RAG知识库实战指南:企业AI落地中不可绕过的精准问答基建
引言:为什么90%的AI客服上线后仍被人工坐席“兜底”? 某头部保险集团投了300万元上线大模型客服,结果首月幻觉率就冲到42%,政策解释频频出错,只能退回“AI+人工双轨制”;某省级12345热线把历年工单全喂给大模型,87%的市民问题答非所问。这不是模型不行,而是缺了一样东西——一个真正管用的RAG知识库:结构清晰...
引言:为什么90%的AI客服上线后仍被人工坐席“兜底”?
某头部保险集团投了300万元上线大模型客服,结果首月幻觉率就冲到42%,政策解释频频出错,只能退回“AI+人工双轨制”;某省级12345热线把历年工单全喂给大模型,87%的市民问题答非所问。这不是模型不行,而是缺了一样东西——一个真正管用的RAG知识库:结构清晰、更新可控、每一条回答都能追根溯源。
RAG(Retrieval-Augmented Generation)不是锦上添花的插件,它是企业AI能跑稳的底盘。它把私域知识和大模型分开,用检索来“拉住”生成的缰绳,直接治幻觉、治过时、治不合规。这篇文章写给已经动手做AI,却卡在效果上不去的技术负责人、AI产品经理和交付工程师——不讲概念,只说怎么落地。
一、RAG知识库到底是什么?别再当成“检索+生成”拼积木
真正能用的企业级RAG,是闭环,不是接口
上传几份PDF、调个API,那叫Demo,不叫RAG。企业级RAG是一整套活的系统:知识怎么收、怎么切、怎么标、怎么查、怎么锁权限、怎么审计。举个例子:一家三甲医院建临床指南RAG库,没把《中国2型糖尿病防治指南(2023年版)》整个扔进去,而是按医生实际工作流拆解——“诊断标准”“药物禁忌”“妊娠管理”……一共切成137个语义块,每个块都打上ICD-11编码、证据等级(A/B/C)、生效日期。所以当医生问“妊娠期能不能用司美格鲁肽?”,系统不仅给出答案,还顺手标出:“依据2023年ADA共识,证据等级B”。
IDC 2024年报告显示,用了结构化RAG的企业,AI问答准确率平均提了58%,知识更新从等一周变成几分钟。
RAG知识库、知识图谱、微调模型,到底该选谁?
- RAG知识库:改知识不用重训模型,谁查了什么、哪条知识被用了,全程可查
- 知识图谱:适合强逻辑推理,但建一张信贷规则图谱,某银行花了11个月;遇到几万字的诊疗记录,它就干瞪眼
- 微调模型:贴得深,但容易忘——某券商微调LLaMA-3后,连基础数学题都错得更多了
它到底解决了什么?三个字:准、快、稳
- 准:金融合同审查场景里,条款引用错误率从19%(微调方案)压到3.2%
- 快:某新能源车企把OTA升级文档实时同步进RAG,工程师查最新故障码,从47分钟缩到8秒
- 稳:每条回答背后都带着原文页码和版本号,ISO/IEC 27001审计时,直接甩链接
二、真正在赚钱、省人、避雷的四个RAG场景
场景1:金融合规问答,不是查法条,是帮人过关
招商证券的监管问答RAG库,塞进了证监会全部1243份有效规章、交易所387条问询函模板、还有自家合规手册。关键在切法:《证券期货经营机构私募资产管理业务管理办法》不是按页切,而是按业务动作切——“投资者适当性”“嵌套限制”“杠杆比例”,每一块都带标签。合规专员问:“资管计划投资非标债权,能不能期限错配?”系统毫秒返回答案,同时高亮标出“第32条第二款:禁止”,还附上原文截图。上线半年,审核人效涨了2.1倍。
场景2:设备维修,修得快不如一次修对
徐工集团给XE900E挖掘机建RAG库,存了23万页维修手册、1.7万条故障视频、432份备件3D参数。最实在的是多模态检索:技师拍一段油泵异响视频,系统自动抽音频特征+画面振动频谱,去比对历史相似故障。2023年第四季度数据:一线技师首次修复成功率,从61%跳到89%。
场景3:新药研发,不是找文献,是找答案
药明康德的RAG库连着PubMed近5年肺癌靶向药临床试验数据(NCT编号、ORR、PFS这些字段全结构化)。你直接问:“奥希替尼和阿美替尼,在T790M突变NSCLC里,3级不良反应发生率分别是多少?”系统不翻摘要,它把临床指标映射成向量空间里的坐标,直接算——第三方盲测,复杂对比类问题准确率94.7%。
三、踩过的坑,比教科书还真实
坑1:以为“全量上传”=“全面覆盖”
某省人社厅曾把15年政策文件(8.2GB PDF)一股脑切块入库,结果搜“失业金申领”,出来37条无关结果。后来改了:只收现行有效、盖了红章的文件;加三道过滤——OCR质量不过关的不要、已废止的剔掉、内容重复的合并。
坑2:切块不管业务,等于自废武功
法律文书得按“条—款—项”切,产品说明书得按“功能模块—操作步骤—异常处理”组织。某家电厂图省事,统一用512字符滑动窗口切说明书,“儿童锁开启方法”被硬生生劈成两半,问答失败率飙到65%以上。
坑3:Embedding模型乱选,中文金融术语直接失焦
text-embedding-ada-002这种通用模型,在“质押式回购利率”和“买断式回购利率”之间分不清。平安科技实测发现:换成领域微调的bge-zh-v1.5,两个术语的向量区分度提了4.3倍。
四、怎么从试跑(PoC)走到真用?四步,不绕弯
- 先盘家底:哪些文档类型、多久更新一次、谁能看(比如财务制度,只给CFO开权限)
- 按业务切,不是按字数切:定义“合同里的违约责任条款”这种语义单元,而不是“每512字一切”
- 别只靠向量:混合用——向量查语义、BM25抓关键词、规则卡时效和权限
- 让反馈长进系统里:UI上放个“答错了”按钮,点一下,自动优化chunk、重训embedding
五、RAG不止于问答:它正成为Agent的“脑子”
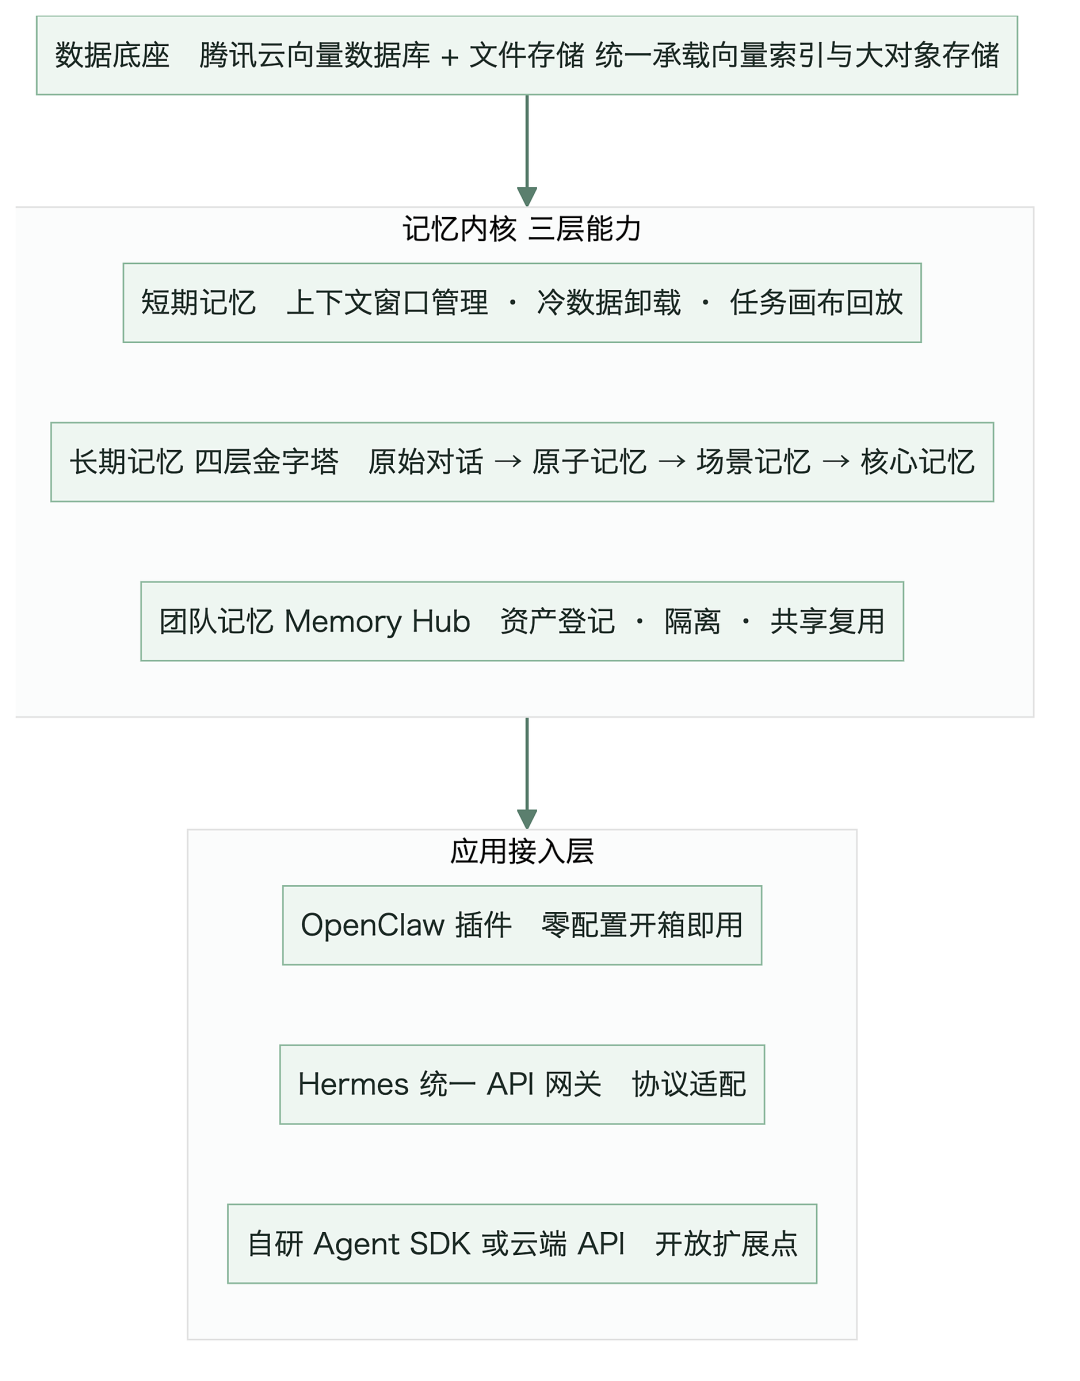
当RAG知识库变成Agent的长期记忆,价值就变了。比如某跨境电商的采购Agent,执行“东南亚仓补货”任务时,会自己调出三样东西:① 越南2024年EPR新规、② 物流商SLA协议、③ 去年滞销的SKU清单,然后综合算出最优采购方案。RAG,正在从问答底座,变成企业认知操作系统的核心。
给技术负责人的三条行动建议
- 立刻分级知识资产:只把前20%真正高频、高风险、高价值的知识放进RAG,其余先放着
- 第一版就要带溯源水印:每条回答末尾自动加一句:“依据[文件名]V3.2第X章,更新于2024-06-15”
- 把它当IT系统管:写进ITIL流程,定清楚谁创建、谁审核、谁归档、谁作废
总结:RAG不是功能模块,是信任锚点
大家聊Agent、聊多模态、聊推理速度,但真正决定AI项目能不能活下去的,往往就是那个不声不响的RAG知识库。它不炫技,但每一条回答都有出处;它不取代模型,却让大模型真正替你说话。所有跑通的案例都在说同一件事:RAG挖得多深,AI才立得多稳;而RAG管得有多细,才真正构成你的AI护城河。
立即咨询 JOTO
JOTO 为企业提供从RAG知识库架构设计、行业知识切片建模到Dify+RAG生产环境交付的一站式AI落地服务,已助力17家客户将RAG知识库准确率稳定在92%以上。 联系 JOTO 获取 AI 落地咨询
立即体验 JOTO
如果你想进一步了解 JOTO,欢迎前往官网体验。
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们