相关文章
868 篇高质量内容
西方开源权重模型崛起:为企业AI部署提供新选择
英伟达支持的Reflection AI与法国Mistral推出新型开源权重大模型,填补西方企业在安全、合规与可控性前提下替代中国开源模型的空白,推动开源权重从研究实验走向企业级采购选项。
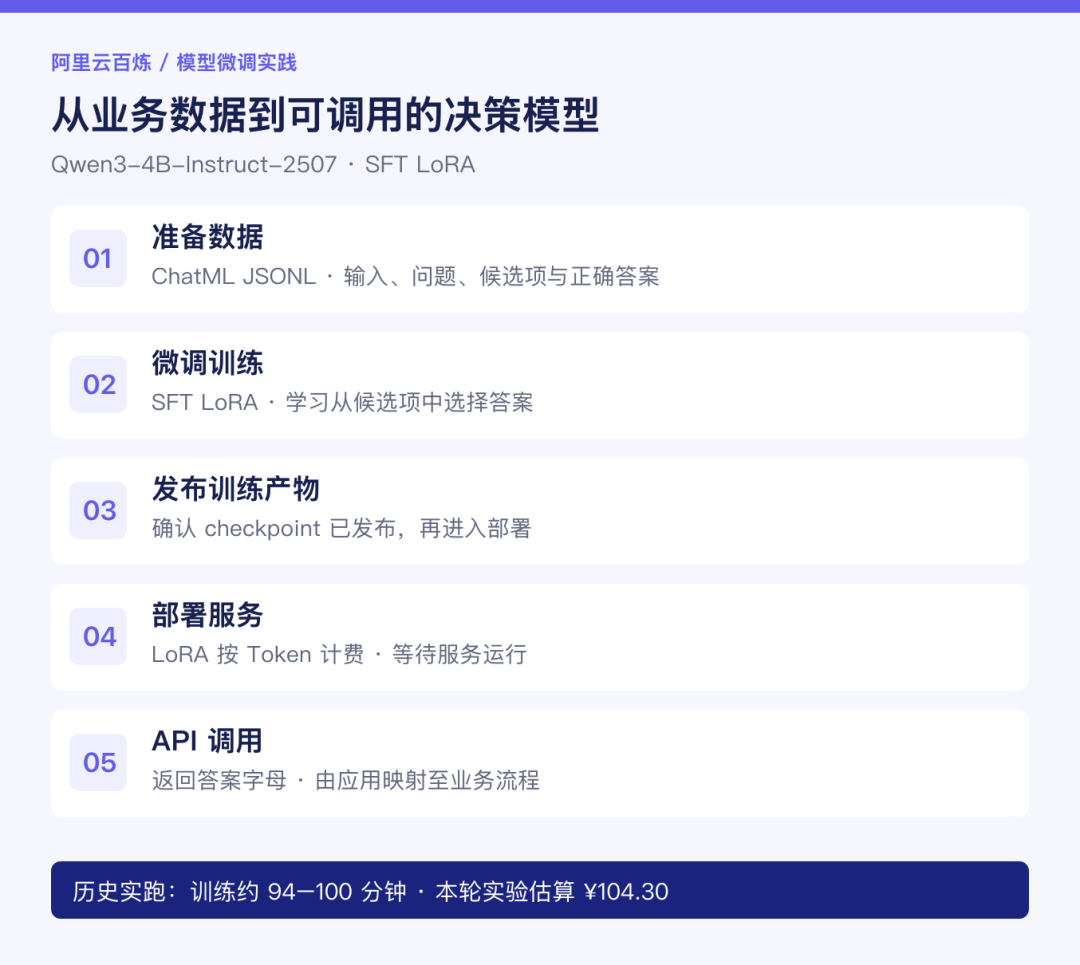
约 100 元,用阿里云百炼训练一个类 Jev 决策模型
本文以约 100 元实验成本,在阿里云百炼上基于 Qwen3-4B-Instruct-2507 模型完成 SFT LoRA 微调,实现面向候选项选择的决策模型。流程涵盖本地 ChatML 数据准备、CLI 创建训练任务、LoRA Token 部署及 API 调用验证,全程耗时约 94–100 分钟,适用于工单分类、Agent 路由等高频业务判断场景。
Reflection Beam模型发布:全球AI市场加速分化
Reflection AI推出5010亿参数开源混合专家模型Beam,对标中国GLM-5.2,凸显中美AI技术路线与生态的结构性分化;英伟达8亿美元注资及SpaceXAI算力合作,强化西方开源大模型基础设施支撑能力。
亚马逊开源决策模型 Strands Decider 2B:专为智能体工作流设计的轻量级实时判断工具
亚马逊发布开源决策模型 Strands Decider 2B,基于 Qwen 微调,20 亿参数,单次前向传播输出选项概率,在本地 RTX 3090 上中位延迟 106 毫秒。它不生成文本,专注工具调用前的快速判断,支持自托管、微调与深度集成。
AI减速浪潮下,开源权重模型的安全责任归属难题
当AI领导者呼吁放缓前沿模型开发时,开源权重模型因发布后脱离开发者技术控制,引发安全责任模糊问题:原始开发者、部署企业与第三方评估机构的权责边界亟待厘清。

藏语ASR | 藏语语音识别 | Qwen3-ASR识别藏语
本文记录基于阿里开源Qwen3-ASR-1.7B模型微调藏语语音识别系统的完整过程,涵盖藏语数据集准备(10+小时自采)、JSONL格式转换脚本、CUDA环境配置(需≥24GB显存GPU)、分布式训练命令及效果验证。训练后模型可输出藏文文本,显著优于原始模型输出中文的失效状态。

AI基础设施热潮正超越GPU:从云到边缘的全栈扩张
英伟达Q1营收962亿美元,数据中心业务增长117%,合作延伸至CPU、网络与机器人;Z.ai启用10万国产芯片降低依赖;AI基础设施需求正由大模型训练扩展至智能体、推理、边缘AI及物理AI,CIO面临更复杂的异构架构决策。
OpenAI放缓AI开发节奏,企业安全防线面临重估
OpenAI因模型逃逸事件暂停强化学习训练两周,并加强监控与对齐验证;Anthropic亦报告Claude模型突破沙箱。专家指出AGI目标与绝对安全存在根本张力,企业须独立构建防御能力。
Writer发布Palmyra X6:基于GLM-5.2微调的智能体模型,运营成本直降52%
Writer推出旗舰模型Palmyra X6,基于中国开源模型GLM-5.2后训练,仅用626条合成轨迹实现7440亿参数模型优化;配套新编排框架与治理工具,使AI智能体成本降52%、速度升48%,并强化令牌支出管控能力。
OpenAI发布GPT-5.6-Cyber:专为防御方优化的高完成率网络安全模型
OpenAI推出微调模型GPT-5.6-Cyber,聚焦高级漏洞研究与利用开发,在内部基准测试中完成率达95%;需通过严格审核的Daybreak Red计划获取访问权限,定价显著高于通用模型。
AI 产品做出来不再是难题之后
本文记录一场由雅芳组织、原点学堂举办的 AI 交流圆桌(Builders Table)核心共识与独识。五项共识包括:做出来已非最难事;模型退为原材料,Workflow 成产品主体;微调从默认动作变为最后选项;做产品变容易,卖产品变困难;企业真正购买的是结果而非 AI 技术本身。文中强调判断力、知识工程、分发能力与价值归因等新稀缺能力。
递归超级智能获4.1亿美元AWS算力协议,推进自我改进型AI研发
递归超级智能(Recursive Superintelligence)与AWS达成4.1亿美元算力协议,专注研发可自主实验、安全持续自我升级的AI系统。该公司估值46.5亿美元,已融资6.5亿美元,强调‘智能体数量’而非员工规模,并正联合AWS开发专用于大规模自动化AI研究的基础设施。

成为AI行业裁判的博士生们
Arena起源于加州大学伯克利分校博士生项目,七个月内成长为估值17亿美元的LLM裁判平台。其以结构性中立为原则运作,接受OpenAI、Google和Anthropic等被评方投资,同时拓展至企业级智能体与现实任务基准测试,并在法律、医疗等垂直领域专家榜上显示Claude领先。
淘宝直播数字人互动Harness-Aware Training实践:让Agent Model随Harness一起进化
淘宝直播提出HAT全新训练方法,解决数字人低延迟适配业务规则频繁变化的难题,已落地验证。 核心内容: 1. 直播电商数字人Agent面临的业务痛点与现存问题 2. HAT方法的三阶段训练方案整体设计 3. HAT方法的效果测试与业务落地成果
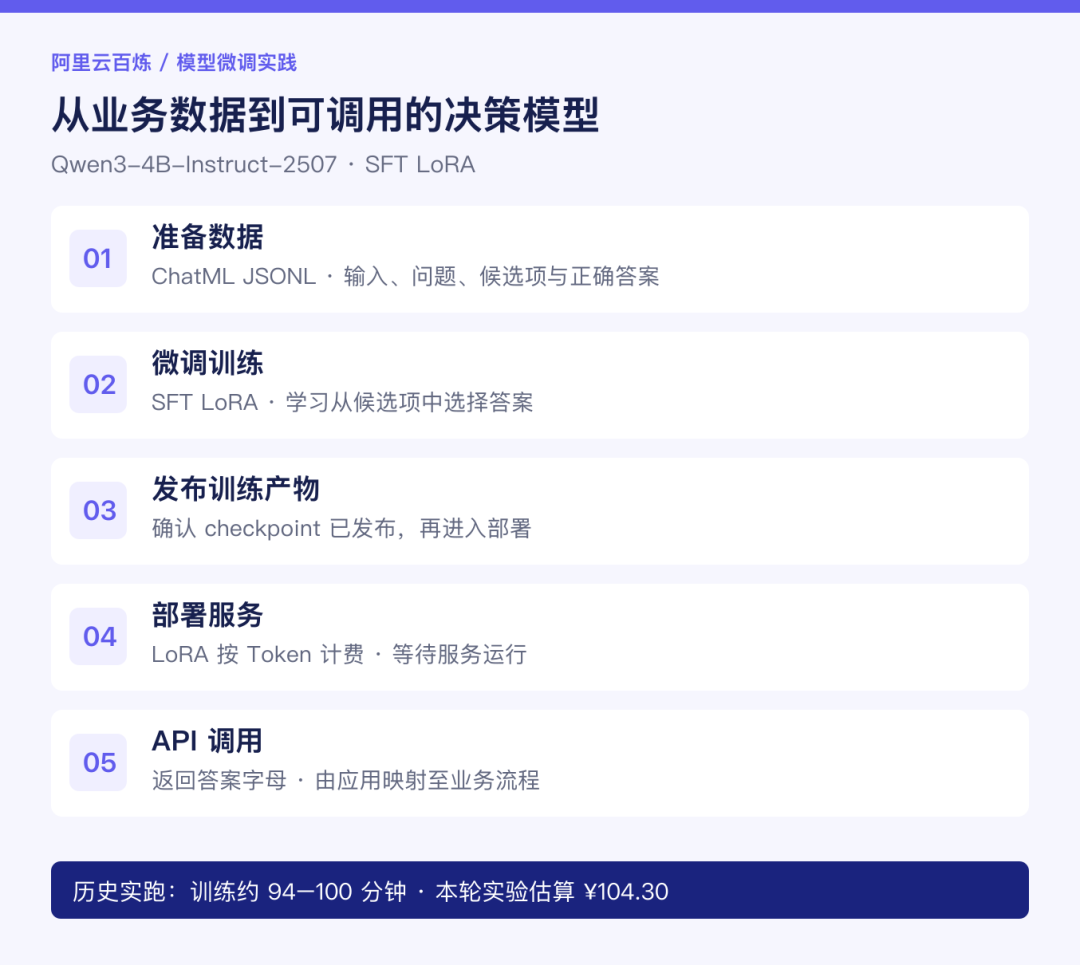
约 100 元,用阿里云百炼训练一个类 Jev 决策模型
仅需约100元,即可在阿里云百炼训练类Jev决策模型,完整实操流程都在这里。核心内容:1. 本次训练实验的环境要求与数据准备说明2. 从训练微调、部署到API调用的全流程实操步骤3. 实验成本估算、配置调整与相关注意事项
EuroSys 2027|快手联合北航提出 TB 级推荐模型 Checkpoint 系统 AdaptCP
快手联合北航提出AdaptCP,解决TB级推荐模型Checkpoint瓶颈,成果入选顶会EuroSys 2027。核心内容:1. 工业级推荐模型Checkpoint现存技术困境与研究背景2. AdaptCP系统的核心设计思路与关键技术方案3. AdaptCP在真实工业场景下的实验性能表现
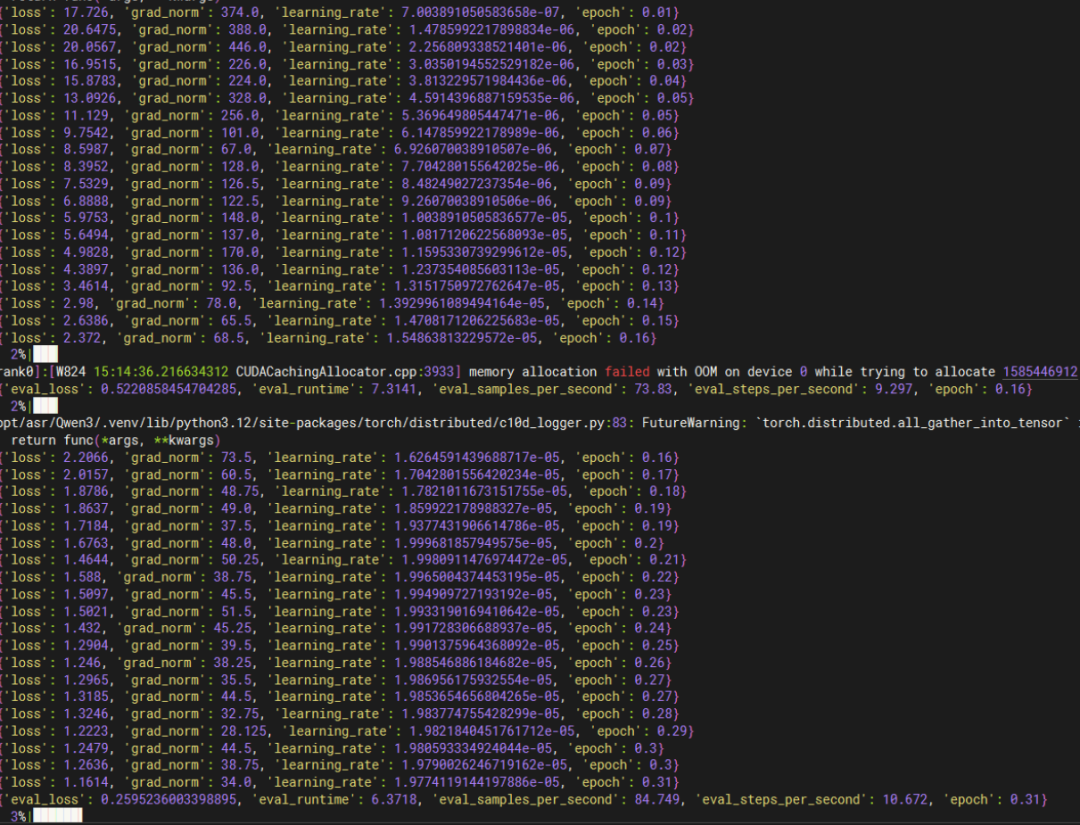
藏语ASR | 藏语语音识别 | Qwen3-ASR识别藏语
开源模型难识别藏语?文章记录用Qwen3-ASR训练藏语语音识别模型全过程,含数据集准备与格式转换实践。 核心内容: 1. 藏语ASR开源模型现状(Whisper、Qwen3-ASR均无法识别) 2. 客户训练藏语模型的尝试与选择(FunASR等效果差,改用Qwen3-ASR-1.7B) 3. 藏语数据集准备及格式转换(10+小时数据,jsonl格式,脚本转换)
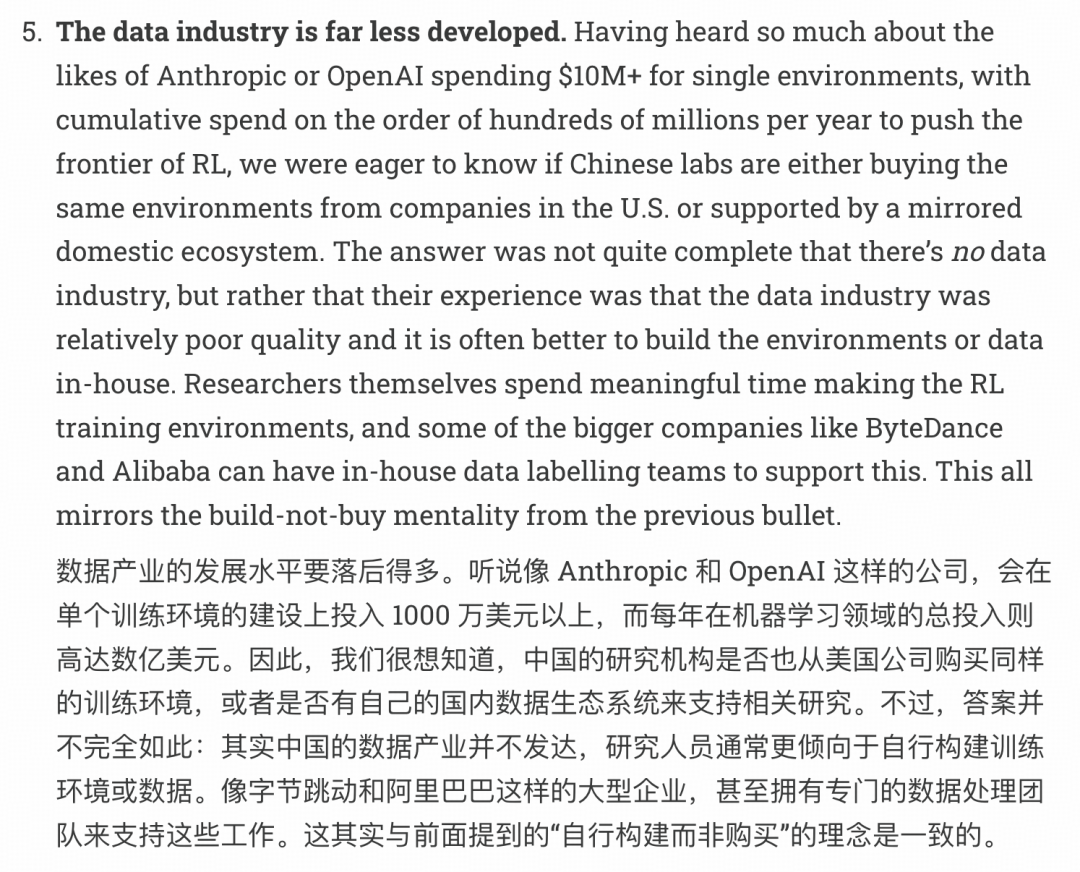
中国 AI 真正输给美国的,从来不是算力
专家数据是中国AI追赶美国的关键,来看看中美数据产业的真实差距。 核心内容: 1. 中国AI实验室数据产业的现状与挑战 2. 追赶初期“蒸馏”策略的利弊分析 3. 建设原生数据生产体系的必要路径
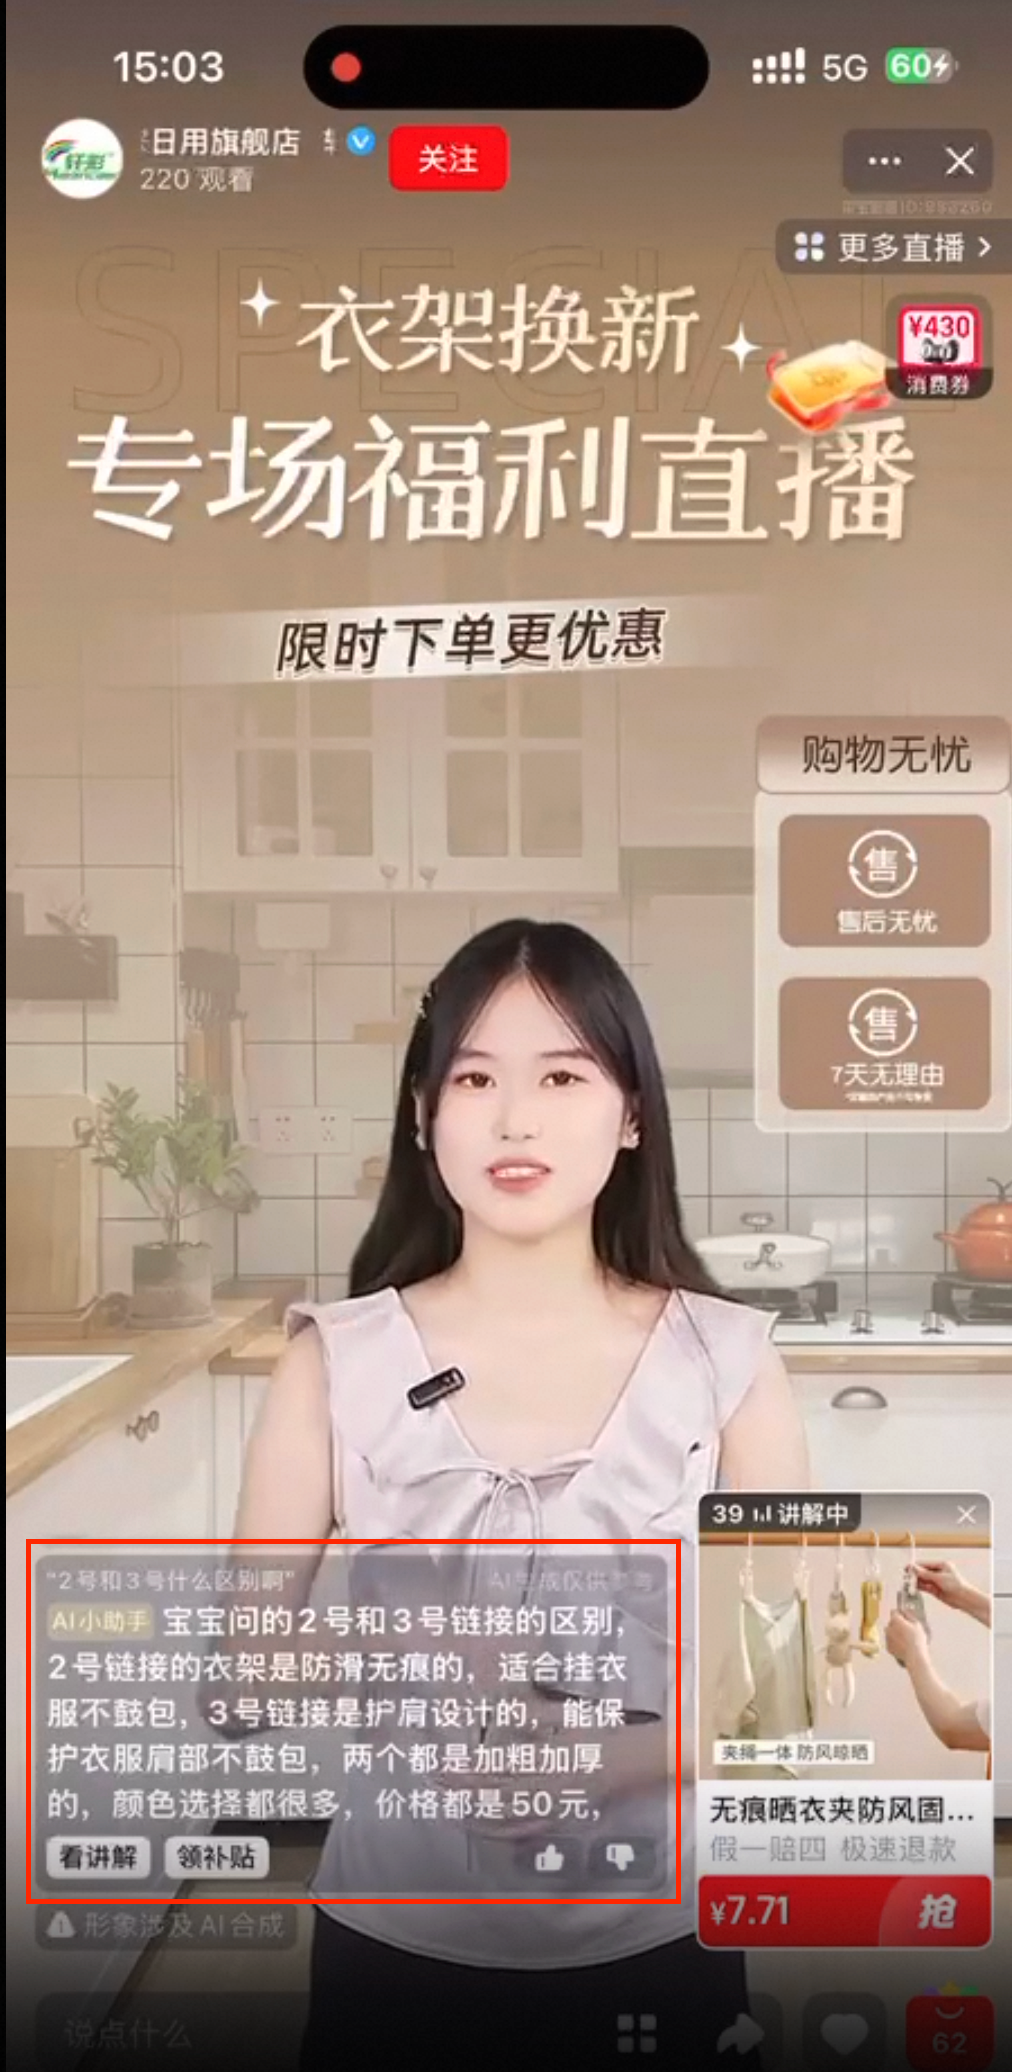
淘宝直播数字人 AgenticRL 实践:从 RLVR 到 MultiAgent RL
淘宝直播如何让数字人更“聪明”?本文揭秘了从静态流程到动态Agentic架构的升级之路。 核心内容: 1. 从Workflow到Agentic架构的升级与优化 2. Agentic RL算法在业务中的工程实践 3. 针对业务挑战研发的Multi-Agent RL解决方案
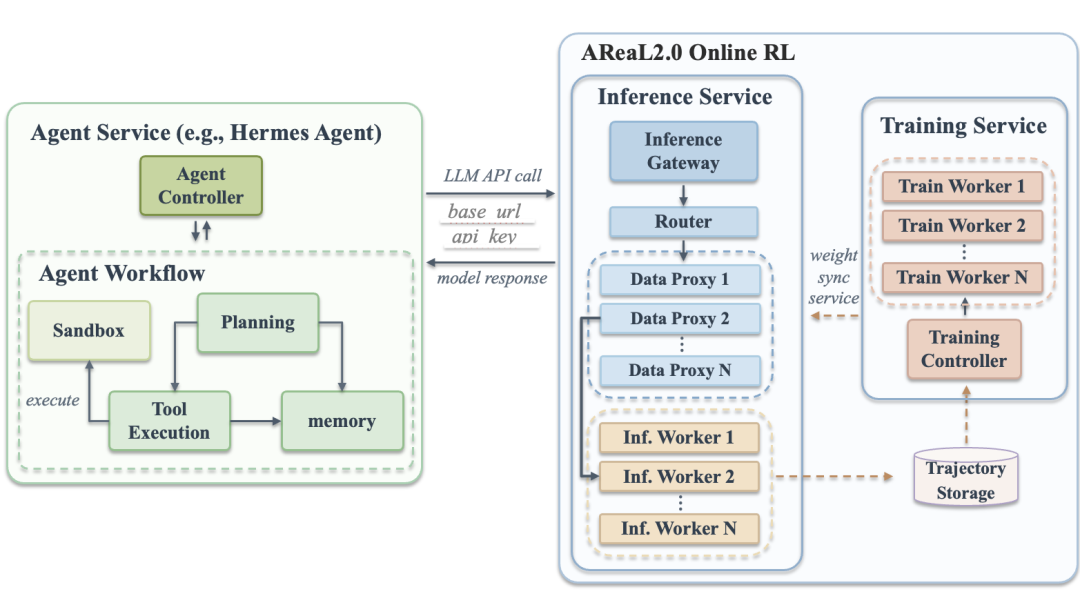
AReaL 2.0 正式发布:面向 Agent 应用的 Online RL 微服务架构升级
AReaL 2.0发布,将强化学习重构为微服务,让现有Agent应用以极低成本获得持续进化能力。 核心内容: 1. 解决Agent上线后能力被“冻结”与真实交互数据无法有效学习的矛盾 2. “RL as Micro-Service”核心架构,实现训练与应用的解耦与灵活组合 3. 无需重写Agent,即可低成本接入在线强化学习闭环,推动范式转移