相关文章
533 篇高质量内容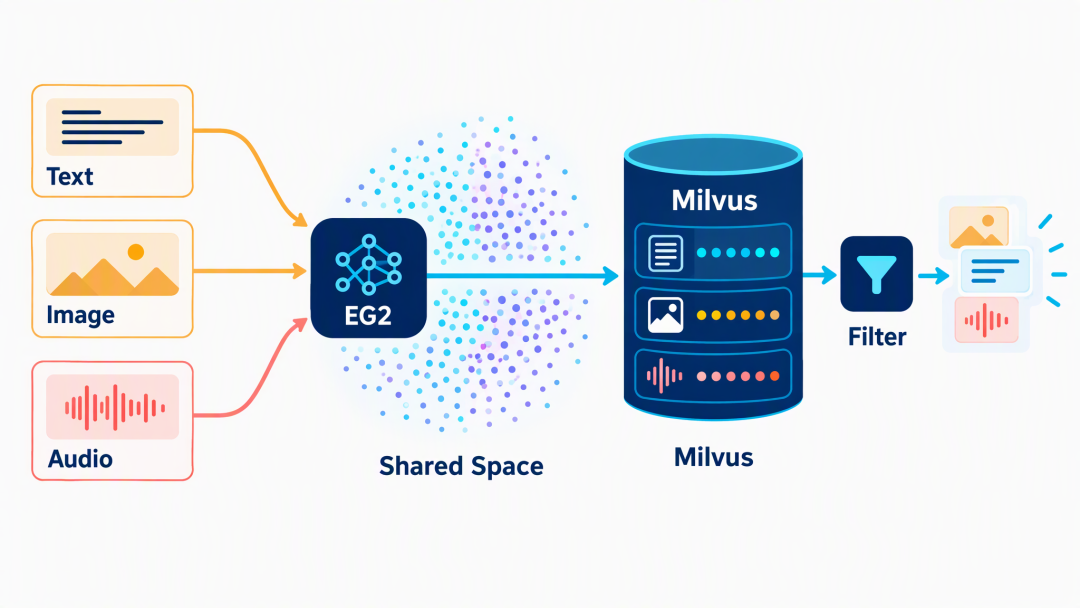
谷歌EG 2模型+Milvus实测:最适合低成本本地部署的多模态embedding模型来了
Google开源的EmbeddingGemma 2(EG2)以740M参数规模支持文本、图片、视频、音频统一编码,可按模态加载编码器并裁剪向量维度至256维或128维。本文通过Milvus实测其与Nomic、qwen3.7-text-embedding-flash、Qwen3-VL-Embedding的横向对比,在Flickr8k和ESC-50数据集上验证其文本/图文/音频检索能力及256维向量的精度-存储平衡点。
iPhone断网跑35B多模态!国产开源新模型,只占3G内存
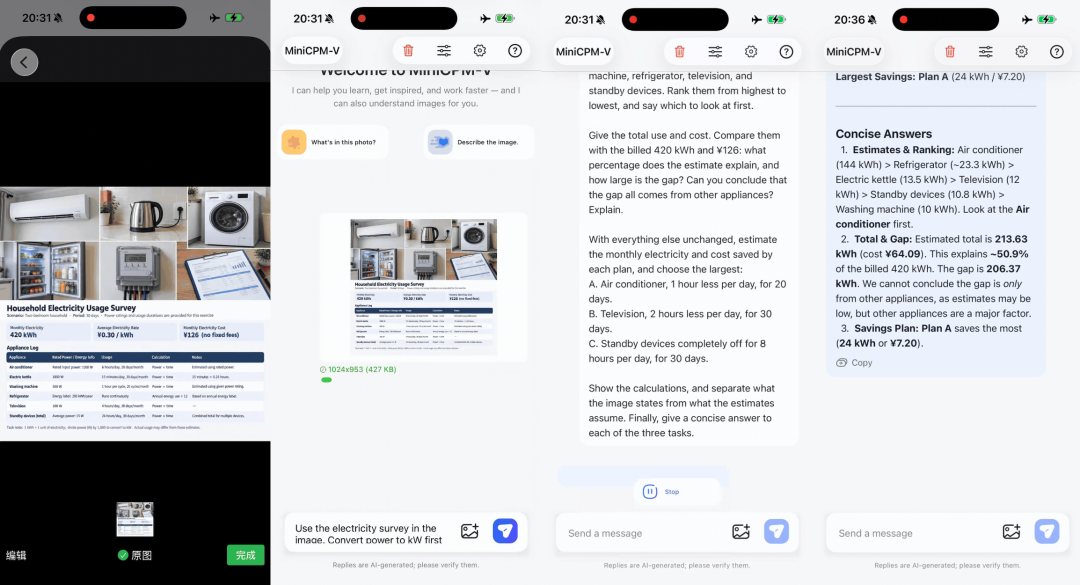
面壁智能与OpenBMB开源MiniCPM-V 4.7,含35B-A3B(MoE结构,仅激活3B)和1B两个版本,可在iPhone 17 Pro Max等端侧设备断网运行,解码速度超13 token/s,内存占用约3GB。模型在MMBench、OmniDocBench等基准测试中领先,支持iOS/安卓/鸿蒙及主流推理框架。
微信又上大分了!又偷偷更新了两个 AI 新功能,我赌你一个都没发现
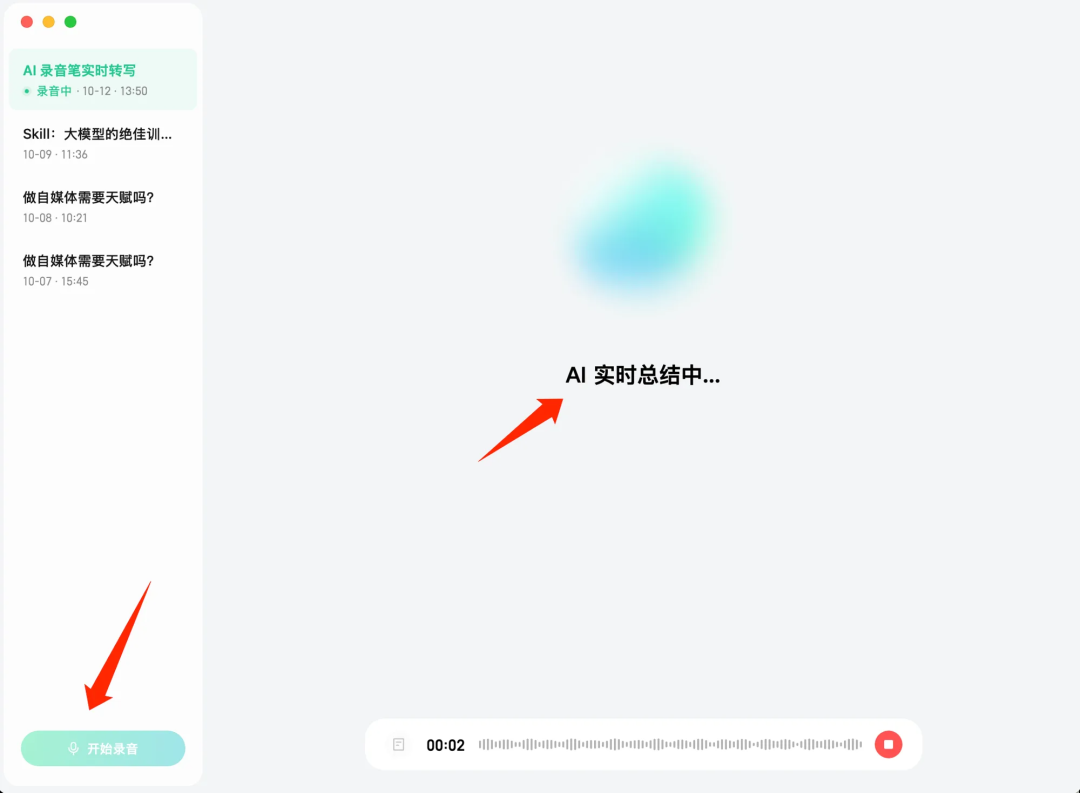
微信偷偷更新了两个实用AI新功能,大部分人都没发现,快来了解。 核心内容: 1. 微信输入法内置AI录音笔功能的特色与实用性讲解 2. 微信聊天内置AI P图功能的入口与便捷性优势 3. AI P图四大核心功能的具体作用介绍
0.6B起!Jev对手模型来了,开源多模态,登上全球测评榜一
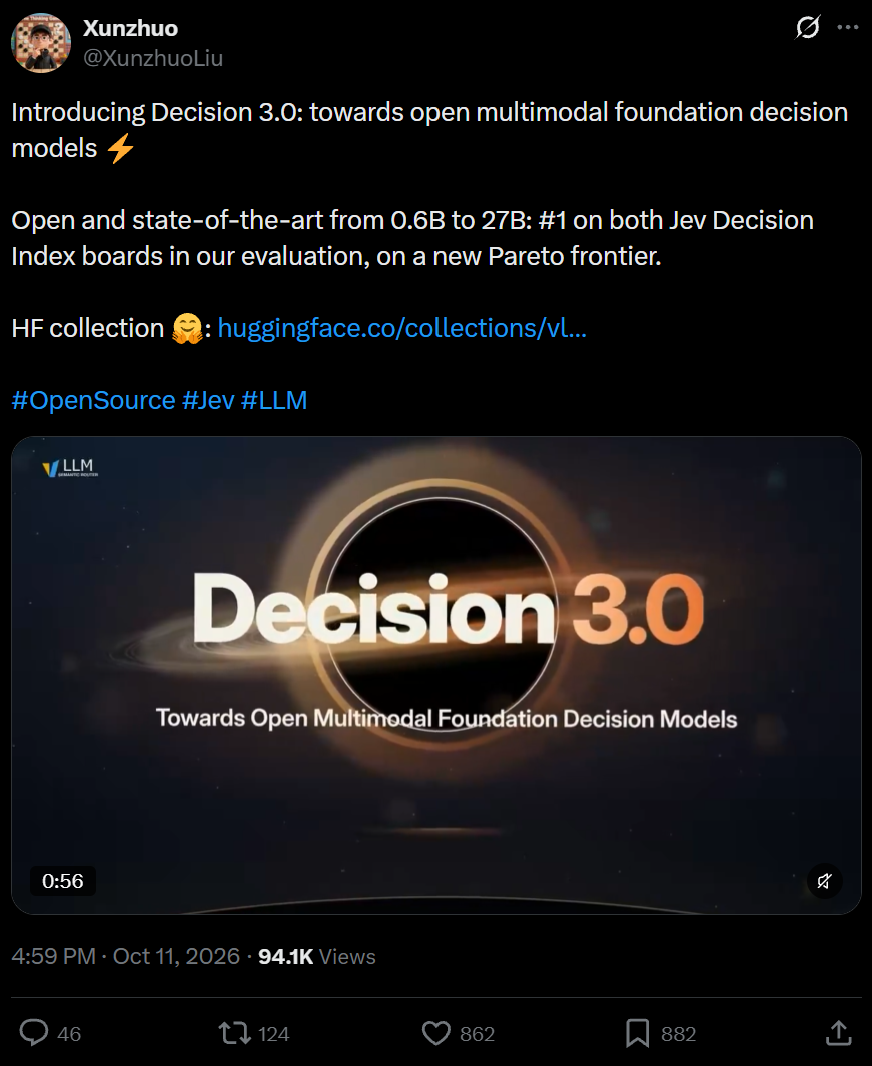
vLLM Semantic Router开源Decision 3.0系列决策模型,参数规模覆盖0.6B至27B,支持文本、图片与视频输入,不生成长文本,仅输出结构化判断结果及置信度。在Jev Decision Index榜单中,旗舰模型d3文本与视觉分均位列第一,超越Jev与微软Decision-1。模型权重已开源,支持本地部署与边缘推理。
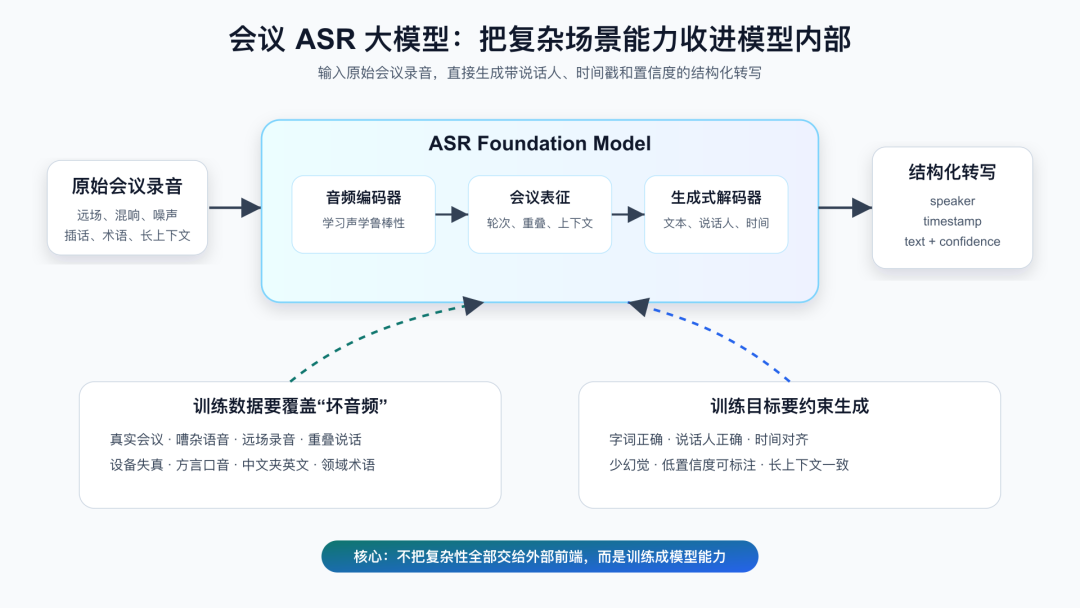
技术解读|会议 ASR 的下一站:让大模型自己学会听懂会议
本文探讨会议语音识别(ASR)的技术演进方向,指出传统模块化系统在真实会议场景中面临声学复杂性、多人重叠说话、专业术语混杂等挑战;提出ASR大模型应将声学鲁棒性、多说话人结构理解、长上下文一致性与输出克制等能力内生化,直接从原始音频生成带说话人归属与时间戳的结构化转写。
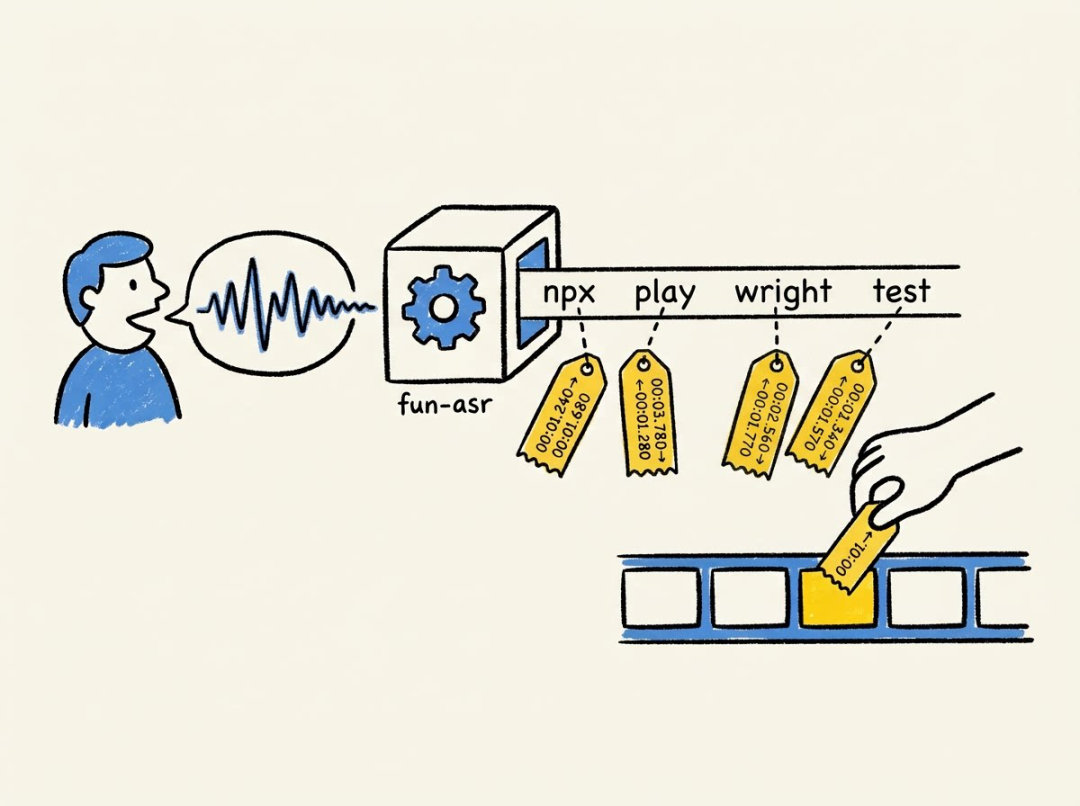
一个工具,十几分钟搞定:录屏字幕生成+错误字幕修正+多语言版本生成 | 开发者案例
阿里云百炼开发者 oil-oil 开源的 qwen-subtitle 工具,利用 ASR 语音识别与视觉理解模型协同纠错,解决录屏视频中专有名词(如 html2pptx→html to ppt)被误识别的问题;支持自动纠错、断句去水词、多语种字幕生成及配音合成,全流程由百炼 CLI 驱动,5 步约 15 分钟完成。
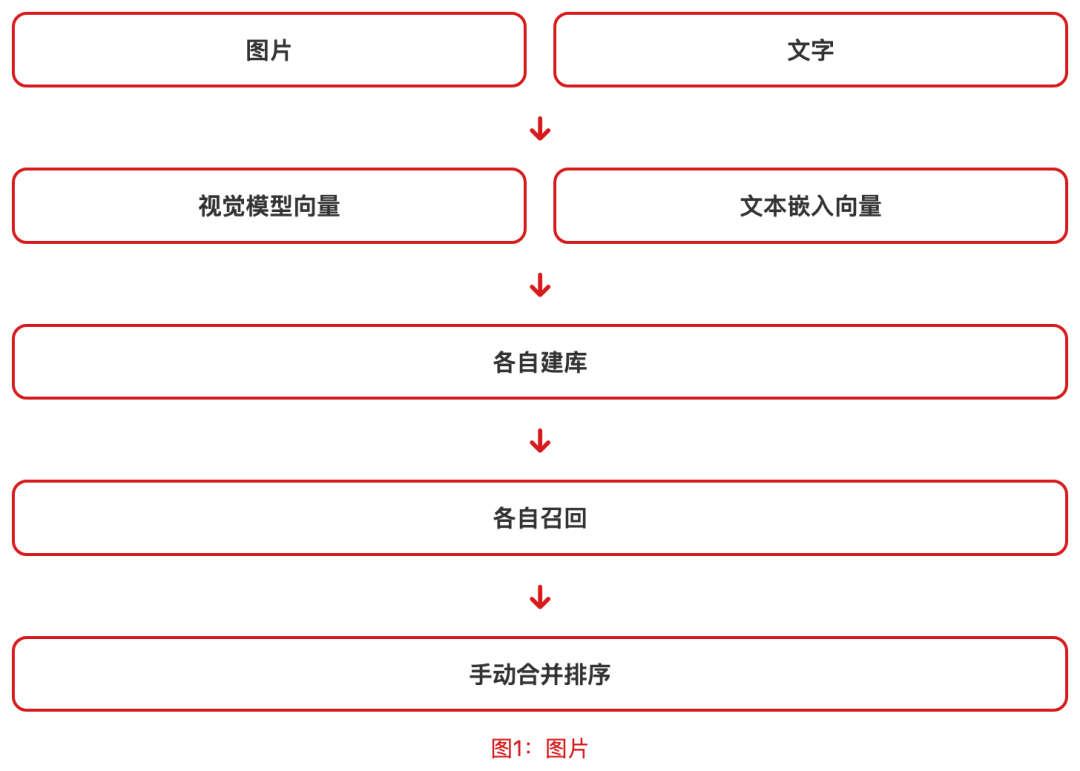
知识库里一半答案是图,检索却只认字:一个 740M 免费模型把盲区填上了——我们跑通给你看
Google DeepMind 于2026年10月6日发布开源多模态嵌入模型 EmbeddingGemma 2(740M 参数,Apache 2.0 许可),支持文本、代码、图像、视频、音频五种模态统一映射至同一向量空间。实测表明,该模型可使纯图答案(如报错弹窗截图、PPT流程图)进入检索候选集,解决企业知识库中图文资产割裂导致的检索盲区问题。
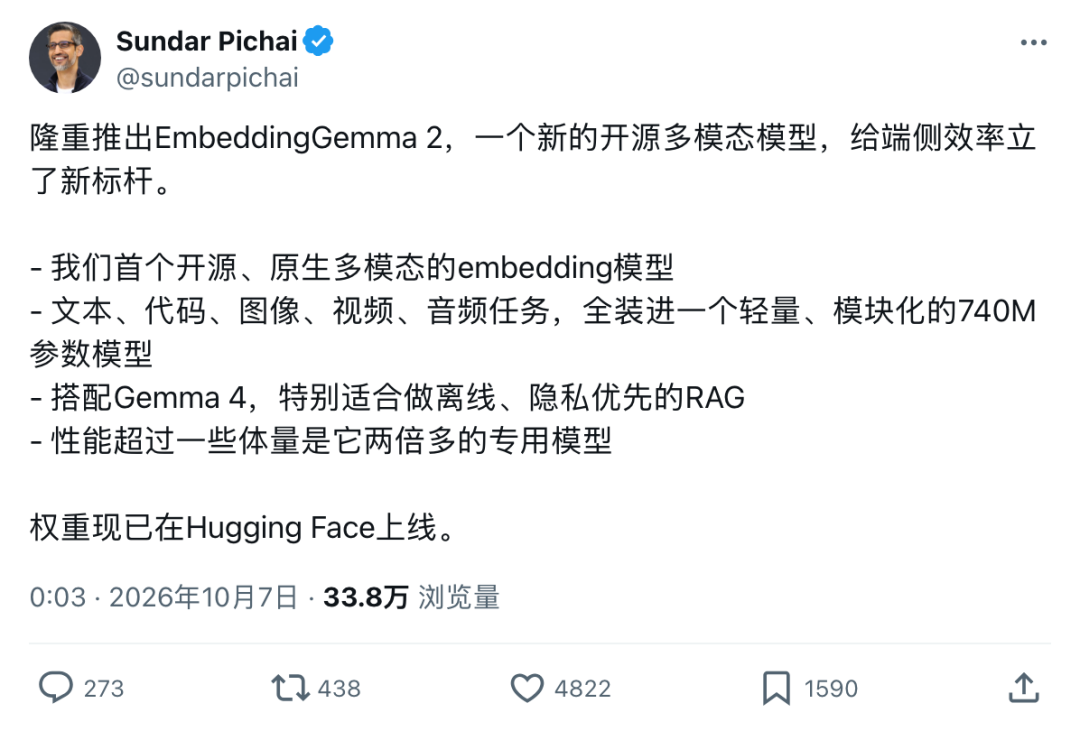
谷歌把AI搜索塞进手机!不到600MB,照片、视频、录音断网照样搜
谷歌开源EmbeddingGemma 2,740M参数、567MB内存占用,支持文字、图片、音频、视频跨模态联合嵌入。可在手机、浏览器本地运行,22毫秒完成多模态检索,无需联网或调用API。它统一处理多模态内容至768维语义空间,提升图像/视频检索得分近20分,并支持代码、多语言及离线RAG应用。
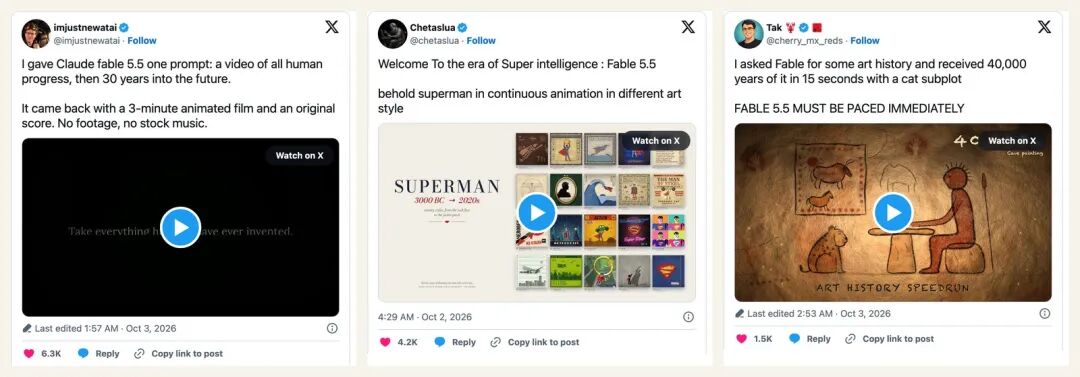
huashu-art-motion发布!可能是最有审美的动画skill。
huashu-art-motion 是一个开源动画 skill,支持用自然语言指令生成多风格白板动画、艺术史穿越短片及解说类视频。它基于 Claude Code Opus 5.5 实现,可拆解参考视频、生成运动热力图、代码绘图与合成配乐,并内置35种艺术风格卡与8种YouTube常见解说模板。
Mistral发布万亿参数开源模型Le Chonk:聚焦企业可部署、主权可控的多模态基础模型
Mistral推出参数量达一万亿(490亿活跃)的开源权重模型ML4(代号Le Chonk),支持多模态输入与文本输出,专攻编程、网络安全、金融、工业视觉定位等场景,计划10月27日开放权重,强调零数据留存与主权基础设施部署能力。
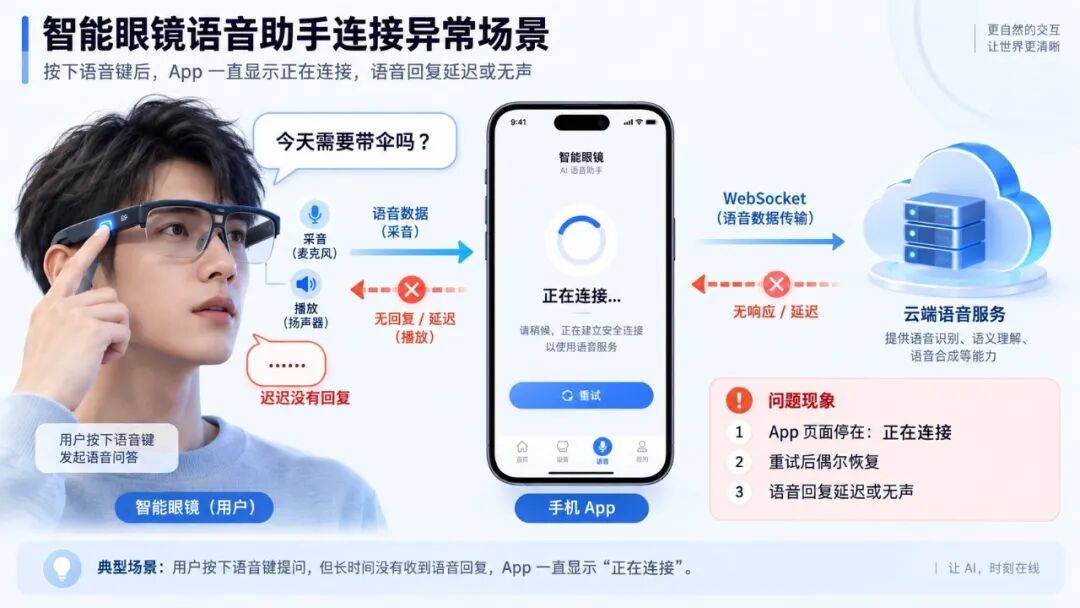
AI 语音一直“正在连接”?用 RUM 排查 WebSocket 建连问题
AI语音总卡在“正在连接”?本文教你一步步排查WebSocket建连疑难问题。核心内容:1. AI语音交互场景下建连问题的背景与排查难点2. 借助RUM记录握手信息定位问题范围的方法3. 通过Trace关联追踪服务端问题根因的流程
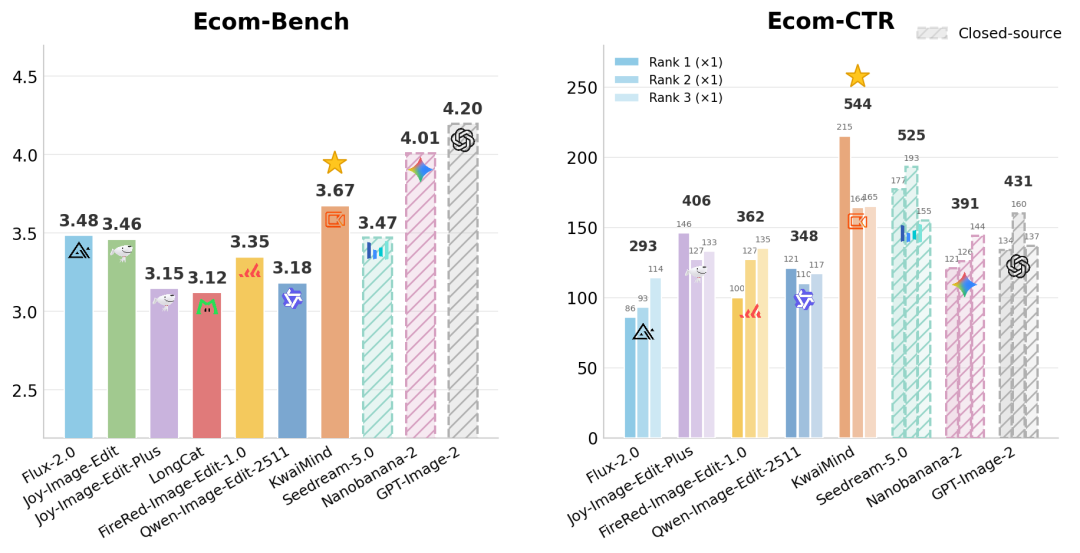
AI改图,终于懂点「用户心理学」了
快手技术团队推出电商图像编辑基座模型KwaiMind,融合通用编辑与电商专项能力,在Ecom-Bench评测中视觉总分位居开源模型第一;线上A/B实验显示其带来商品主图点击率相对提升约2.44%。模型采用多智能体数据引擎构建180万对高质量训练样本,并通过专项优化与多教师蒸馏(DiffusionOPD)统一基座能力。
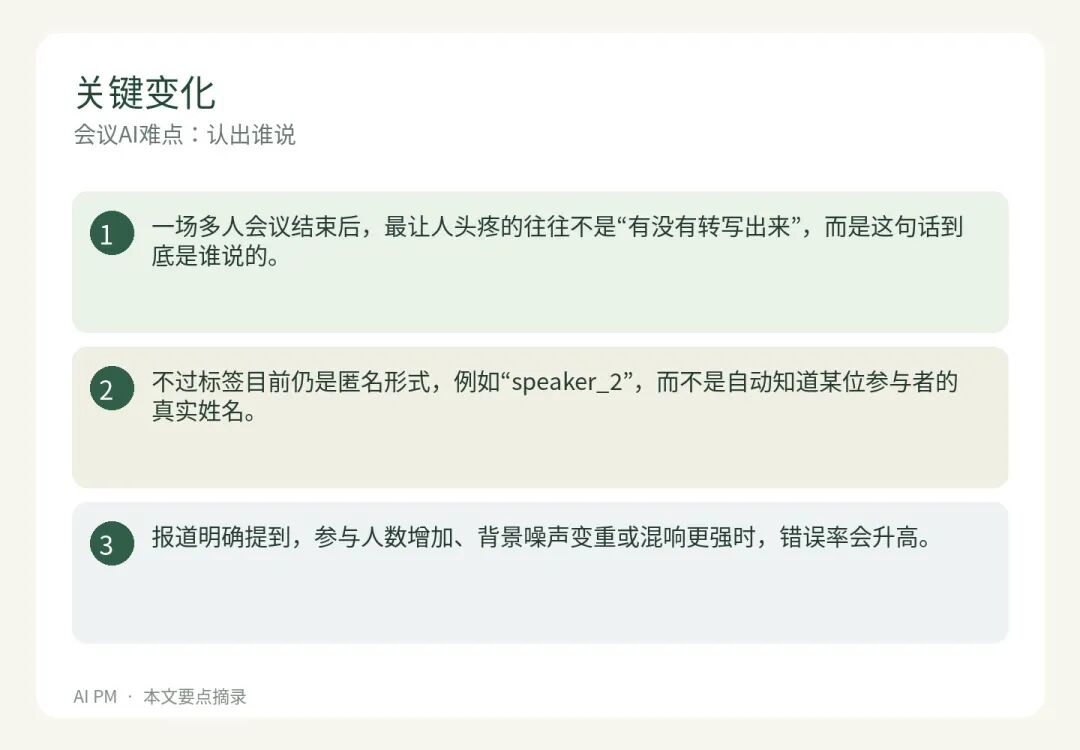
AI会议转写真正的难点,不是识别内容而是认出谁在说话
Nvidia 发布 Nemotron 3 Diarization 模型,专注说话人分离(最多8人、支持实时),参数约1亿、免费开放。其核心价值在于将“谁在什么时候说话”从语音识别中解耦,但不解决“这个人是谁”的身份映射问题。DER 错误率14.7%,但实际效果受人数、噪声、混响影响显著;缓冲时长与准确率存在明确取舍。
微软出手!VibeVoice:90分钟4人对话TTS+60分钟长音频ASR,语音AI天花板开源了
微软研究院开源VibeVoice,支持60分钟长音频一次转写(带说话人分离)、90分钟4人对话TTS合成、0.5B参数实时TTS(首字延迟<300ms),并推出ASR-BitNet版可在纯CPU上运行。项目采用统一Next-Token Diffusion架构,被ICLR 2026接收为Oral论文。
千问办公,如何成为组织生产力底座?
千问办公将企业协作、Office交付、多模态创作、网页制作、数据分析和专业技能整合至统一工作台,核心目标是减少任务在多个软件间的信息搬运。它通过与钉钉深度打通、支持可编辑的Office产物、理解图文音视频输入、提供网页一键发布、聚合分析分散数据、封装岗位技能流程,推动AI从“生成答案”转向“连接业务环节”。
小米MiMo-V2.6系列发布:Pro登顶全球开源权重模型榜首,Flash以1/3成本逼近旗舰性能
小米MiMo-V2.6-Pro以46分成为Artificial Analysis‘智能指数’全球最高分开源权重模型,超越Grok 4.6与Gemini 3.8 Flash;配套的V2.6-Flash在多项智能体基准中达Pro的94%–97%性能,API成本仅为其三分之一,且全栈开源MIT许可。
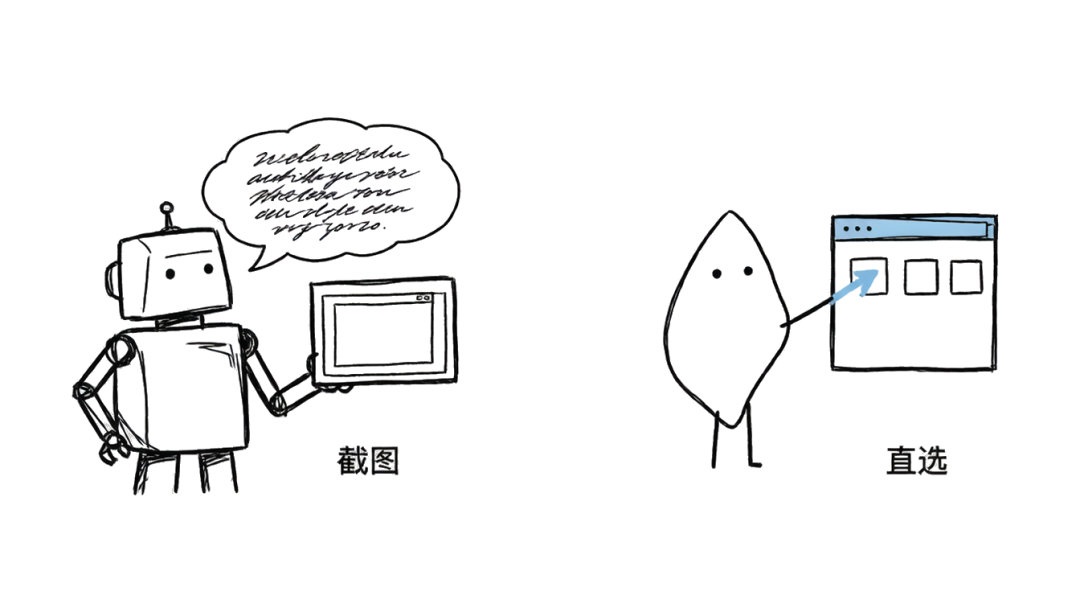
jev模型刷屏,我在本地装了一个平替
JEV并非生成式大模型,而是专精于低延迟、低成本决策的「系统一模型」,仅支持Choice/Score/Noul三类结构化判定。browser-use将其接入浏览器自动化,通过DOM快照替代截图+多模态推理,协议调用减少91%。作者部署开源平替decider-2b-vision,在本地实现离线、免费、数据不出境的同类决策能力。
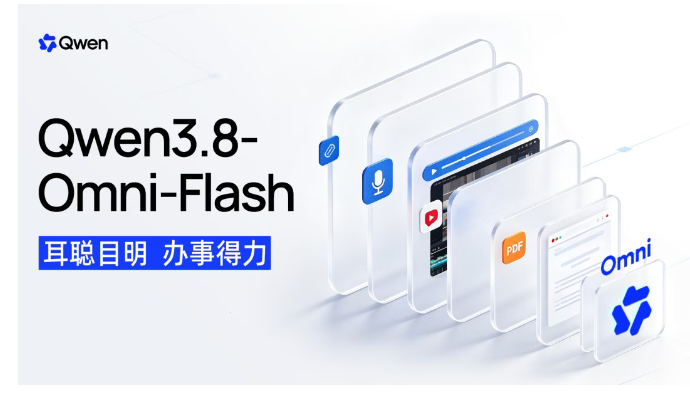
千问上线 Qwen3.8-Omni-Flash:1M 上下文,音频输入价格降幅超98%
9月18日,千问发布原生全模态模型Qwen3.8-Omni-Flash,支持文本、图像、音频与视频输入,上下文达1M。其音视频Agent能力显著提升,在30项评测中平均得分较上一代提升超26%;音频输入API价格降幅超98%,并开源Qwen-Live Harness以优化长程交互效率。
Gemini 3.8 Live:实时流式语音AI代理重塑人机对话范式
谷歌发布Gemini 3.8 Live与Live Extended Thinking两款音频模型,支持边流式输出语音响应边执行API/工具调用、实时视觉输入及97+语言,实现推理与交互延迟分离,使AI代理可被自然中断并持续上下文对话。
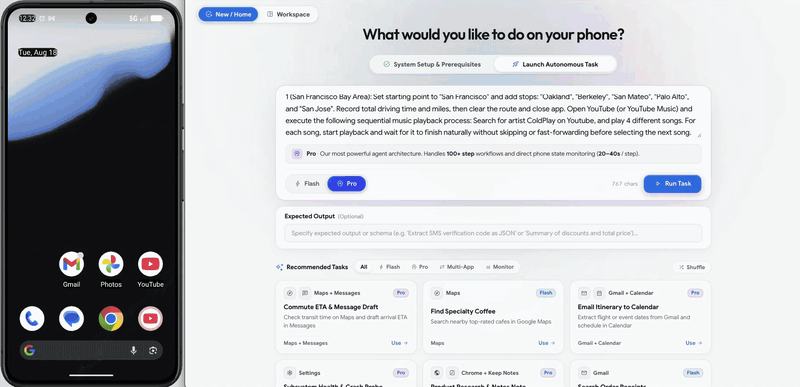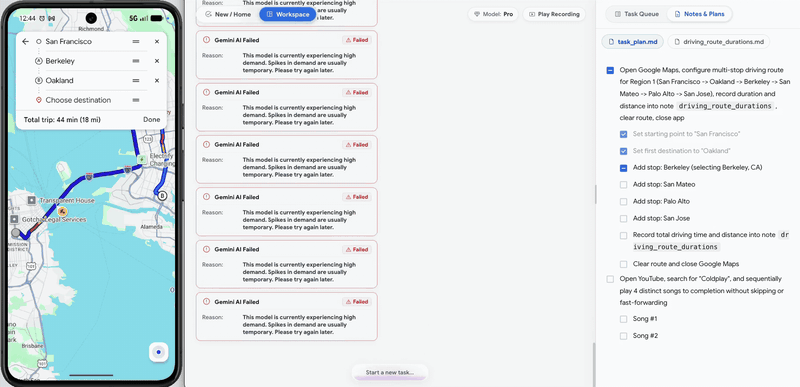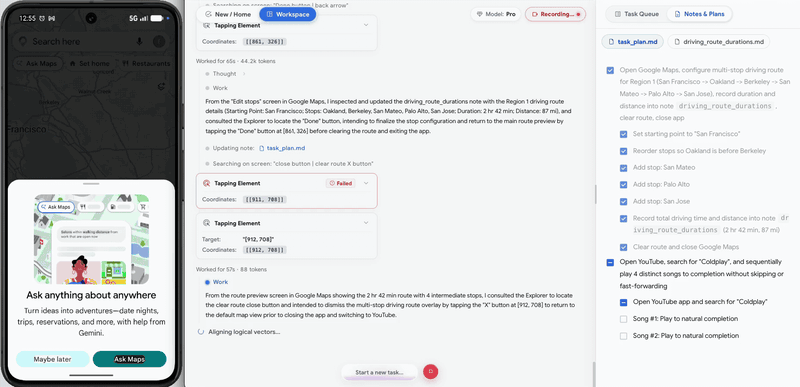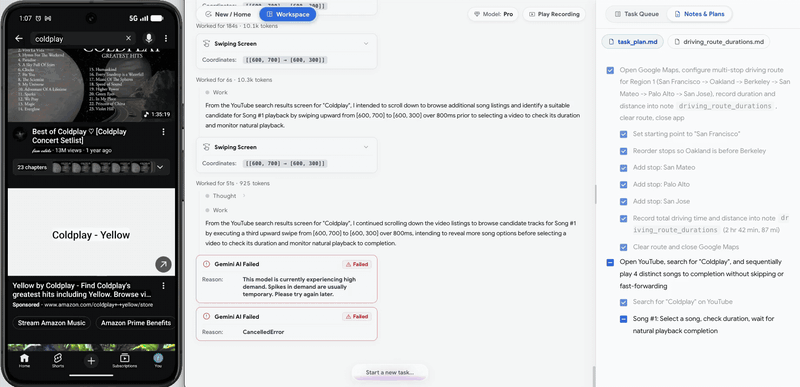
谷歌放大招了!开源AI项目Artemis,让手机自动化成功率飙升到99%
谷歌开源Android自动化AI项目Artemis,在AndroidWorld基准测试中任务完成率达99%以上,支持自然语言指令驱动、双模式执行(Flash/Pro)、MCP协议集成,并具备多模态定位与预执行检查等工程优化能力。项目已引发关于mobile-use代码归属的开源合规争议。