今晚,我们正式发布 Qwen3.8-Flash,这是一个多模态 MoE 模型,主模型参数量为125B,额外配备 51B 的 N-gram Embedding,每 token 激活 6B 参数。 它原生支持 262,144 token 上下文,并可通过 YaRN 扩展至 1M token。
Qwen3.8-Flash 围绕以下四个方面对模型进行了系统升级,在提升模型能力的同时,进一步优化计算效率、模型容量和训练稳定性:
-
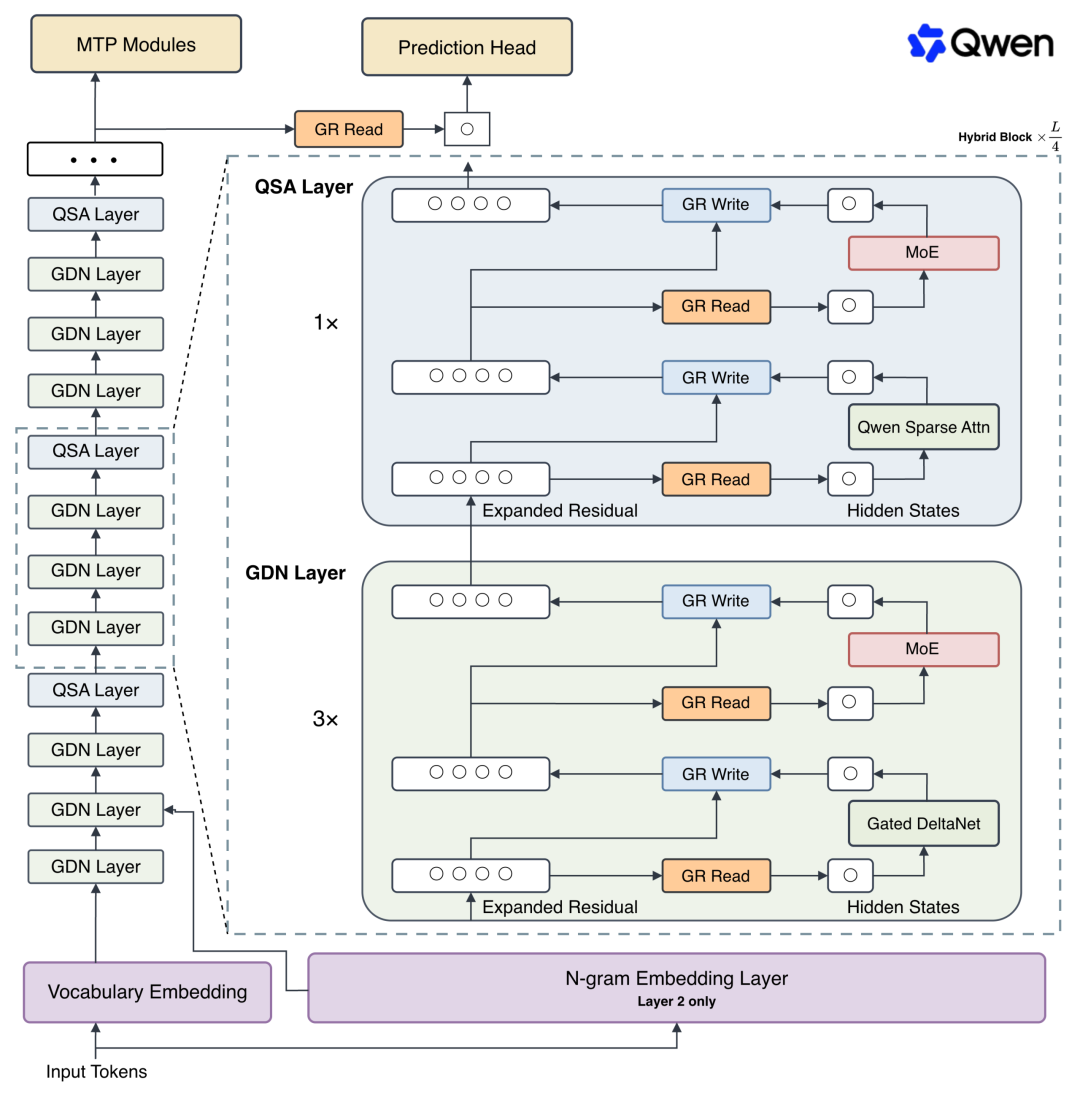
Attention:采用 GDN + QSA Hybrid 架构。Gated DeltaNet(GDN)高效压缩历史信息;Qwen Sparse Attention(QSA) 通过压缩式轻量 Indexer 在 micro-block 粒度上筛选重要上下文,显著降低长序列 Attention 开销。
-
Residual:引入 Gated Residual(GR),将 Residual Stream 扩展为 4 条分支,并通过动态 Gate 控制信息读写,增强跨层信息传递和训练稳定性。
-
Embedding:引入 N-gram Embedding,利用局部上下文进行查表,以很少的额外计算扩展模型容量;Embedding Table 可以卸载到 Host Memory,并通过异步 Prefetch 与模型计算重叠。
-
Optimization:采用 Muon Optimizer,围绕正交化精度、Muon 与 AdamW 的参数分工以及融合参数拆分等策略进一步优化,并针对新架构重新拟合 Scaling Law。
模型权重将在 Hugging Face 与 ModelScope 发布,默认 1M 上下文并内置官方工具的生产版本,以 Qwen3.8-Flash 的形式在千问AI平台提供服务。有关 Qwen3.8-Flash-Next 架构设计、训练方法和实验分析的更多技术细节,请参阅 GitHub 仓库中的技术报告。
Hugging Face:
https://huggingface.co/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921FsyOPe&file=Qwen3.8-Flash-Next
ModelScope:
https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921XAP2dV&file=Qwen3.8-Flash-Next
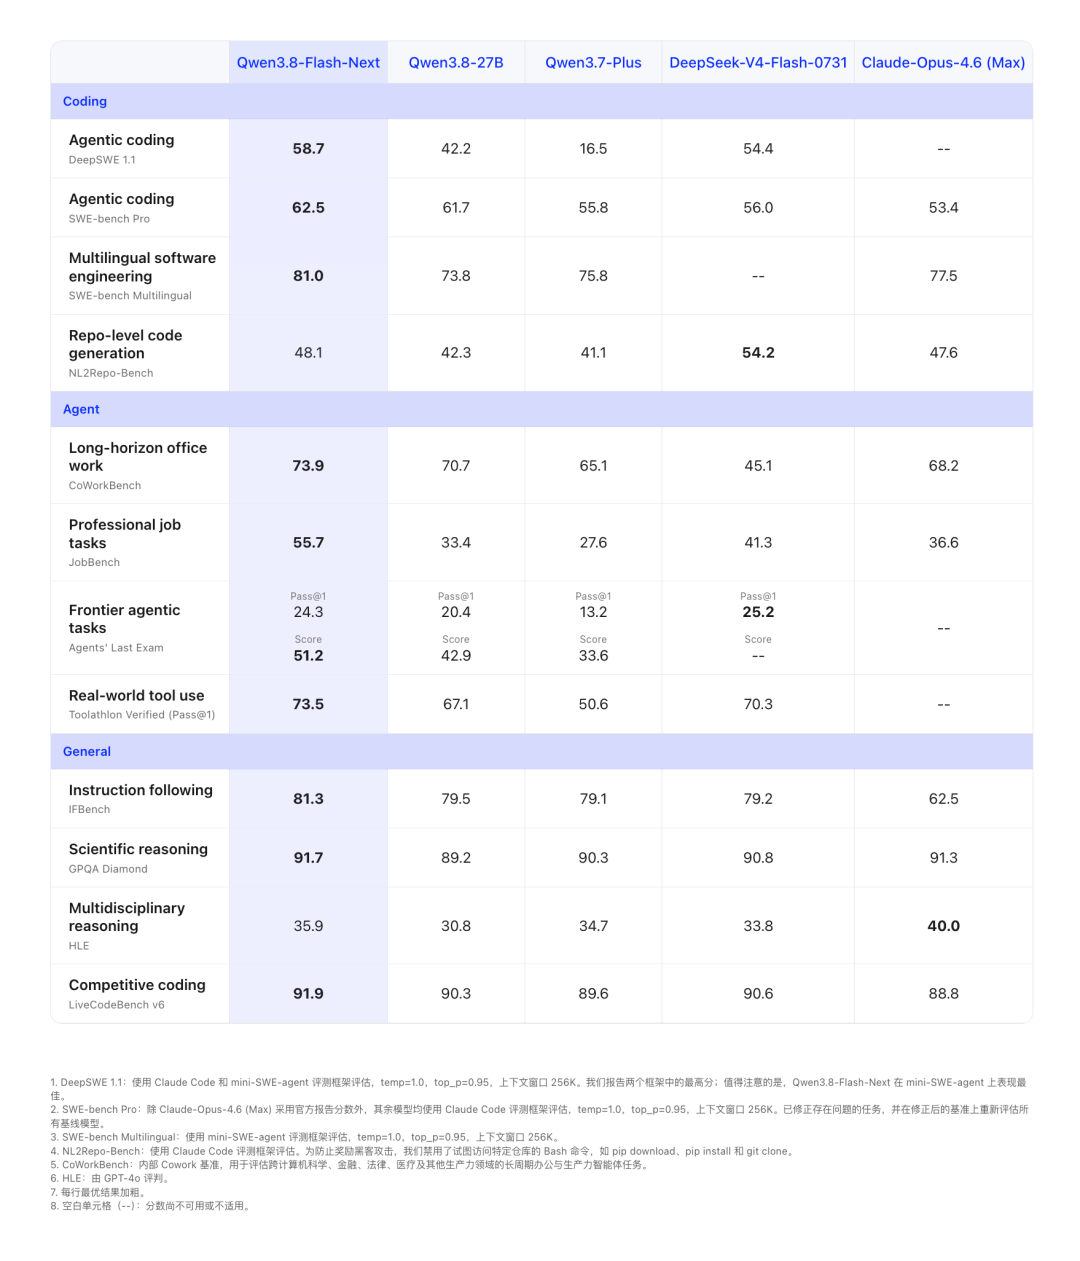
模型表现
纯文本
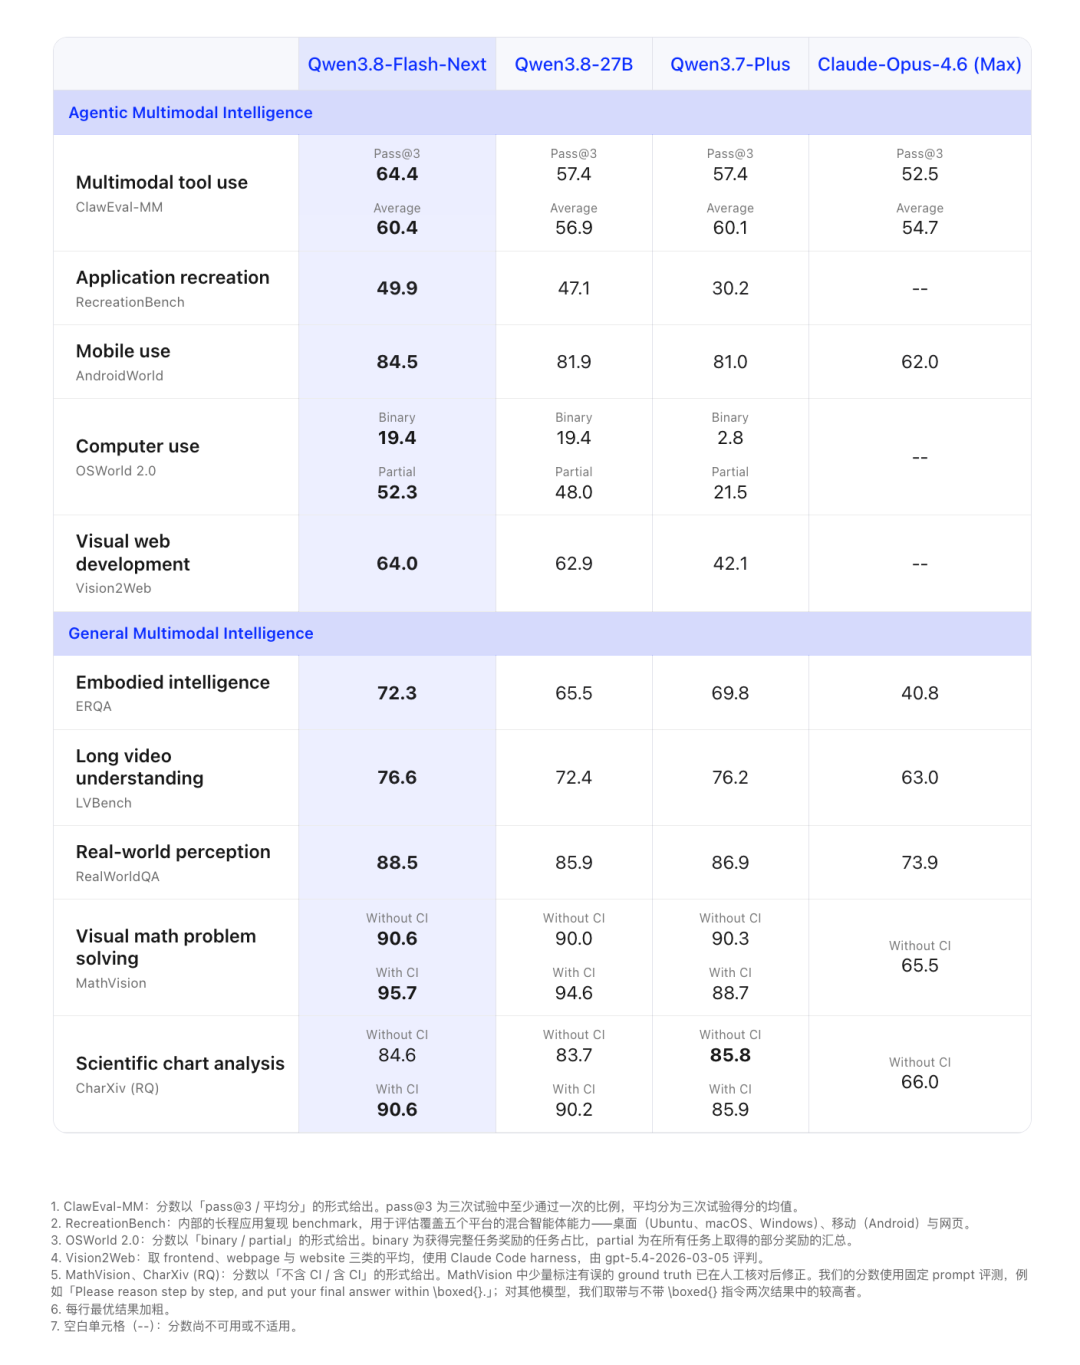
多模态
模型结构
01
Attention:
GDN + QSA,高效记忆与精准检索
延续 Qwen3.5 的架构设计,Qwen3.8-Flash采用 GDN + Attention 的 Hybrid 架构:在每四个网络层中,有三层使用 Gated DeltaNet(GDN),负责将历史信息持续压缩并存储在一个固定大小的循环状态中;剩下的一层则保留全局Attention,负责对全局信息进行精确检索。
针对这层全局 Attention,我们进一步引入 Qwen Sparse Attention(QSA)。Sparse Attention的核心思路是只关注重要的上下文,从而减少长序列的计算量。然而,现有的方案(如 DSA)通常仍需要一个 token 级别的indexer来定位重要位置;随着上下文不断增长,这个 indexer 本身的计算开销也会逐渐变成不可忽略的负担。
QSA 将这一过程进一步的优化与压缩:它使用轻量级的 indexer 先把序列聚合成micro-block,在 block 级别上估计上下文重要性,然后再选出最相关的区域执行 Attention计算。这种做法不仅减少了实际 Attention 的计算量,还大幅降低了“寻找重要上下文”本身的 indexing 成本。此外,与那些跨层共享索引的方案不同,QSA 在每一层内部独立完成序列压缩,对跨层 Attention 相似性的依赖更小,因此完美契合 GDN 与 Attention 交替出现的 Hybrid 架构。
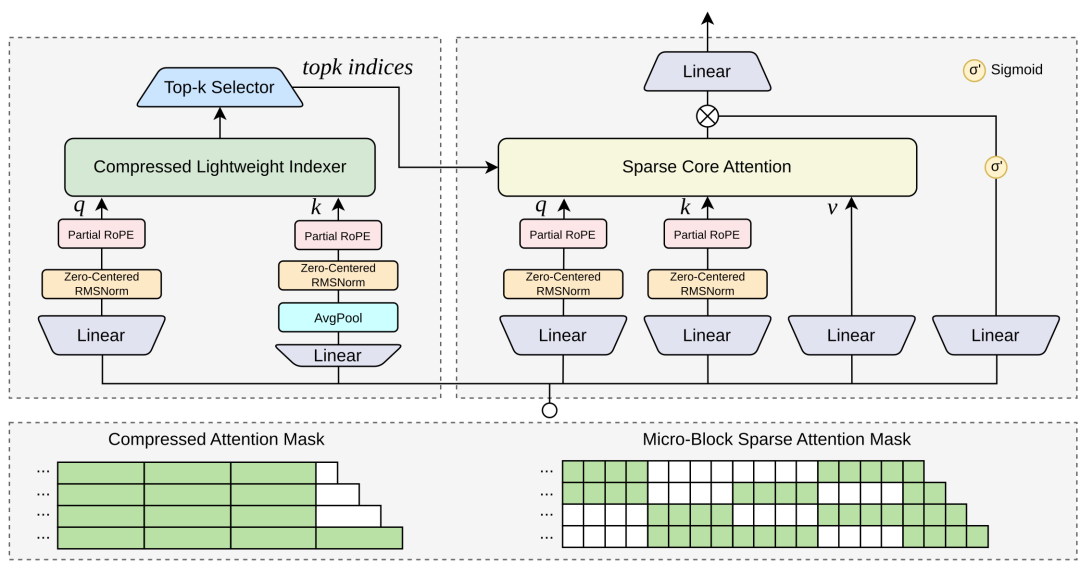
可以简单理解为:GDN 负责高效“记住”,QSA 负责精准“查找”。
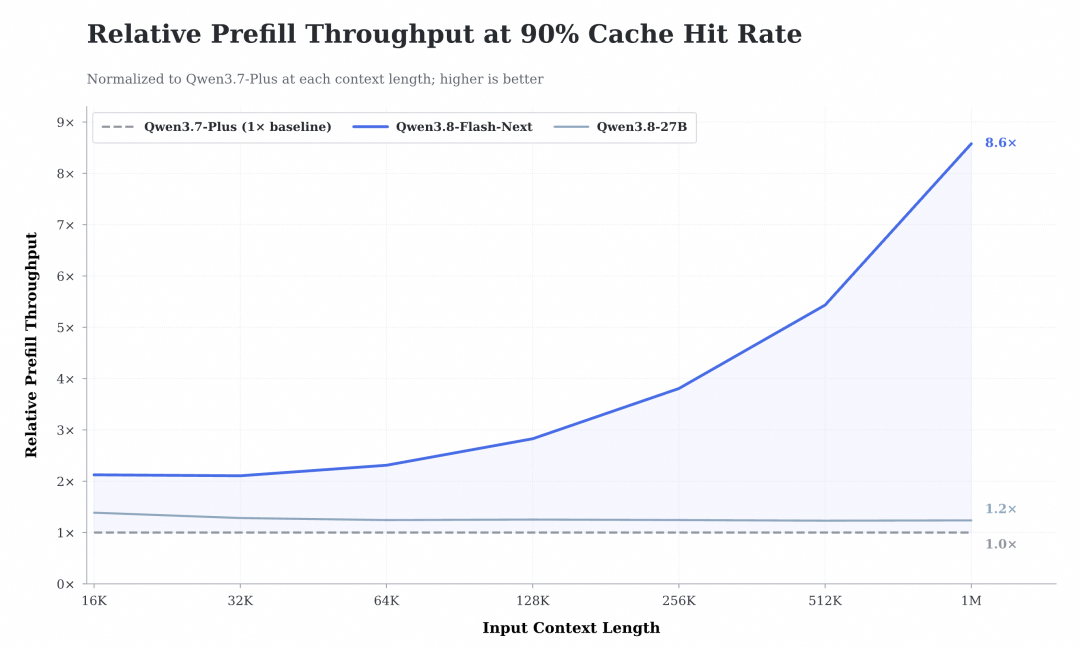
在实际性能表现上,面对 1M token 的超长上下文,QSA 的 Attention Kernel 在 Prefill 和 Decode 阶段分别实现最高 7.6× 和 4.9× 的加速。在贴近线上高缓存复用场景的实验设定下(Prefix Cache 命中率为 90%),Qwen3.8-Flash 在 1M 上下文下的 Prefill 吞吐达到 Qwen3.7-Plus 的 8.6 倍。
02
Gated Residual:
给信息更多传递路径
03
N-gram Embedding:
低成本扩展模型容量
受到 Gemma 3n 中 Per-Layer Embedding 和 DeepSeek Engram等工作的启发,我们进一步引入 N-gram Embedding,从 Transformer 参数之外的维度扩展模型容量。
普通 Embedding 根据单个 token 查表;N-gram Embedding 则结合当前 token 与前几个 token 组成的局部上下文进行查表,这种方式能够为模型中常见的短语搭配和局部语言模式提供更加丰富和精准的额外表示。
它的核心优势是: 可以增加大量参数,同时几乎不增加每个 token 的计算量。
Qwen3.8-Flash 额外引入了 51B N-gram Embedding 参数。由于查询位置可以提前确定,这些参数可以存放在 Host Memory 中,通过异步 Prefetch 与模型计算重叠,无需长期占用 GPU 显存。
04
Optimization:
架构和优化协同设计
Qwen3.8-Flash 使用 Muon Optimizer训练,并围绕三个关键问题进一步优化 Muon 在大模型训练中的使用方式:正交化精度、Muon 与 AdamW 的参数分工,以及融合参数矩阵的拆分。
针对新的模型结构和 Optimizer,我们重新拟合了 Scaling Law。结果显示,模型可以稳定使用更大的 Learning Rate 和 Batch Size,进一步提升收敛效率和大规模并行训练吞吐。
其它架构优化
此外,其余组件沿用 Qwen3-Next 所确立、并在 Qwen3.5–Qwen3.8 系列中不断打磨的设计。
极致稀疏 MoE:在全局负载均衡下,固定激活专家数量而持续增加专家总参数量,可稳定降低训练 loss。因此 Qwen3.8-Flash-Next 采用较大的专家池,每 token 只路由少量专家,并配合一个共享专家。
Multi-Token Prediction:MTP 模块以多步方式训练,保持训练与推理之间的一致性,从而提升实用场景下speculative decoding的接受率,同时也提升主干本身的性能。其中的全注意力层同样被替换为 QSA。
训练稳定性:保留 Zero-Centered RMSNorm 并对 norm weight 施加 weight decay、注意力输出门控机制,以及 MoE router参数初始化的归一化。这些设计使小规模消融结果更为可靠,也有助于大规模训练平稳进行。
Base模型表现
我们将 Qwen3.8-Flash-Next-Base 与 Qwen3.8-27B 及 Qwen3.7-Plus 的 base 模型进行比较。
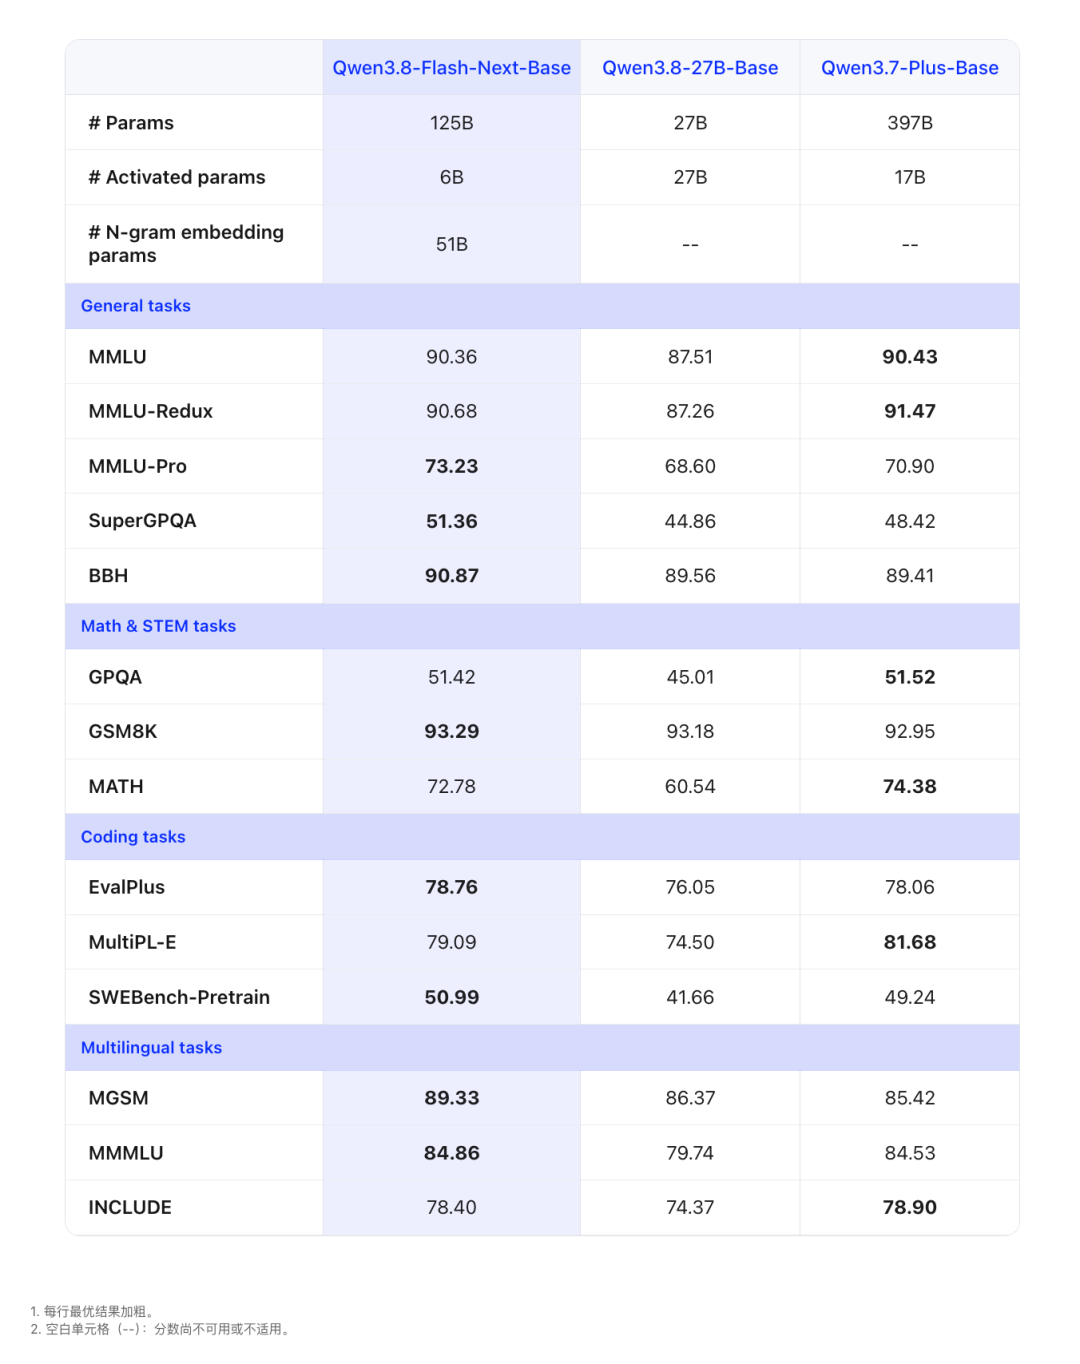
在 6B 激活参数下,Qwen3.8-Flash-Next-Base 在 14 个 benchmark 中的 8 个上取得最优结果,包括 MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain、MGSM 与 MMMLU;在 MMLU、MMLU-Redux、GPQA、MATH 与 MultiPL-E 上与 Qwen3.7-Plus-Base 接近。其中 51B 的 N-gram embedding 参数是确定性寻址的,不进入每 token 的矩阵乘预算。
总结
Qwen3.8-Flash-Next 在 Qwen3-Next 所引入的混合架构之上,沿 Attention、Residual、Embedding 与 Optimization 四个方向作了扩展。
QSA 在每一层内部将序列压缩为 micro-block,在保持精确检索能力的同时,降低了长上下文下的注意力开销与 indexing 开销。
Gated Residual 将残差流扩展为多条并行分支,并以逐元素的动态门控控制读写,在算术开销可忽略的前提下改善跨层信息传递与训练稳定性;残差状态还可以保存为 FP8,进一步降低访存量。
N-gram Embedding 以确定性寻址的查表记忆扩展容量,可以在几乎不增加每 token 计算的前提下扩展,并卸载到 host memory。
优化方面,Muon 作为主优化器使用,其中正交化精度、参数分工与融合矩阵拆分是决定性的实现选择,我们也针对新架构重新拟合了 Scaling Law。
关注我,掌握千问大模型最新动态
