从数据的角度,去看这个世界,获取到自己想要的信息
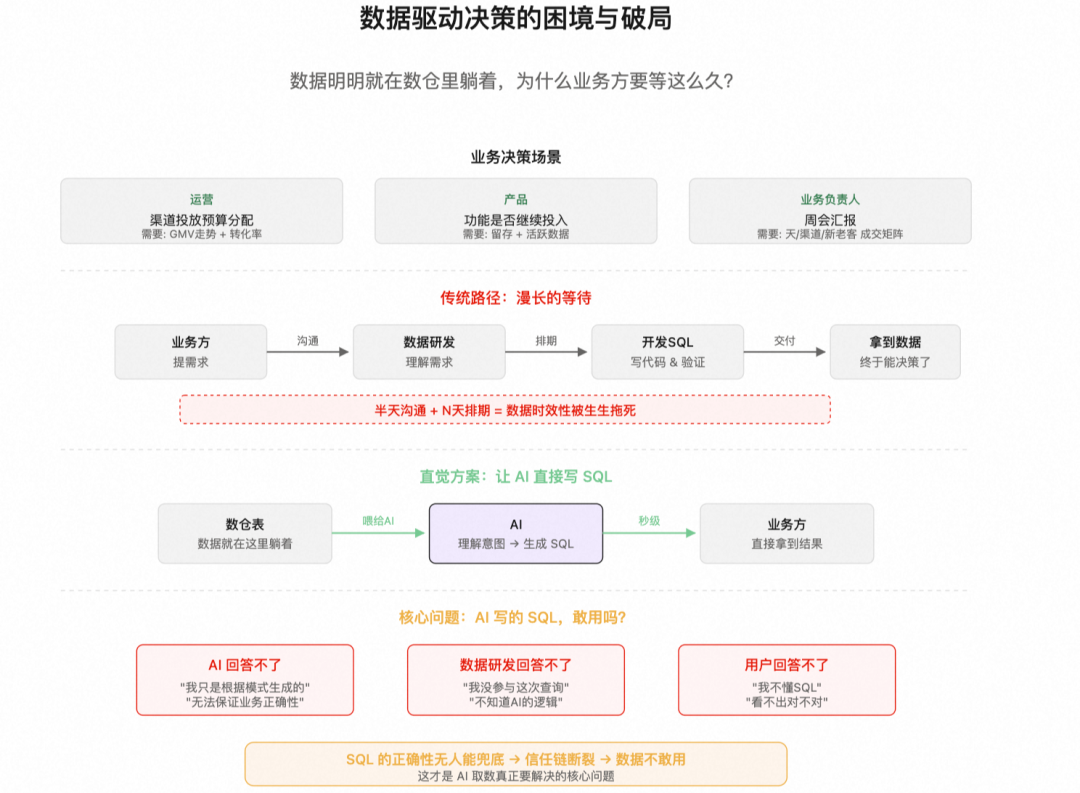
业务每天都会产生大量的用户行为数据,这些数据都经由数据工程师的加工处理放在数据仓库中,有了这些数据可以让我们的业务决策变得更加合理,科学。但是这些数据已经在数仓了,但是业务一般情况下还是要等较长的时间才能看到想看的数据,为啥取个数这么难呢?
代号:物理事实的抽象代表
代号:物理事实的抽象代表
在语言学上,我们为了交流的方便,都会为一些复杂的东西,起一些代号,这些代号是物理事实的抽象代表,代号在我们的生活中处处可见,比如各种名称:人名、地名、物名等等。
在本文中取数语境中的核心代号都代表什么的含义。先看下两个核心抽象的代号:指标是什么:业务主体行为的度量;维度是什么:业务主体行为发生的环境。指标名、维度名是具体的代号。比如"用户在直播平台成交了多少钱"这个业务度量的代号是"成交金额","用户从哪种方式进入直播的这个行为环境"是"渠道名称"这个代号,这些代号就代表的是具体业务,都是具体的、真实的事件行为。很多约定俗称的代号,不用沟通解释大家都能对齐,但是一些专业的代号,或者一些事件行为,没有一些标准的代号名称,我们如果用这些各自理解的代号去沟通,去交流,那我们很难去沟通交流
真实场景
真实场景
1)比如现在用户需要一个成交金额,数仓中刚好只有一个成交金额,我们就默认这个就是用户想要的那个成交金额,直接找到成交金额的这张表,基于这个表来组装出来SQL然后去执行,SQL执行返回结果
2)现在问题复杂了,用户说我要gmv,但是数仓中只有成交金额,我们就要去问,我们只有成交金额,你要的是不是成交金额,我们来说明下成交金额描述的事实行为,用户说下他想要的事实行为,达成一致,找到成交金额的这张表,基于这个表来组装出来SQL然后去执行,SQL执行返回结果
3)接着,用户说我要gmv,但是数仓中有两个成交金额的指标,但是计算方式不一样(一个限制了 字段A= 'Y',一个没限制),又要去问,你想要的成交金额是怎么计算的,这两个指标的代表的事实行为是啥(数据口径是啥),是不是你想要的计算方式,好的,用户明确了我要限制字段A='Y'的,好的找到字段A = 'Y' 的那个指标口径,写出一段SQL,SQL执行返回结果
流程抽象
流程抽象
其中的核心流程是:用户说他要什么(一个代号),这个代号代表一个业务行为的度量方式。数仓有什么(一堆代号),这些代号都分别代表的业务行为的度量方式,其中还有很多不同的度量方式,用着同一个代号。有时候用户说的代号和数仓中的代号是对齐的,但绝大多数是对不齐的,代号对齐了,还要明确代号所代表的具体的事实行为是不是对齐了。这部分对齐是取数的第一步,明确清楚业务想要的是哪个具体代号。第二步,写一个SQL,将这个代号的数据取出来
取数流程中有一个最核心的矛盾点:同一个东西的代号没有标准、没有达成共识
现在是要AI来完成这一流程:用户说出他想要的代号,AI进行语义理解,理解了用户想要什么。AI理解数仓,数仓中都有什么代号,并且理解清楚每个代号的具体含义。理解清楚之后将用户需求的代号和数仓中的一个代号匹配起来了,然后写一条SQL 返回给用户。在小批量表并且取数需求相对简单的场景下,AI的发散空间相对较小,单独使用AI完成这一流程,可信度还是比较高。但是在复杂的场景下,AI在完成这一流程的过程中就会遇到很多问题,首先AI理解用户语义,这个是AI理解自然语言的能力,模型本身的能力,这个强弱我们无法控制。但是接下来AI要理解数仓中的事实行为代号,理解完要写SQL,就会出现较大的问题
理解数仓很难避免幻觉
理解数仓很难避免幻觉
数仓是业务的数据抽象,业务的不断发展变化,业务的看数视角是不断变化的,决定了数仓是不断变化的,这些变化体现在数仓中就是:数据的事实行为描述越来越多、数仓不断的冗余、数仓表的不断膨胀,复杂性极大,具体到业务需求不知道应该用哪一种计算方式,只能不断的去确认沟通,这样的数仓复杂性,多义性让AI理解的话,幻觉极大,很难正确理解数仓中事实行为代号(数据口径)的现状
写出SQL更难避免幻觉
写出SQL更难避免幻觉
基于第一层理解数仓数据口径的基础上,叠加真实的取数需求,进入第二个问题:AI怎么写SQL。数仓是冗余的,同一个指标代号的计算方式是多样的,决定了取数SQL会涉及到很多的选择决策,比如指标计算口径确定、表选择,维度计算口径、表选择、数据筛选等等。这一步需要在第一步的基础上,再理解需求,进行很多的SQL决策,才能写出来一个语法正确、语义正确的SQL
AI 可以生成语法完美但语义错误的 SQL ,通过各种手段可以在很大的程度上做到70%,80%,甚至90%的正确率。这些正确率,听起来是好的,在评测的领域中就很好的成绩,但是在生产环境中呢,也就是意味着永远有错的可能,而用户是不知道这一次是对的,还是错的
此外,取数系统能发挥出最大的价值的点在于:这套系统的用户不是数据开发,而是运营、产品、分析师,甚至是 AI Agent 本身 ,他们无法判断一段 SQL 是否完全语义正确。如果系统的可靠性依赖于"有人会审 SQL"这个前提,用户并没有被解放,SQL必须无须确定,用户只确认,语义自己是不是想要的,只确认业务方面的知识,不需要关心这个数怎么取
各取所长:AI的思考能力+工程的确定性
各取所长:AI的思考能力+工程的确定性
AI不擅长的事情:精准的完全确定的输出;工程擅长的事情:确定性的输入产生确定性的输出,用工程的强确定性来弥补AI的不确定性
针对AI怎么理解数仓中的事实行为代号?我们对数仓进行抽象规整,建设代号层,让AI有一个清晰、易用、便于理解的数据
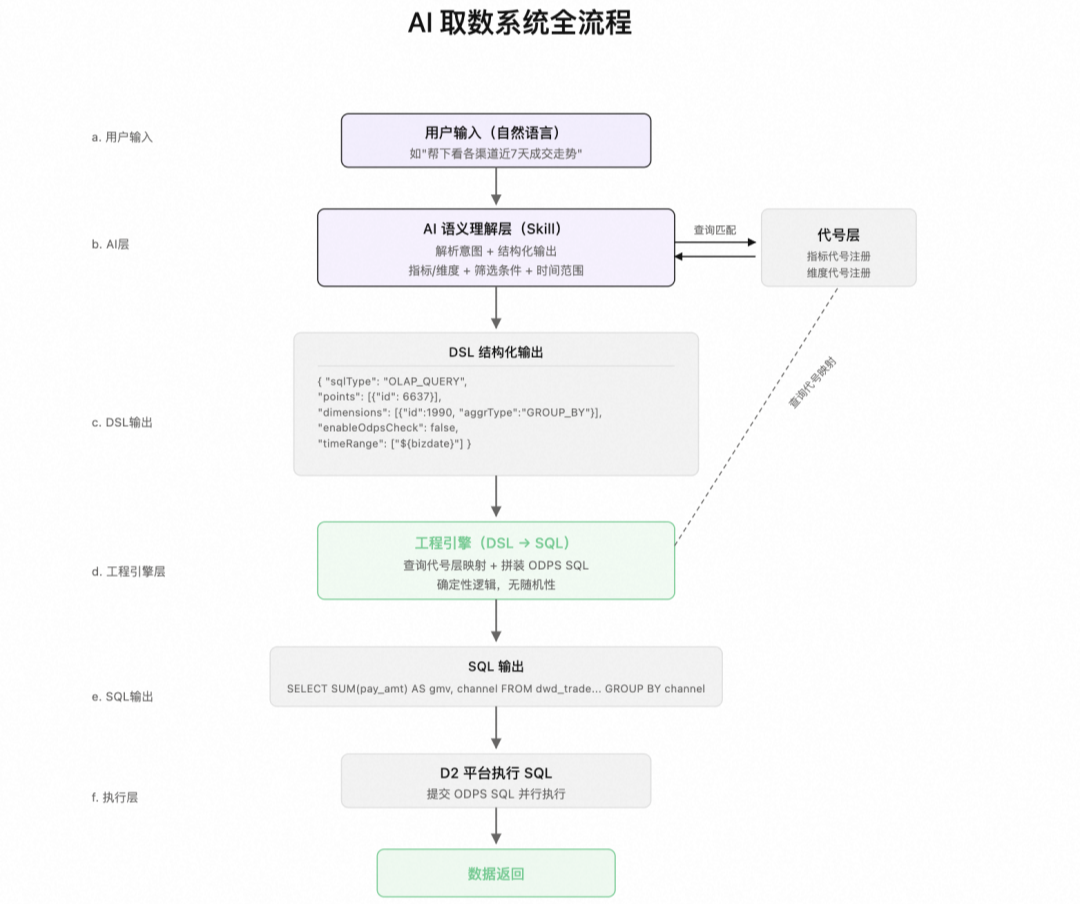
针对AI怎么写SQL?我们将写SQL的复杂性屏蔽掉,只让AI输出用户的需求,构造一个查询请求(轻量级的JSON),工程将查询请求翻译为确定性SQL
▐ 整体流程图
▐ 整体流程图
▐ 为什么值得信任
▐ 为什么值得信任
每一环都有明确的角色来确认,保证整体流程可靠、值得信任
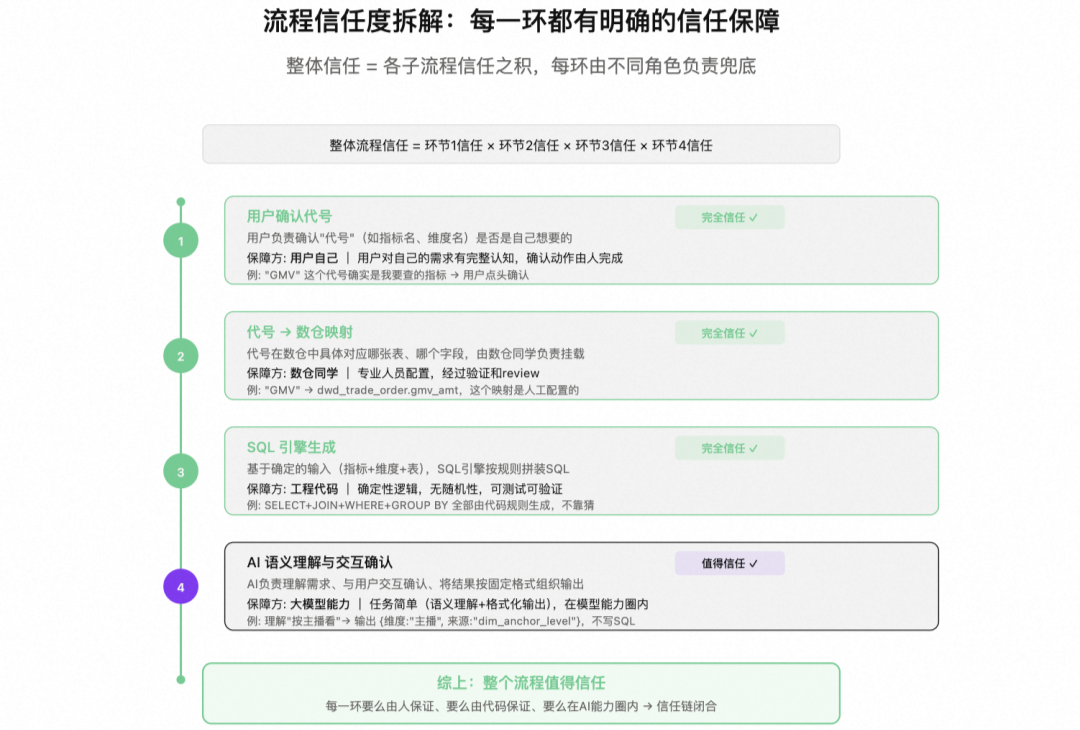
各环节的判断力
各环节的判断力
在代号对齐环节,用户需要判断这个代号是不是自己想要的
在代号数仓映射环节,数仓同学需要判断这个代号在数仓中的口径是什么
在SQL引擎生成环节,SQL引擎需要判断SQL的组织是不是语法语义正确的
对用户的要求有所变高
对用户的要求有所变高
在现在的全链路协作的过程中,用户可以提一个相对模糊的取数需求,或者说截一个图,或者说可以给某某去确认,研发的主观能动性,会去通过各种方式,和用户沟通收集信息把这个需求澄清完毕。但是现在AI取数系统的流程中需要用户自己根据AI理解代号层的结果,然后和用户对齐代号,用户需要对AI对齐的代号有判断力,要和AI对齐自己的真实意图。这其中也变相对我们的代号层的质量有很高的要求,不能有二义性,要具有含义代表唯一性
▐ 通过AI Agent平台直接使用
▐ 通过AI Agent平台直接使用
Skill作为现在Agent主流的扩展能力,在任何的平台都可以集成使用,同样的我们的取数技能在Claude Code、Qoder等Agent平台上都可安装使用
代号层 — 让同一个东西的代号有标准、达成共识
代号层 — 让同一个东西的代号有标准、达成共识
业务行为的标准、唯一的数据代号化表达。比如"在直播间成交的金额" 这个业务行为的代号就是"成交金额",只有这样的一个名称
代号集,定义的就是这样一个映射关系,本质也是一个字典。通过这个直播数据大字典,我们可以对很多直播下事实达成共识,用一种代号来表达。我们基于阿里巴巴这个词沟通就不会有歧义,因为大家都知道阿里巴巴代表的是什么物理世界的东西。战争时代通过无线电进行发报,也要按照统一的密码来进行沟通,沟通双方也要定义好双方共同认可的密码本
▐ 在系统中的定位
▐ 在系统中的定位
对于系统中的AI来说,代号层就是一个沟通的共识层,"统一了直播数据事实的文字",让AI和用户可以用同样的一种语言和用户沟通,解决取数中代号对齐问题
对于系统中的SQL引擎来说,代号层就是一个数仓映射层,让代号回归到数仓,让代号具体落实到数字物理世界,解决取数中SQL书写问题
▐ 代号层的结构如何
▐ 代号层的结构如何
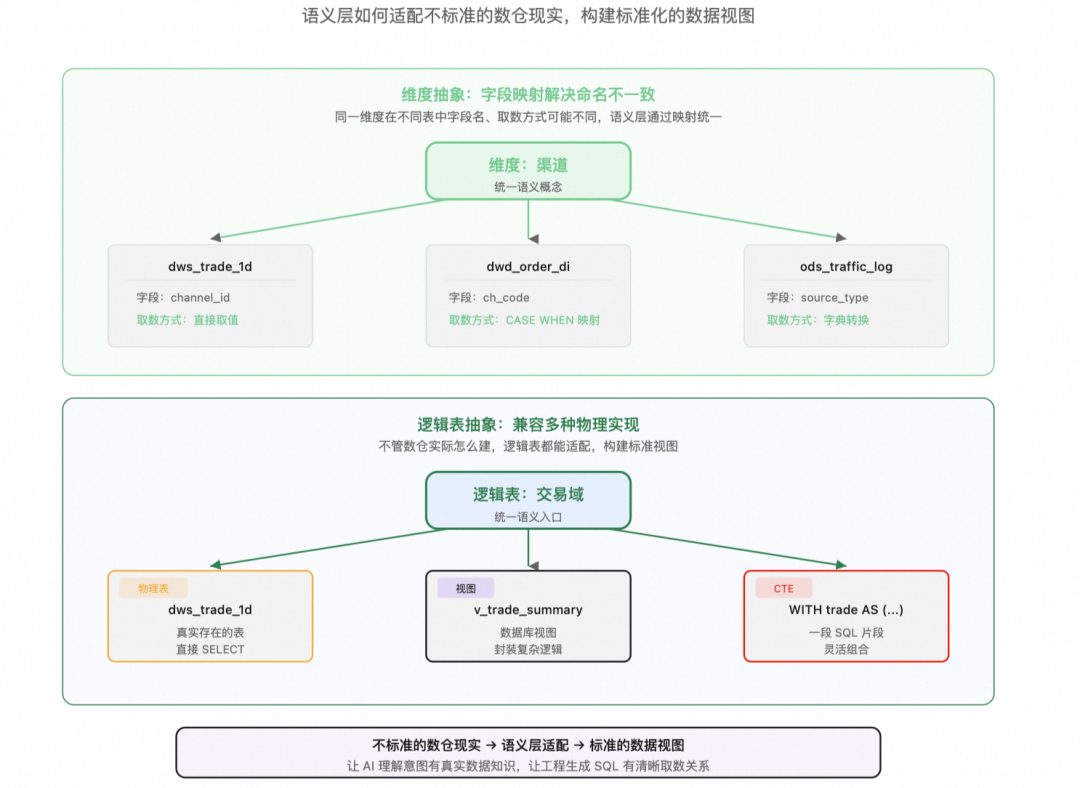
我们以逻辑表为核心来构建我们的代号层。逻辑表就是整个代号层的骨架,从整个数仓的角度来说,本质是对业务过程的又一次抽象
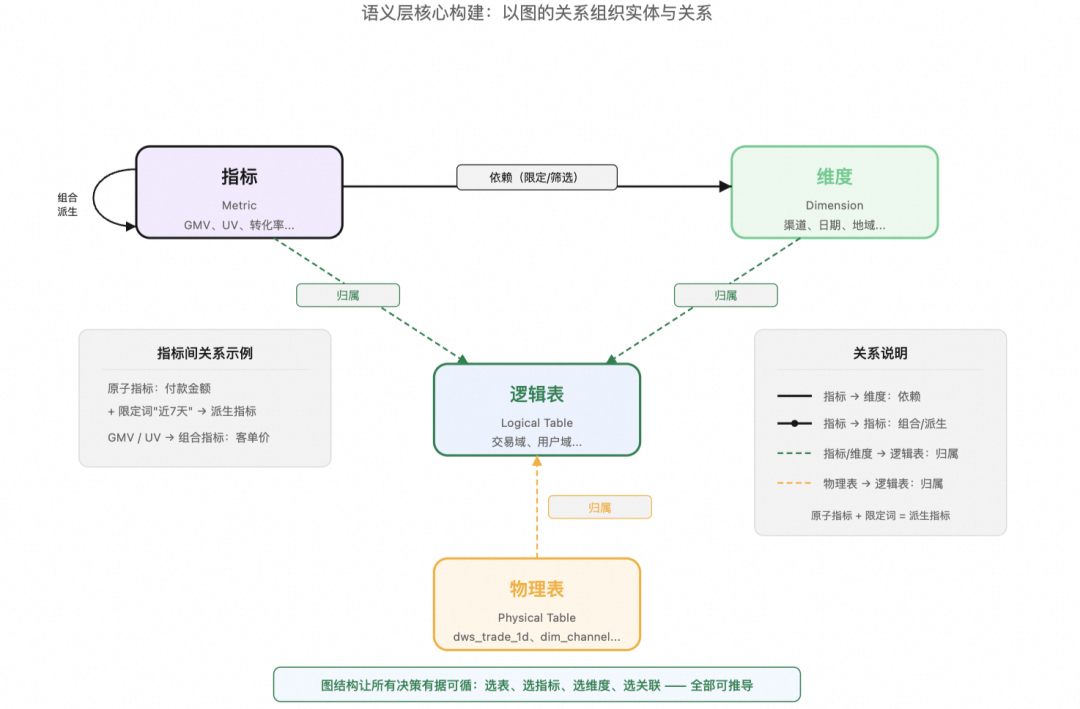
▐ 真实的数仓怎样挂载到代号层
▐ 真实的数仓怎样挂载到代号层
对于同一个代号,数仓中都是有好几份的,是冗余存储的,冗余存储是数仓的一个核心特性
从大的逻辑上来说,核心分为事实表和维表。其中事实表是按照业务过程的来组织的表,业务过程就是业务时间行为的抽象集合。比如成交的业务过程,有明细表、各粒度的dws汇总表;同样的观看业务过程,有明细表、各粒度的dws汇总表。维度表核心有:各个实体的维表。比如主播维表、用户维表、商品维表等等。这个就是数仓的骨架部分,是这个数仓的核心
表所承载的都是维度和指标。这些维度和指标都是上文中代号的具体的数仓实现。比如成交金额这个代号,就在成交业务过程的明细表中的一个字段、在dws汇总表中的一个字段。这些具体的表字段,成交金额这个代号在数仓中的事实体现。也就是说,用户需要成交金额这个代号的时候,我可以给用户其中的任意一个都是对的,都是同一个事实的表达。所以数仓中的这些字段都会绑定在成交金额的这个代号上。同样的维度也是,同一个维度代号也是在数仓中的很多地方都是有的,很多数仓事实字段都可以表达出来这个代号
我们的代号是按照业务过程的标准组织的,如果真实的数仓也按照这个组织的标准去建设的话,那很完美的就可以进行对接。但是如果不标准,其实也没问题,只要能从标准中的数仓中抽象出来这些代号的具体实现就行。我们的代号层也设计了字段映射,自定义CTE等功能,来从逻辑上讲不标准的数仓,挂载到标准的代号层
SQL引擎 — 如何去写出来取数的SQL
SQL引擎 — 如何去写出来取数的SQL
SQL引擎 — 如何去写出来取数的SQL
在真实的数仓中,写SQL,也是一件看似简单,其实有超级多的细节选择的问题,并且都是确定性的规则,工程是最佳的,最值得信任的保障
用户通过和AI的交互,已经从标准的统一的代号库里面,取到了他想要的那一个代号,这个代号已经唯一确定了,接下来的核心动作就是拿到这个唯一的代号,从已经挂载到这个代号层的物理数仓,拿到这个统一的代号集,然后根据具体的实现方式,构建出来一条SQL
▐ 代号在数仓中具体化、唯一化
▐ 代号在数仓中具体化、唯一化
▐ 代号在数仓中具体化、唯一化
整体的选择的目标就是:在能正确满足需求的情况下,找到一种最快的计算方式,也就是找到一种参与计算数据量最小的一种方式。选择整体分为两步:
收集本次需求的具体数仓要求
在满足要去的表中,选择一张最优的
▐ SQL组织
▐ SQL组织
▐ SQL组织
上面通过收集要求、按照数仓加工规则选择出来每个代号的具体表达,接下来就是按照标准SQL语法,将这些进行SQL组织。其中也有很多的细节,比如筛选提前做。如果有关联需要关联维表,还要确定关联方式。派生指标要先加工原子指标,先加工限定词,然后再后面的一层加工。如果有limit 还有需要在结尾添加limit语法
▐ 监控分析
▐ 监控分析
▐ 监控分析
有了这一套SQL引擎工程体系,我们将用户的查询记录下来。我们可以中心化将这些请求的日志,忠实的记录下来,然后做一些常用DSL的分析,工程稳定性的监控,为后续的数仓迭代,DSL能力覆盖范围迭代、评测系统构建等场景提供数据源支持
Skill:将AI拴在流程的笼子里
AI很强,但是很容易乱干,自以为是的去干,要设计一套让AI沿着工作的流程
▐ 门禁机制
▐ 门禁机制
▐ 门禁机制
有了上面的确定性的基础,我们怎么让AI确定的生成我们要的JSON结构呢?在这一步的核心风险点是,AI自己去查资产层会出现二义性或者多义性的情况。
在出现高歧义的情况下,必须要停下来去向用户确认,必须要遵循这个前提,不允许自己做决定。在生成SQL的过程中,AI只需要拿到工程生成的SQL,不允许修改任何SQL,一边需要用户确认,另一边生成的SQL不允许修改,最大限度的缩小AI发挥的空间
▐ 可审计回溯
▐ 可审计回溯
▐ 可审计回溯
我们在很多的关键流程节点都增加了过程留痕,比如查询到实体需要留痕、生成的JSON要保存下来、生成的SQL要保存下来,让每一步都可以追溯,AI也可以自己检查
▐ 钩子机制
▐ 钩子机制
▐ 钩子机制
在现在的Agent平台上,不管是Claude Code、Qoder、Codex都会有工程钩子的设计,这些让Agent在执行到某些动作的时候直接强制执行某段逻辑,让AI的可靠性持续增强
回到信任
回到信任
▐ 信任不是给予的,是构建的
▐ 信任不是给予的,是构建的
▐ 信任不是给予的,是构建的
设计让AI值得信任的系统:我们的这套系统正式构建了一个值得信任的基础设施,我们整个系统也是一套AI系统。不管是语义层的基建,工程引擎的确定性生成,还是Skill中的门禁等等,都是为了信任而构建的一全套基础设施。在AI时代,从AI系统的角度来说,工程师最重要的能力不是使用 AI,而是设计让 AI 值得信任的系统
信任基建可以参与构建其他的信任系统:有了AI取数的这个值得信任的基建,下游数据消费想象空间非常丰富。运营、产品各个业务就可以直接快速的获取到自己想要的数据;下游的分析Agent可以直接对接我们的这个取数skill,直接产出分析结论;更进一步,甚至运营工作台也可以接入,看取数基建作为行为系统的一部分,信任基建可以参与构建其他的信任系统
▐ 传统协作关系的变革
▐ 传统协作关系的变革
▐ 传统协作关系的变革
研发工作重心变革:信任的不断建立,让数据开发同学从"写 SQL 的人"变成了"建语义层的人",核心工作从重复性的取数开发,转变为高价值高复用性的语义资产建设和数据质量管理
组织协作变革:随着技术的发展,信任程度越来越高,一台机器可能重塑一个行业的协作方式:比如一台印刷机就代替了传统的印刷行业,印刷的效率极大提高,让用户更专注于你要印什么,而不用花太长时间去和印刷工人沟通交流这些要怎么排版,去怎么印,这个用户自己在印刷机就可以自行决定,让价值更着眼在用户要印什么~~~
