OpenAI 首席科学家 Jakub Pachocki 近日在公开文章中给出了一个分量很重的判断:基于内部结果,他强烈预期,当前的进步速度可能延续到递归自进化(RSI)阶段。他进一步写道,OpenAI 正将研究重心朝 RSI 推进,因为他们认为,这是未来保持 AI 研究前沿地位的必经之路。
前沿竞争正在指向一个更深的问题:
今天的 AI,如何参与制造更强的下一代 AI?
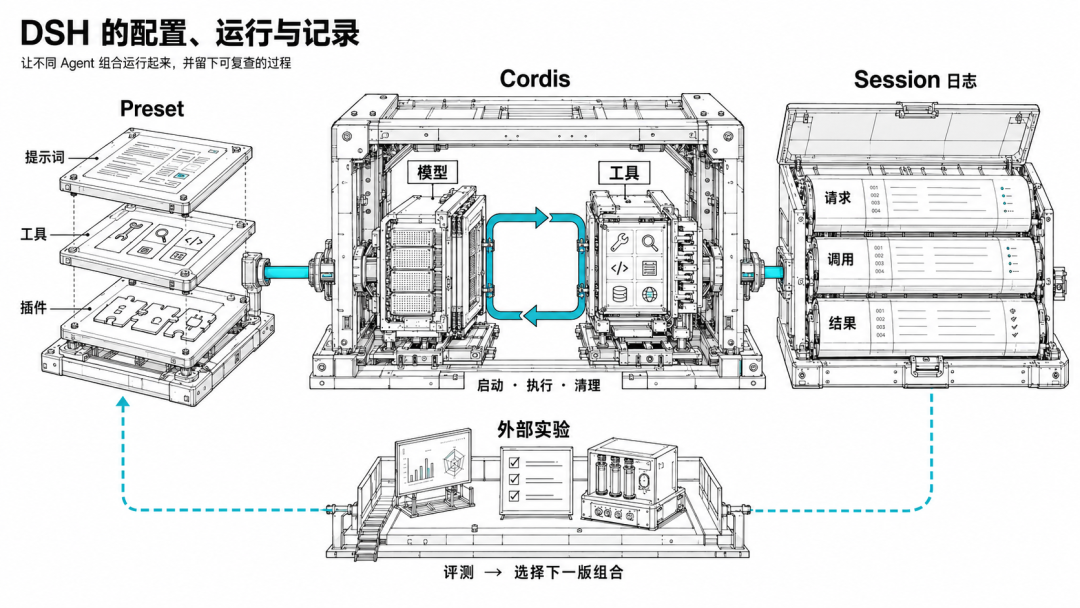
受到社区广泛关注的 DeepSeek Harness(下文简称 DSH),为探索 Agent 如何改进自身运行方式提供了一个具体样本。它将 Agent 的运行机制开放为可替换、可组合的插件,连负责组织模型请求与工具执行的循环也可以调整。同时,DSH通过 Session Log 保存执行记录,为分析任务成败和后续的改进提供了依据。
两者结合,使它自然成为探索 Agent 自我改进的一种基础设施:Agent 可以利用自己的执行经验,参与修改驱动自身运行的 Harness,再用修改后的系统执行下一轮任务。
从 Agent = Model + Harness 的视角出发,AI 参与制造下一代 AI,既可以通过模型训练,也可以通过改进 Harness 展开。在我们看来,DSH 的设计让 Agent 能够在持续运行中,以更大的修改范围参与自身改进:无需重启或重新编译,就能动态调整工具、插件乃至执行循环,使 Harness 的运行与演化同步发生,为探索递归自进化提供了工程起点。
本文结合源码、社区中的设计讨论、实际编码实验和自进化研究,分析 DSH 如何组织 Agent 的运行,Harness 的调整怎样影响任务表现,以及组件替换与运行记录机制,如何为 Agent Self-Improvement 乃至 RSI 提供工程支持。
01
Agent Preset 的配置体系与执行模式
DSH 的 Web Profile 通过 Agent Preset 组织每个 Agent 的提示词、工具、Skill 和 Agent 侧插件配置。官方提供四种模式:Standard(标准模式)、Minimal(极简模式)、PTC 模式和 Creator(创造模式)。后文将详细介绍这四种模式的配置与执行方式。
· 公共运行环境与 Agent 配置
命令时,DSH 通过 Cordis 装载 Web Profile,加载会话、模型路由、沙箱、工具注册表与 Web 服务,形成 Host 运行环境;然后根据用户选择的 Preset 创建 Agent。多个 Agent 共用 Host 服务,各自保留 Preset 提供的提示词和工具范围。而作为一次性任务入口的 headless profile 同样通过 Cordis 装载预先组合的插件配置创建一个 Agent,执行命令行传入的任务后输出最终答案并退出;它不提供 Preset 选择功能。两种入口采用不同的插件组合,也体现了 DSH 通过 Cordis 按运行场景组织和装载组件的能力。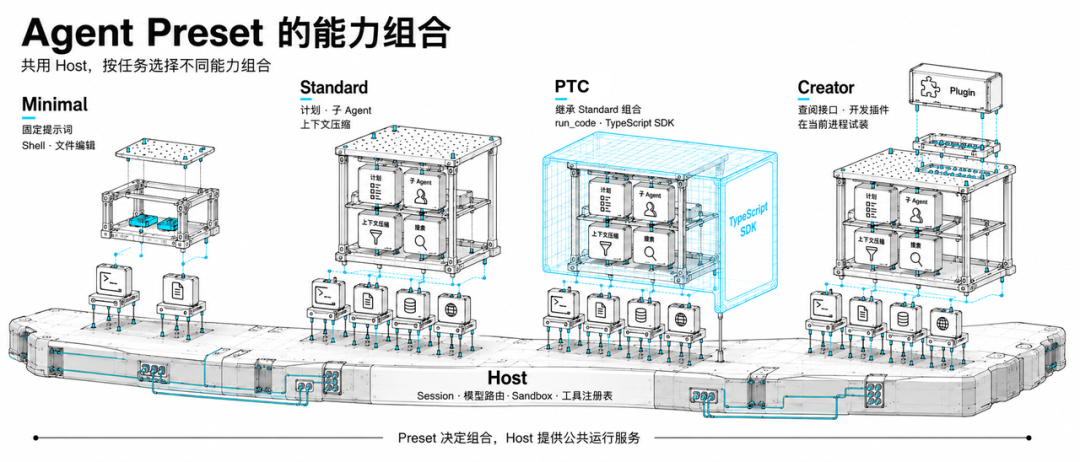
Standard 是 DSH 预置的一套完整 Agent 配置,提供 Shell、文件读写、代码搜索、图片与网页查看、后台任务、目标、计划、待办和子 Agent 等能力。
Minimal 采用固定提示词和双工具的极简配置:完整 persona 直接构成系统提示词,不追加运行时上下文,模型只获得持久 Shell 和文本编辑工具。在 DeepSeek 于 2026 年 7 月 31 日公布的官方评测中,V4-Flash 搭配 Minimal 模式,在 Terminal-Bench 2.1 和 DeepSWE 上的得分分别为 82.7 和 54.4。评测采用 max 推理档位,设置 top_p=0.95 、temperature=1.0 。
· PTC 模式的程序化工具调用
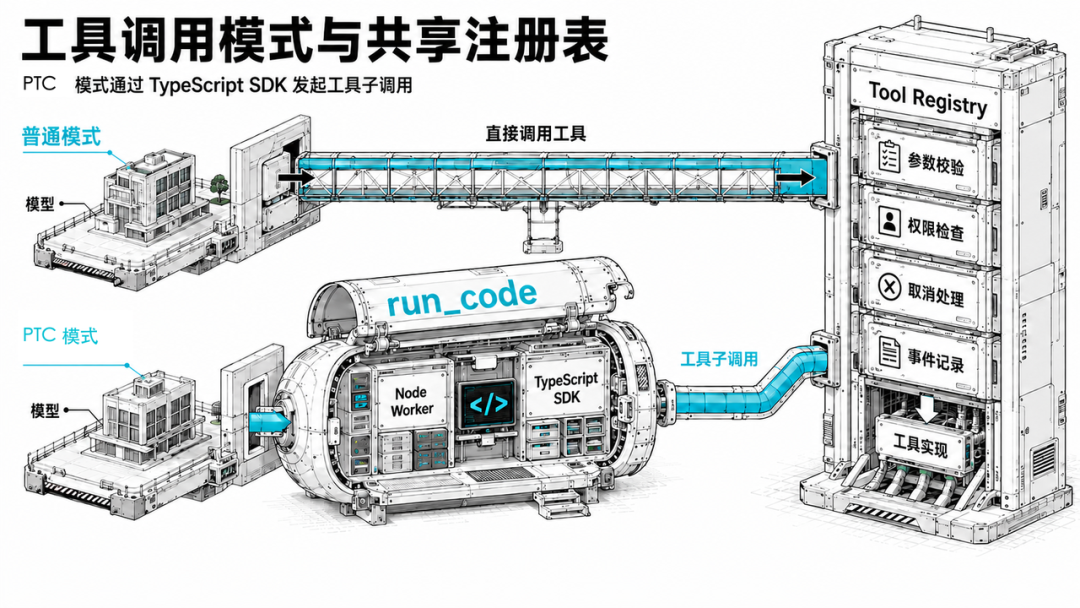
· Creator 的插件开发与版本试装
· 三种Preset 的任务表现
deepseek-v4-flash 和 DSH 0.1.2-alpha.1,分别采用 Minimal、Standard 和 PTC三种模式执行 Terminal-Bench 2.1 和 DeepSWE 中的任务。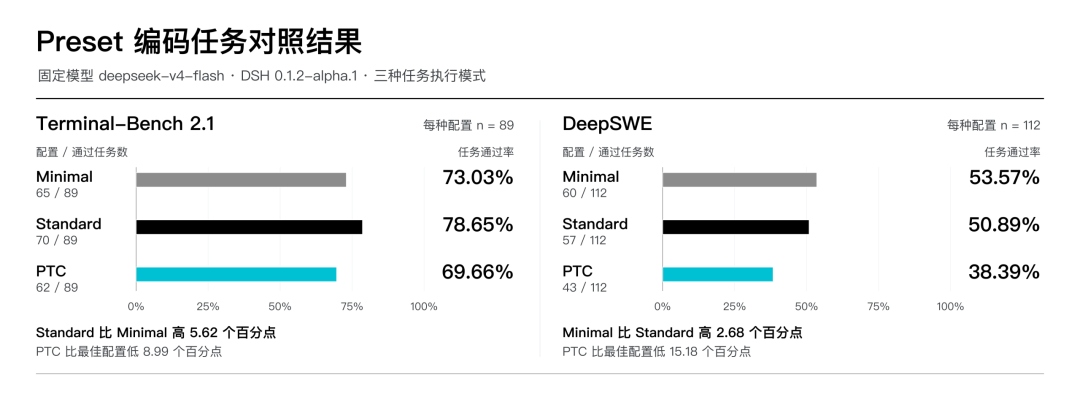
PTC 在两项评估中的通过率均低于最佳配置,分别相差 8.99 和 15.18 个百分点。逐题结果显示,不同配置的优势会随任务变化,PTC 也完成了部分其他配置未完成的任务,汇总通过率不能单独说明一种模式对所有任务都更适用。接下来从 PTC 轨迹中的工具调用、程序执行和错误恢复入手,分析当前模型与程序化调用方式的适配情况。
· 程序化调用的收益与适配模型
read 等普通工具的尝试,共产生 393 次接口拒绝;另有 47 条因遗漏 run_code 必填参数被拒绝 267 次。128 条出现程序语法错误,60 条出现运行异常,112 条出现执行完成但无返回内容的情况。各类计数存在重叠。这些错误会让模型重新生成程序、再次调用工具,或无法确认结果,因而增加执行开销。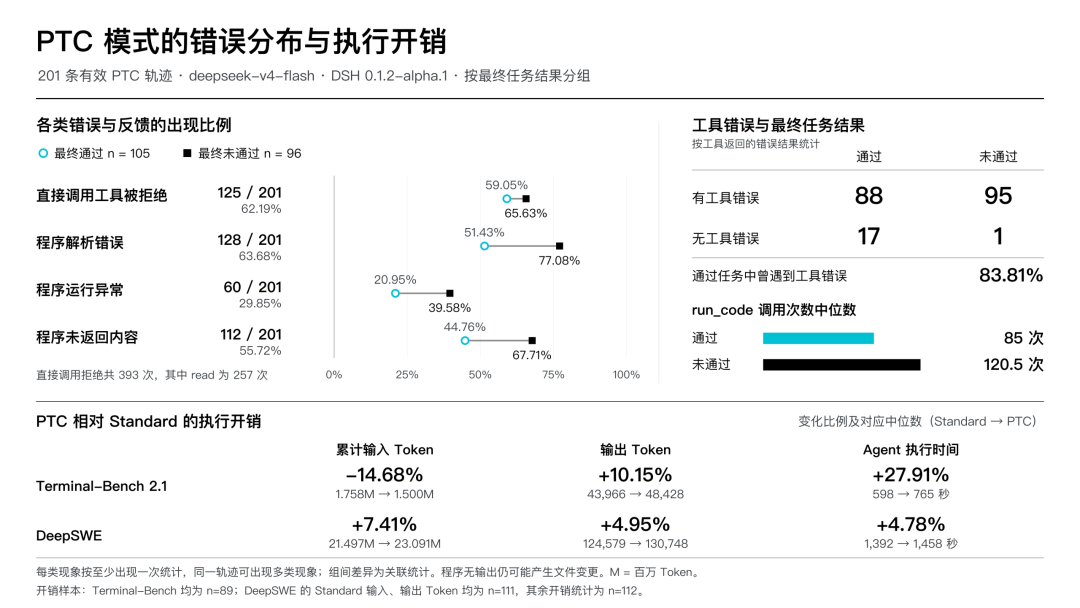
105 条通过的轨迹中,88 条出现过失败工具结果;模型能够根据反馈调整参数或改写程序后继续完成任务。错误得到修正并不意味着没有成本,这些重试仍占用额外请求和执行时间。
与 Standard 相比,Terminal-Bench 中 PTC 的累计输入 Token 中位数少 14.68%,累计输出 Token 高 10.15%,执行时间从 598 秒升至 765 秒;DeepSWE 中,累计输入、输出 Token 分别高出 7.41% 和 4.95%,执行时间从 1,392 秒升至 1,458 秒。PTC 的输入量在两项任务中的变化方向不同,也没有同步带来更短的执行时间;程序生成和错误恢复会占用额外时间。
本轮结果不能简单归结为 PTC 模式本身更差:通过率、Token 和执行时间反映的是当前模型与 Harness 的配合。轨迹显示,模型更准确地理解调用约定、生成程序并处理返回结果时,PTC 的确有减少中间交互和输入量的空间;能否把这种空间转化为稳定的通过率与效率提升,还要结合模型能力和 Harness 实现的后续演进继续验证。
02
Cordis 的依赖管理与插件生命周期
DSH 以 Cordis 为核心插件框架,管理插件加载、服务依赖与生命周期,Preset 声明的插件也通过它运行。Cordis 在启动前检查所需服务,服务替换时重载相关插件,卸载时执行已登记的清理函数。
· 服务依赖决定插件的启动与重载
static inject = ['agents', 'sessions', 'llm', 'tools', 'systemPrompt']
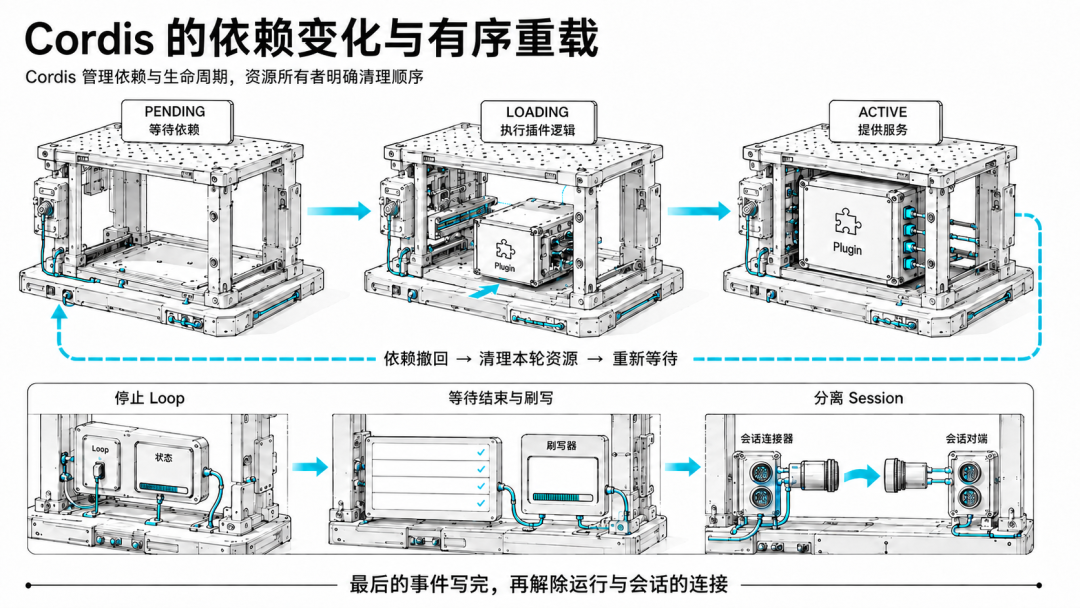
PENDING 状态;服务就绪后,进入 LOADING 状态并启动插件;启动成功后,转为 ACTIVE。UNLOADING 状态,执行已登记的清理函数。清理完成后,如果依赖仍未满足,则回到 PENDING;所需服务重新就绪后,同一个 Fiber 可以再次启动插件。如果这次装载被移除,对应的 Fiber 最终转为 DISPOSED;如果插件入口执行失败,则转为 FAILED。通过以上机制,组件可以在运行中替换,Cordis 会按依赖关系完成相关插件的退出、资源清理和重新启动。
· Context 与工具的可见范围
dsh-scope 记录工具注册的作用范围,为各个 Agent 分别生成可见的工具目录。PTC 模式生成 SDK 时也使用这份目录,未向当前 Agent 提供的工具,不会生成对应的 SDK 方法。· Effect的资源登记与退出顺序
· Agent Loop 的插件化与任务编排
dsh-agent 定义创建、恢复、收发消息和取消执行等接口,默认的 dsh-agent-loop 则负责组织模型输入、处理模型输出、调度工具,并按回合和步骤推进任务。开发者可以更换 Loop 插件,改变模型请求与工具执行的组织方式,Web 等上层组件仍通过统一接口使用 Agent。dsh-slice-agent-loop 替换默认 Loop,重新实现了模型请求的上下文组装。在默认的切片模式下,它把已结束回合中的请求、答复、文件内容与修改整理为结构化记录,在新回合开始时与当前请求、任务目标和文件状态一起组成模型输入。完整交互保存在会话日志中,模型需要查看细节时,可以通过历史检索工具取回原始内容。模型调用、工具执行和会话管理仍使用 DSH 的公共服务。agent() 启动子 Agent,用 pipeline() 和 parallel() 组合执行流程,并在变量中保存中间结果。例如,可以让多个 Agent 并行检查不同文件,再安排其他 Agent 验证发现的问题。循环、分支和结果传递由脚本控制,各子 Agent 内部仍由 Loop 推进模型请求与工具执行。03
Session Log 的运行事实与使用
Session Log 是 DSH 记录运行事实的真源。会话延续、中断恢复、轨迹分析和回归验证都以其中的事件为依据,其他视图与统计也从这份记录中获取事实。
生产环境中的 Agent 会连续执行多轮模型请求和工具操作。模型当时收到的信息、采取的动作,以及提示词、工具说明和上下文的变化,共同构成了定位异常行为、恢复中断任务和复查执行结果的依据。DSH 通过 Session Event Log 保存这些过程,遵循 Model-visible ⟺ logged 的设计原则,即通过会话日志及其引用的附件重建进入模型请求的内容。这使每一步的行为都有对应的输入和执行记录可供检查。
· 请求快照与执行轨迹
Session 对象。它维护的事件数组(SessionEvent[])按序号 seq 持续追加,构成 Session Event Log。会话头(SessionHeader)保存会话 ID、创建时间等基本信息,位于事件序列之外。持久化由独立的 SessionPersistence 服务负责,支持 JSONL、SQLite 等存储后端。request/header)保存模型配置、系统提示词和工具定义,工具调用与执行结果通过调用编号配对,步骤和回合结束也有对应的事件记录。开发者可以据此还原任务的执行顺序,核对每一步使用的配置和收到的反馈。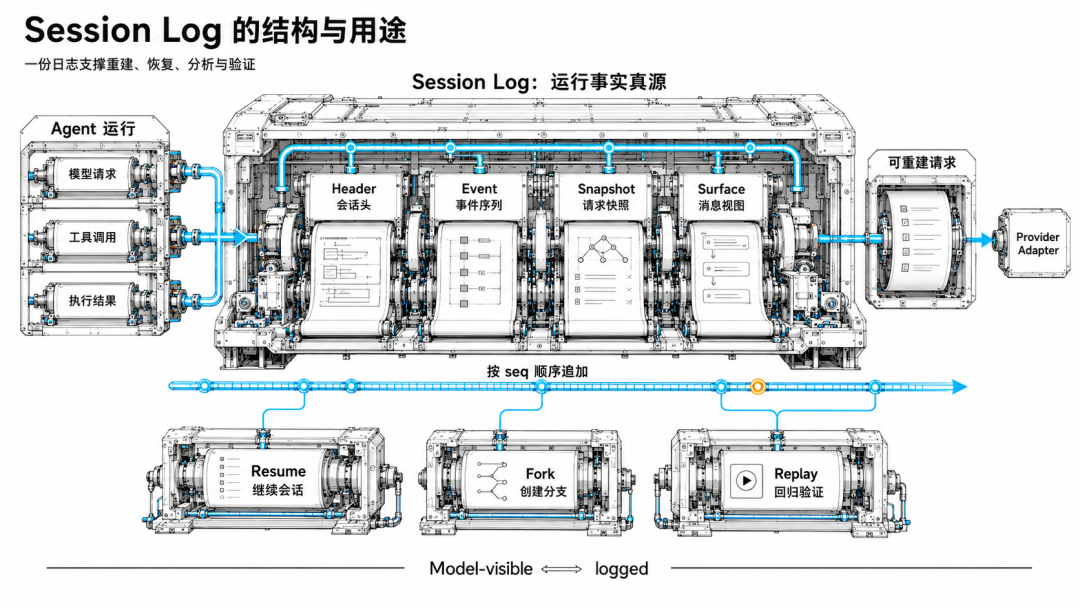
早期日志曾遗漏请求配置,插件中途改写的请求也难以追溯。现在,配置变化、注入消息和工具定义先写入日志,再据此构建请求,落实 Model-visible ⟺ logged 原则。模型实际看到的内容应能从日志重建,比较快照便可定位提示词、工具说明或模型配置从何时开始变化。
· 历史记录与请求重建
· 会话延续与中断恢复
· 执行轨迹分析与回归验证
04
Harness 优化与 Agent 的持续改进
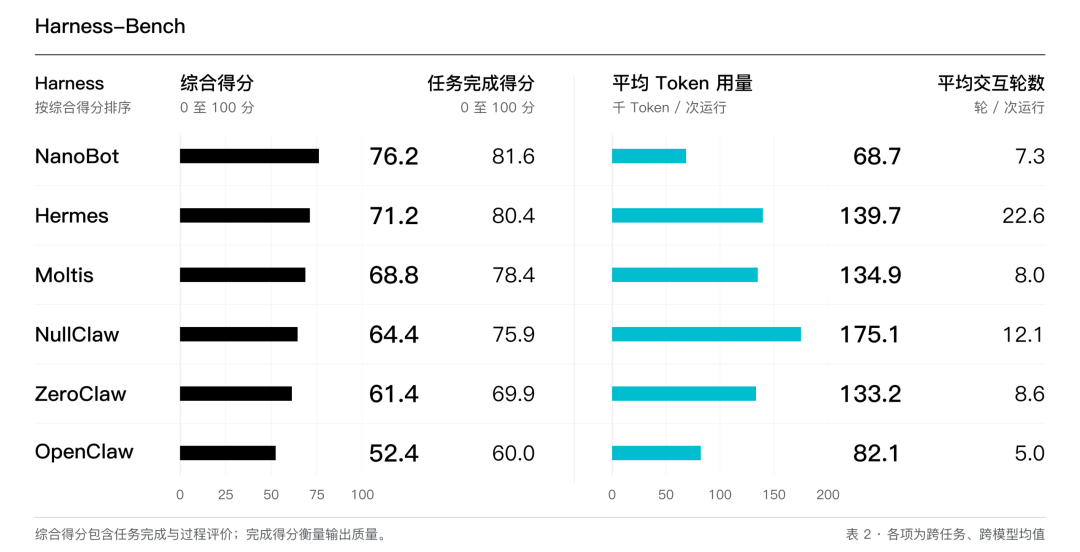
Agent 自进化的一条路径,是利用任务经验持续改进 Harness,并通过训练让模型学会更有效的执行方式。围绕这条路径,相关研究从运行配置的效果评估,延伸到候选的生成与选择、模型与 Harness 的联合更新,以及改进方法和评价规则自身的更新。
· Harness 的效果评估与反馈改进
LangChain 对 Deep Agents 的优化进一步展示了如何利用任务反馈改进 Harness。团队固定使用 gpt-5.2-codex,将轨迹分析整理为 Skill,让 Agent 汇总失败原因并提出修改建议。针对模型写完代码便结束任务、遗漏测试的问题,团队据此调整提示词,并通过 Middleware 在任务结束前提醒模型按照任务要求完成验证。结合环境信息补充和推理预算安排等调整,团队将 deepagents-cli 在 Terminal-Bench 2.0 上的得分从 52.8% 提高到 66.5%。
以上研究与实践说明,Harness 的设计会影响 Agent 的任务表现,执行反馈也能够指导这些设计的改进。 在此基础上,自进化研究进一步探索 Agent 如何参与这些改进,包括能够修改哪些对象,以及有效修改如何被选择和持续使用。
· 自进化的修改对象与持续使用
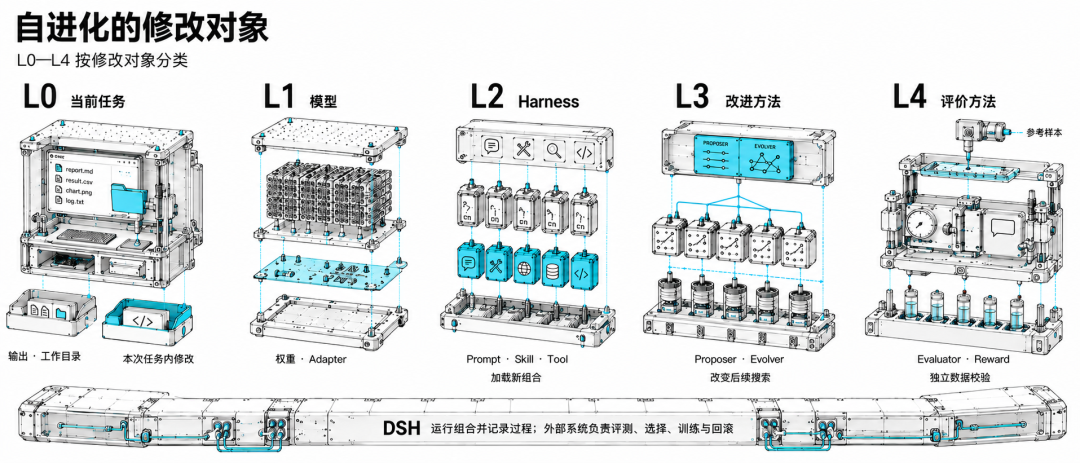
对于 DSH,最直接的研究入口是 L2。开发者可以把轨迹中反复出现的错误整理为提示词、Skill 或工具实现的修改,通过 Preset 装入后续任务。Creator 可以参与生成和试装候选修改,Cordis 负责管理相关插件的运行,Session 负责保存执行过程。外部实验系统可以保存候选版本,并在未参与修改过程的任务上比较新旧配置。反复围绕同一批任务调整规则,可能让改动越来越依赖已有样例。通过独立评测,团队可以检查改动在新任务中是否仍然有效、原有能力是否退步,再结合任务通过率与执行成本决定是否采用新版本。
· 候选选择与历史最佳版本
· 模型与 Harness 的联合更新
· 改进方法与评价规则的更新
05
让 Agent 在 DSH 中参与自身研发
前述研究将 Harness 修改、候选选择与模型学习联系起来,为 Agent 参与自身研发提供了不同方法。结合 DSH 与 RSI,可以让 Agent 从任务轨迹中发现问题,参与改写影响自身表现的工具、规则与上下文处理方式,再由通过评测的新版本承担后续任务,并继续参与下一轮研发。随着这条反馈链反复运行,Agent 的执行经验就能用于改进产生下一代 Agent 的过程,递归自进化也有了具体的研究对象。
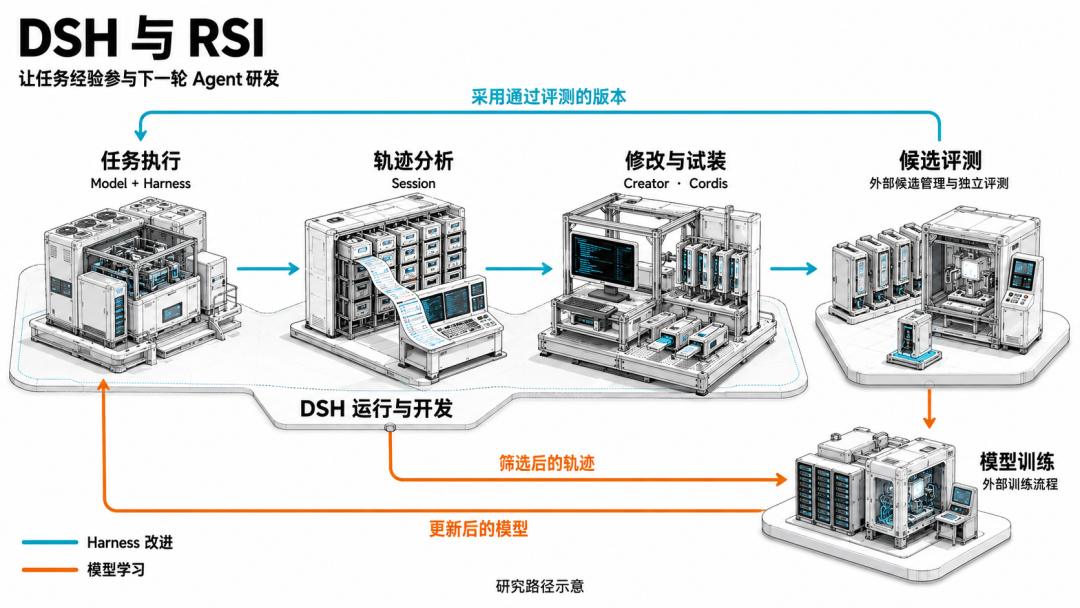
DSH 提供了运行这条反馈链所需的组件。Session 保存模型输入、工具反馈和上下文变化,Creator 可试装插件,Cordis 管理其运行。外部系统再把修改、版本与任务结果对应起来,经独立评测决定是否进入后续任务。
筛选后的轨迹还可以进入外部训练流程,使模型学习有效的工具使用和纠错方式;训练后的模型再回到 DSH,参与下一轮 Harness 修改。随着模型、运行方式和候选评价方法一起迭代,RSI 的观察对象也从单次任务成绩扩展到多轮研发收益。
06
结语
DSH 展示了一种值得继续探索的 Harness 范式。可替换的运行组件与可追溯的执行记录,让开发者能够修改 Agent 的工作方式,并通过真实任务检验结果。进一步结合评测与模型训练,这些实践也为研究模型与 Harness 的共同演进提供了具体依据。
衔远科技长期深入研究 Agent 自进化,并持续开展相关实践。与清华大学联合发布的自进化综述,关注任务经验如何转化为后续可用的能力,讨论了经验如何写入 Skill、记忆、环境配置或模型参数,以及这些更新如何经过检验、持续影响后续任务。Agent 自进化关键是经验落点
环境提供任务执行的条件与反馈,Harness 组织模型与环境之间的交互,并支持经验的保存、调用和更新。在此基础上,研究进一步将改进过程本身作为优化对象,探索系统如何根据以往的改进结果,调整经验筛选、候选生成与评测方法,让积累的经验既用于完成下一次任务,也用于改进下一轮学习的方式。
沿着这一方向,衔远科技已经构建了以 AI4AI 为核心的企业级 Agent 自进化基础设施,通过 MetaAgent 元智能体进化层支持 Agent 发布后的持续评测与改进。企业的真实业务提供长期任务,也提供判断改进是否有效的依据。将研究方法与业务实践结合,目标是让经过验证的专业经验用于后续工作,并随着新的任务反馈继续完善,使企业积累的经验能够持续改善 Agent 的判断与行动。
随着模型能力与 Harness 设计共同发展,Agent 有望更可靠地承担复杂任务,也更深入地参与研究与工程创新。我们期待这些探索逐步提高 Agent 学习和改进自身的能力,并让改进后的系统参与下一代系统的构建。让 AI 参与创造更好的 AI,将持续进化的能力带入企业的研究、决策与创新,是衔远科技长期投入的方向。
