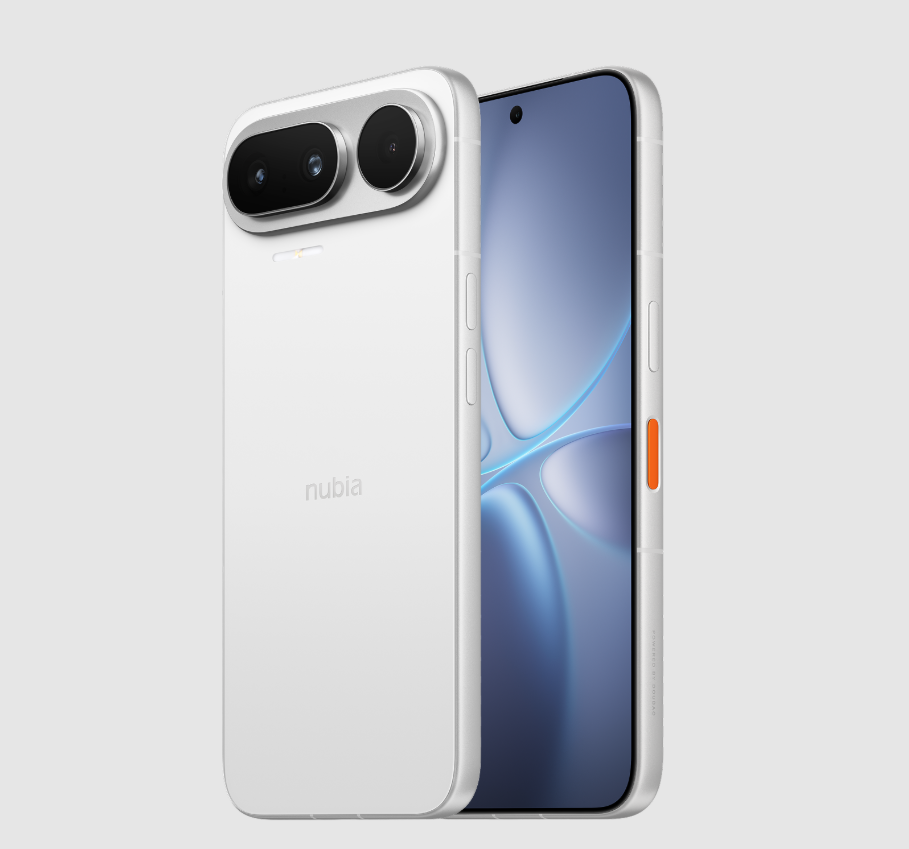
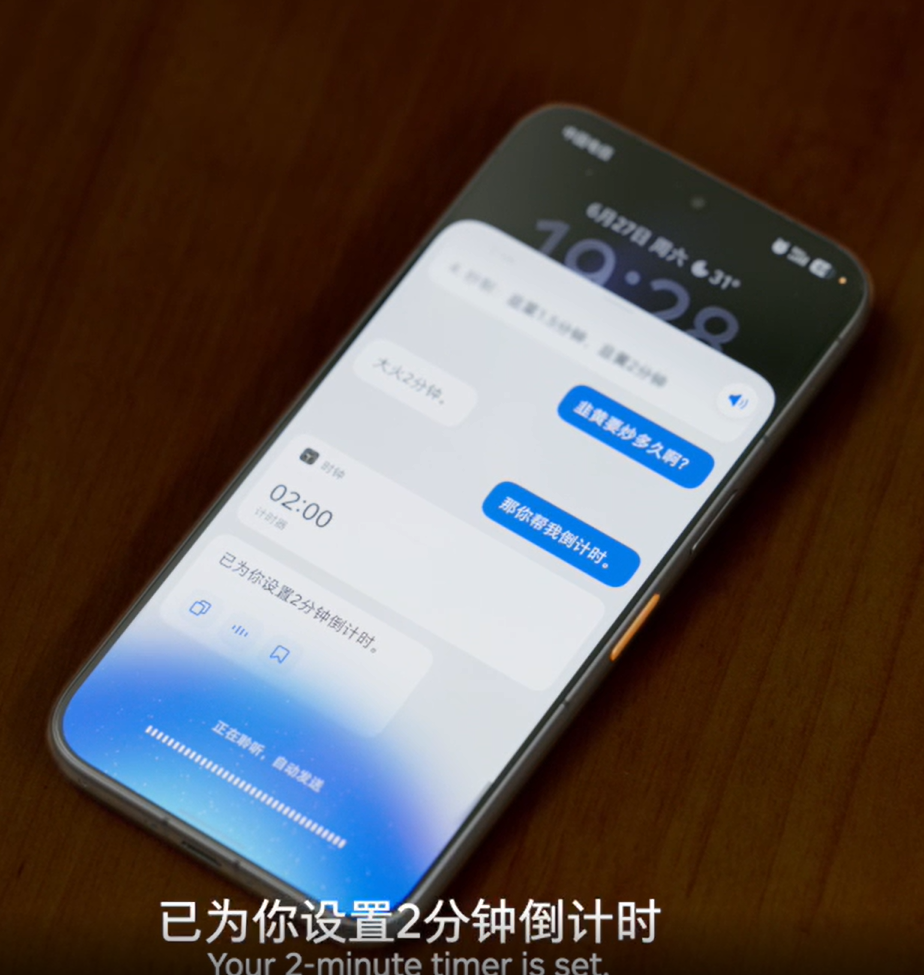
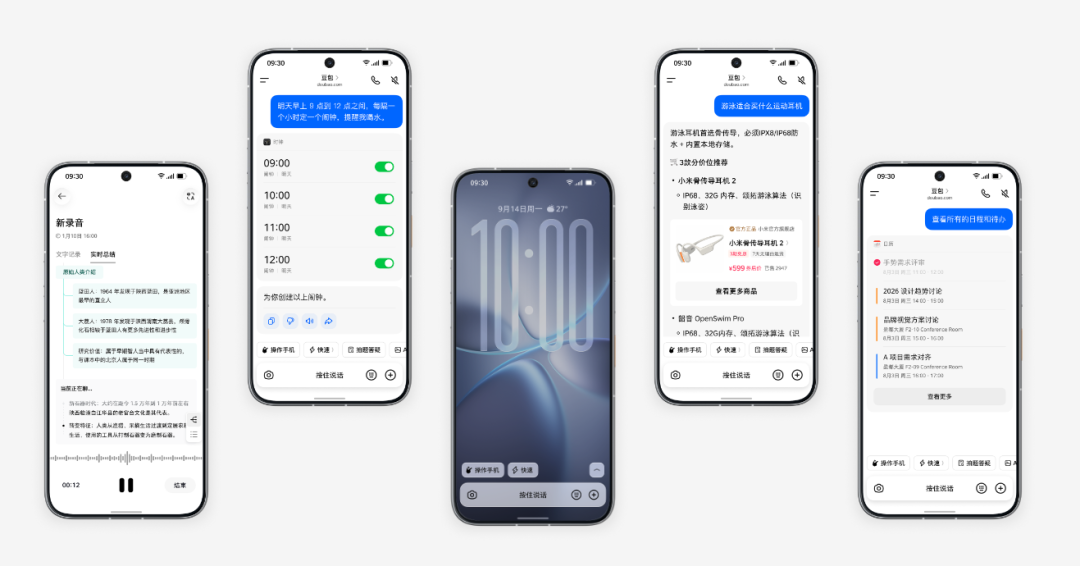
准确地说,是豆包手机助手的消费者版本来了。
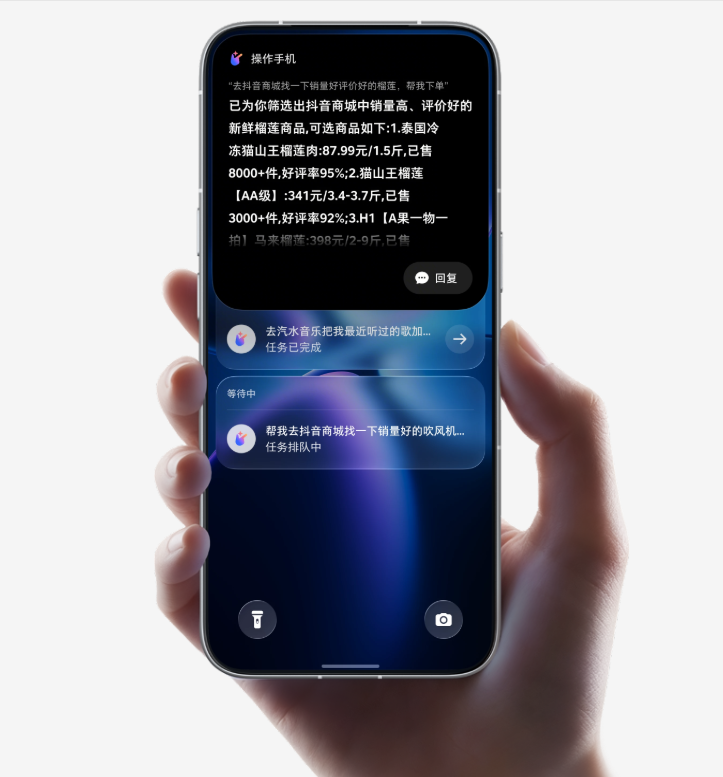
它试图把手机从一个“被人操作的工具”,变成一个“替人完成任务的 Agent”。
用户不需要打开 App、寻找功能、一步一步点击。
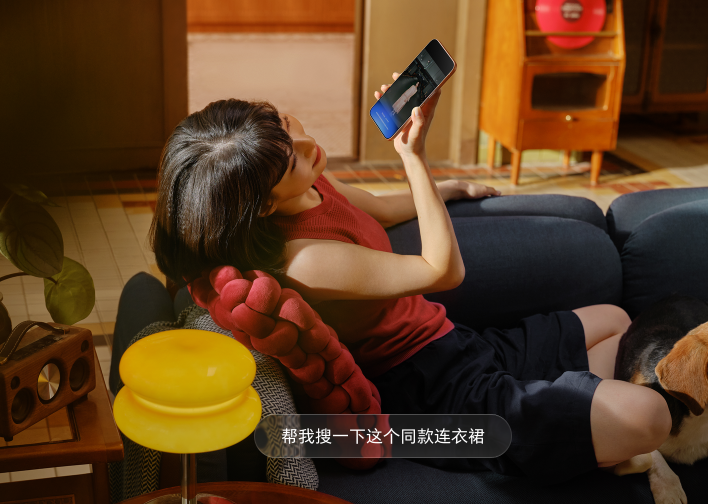
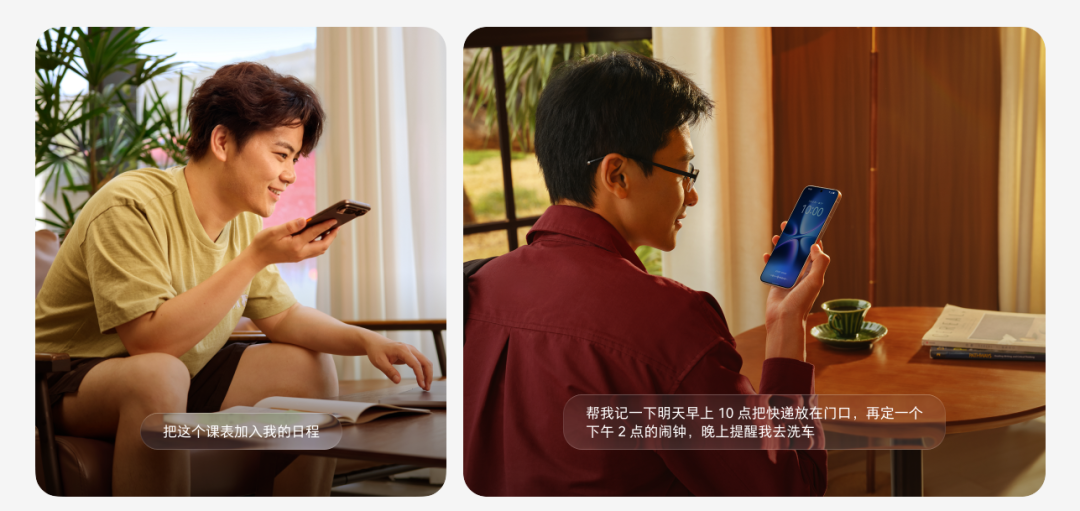
你只需要说:
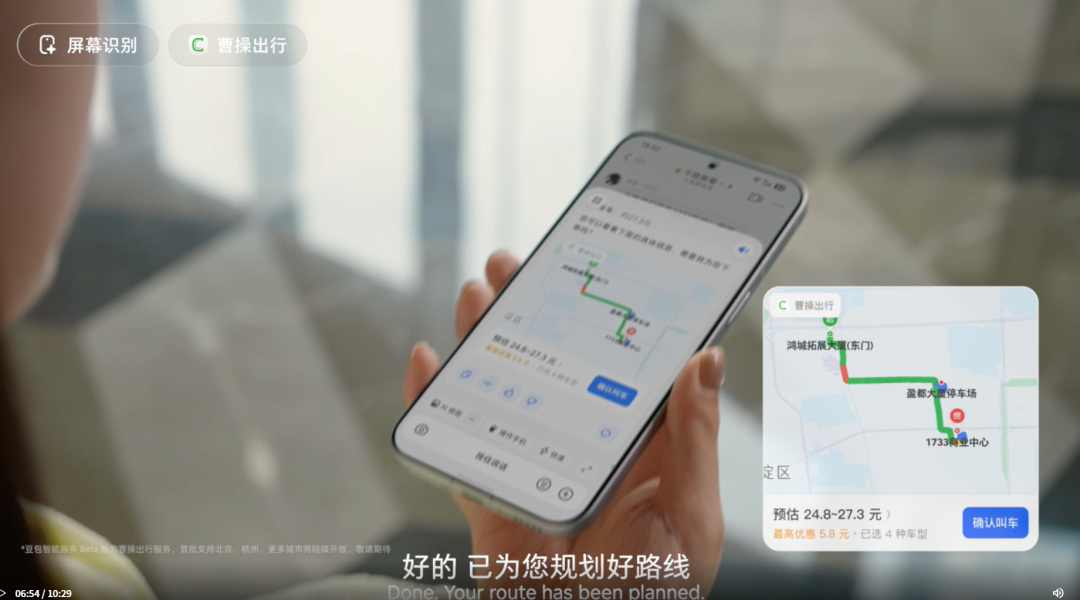
“帮我叫一辆车。”
“把刚才看到的内容整理一下。”
“帮我把这些照片做成一个视频。”
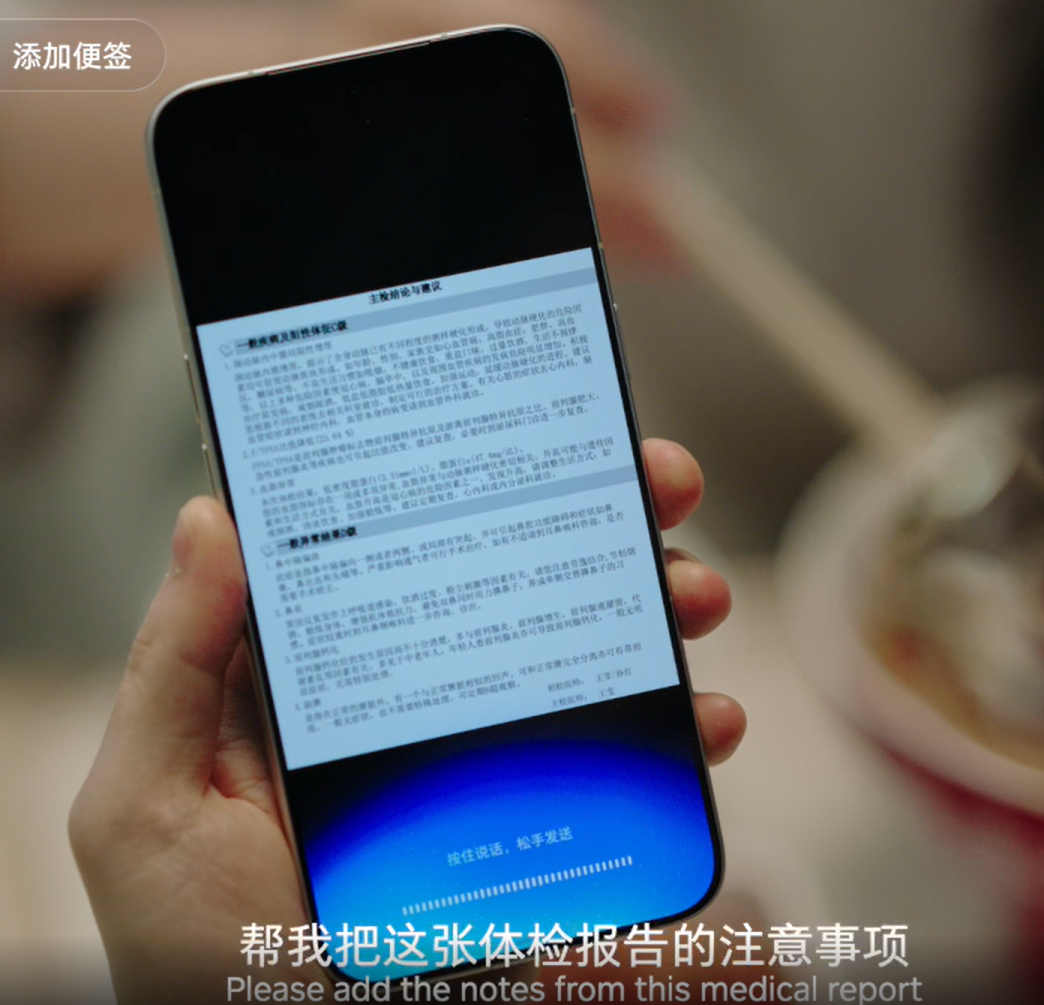
甚至可以把一连串任务直接交给 AI,让它自己理解屏幕、调用 App、执行操作。
从技术演示来看,这确实很酷。
手机第一次开始表现出一种“自己会动”的感觉。
但问题也恰恰在这里:
技术上能做到,不代表用户真的需要。
我甚至想提出一个更直接的问题:
人类真的需要一台“口述 + AI Agent”的手机吗?
我的答案是:
至少现在,我认为不需要。
不是因为 AI Agent 没有价值。
恰恰相反,我认为 Agent 很可能是手机未来非常重要的能力。
但我不认为:
“口述”会成为 Agent 手机最理想的人机交互入口。
一、首先,口述是一种“对外暴露”的交互
这是我对“语音 Agent 手机”最大的质疑。
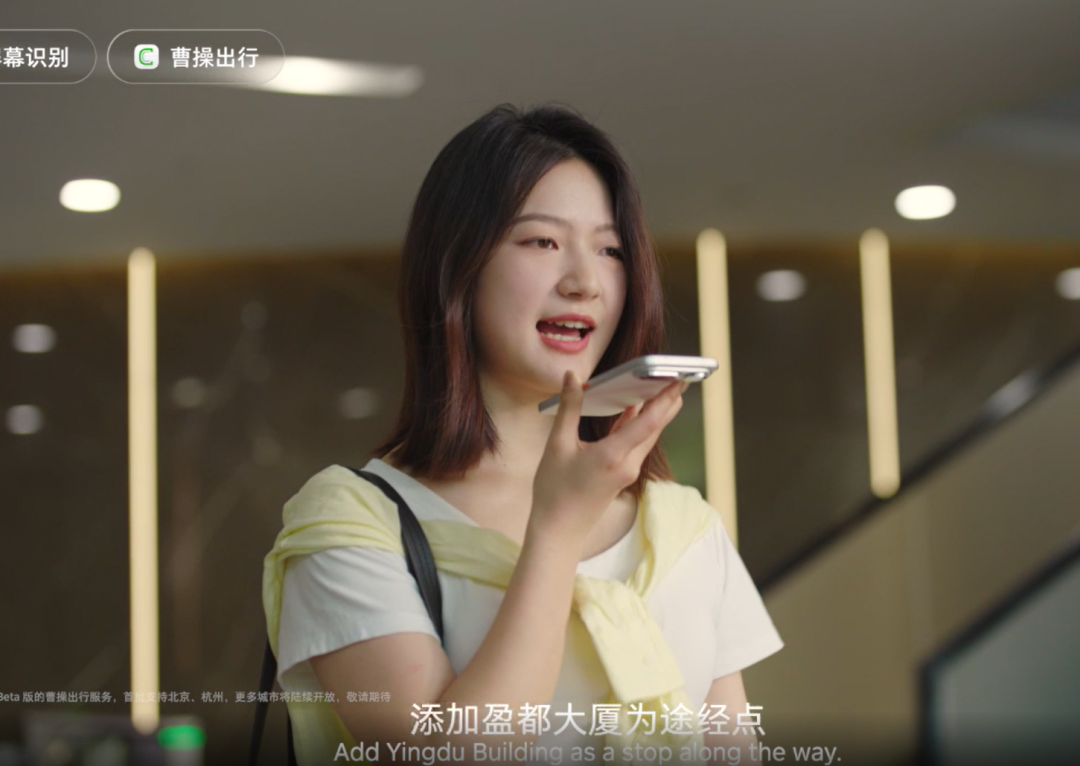
我们习惯了语音助手之后,很容易产生一个错觉:
既然说话比点击方便,那我以后为什么不直接说?
问题是:
你真的愿意在所有场景里对着手机说话吗?
办公室里。
会议室里。
电梯里。
地铁上。
餐厅里。
商场里。
和客户谈事情的时候。
甚至和朋友坐在一起的时候。
你可能突然想让手机帮你做一件事情。
例如:
“帮我查一下这个产品的价格。”
“把这个文件发给老板。”
“帮我订明天早上的机票。”
“把刚才这个地址保存下来。”
这些事情本身没有任何问题。
真正的问题是:
你愿不愿意把你的意图公开说出来?
因为语音是一种非常特殊的交互方式。
点击是“私密的”。
滑动是“私密的”。
打字也是相对私密的。
但说话不是。
你一旦开口,周围的人就知道你在做什么。
而且很多时候,他们甚至不需要知道。
二、真正优秀的交互,不应该要求用户“解释自己”
这是一个很容易被忽略的问题。
今天我们使用手机 App,实际上已经形成了一套非常成熟的“低认知负担”交互方式。
看到一个东西。
点一下。
长按。
复制。
分享。
拖动。
滑动。
选择。
确认。
整个过程中,用户甚至不需要组织语言。
而 Agent 的逻辑恰恰相反。
它要求你:
先把自己的意图描述出来。
比如:
“帮我找一个适合办公室使用、预算1000元以内、尺寸不要超过1.2米、颜色和我现在这个装修风格比较搭的柜子。”
这句话听起来很智能。
但从另一个角度看:
是不是也意味着用户需要先把自己的需求“说清楚”?
而现实世界的人类,很多时候并没有那么清楚自己的需求。
我们很多时候是:
边看、边想、边操作。
而不是:
先想清楚,再完整描述。
这也是为什么图形界面存在了这么多年。
它不是因为“人类不会表达”。
而是因为:
好的交互应该帮助用户表达,而不是要求用户先完成表达。
三、如果最后只是“一句话触发一连串操作”,那它到底是不是 Agent?
这里是我认为更值得讨论的问题。
现在很多 AI 手机最容易让人兴奋的地方,是:
“一句话,让 AI 帮我操作手机。”
听起来非常先进。
但如果我们拆开来看,会发现一个有意思的现象:
用户说:
“帮我把这些照片整理一下,然后做成一个视频。”
AI 理解需求。
AI 调用相册。
AI 选择照片。
AI 打开剪辑 App。
AI 选择模板。
AI 添加音乐。
AI 导出视频。
整个过程确实比传统操作方便。
但是从产品逻辑来看,它实际上很像什么?
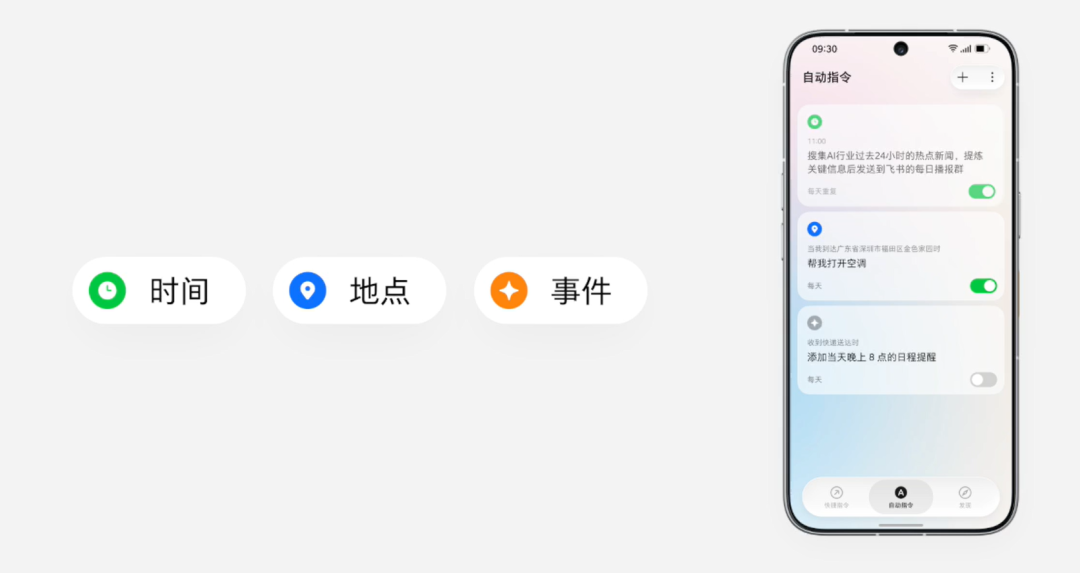
宏。
四、Agent 和“宏”的区别,到底在哪里?
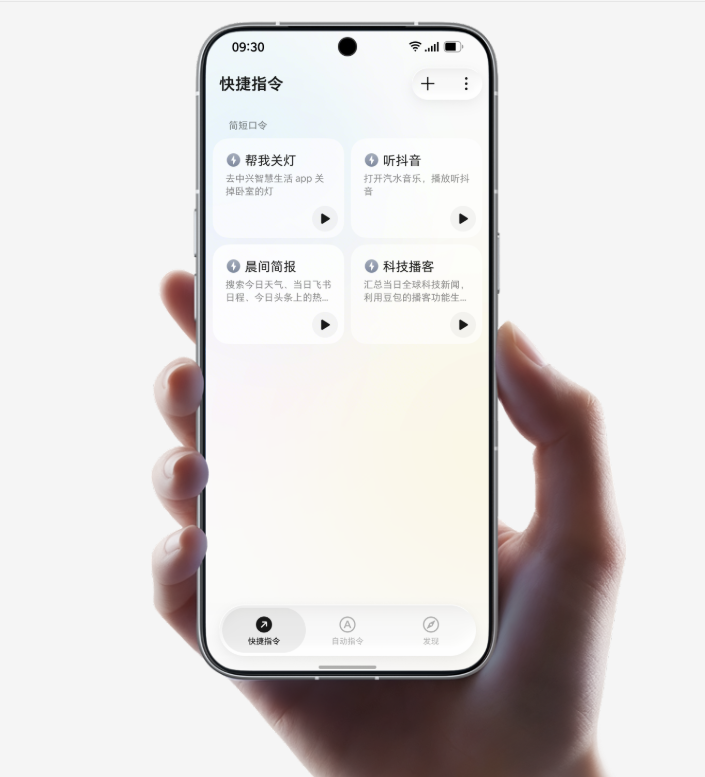
宏的核心逻辑是:
提前定义一套流程 → 触发 → 自动执行。
Agent 的理论逻辑应该是:
理解目标 → 感知环境 → 自主决策 → 动态执行 → 根据结果调整 → 最终完成目标。
两者最大的区别,不应该是“有没有 AI”。
而应该是:
面对没有被预先定义的情况,系统有没有真正的自主决策能力?
如果用户说:
“帮我订一个明天去上海的机票。”
这件事情可能非常复杂。
去哪一个机场?
几点出发?
预算多少?
是否需要托运行李?
红眼航班接受吗?
如果没有符合条件的航班怎么办?
如果价格超过预算怎么办?
如果需要中转怎么办?
真正的 Agent 应该能够根据上下文自己判断。
而不是:
用户一句话 → AI 按照固定流程点击 1、2、3、4、5。
如果最后所有任务都必须被拆解成一套可以执行的步骤,
那么所谓 Agent,很容易退化成:
“AI 驱动的超级宏。”
这也是我认为目前很多 AI 手机最值得警惕的地方。
我们究竟是在创造新的计算范式,还是把传统 GUI 自动化做得更自然?
五、真正的 Agent,不应该只是“替我点手机”
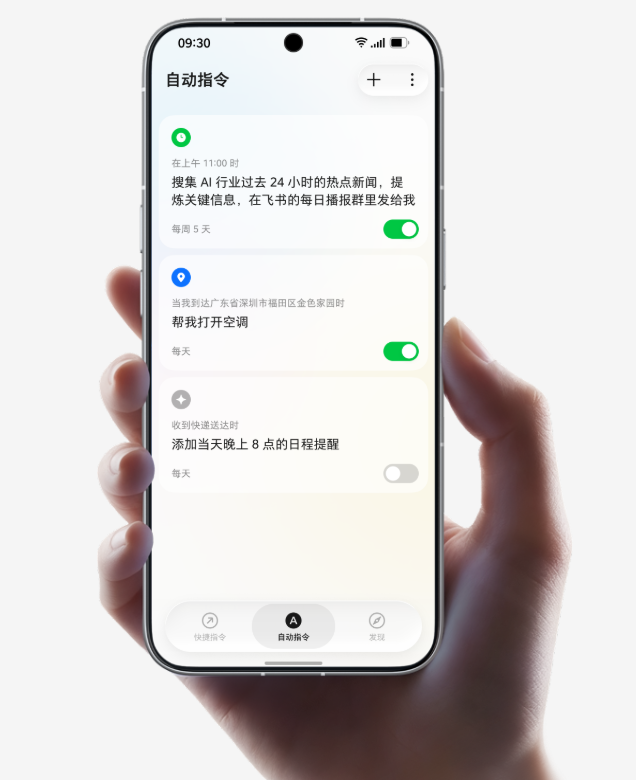
这是我认为 AI 手机下一阶段真正需要解决的问题。
如果 Agent 只是:
帮我打开 App。
帮我点击按钮。
帮我填写表格。
帮我下订单。
那么它解决的其实只是:
“操作成本。”
但用户真正需要解决的,是:
“决策成本。”
这两个东西完全不同。
比如:
“帮我安排明天去上海出差。”
这不是一个操作问题。
而是一个决策问题。
Agent 应该知道:
我明天有哪个会议?
会议几点开始?
我现在在哪里?
过去我通常选择什么交通方式?
公司的出差标准是什么?
我的预算是多少?
哪一趟航班最合适?
如果航班延误怎么办?
到了上海以后怎么去酒店?
真正的 Agent,是把这些事情连接起来。
它甚至应该在某些情况下告诉你:
“我发现明天上午的航班价格比平时高40%,但下午航班价格正常,而且不会影响你的会议。我建议选择下午这一班。”
这才开始接近真正意义上的 Agent。
因为它不是在替你点击手机。
而是在替你完成一部分任务认知和决策工作。
六、所以问题可能不是“AI手机需不需要Agent”
这个答案其实已经越来越明确。
需要。
但真正值得讨论的是:
手机需要什么样的 Agent?
我认为未来的 Agent 手机,不应该是:
“我说,你执行。”
而应该逐渐变成:
“我在做我的事情,你理解我的上下文,在合适的时候帮我完成事情。”
这两者有非常大的区别。
前者仍然是:
人 → 指令 → AI → 执行
后者则是:
人 → 意图 / 上下文 → AI理解 → 判断 → 行动 → 结果
这才是真正的变化。
七、未来真正有价值的入口,可能根本不是语音
这可能是整件事情最有意思的地方。
如果 AI 足够聪明,
为什么一定要让我说话?
我看到一个商品。
AI 应该知道我正在看什么。
我收到一封邮件。
AI 应该知道这封邮件意味着什么。
我打开一份合同。
AI 应该知道我可能需要关注哪些风险。
我拍了一张照片。
AI 应该理解照片里的内容。
我在聊天。
AI 应该理解当前上下文。
我连续几天搜索某个东西。
AI 应该理解:
“这个人可能真的准备买它。”
这时候,
用户甚至不需要主动告诉 AI:“帮我做什么。”
AI 可以从上下文中理解:
我正在做什么。
这才是我认为 AI 手机真正值得期待的方向。
八、手机的下一代交互,不应该是“更会听”,而应该是“更懂”
过去的语音助手解决的是:
听懂我说什么。
现在的 AI Agent 开始解决:
理解我要什么,并替我执行。
但下一阶段应该解决:
我甚至不需要完整说出来,它也知道我正在做什么。
所以我对“AI 手机”的判断是:
语音只是入口,Agent 才是能力,但上下文才是核心资产。
如果一个 AI 手机最大的卖点还是:
“你只需要说一句话,它就可以帮你操作手机。”
那么我认为这还只是第一阶段。
因为它仍然在强调:
“你要告诉我,你想做什么。”
而真正成熟的 AI 手机应该逐渐变成:
“你不用每次都告诉我,因为我已经理解你正在做什么。”
九、我并不反对豆包手机
恰恰相反。
我认为豆包手机正在做一件非常有价值的事情:
它把“AI Agent 操作手机”从概念真正推进到了消费者产品。
消费者版本已经把语音、AI 键、屏幕理解、本地记忆、任务执行等能力组合到一起;“操作手机”也以 Beta 形式继续开放。
这本身值得肯定。
但一个产品进入市场之后,真正需要回答的就不再是:
“技术上能不能做到?”
而是:
“用户为什么每天都要用?”
这是两个完全不同的问题。
技术演示解决的是:
Wow!它居然可以这样做。
产品最终要解决的是:
我为什么下意识就会这样用?
十、AI 手机真正的终局,不应该是“一个会操作手机的人”
我甚至认为:
AI Agent 最终可能会让“手机”这个概念本身发生变化。
现在的手机,本质上是:
App + 屏幕 + 操作系统 + 人。
未来可能变成:
意图 + 上下文 + Agent + 服务。
App 甚至可能逐渐退到幕后。
用户不再关心:
“我要打开哪个 App?”
而只关心:
“我要把这件事情完成。”
这才是真正的 Agent 时代。
所以回到最开始的问题:
人类真的需要一台“口述 + AI Agent”的手机吗?
我的答案仍然是:
不一定。
人类真正需要的,从来不是一台“更会听话”的手机。
而是一台:
能够理解上下文、减少表达成本、减少决策成本,并且真正替用户完成事情的手机。
如果只是把“说一句话”变成“自动执行十几个点击”,那么它只是把手机的操作方式换了一种形式。
它可能比宏高级,也可能比宏聪明。
但它还没有真正改变手机。
真正的 AI 手机,应该让用户越来越少地“操作手机”,而不是越来越方便地“告诉手机怎么操作”。
这可能才是 AI Agent 手机真正值得思考的问题。