代码评审这件事,程序员又爱又恨。
爱的是它确实能拦住不少低级错误,恨的是它太耗人。一个中等规模的 PR,认真看完少说半小时,大一点儿的改动,一下午就没了。更别提有些改动你根本不熟,看半天还在猜这段逻辑到底干嘛的。
所以这两年,用 AI 辅助 review 越来越普遍。但用过的都知道,通用 Agent 干这活儿,问题不少。
通用 Agent 做 Code Review,到底差在哪
拿 Claude Code 这类通用 Agent 做代码评审,用久了会发现三个典型毛病:
一是覆盖不全。 改动文件一多,Agent 就开始“偷懒”,挑几个看着顺眼的文件评一评,剩下的直接跳过。你以为它全看了,其实漏了一大半。
二是定位漂移。 它说“第 47 行这里有问题”,你跳过去一看,第 47 行是空行,真正的问题在第 52 行。文件引用错位、行号对不上,这种事太常见了。
三是不稳定。 同一个 PR,换个 prompt 措辞,评审结果能差出十万八千里。自然语言驱动的东西,调试起来基本靠玄学。
根子上的原因就一个:纯语言驱动的架构,对评审过程没有任何硬约束。
阿里的解法:确定性工程 + Agent 混合
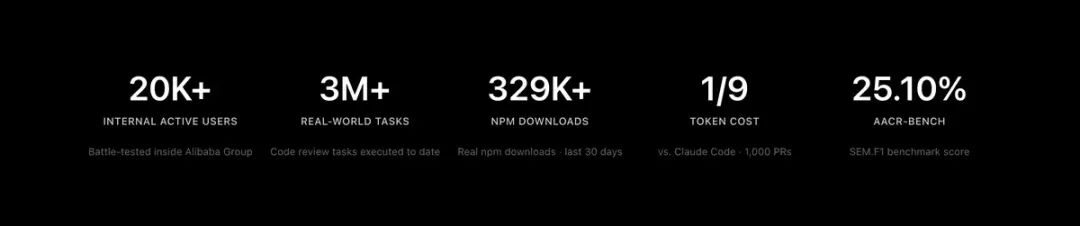
阿里内部有个 AI 代码评审助手,已经跑两年了,服务了几万名开发者,识别出几百万个代码缺陷。最近他们把它孵化成了开源项目,叫 Open Code Review(简称 ocr)。
这个项目的核心思路挺有意思:该工程保证的地方用工程保证,该模型决策的地方交给模型。
说白了,就是不迷信大模型,也不排斥大模型。
确定性工程负责“不能出错”的环节
哪些环节不能出错?文件选择、文件分组、规则匹配、评论定位。
Open Code Review 用工程逻辑而不是语言模型来保证这些环节的正确性:
精确的文件选择:明确判定哪些文件需要评审、哪些应该过滤,不遗漏重要改动。 智能文件捆绑:把相关文件捆成一个评审单元,比如 message_en.properties和message_zh.properties放一起看。每个捆绑包作为独立子 Agent 运行,上下文隔离,天然支持并发,改动量再大也稳。细粒度规则匹配:根据文件特征匹配评审规则,把模型注意力集中在最相关的地方,从源头砍掉信息噪音。相比纯语言驱动的规则引导,模板引擎的匹配方式更稳定、更可预测。 独立定位与反思模块:评论定位和评论反思两个模块独立于主流程,系统性地提升位置准确度和内容准确度。
Agent 负责“动态决策”的部分
Agent 的优势集中在真正需要动态判断的地方:
场景调优的 Prompt:专门为代码评审优化的模板,效果更好,Token 消耗更低。 场景调优的工具集:从大规模生产数据的工具调用轨迹里蒸馏出来的,分析了调用频率分布、单工具重复率、新工具对整体调用链的影响,最终做出一套专门给代码评审用的工具集,比通用 Agent 工具箱更稳、更可预测。
Agent 可以读完整文件内容、搜索代码库、查看其他改动文件获取上下文,产出的是有深度的评审,不是只盯着 diff 表面的反馈。
除了 diff 评审,ocr scan 还能整文件扫描,用来审计不熟悉的代码库或者没有有意义 diff 的目录。
Benchmark:精度更高,Token 只要九分之一
Open Code Review 建了一个真实场景的代码评审 Benchmark,叫 AACR-Bench:
50 个热门开源仓库 200 个真实 Pull Request 10 种编程语言 80 多位资深工程师交叉验证 1,505 个标注的 ground-truth 问题
数据集已经放在 Hugging Face 上了。
和通用 Agent(Claude Code)在相同底层模型下对比,结果是这样的:
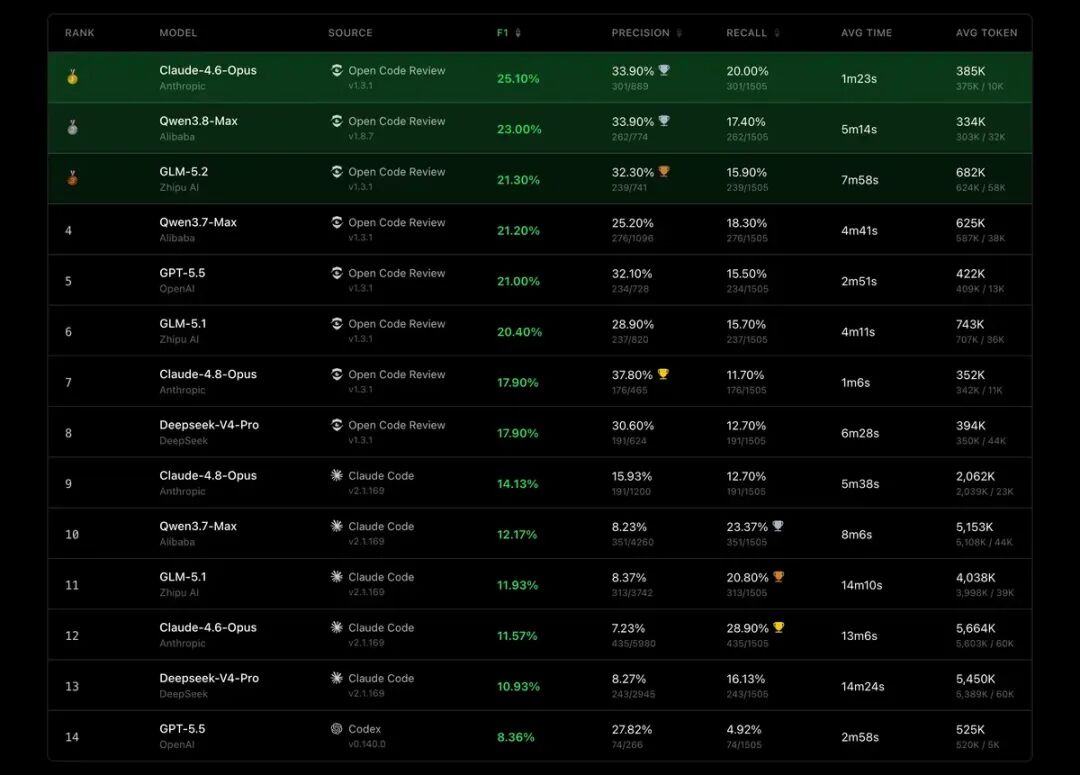
结论是:Open Code Review 的 Precision 和 F1 显著更高,Token 消耗只有约 1/9,评审速度也更快。
代价是 Recall 比通用 Agent 低——这是一个刻意的取舍:宁可少报,也不愿用噪音淹没你。
怎么用
前提条件
Git >= 2.41。Open Code Review 依赖 Git 做 diff 生成、代码搜索和仓库操作。
安装
npm install -g @alibaba-group/open-code-review
装完之后,ocr 命令全局可用。
快速开始
第一步,配置 LLM
ocr config provider    # 选择内置提供商或添加自定义
ocr config model       # 为当前提供商选模型
交互式界面会引导你完成提供商选择、API Key 输入和模型配置,然后自动测试连通性。
第二步,评审
# 工作区模式——评审所有已暂存、未暂存和未跟踪的改动
ocr review

# 分支范围——评审 feature 分支从 main 分叉以来的改动
ocr review --from main --to feature-branch

# 单个 commit
ocr review --commit abc123

# 恢复中断的范围或 commit 评审
ocr session list
ocr review --from main --to feature-branch --resume

# 整文件扫描——评审整个文件而非 diff,不需要 git 历史
ocr scan                          # 扫描整个仓库
ocr scan --path internal/agent    # 扫描目录或指定文件
ocr scan --resume    # 恢复中断的整文件扫描

# 结果保存到文件(推荐给 AI 宿主 Agent 用)
ocr review --format json --output result.json

# 委托模式——让你的 AI 编程 Agent 自己执行评审
# OCR 负责文件选择和规则解析,不需要配置 LLM
ocr delegate preview
ocr delegate rule src/main.go src/handler.go
集成生态
Open Code Review 已经适配了主流编程 Agent 平台:
Claude Code — 安装插件,带评审斜杠命令 Codex — 安装插件,带可调用的评审技能 Cursor — 安装插件,带可移植评审技能 Kimi Code — 安装插件,带评审斜杠命令和技能 OpenCode — 安装原生评审工具和斜杠命令 QCA Forward — 用 QCA 宿主模型跑委托模式,带现成模板 Skill 兼容 Agent — 安装可移植 Agent 技能
评审执行有两种模式:
默认模式(OCR 管理):OCR 用它配置的 LLM 跑评审 委托模式:你的编程 Agent 用自己的 LLM 跑评审,不需要 OCR API Key
CI/CD 集成支持 GitHub Actions、GitLab CI、GitFlic CI 和 Gerrit。
还有个 Session Viewer,可以在浏览器里浏览和回放评审会话,把评论标记为已修复或已忽略,处理问题时先隐藏掉,挺实用的。
遥测方面集成了 OpenTelemetry,可观测性也考虑到了。
最后说两句
Open Code Review 这个项目最值得关注的地方,不是它用了什么模型,而是它的架构思路:不把正确性寄托在语言模型的“自觉”上,该用工程约束的地方就用工程约束。
文件选择、规则匹配、评论定位这些环节,本来就不该让模型自由发挥。模型擅长的是理解代码语义、做动态判断,那就让它专注干这个。
这种“确定性工程 × Agent”的混合思路,可能比单纯堆模型能力更有参考价值。
项目文档在 open-codereview.ai/docs,感兴趣可以去看看。
