
编者荐语
具身智能体如何实现能力持续提升?本文以 EmbodiSkill 与 ASPIRE 两项最新研究为基础,聚焦技能持续进化机制,提炼出反馈归因、技能积累与多候选探索三项关键原则。文章从反思粒度、知识沉淀到竞争式验证,系统梳理智能体自我演进的核心路径,并结合工程实践提出具体启示,为构建可持续学习、可复用、可迭代的具身智能体提供了有价值的设计参考。
点击视频,快速了解全文核心干货
Physical Agent持续进化设计的思考:反馈粒度、知识组织与探索机制
亚信科技(中国)有限公司
摘要:具身智能体要在真实物理环境中持续进化,关键在于技能更新机制的设计。传统方法将整条轨迹打包为粗粒度反馈,难以区分“技能内容缺陷”与“执行过程失误”,导致有效知识被错误覆盖甚至退化。本文基于清华大学AIR(Institute for AI Industry Research)研究院提出的 EmbodiSkill 和 NVIDIA GEAR(Generalist Embodied Agent Research) 实验室提出的 ASPIRE 两项工作,提炼出智能体持续进化的三个设计原则:第一,反馈的归因粒度决定进化质量,结构化反思远优于整体重写;第二,技能库正在从辅助存储演变为知识积累的核心载体,其规模与迁移性能正相关;第三,多候选探索与竞争能有效弥补单轨迹反思的偶然性偏差。三者共同指向同一方向——让智能体从自身执行经验中诊断问题、沉淀知识,实现“越用越聪明”的持续进化闭环。
一
引言
具身智能体在真实物理环境中执行任务时,面临一个根本性困境:环境布局、物体状态、光照条件、执行噪声等因素的无限多样性,使得任何预先定义的技能或策略都无法覆盖所有可能遇到的情况。因此,智能体必须具备从自身执行轨迹中持续学习的能力——即技能的自我演进。
近期,两项研究工作从不同角度深入探讨了这一问题。一项是清华大学 AIR 研究院等机构提出的 EmbodiSkill ,聚焦于技能感知的反思与靶向修订;另一项是 NVIDIA GEAR 实验室领衔的 ASPIRE,聚焦于代码即策略框架下的技能发现与积累。将这两项工作放在一起审视,可以提炼出具身智能体持续进化设计中的三个关键技术判断:反馈粒度决定了进化的质量,技能库正在从辅助模块转变为知识积累的核心载体,以及多候选探索是提升进化鲁棒性的关键路径。
三个判断不是孤立结论,而是构成一个持续进化的有机体系:
1.反馈粒度(输入层)决定进化质量的上限。
2.多候选探索(方法层)为进化提供鲁棒性保障。
3.技能库(积累层)把每一次成功进化沉淀为可复用的知识。
三者相互作用:细粒度反馈 → 驱动技能库沉淀;多候选竞争 → 胜出入库;技能库 → 反哺反馈粒度。
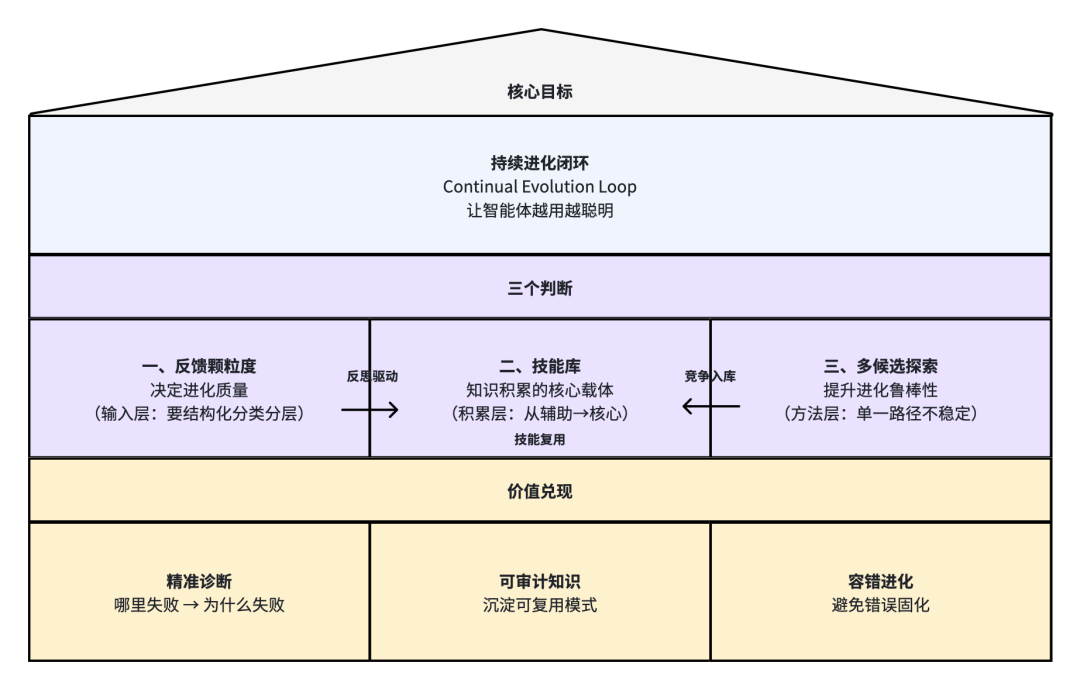
图1:三个判断关系与价值
二
反馈粒度决定进化质量
在技能自演进系统中,最核心的设计决策是如何将一条执行轨迹转化为更新信号。传统方法将整条轨迹连同成功或失败标签打包,交给大模型生成整体性的技能修订建议。这种做法看似直接,但在物理环境中存在严重隐患。
问题的根源在于,物理世界中的任务失败原因往往是高度纠缠的。一次抓取失败,可能是因为技能描述中缺少了某个前置条件检查(技能内容问题),也可能是因为感知模块抖动导致定位偏差,或者是运动规划器遇到了不可达的构型(执行过程问题)。如果系统无法区分这些情况,就可能将一次偶然的执行失误误判为技能缺陷,从而错误地“修正”原本有效的技能内容。
EmbodiSkill 的设计正是为了解决这一归因问题。它将轨迹反思分为四类:Discovery(发现新内容)、Optimization(优化已有内容)、Skill Defect(技能本身有缺陷)和 Execution Lapse(技能正确但执行失误)。这种分类的价值在于,不同类型的反思对应完全不同的更新操作:前三种作用于技能主体,而 Execution Lapse 只更新技能附录——一个用于提醒执行者注意特定要点的辅助结构,绝不触碰核心规则。实验数据显示,在 ALFWorld(text-based embodied AI benchmark) 基准上,采用这种细粒度归因后,任务成功率从粗粒度更新的 78.36% 提升至 93.28%,相对提升 19%。
ASPIRE 则从执行引擎层面解决了反馈粒度问题。它设计了细粒度的多模态执行迹记录机制——每次感知、规划、抓取、运动控制调用,都会记录输入、输出、返回值、关键帧等完整信息。这让代理能够逐层下钻定位问题:从“任务失败”到“规划失败”,再到“目标点落在碰撞缓冲区”。例如,在一次“导航并拿起收音机”的任务调试中,代理通过迹发现感知模块成功识别了收音机,但 navigate_to_pose 反复返回规划错误,进一步检查发现是导航目标点落在了桌子边缘的碰撞缓冲区(约 20 厘米)内。基于这一诊断,代理编写了多角度接近策略,而非盲目修改感知或抓取模块。
两个工作的共同启示是:技能的进化质量,根本上取决于反馈信息在原因维度上的分辨率。 如果反馈只是成功或失败加整条轨迹文本,进化模型必须从大量噪声中猜测问题所在;如果反馈已经按照内容错误、感知失败、规划不可行等维度进行结构化组织,修复的准确性和进化的稳定性就会显著提升。
启示:在我方具身智能体框架的反思模块评审中,建议先做 3 个"归因维度"的具体检查:
任务层级归因:反思输出是否定位到"是哪个子任务"(如"抓取杯子失败" vs "整个烹饪失败")?
失败模式归因:反思输出是否区分"规划错误/执行错误/感知错误/外部干扰"等失败原因?
可执行建议归因:反思输出是否给出"下次应修改什么具体代码/参数/技能"(而非笼统的"再试一次")?
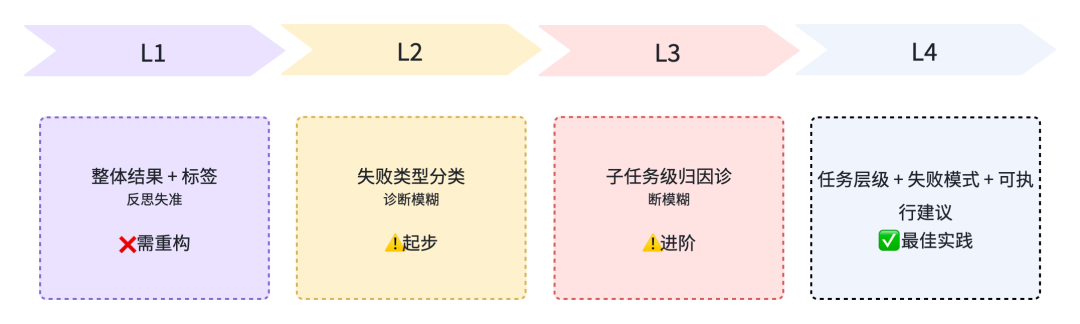
图2:反馈分阶段建议
三
技能库作为知识的组织化形态
在传统设计中,技能库往往被视为执行模型的附属组件——存储一些预定义的策略供推理时检索。但这两项工作表明,当技能库具备了“接收证据 → 归因分类 → 选择性更新 → 跨任务复用”的完整能力后,它本身就成为了知识积累的核心载体。
EmbodiSkill 将技能拆分为主体和附录两部分,使得更新不再是整体覆盖而是靶向编辑。经过验证的核心规则沉淀在主体中,不被执行失误类反馈所触及;而执行中容易被忽略的提醒则记录在附录中。这种分离保证了技能的稳定性——正确的规则不会被一次偶然失败所污染。
ASPIRE 的技能库则呈现出更强的涌现性。它不预设技能的分类体系,让代理在调试过程中自行发现可复用的修复模式。ASPIRE论文中展示的技能涵盖了定位消歧、运动原语构建、导航恢复、场景理解、调试工作流等类别,且这些类别并非预先定义,而是在任务积累中自然生长出来的。更重要的是,实验表明技能库规模与零样本迁移性能直接正相关:在测试中,技能库从 0 个任务来源扩展到 90 个时,成功率从 4.7% 提升至 30.5%,呈现单调增长。
这指向一个更深层的变化:技能库正在从存储辅助信息的容器演变为智能体的长期知识体。 当执行模型保持固定(参数冻结)而技能库持续累积时,系统整体能力不再受限于单一模型容量,而是由知识库的丰富程度决定。这种“固定推理引擎 + 持续进化的知识体”的架构,其长期潜力远超单纯依赖模型参数规模扩展的路线。
对我们的启示:建议从"策略检索组件"重构为"知识积累体",分 3 步推进:
Step 1:将现有技能按"主体(核心可执行代码)+ 附录(接口说明/调用示例/适配场景)"分离存储——目前若是混合存储,可先把附录字段抽离到独立 JSON(JavaScript Object Notation)/YAML(YAML Ain't Markup Language)。
Step 2:在反思模块中,将"哪些任务最常复用某类技能"统计为"技能调用频次 × 跨任务复用率"矩阵,并产出"技能价值指数"报告。
Step 3:在参数冻结的固定推理引擎之外,单独绘制"技能库规模 ↔ 跨任务成功率"曲线,定量评估技能积累的有效性。
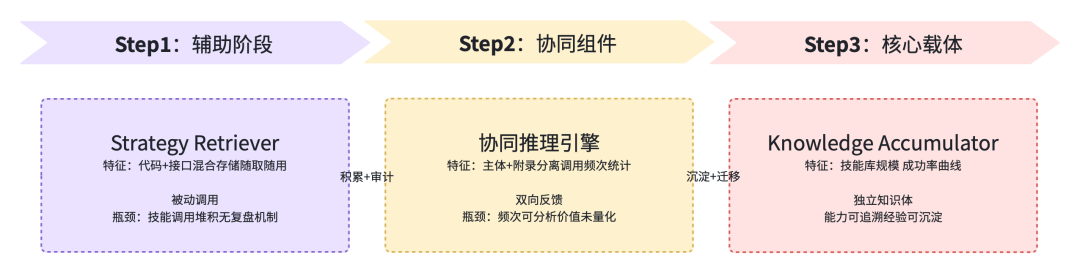
图3:技能库分阶段建议
四
多候选探索:超越单轨迹反思
EmbodiSkill 的进化螺旋构成了完整的闭环,但每个迭代本质上是“一条轨迹 → 一次反思 → 一次更新”的串行模式。当单条轨迹的证据带有偶然性时,更新质量就会受限。
ASPIRE 的进化搜索提供了不同思路:每轮生成 K 个候选程序,全部在调试种子集上执行,基于结果选择最优者作为下一轮种子。在“碗放到盘子上”任务中,搜索从 62% 起步,经过多轮竞争后达到 86%。被淘汰的候选并非无用——它们的失败模式被记录,避免后续重复同样的错误方向。
两种机制对比可提炼出设计原则:技能进化不应过度依赖单条轨迹,而应在多个候选假设间验证筛选。 单轨迹反思类似“根据一次故障排查修订操作手册”,多候选探索则类似“同时提出多个修复方案,在实际测试中择优,再把成功模式标准化”。后者面对物理环境的不确定性时更具鲁棒性。代价是计算开销增加,但技能一旦入库存,后续任务均可复用,这种“前期投入、后期摊薄”的结构在规模化场景下是合理的。
启示:建议在 2 个"低成本高价值"任务路径上试点多候选机制:
试点 1:失败率 > 30% 的关键子任务(如"陌生物体抓取""长序列导航")——在反思模块中生成 2-3 个候选修订方案,对每个候选跑 3-5 次种子验证,取胜出者入技能库。
试点 2:高频复用任务(如"标准烹饪流程""固定路径巡查")——在执行模块中每轮生成 2 个候选执行路径,胜出者入执行缓存。
评估指标:对比试点前后的"同任务二次失败率"+"技能库增长健康度(无重复/无低质)",每月复盘 1 次。
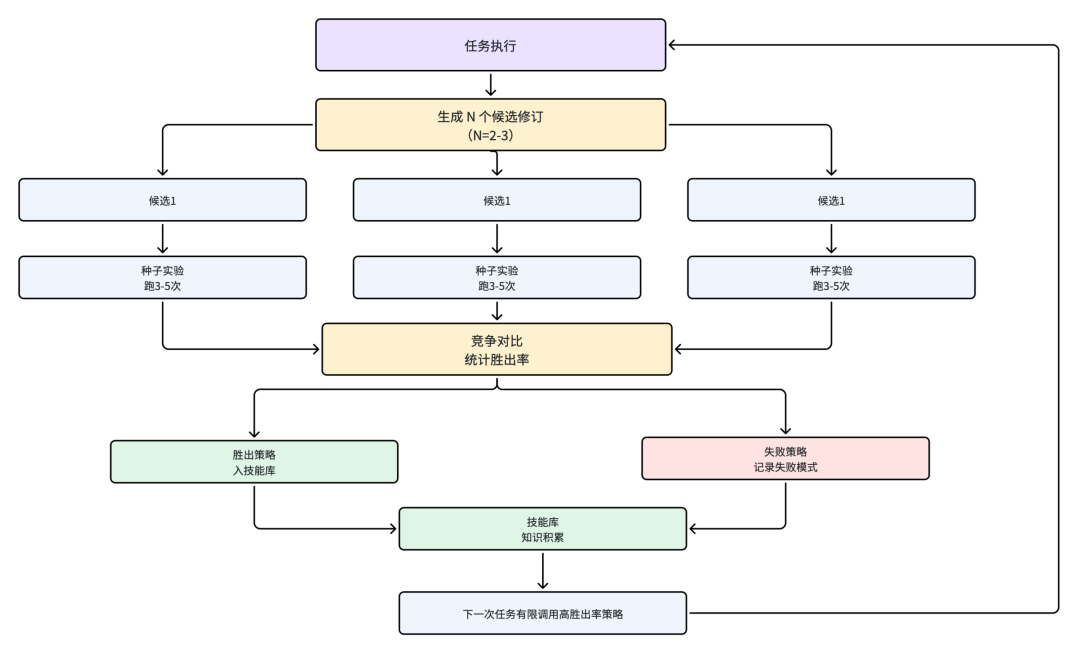
图4:多候选流程图
五
待解决的问题
上述三个方向勾勒了持续进化的核心设计空间,但也留下待探索的问题。
技能库的规模管理:ASPIRE 显示库从 0 到 90 个任务时性能持续提升,但更大规模后,检索效率、条目冲突、过时淘汰将变得突出。如何设计自适应验证-淘汰机制,是后续工程化的关键。规模管理方面,可考虑引入基于调用频次的 LRU(Least Recently Used,最近最少使用)淘汰 + 周期性冲突检测的轻量级维护机制;并在入库存前增加"价值指数"评估环节,把 EmbodiSkill 附录式的稳定性约束与 ASPIRE 涌现式分类相结合。
验证协议的设计:EmbodiSkill 以固定阈值触发更新,ASPIRE 在调试种子集上验证后才入库。但验证集选取可能引入过拟合风险。如何在有限调试资源下设计具代表性的验证集,需要进一步研究。验证协议方面,可在调试种子集之外引入按任务难度分层的验证集结构,并对固定阈值触发与种子集验证两种范式做融合——例如对低风险技能采用快速阈值触发、对高风险技能要求多种子验证,以降低过拟合风险并控制调试成本。
技能的零样本组合:目前工作都基于"从轨迹中提取技能"的模式。当技能库足够丰富后,是否可能通过已有技能的重新组合来应对全新任务,而无需执行轨迹驱动的更新?如果这一路径可行,技能进化的效率将再上台阶——组合的成本远低于从零调试。零样本组合方面,可考虑让代理在执行新任务时优先检索技能库中的相似条目进行组合尝试,把组合尝试的失败模式再回流到反思模块作为新的学习信号,使"组合探索"与"轨迹驱动更新"形成互补而非替代关系。
六
结语
具身智能体的持续进化,不能仅靠更大模型或更多预训练数据来解决。它需要一套系统架构,让智能体从自身执行经验中诊断问题、提炼模式、沉淀知识、持续改进。
EmbodiSkill 和 ASPIRE 从不同路径逼近了这一目标:前者通过反思分类和靶向更新确保进化稳定性,后者通过细粒度执行迹和多候选竞争提升发现效率。两者共同揭示的核心设计原则在于——反馈要足够细,知识要可审计,探索要有竞争。沿着这些方向持续深耕,具身智能体才有可能在真实物理环境中真正实现“越用越聪明”的进化闭环。
参考资料:
[1] Ju R F, Wang X R, Ding X, et al. EmbodiSkill: Skill-Aware Reflection for Self-Evolving Embodied Agents[EB/OL]. arXiv:2605.10332, 2026-05-11. https://arxiv.org/pdf/2605.10332.
[2] Lu R Y, Wu Y B, Kou E, et al. ASPIRE: Agentic Skills Discovery for Robotics[EB/OL]. arXiv:2607.00272, 2026-06-30. https://research.nvidia.com/labs/gear/aspire/assets/Aspire.pdf?v=20260630d.
