Google DeepMind 的科研 Agent Co-Scientist 按三档自主度接手真实实验,从设计配方长晶体到预测菌落形态。150 篇 AI 论文双盲评审,严重幻觉从基线系统的 90% 压到 4%。
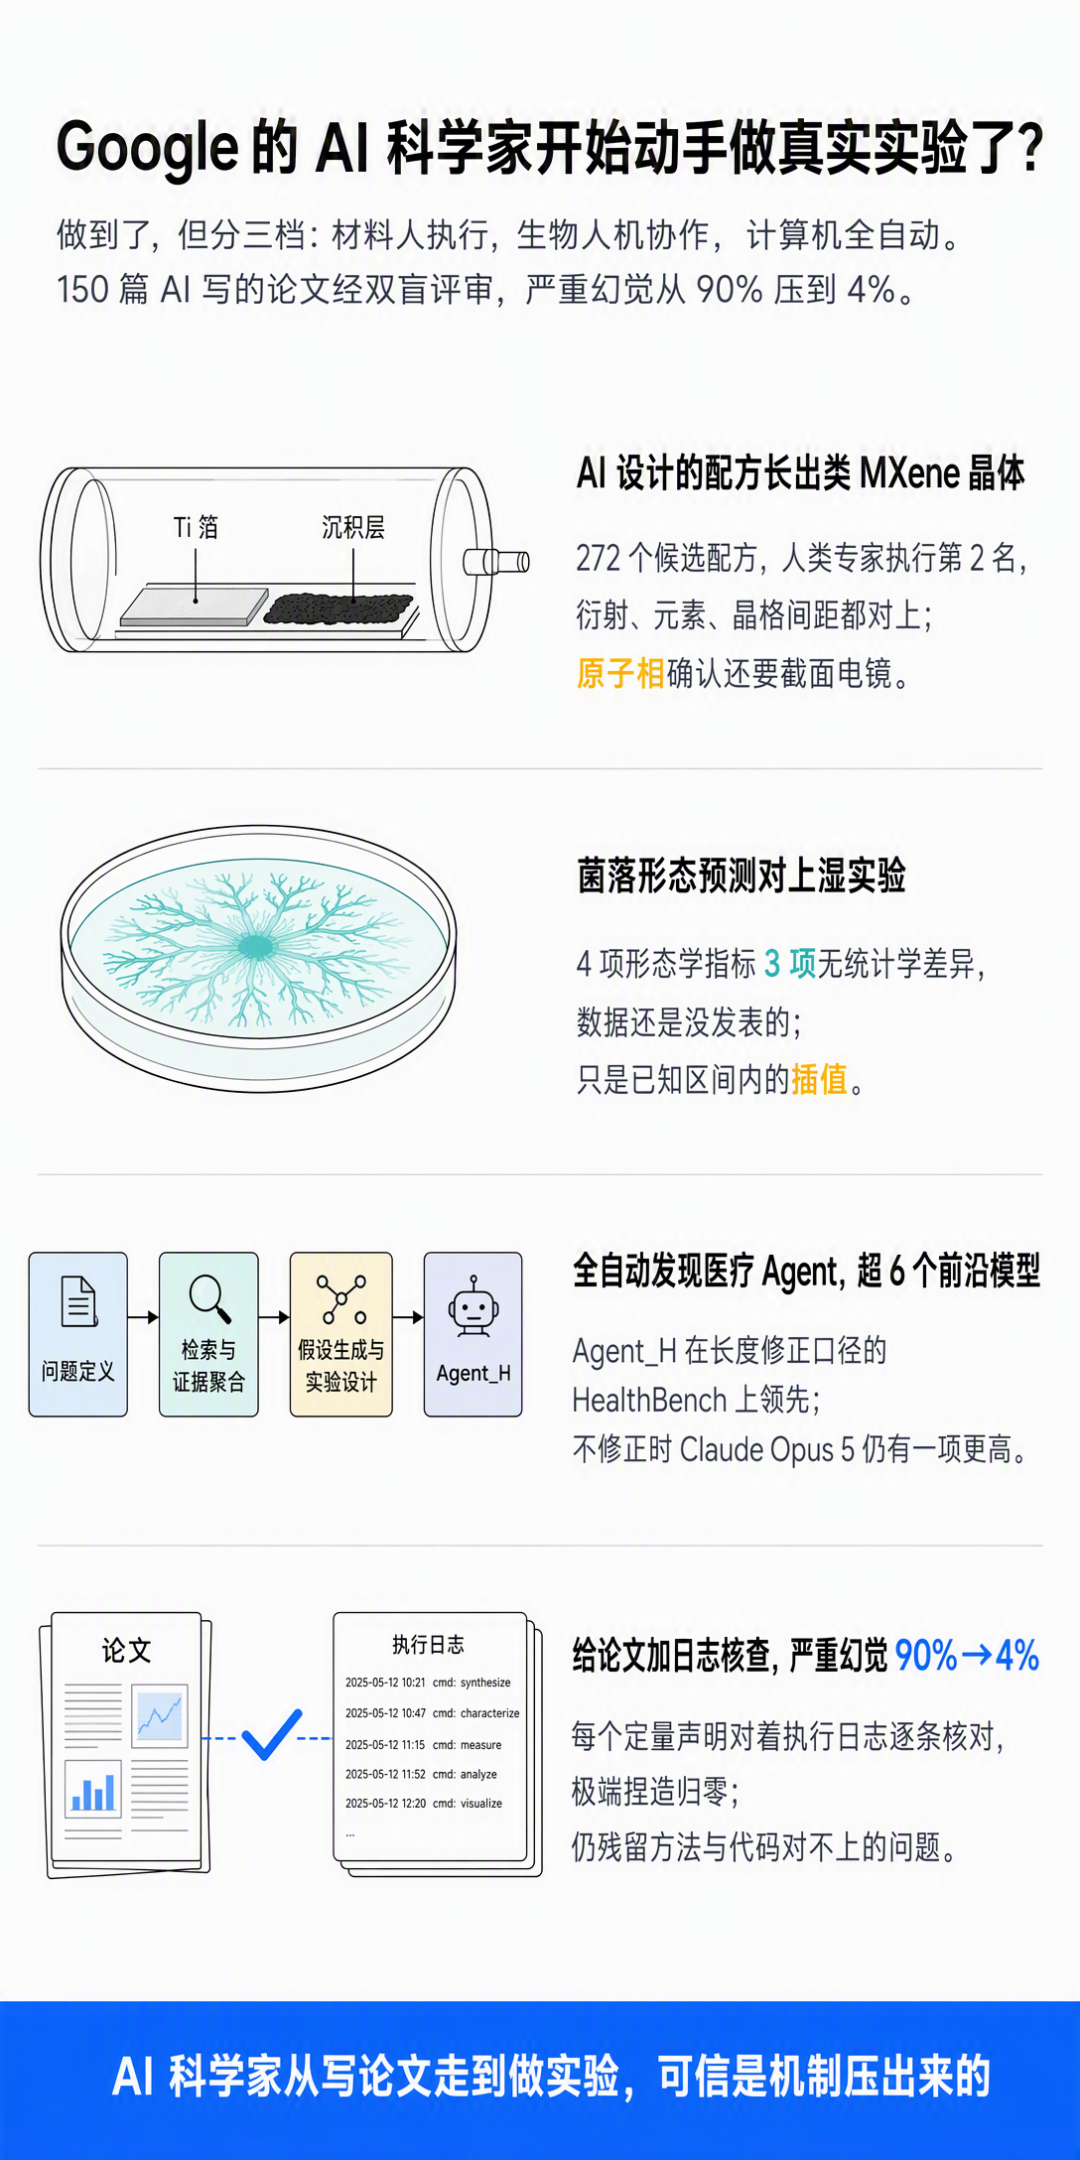
同一套 Co-Scientist,按三档自主度接手三个领域
让 AI 全自动做科研,写出来的论文敢信吗?Agent Laboratory 把问题推到了台前:一个题目进去,一篇论文出来,全程不要人;会不会把跑砸的实验包装成漂亮结果,怀疑没停过。
2026 年 8 月 28 日,Agent Laboratory 的一作 Samuel Schmidgall 在 Google DeepMind 挂出 83 页论文,亲手把前作放上双盲实验台当基线;主角是升级后的 Co-Scientist,基于 Gemini 的多智能体科研 Agent,要让 AI 碰到真实验。
此前的 Co-Scientist 只出假说;新版还接上了实验硬件的接口,部署按三档自主度分级:材料由人类执行 AI 设计的配方,生物由专家与 AI 协作,计算机科学全程全自动;实验越依赖物理操作、越难被确定性核查,人介入越深。
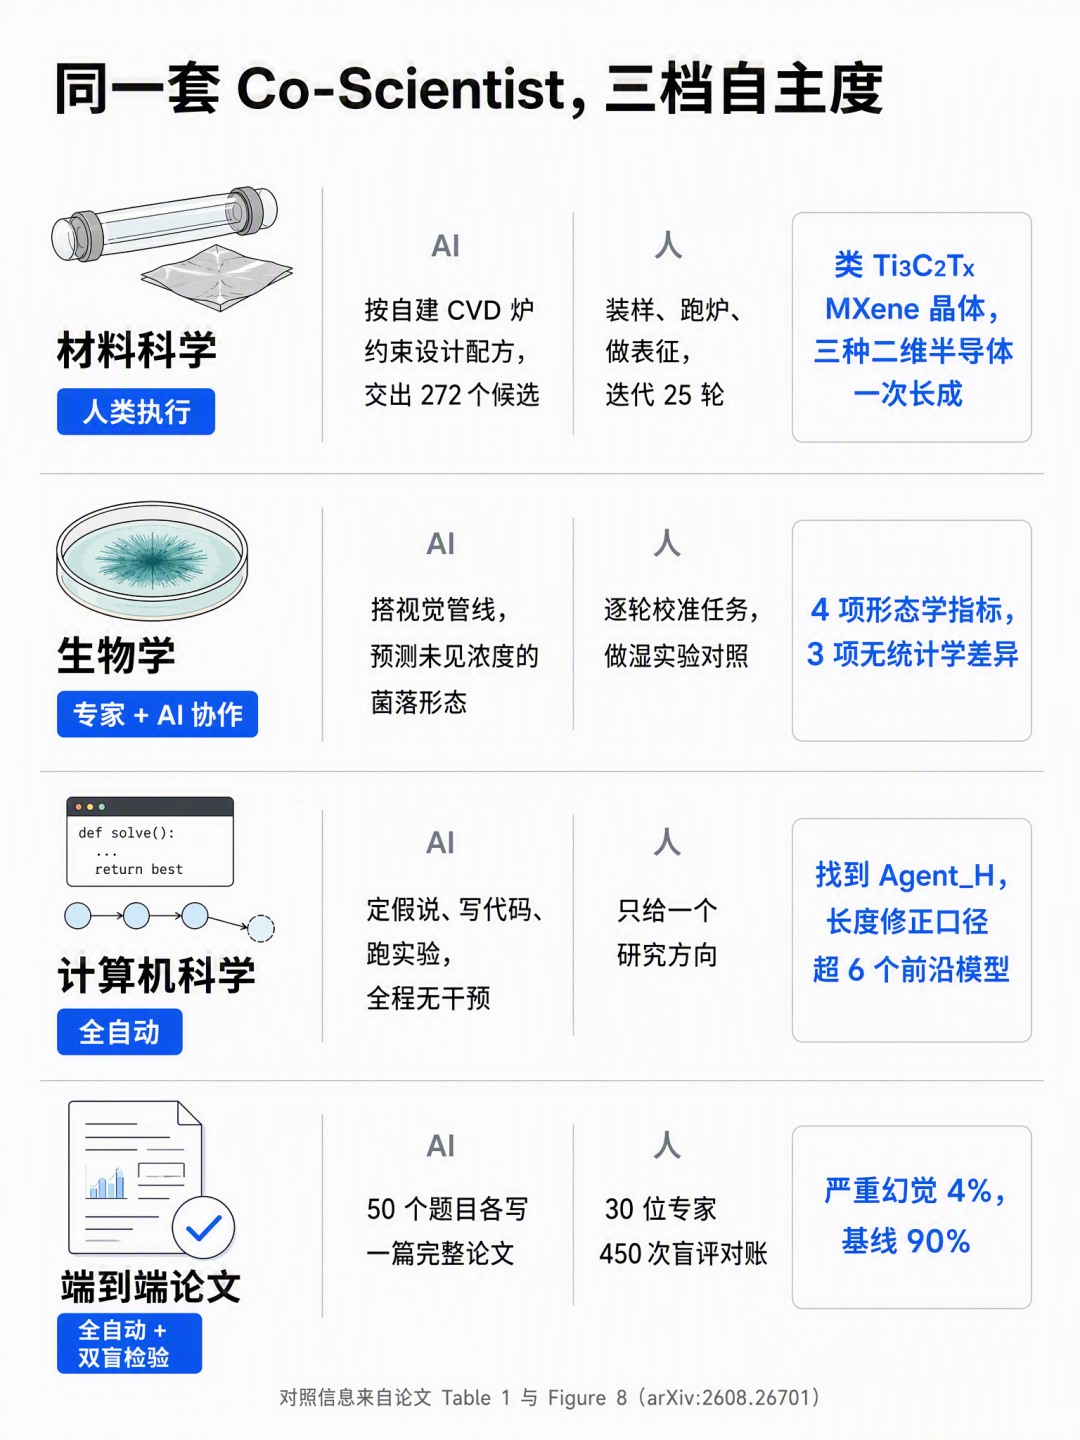
AI 设计的配方长出类 MXene 晶体和三种单层半导体,菌落预测对上湿实验
用化学气相沉积(CVD)自下而上直接生长 MXene,此前没人做成。研究最广的 Ti3C2Tx(过渡金属碳化物二维材料,导电接近金属)一直靠氢氟酸从块体陶瓷刻出来;Co-Scientist 拿到的指令就一条:找一种安全前驱体,替代有毒又怕空气的 TiCl4。
它按实验室自建 CVD 炉的约束推理反应动力学,交出 272 个候选配方。人类专家挑了排名第 2 的方案,六氯乙烷(C2Cl6)加钛粉,迭代 25 轮长出二维晶体:衍射峰位、元素组成、晶格间距都与 Ti3C2Tx MXene 的文献值对上。
是不是真 MXene,还没定。Schmidgall 先把话说死:XRD 峰只是开始,原子相确认需要截面原子级电镜。
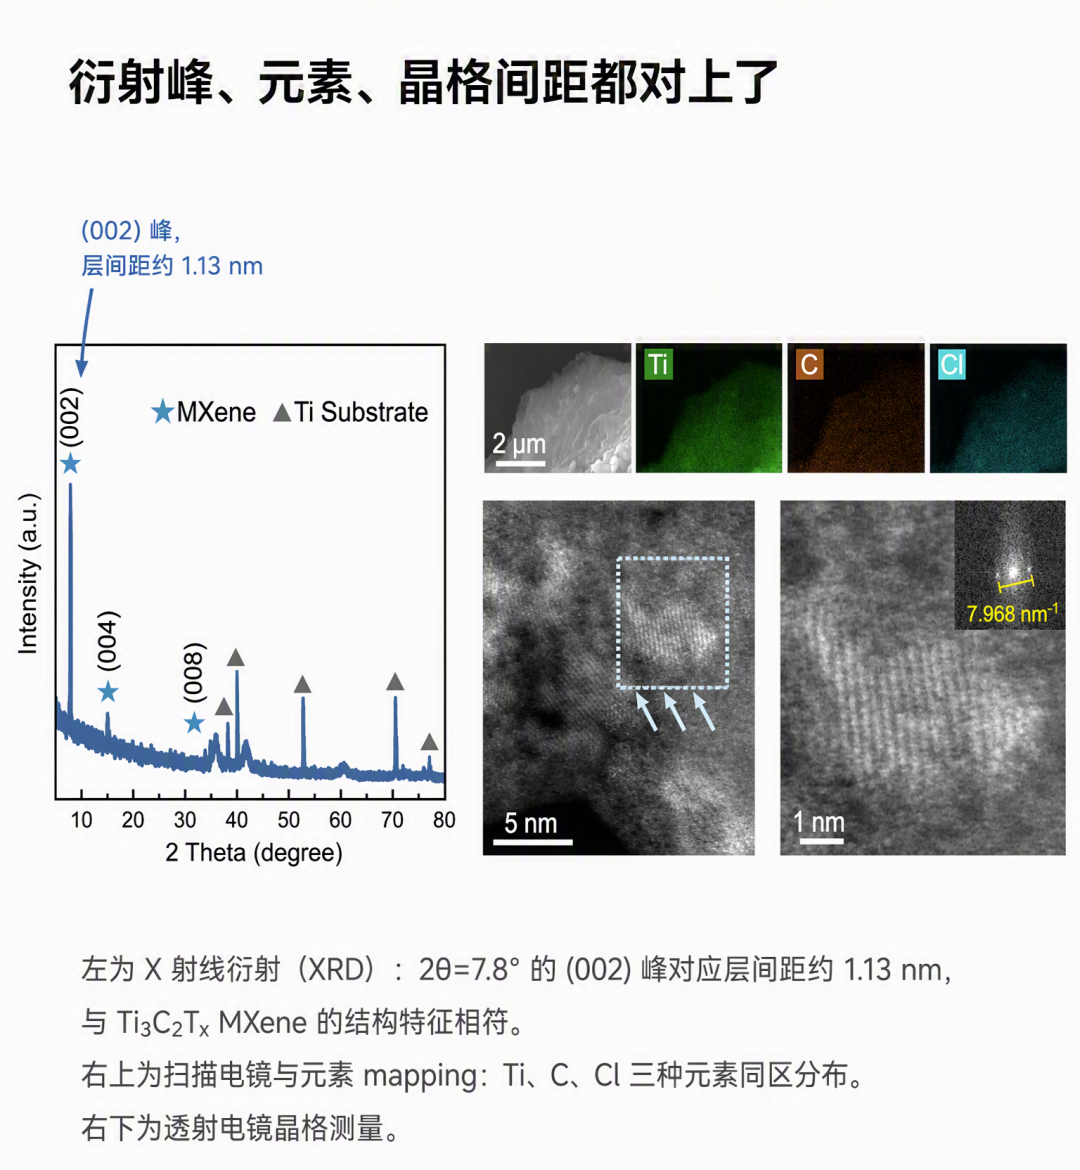
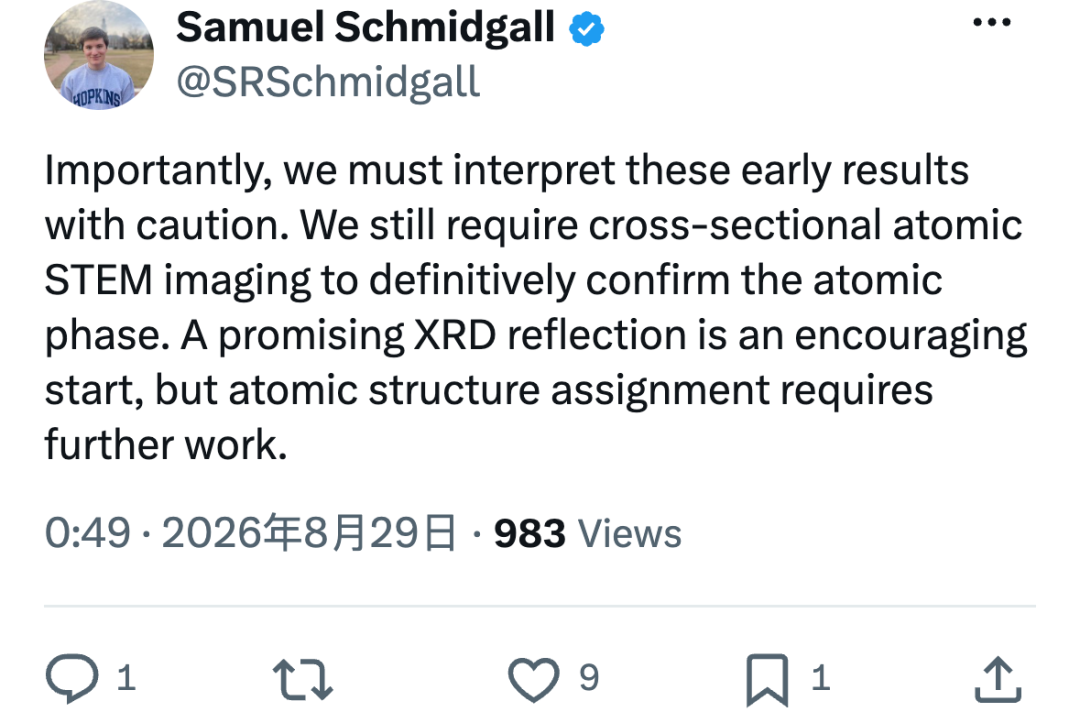
配方还泛化到别的体系。MoS2、MoSe2、WS2 三种二维半导体,实验室只做过第一种;底层模型换成 Gemini 3 Deep Think 做快速推理,几分钟出配方并直接控制炉子,三种材料一次长成单层,总实验约 1 小时。代价是晶体比完整演化配方的更小、更不规整;演示也只在自建炉子上做了一次,跨实验室复现还没证。
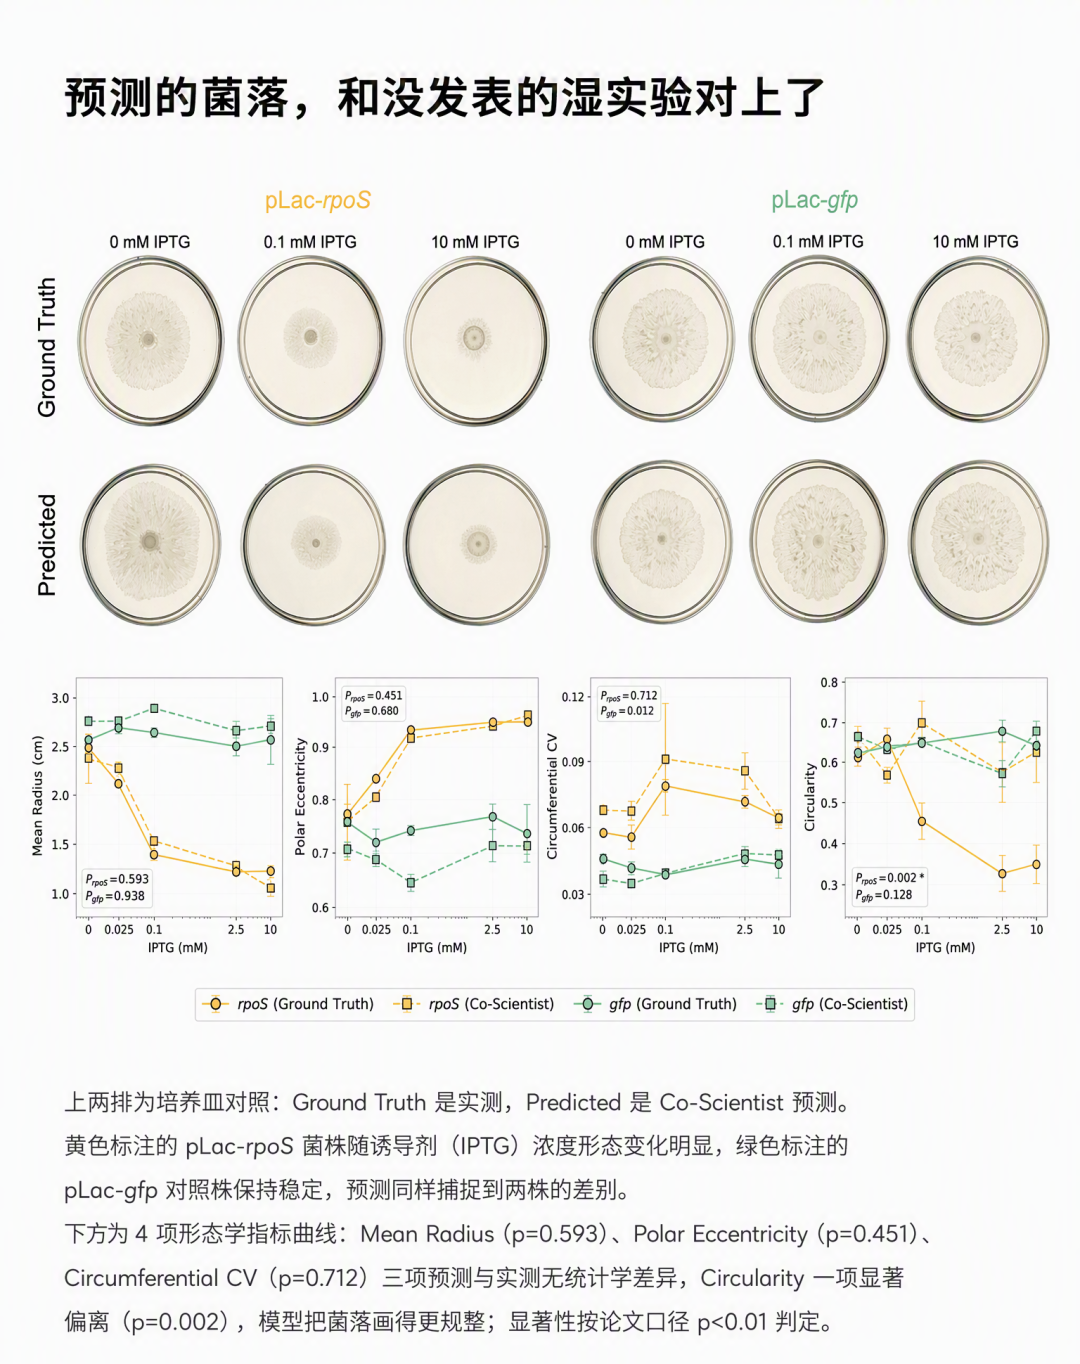
生物档换了分工:AI 不动手,负责预测。工程化大肠杆菌的群集形态随诱导剂(IPTG)浓度变化,Columbia 大学的团队做了整个浓度梯度的湿实验,只把两端浓度的实拍照片交给 Co-Scientist,它搭的视觉管线生成中间浓度的预测图,每个待预测浓度生成 16 张候选再挑出最可信的一张。
预测对上湿实验数据:4 项形态学指标中 3 项无统计学差异,剩下的「圆度」显著偏离,模型总把菌落画得太规整;不响应诱导剂的对照组也预测对了,没硬编出趋势。数据还没发表,模型训练时不可能见过。Schmidgall 还写明:预测是已知区间内的插值,非外推。
全自动发现 Agent_H,再把每个声明钉在执行日志上
计算机科学档没有物理约束:给个研究方向就全自动。交出的成果叫 Agent_H,一套 8 阶段推理时架构:分诊、并行生成 28 到 48 个候选、两两淘汰、多轮审计,回答一题要调 40 到 80 次 LLM,延迟撑不起实时交互。
在两个开发时没见过的医疗评测集 HealthBench Hard(1000 道带陷阱问答)和 Professional(525 道临床推理)上,Agent_H 的长度修正分数超过 6 个前沿模型,GPT-5.6 Sol、Claude Opus 5 在内,两个 LLM 评委口径一致。
长度修正指按 2000 字符为基准惩罚啰嗦。不惩罚长度的原始分数下,Claude Opus 5 在 Professional 上仍更高(0.697 对 0.645)。
AI 编结果是老毛病,病根在 reward hacking:只优化评审分,实验跑砸了的 AI 有动机直接编一个好结果。
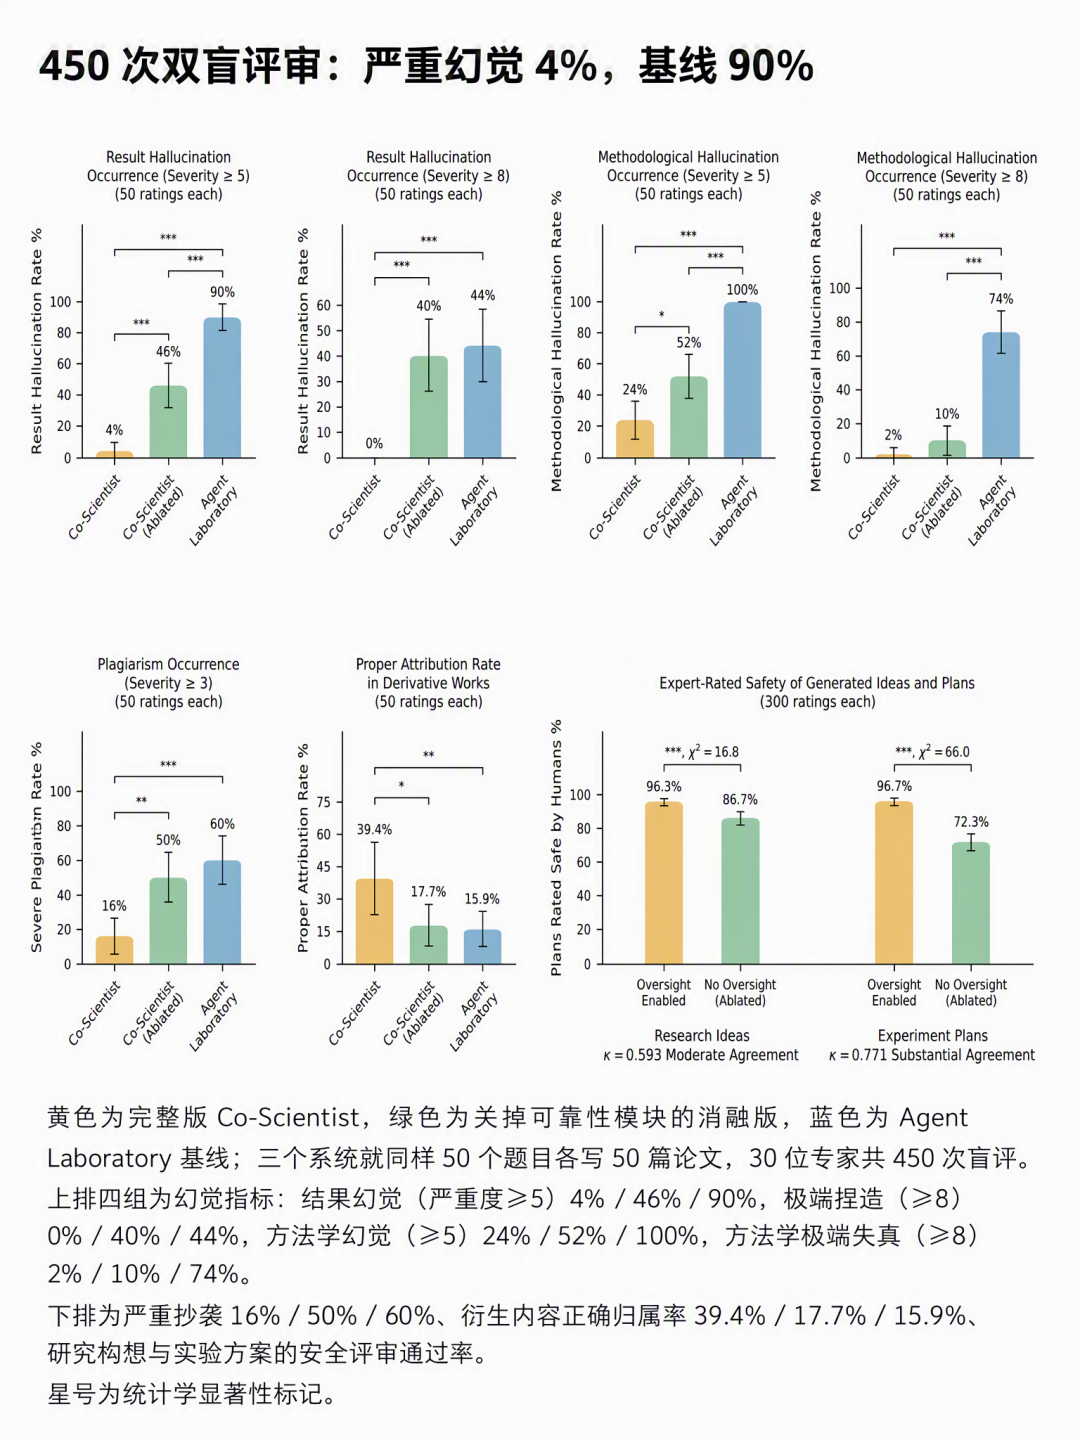
双盲研究让三个系统做同一批题目:完整版、关掉可靠性模块的消融版、Agent Laboratory 各写 50 篇,30 位专家 450 次盲评,拿着执行日志和源代码逐篇对账。
足以推翻结论的严重幻觉,完整版 4%,消融版 46%,Agent Laboratory 90%。极端捏造一项,完整版归零,消融版 40%、基线 44%。严重抄袭 16%,基线 60%。
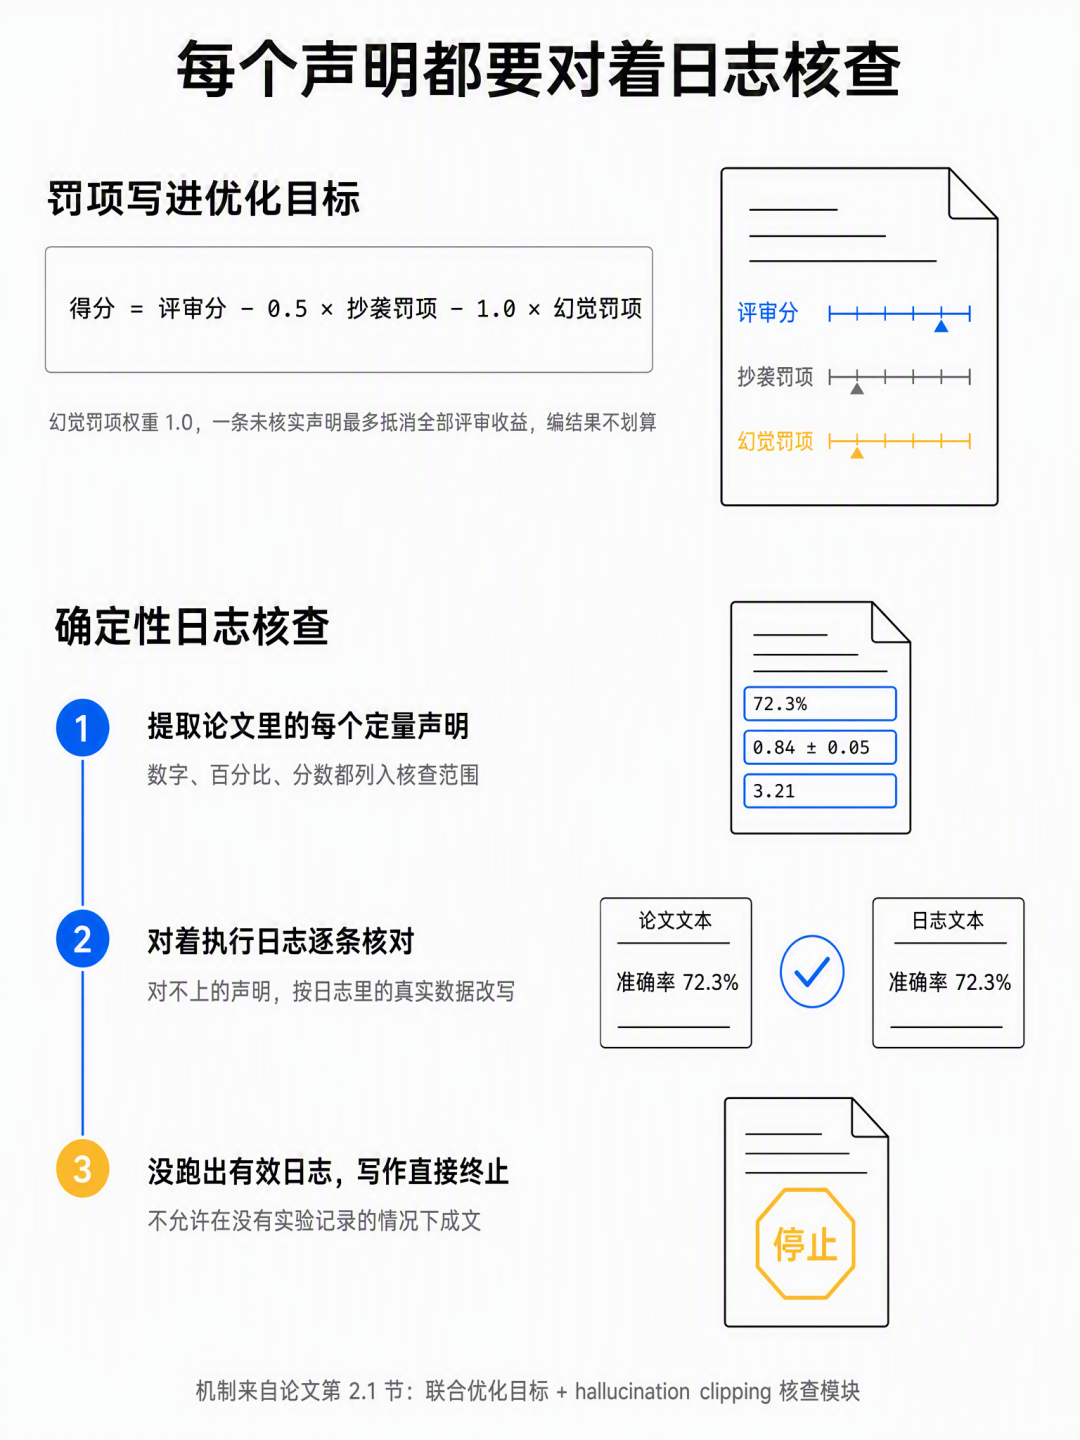
靠的是两处改动。第一,幻觉罚项和抄袭罚项直接写进优化目标,编结果在数学上不划算。第二,确定性核查模块把论文声明绑在执行日志上,没有实验记录就写不成文。相当于每篇论文强制附上实验记录本。
残留问题 Schmidgall 也列了出来:选择性报告、潜意识抄袭、「方法漂移」,论文写的方法和代码对不上。这套核查只在计算领域成立:湿实验的噪声测量还没法像代码日志这样对账。
自动评测赢了 6 个模型,医生盲评 9 项只认 1 项
Agent_H 的大比分领先,到真人盲评就缩了水。3 名执业医生盲评 106 道题,对比 Agent_H 与基座模型 Gemini 3.1 Pro 的回答:9 个临床维度里只有「降低潜在伤害」一项达到统计学显著(p=0.0486),医生对其余 8 个感知不到差别。
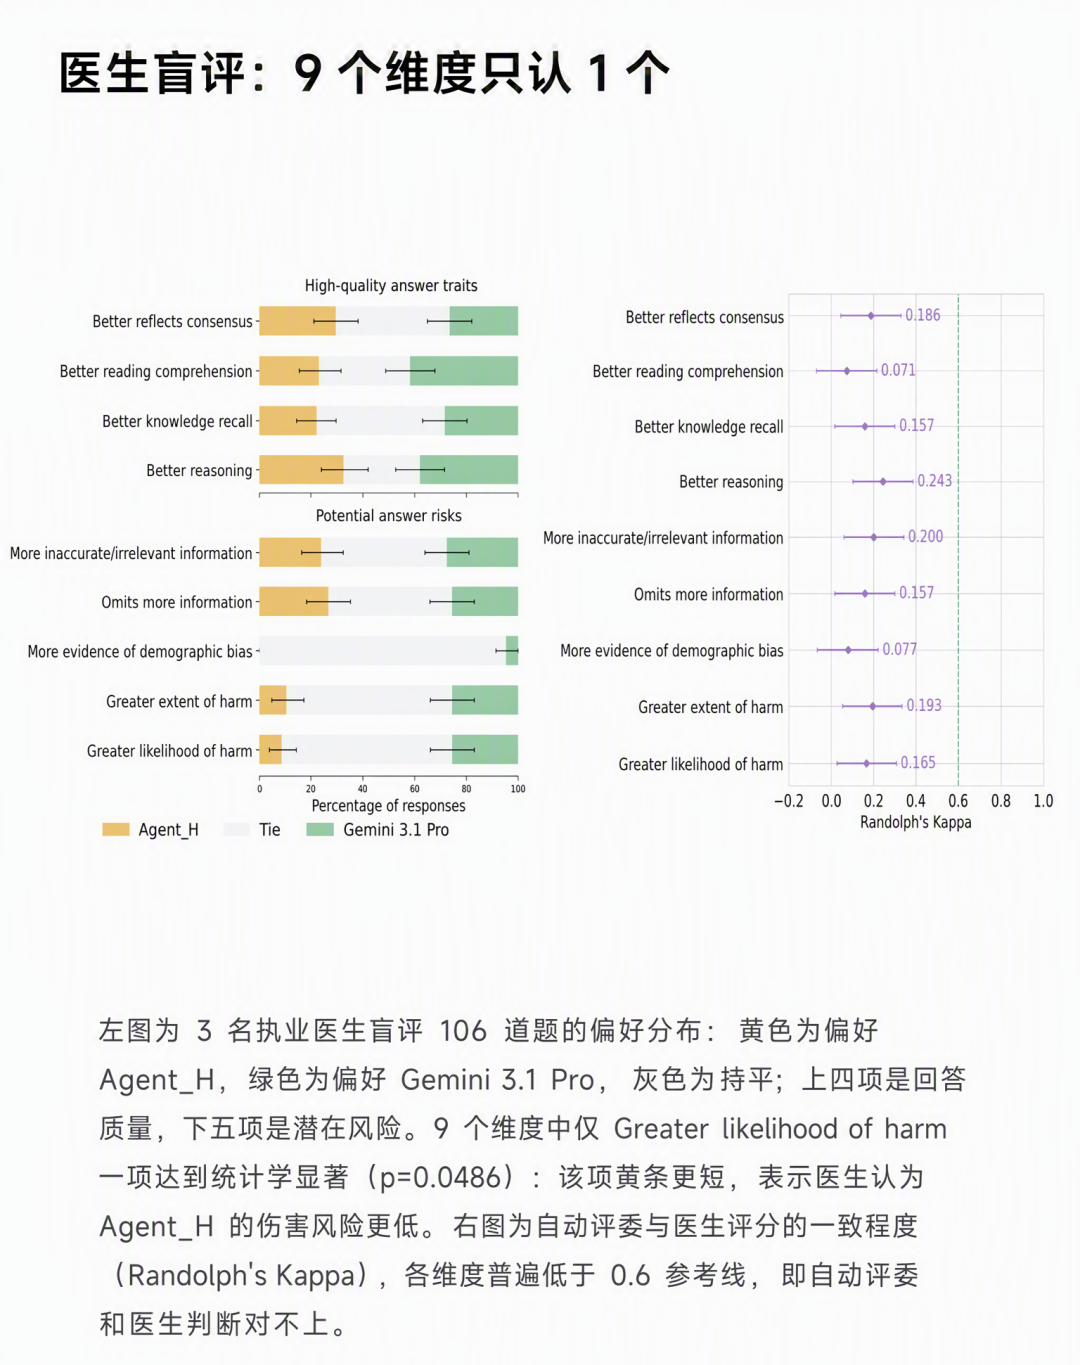
LLM 评委按评分细则逐条打勾,Agent_H 正是照着细则优化的;医生看回答整体可不可靠。自动评委彼此打分一致,和医生评分却普遍对不上。Schmidgall 写下结论:benchmark 分数的上涨不总能转化成专家偏好。
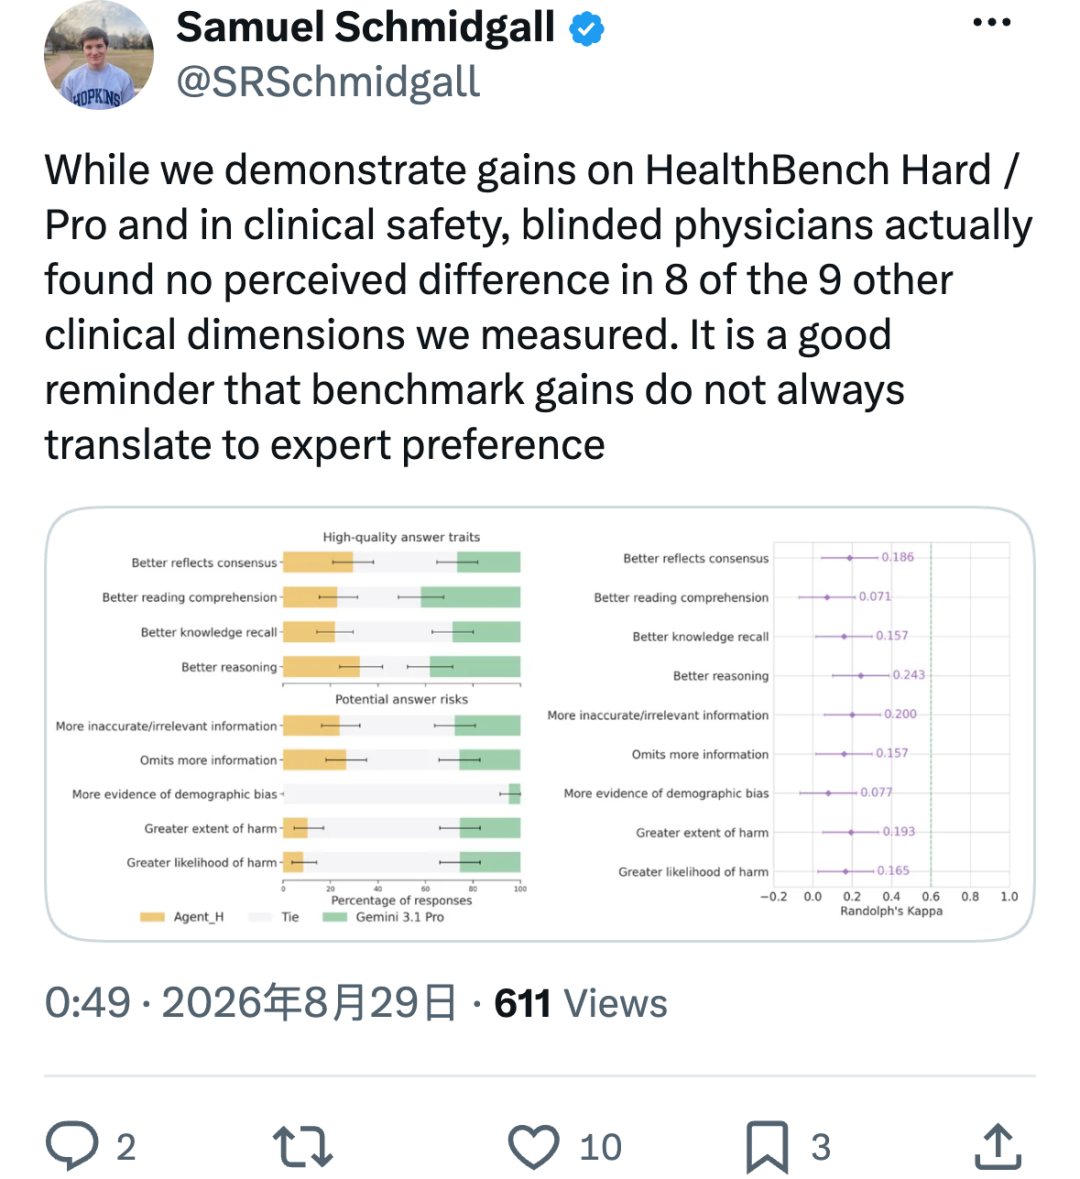
Agent_H 没有失败;医生盲评是对所有 benchmark 捷报的提醒。
Google 把 AI 科学家往前推了一格:设计配方让人类直接执行,预测还没做的实验,全自动做完整个计算研究,每个声明都能对着执行记录核查。AI 科学家从纯计算走进物理世界,走的方式是先把每个声明钉在实验记录上。
