最新的DeepSeek 智能体应用框架(DeepSeek Harness,简称DSH),Model、Tool、Memory、Sandbox 和 Agent 都是可组合、可替换、可扩展的插件。Harness 本身退到最薄——它只做三件事:调度模型与工具、在高危操作前请你审批、维护一份任务计划。
启动方式很轻:
npx @deepseek-ai/dsh web# 默认访问 http://127.0.0.1:3080/
同样按照 Agent = Model + harness 的思路,方舟 Agent Plan 把一个 agent“能干活、能记事、能成长、能出产品”所需的模型和 harness 组件打包,且一次订阅,AFP 额度统一抵扣,预算管理更省心。
DSH 提供了插槽,Agent Plan 提供了量大管饱的 Plugin 工具箱。
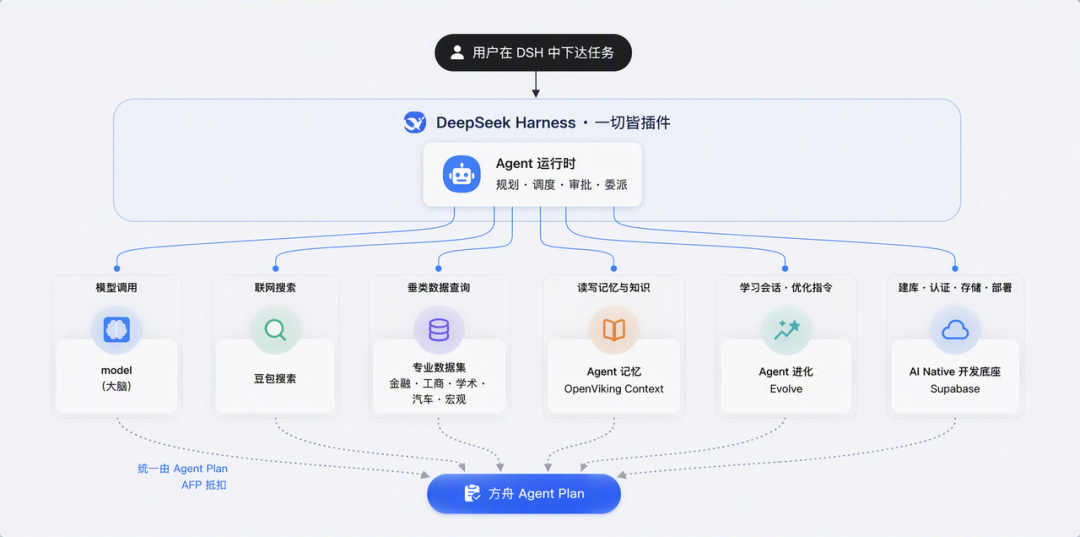
这些组件不是随意堆砌的,Agent Plan 提供的,是方舟沉淀的产品能力,加上广大开发者在真实 agent 项目里反复验证的 Harness 优选组件——搜索该用哪个、数据该信哪个、记忆怎么接、进化怎么做,都已经被挑过一遍。你不必在海量 Plugin 里试错,装上就是一套能打的组合。
一、Agent Plan 提供大脑:全模态主流模型
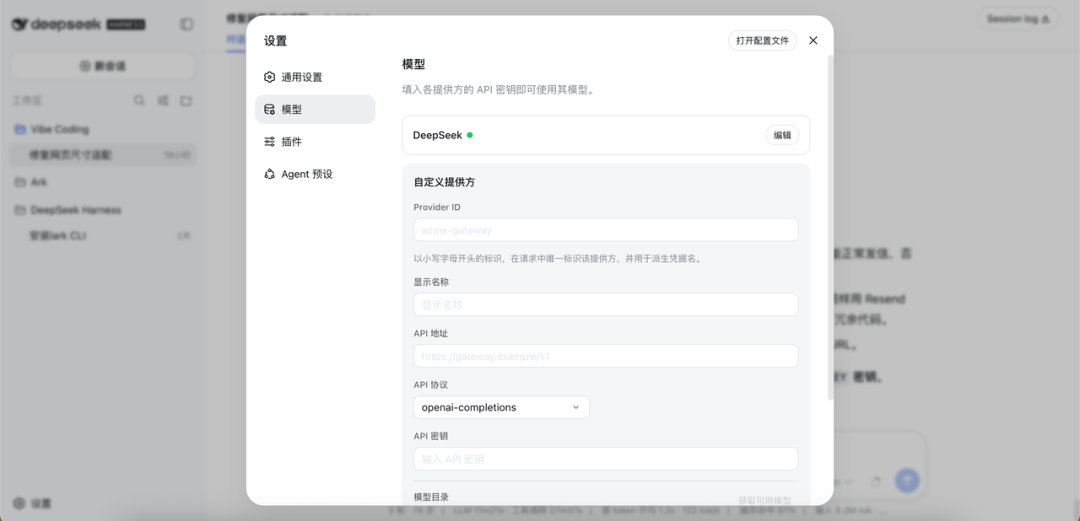
Agent Plan 提供文本生成、图像生成、视频生成、向量化等全模态能力模型,在 DSH 的“设置 → 模型”里添加自定义提供方,用 Agent Plan 专属 API Key 接入模型。
二、Agent Plan 提供手脚和记忆:五大 Harness 组件
大脑就位后,开发者陆续把 Agent Plan 的 Harness 组件全部注入 DSH。它们各自解决一类问题,组合起来才是“量大管饱”。
豆包搜索:让 agent 能上网
模型的知识有截止日期,但任务没有。豆包搜索让 agent 能主动检索最新事实、核验信息出处,并支持权威来源过滤、时间范围筛选、Query 自动改写。
专业数据集:给 agent 硬核数据
通用搜索给不了的东西——上市公司财报、工商信息、司法风险、学术论文、车型配置、宏观指标——专业数据集能查。它会根据 query 自动路由到对应垂类库:
比如 agent 直接问“汽车最近三年的 ROE 变化”,它会调金融数据库返回结构化的 ROE 数据;问“汽车某具体型号的底盘配置”,会路由到车型配置库。
Agent 记忆:让 agent 跨会话记住你
基于 OpenViking Context 的 Agent 记忆是一个“虚拟文件系统 + 语义检索”的上下文数据库。它把记忆、资源、技能统一抽象成文件,分层加载、按需召回,并且在会话结束后自动沉淀长期记忆。接入后,DSH 里的 agent 会在每轮对话前自动召回相关记忆、结束后增量捕获,新会话里提到上次聊过的项目,它依然记得。
Agent 进化:让 agent 越用越聪明
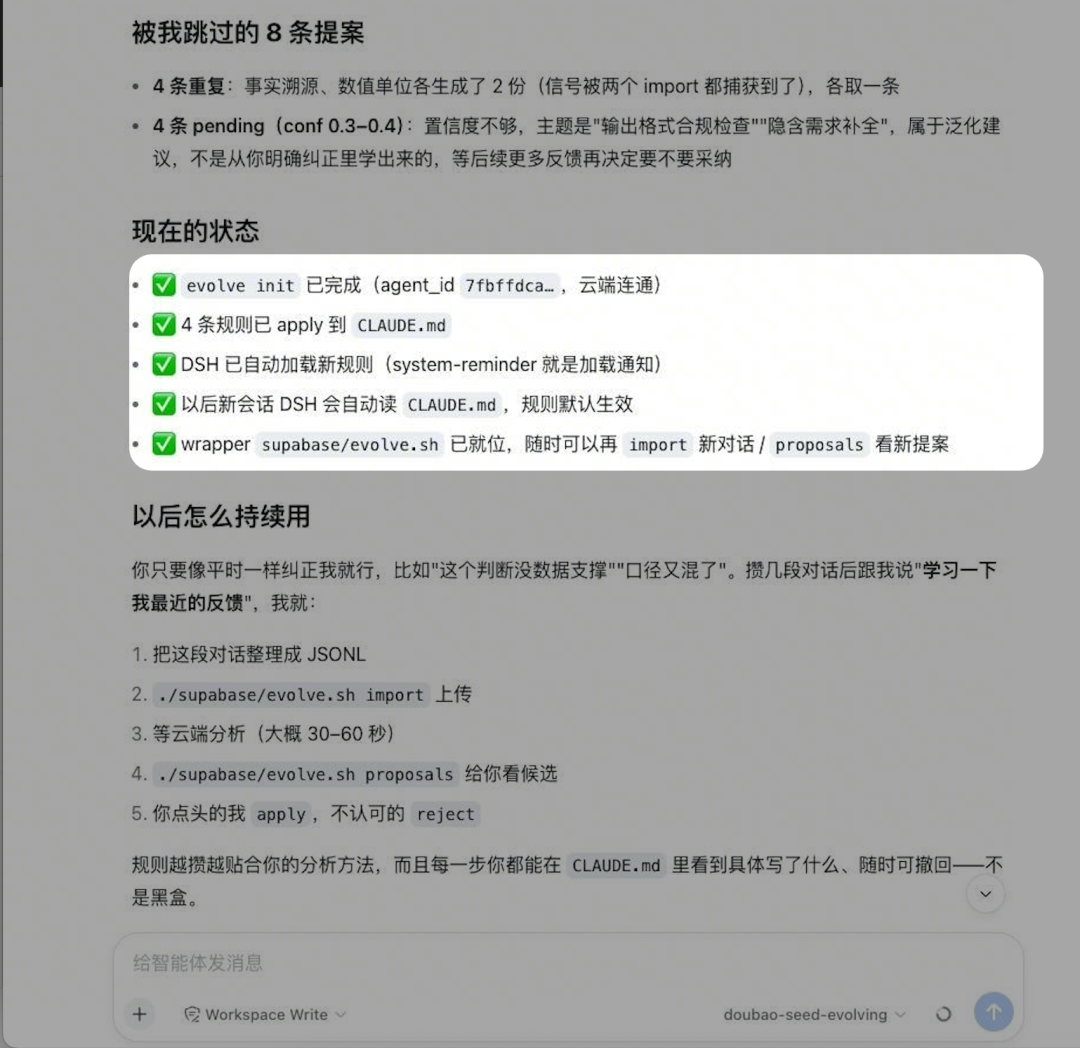
Evolve 组件会学习 agent 的近期会话,识别当前运行时里可优化的指令文件(CLAUDE.md、AGENTS.md、Skills),生成带 diff、证据、风险值和置信度的优化建议;你确认后它才写入。跑几次真实任务后让它 “Learn from my recent sessions”,它会把你反复纠正它的东西沉淀成长期指令。
AI Native 应用开发底座:让 agent 直接把东西做出来
前四个组件让 agent 更聪明,但最终很多任务要落到一个真实产品上:要存数据、要登录、要存文件、要部署。AI Native 开发底座(基于火山引擎 Supabase)给 agent 提供了 Serverless PostgreSQL、认证、对象存储、边缘函数、实时同步和“推送即发布”的前端部署,接入后 agent 可以用自然语言建表、写策略、部署——不用手动搭后端。
三、实战案例:在DSH里长出投资研究助手
小曾是一个独立开发者,也长期关注自己的几只持仓。他想做一个属于自己的投资研究助手:每天自动跟踪三家车企的重要公告和新闻,查询财务指标与核心车型销量,发现值得关注的变化后生成一页研究简报;历史研究结果都能保存下来,之后随时可以继续追问。
他没有从爬虫、数据库和后端开始写,而是打开 DSH,把 Agent Plan 里的模型、搜索、专业数据、记忆和应用开发能力一个个接进去。
然后给 DSH 第一个任务:
我长期关注**、**、**(我们选择了3个真实上市公司股票 )
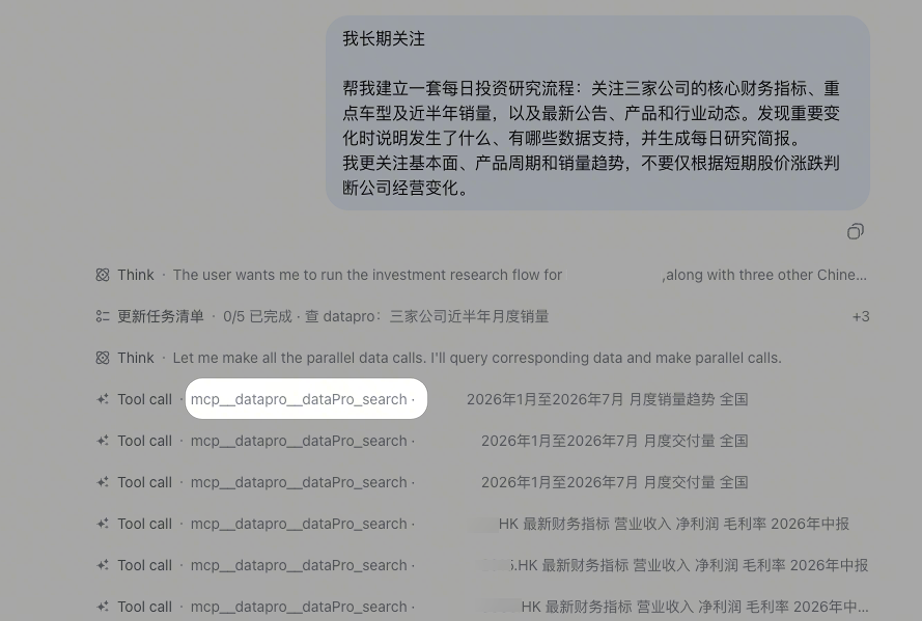
帮我建立一套每日投资研究流程:关注三家公司的核心财务指标、重点车型及近半年销量,以及最新公告、产品和行业动态。发现重要变化时说明发生了什么、有哪些数据支持,并生成每日研究简报。
我更关注基本面、产品周期和销量趋势,不要仅根据短期股价涨跌判断公司经营变化。
1、接入模型和 Harness 能力
为了让这个投资研究助手不只是“根据模型知识聊几句”,小曾为 DSH 接入持续升级能力的 Seed-Evolving 模型,Seed-Evolving 模型在搜索幻觉、工具调用幻觉、状态幻觉等方面显著降低,同时抗误导能力明显提升,整体输出更加可靠。之后小曾又陆续接入 5 类 Harness 能力:
Harness 能力 | 在这个案例中的作用 |
专业数据集 | 查询三家公司的营收、利润、ROE、估值等结构化金融数据,并补充重点车型配置及近半年销量 |
豆包搜索 | 获取最新公告、产品发布、价格调整、行业新闻等实时信息,为数据变化补充事件背景 |
AI Native 开发底座 | 保存公司、财务指标、每日简报和历史研究结果,并生成可持续查看的投资研究页面 |
Agent 记忆 | 记住小曾关注的公司、研究偏好及历史结论,新会话中无需重新交代背景 |
Agent 进化 | 从多次研究和用户修正中学习小曾的分析方法、关注指标及简报习惯,并沉淀为后续任务规则 |
2、第一次运行:从一个问题到一份研究简报
拿到任务后,Seed-Evolving 首先不会直接给出结论,而是把任务拆成需要执行的步骤。Agent 根据不同的任务自主选择对应的数据和工具完成研究。
2.1 先查专业数据
对于财务和产品等结构化信息,Agent 优先调用专业数据集。
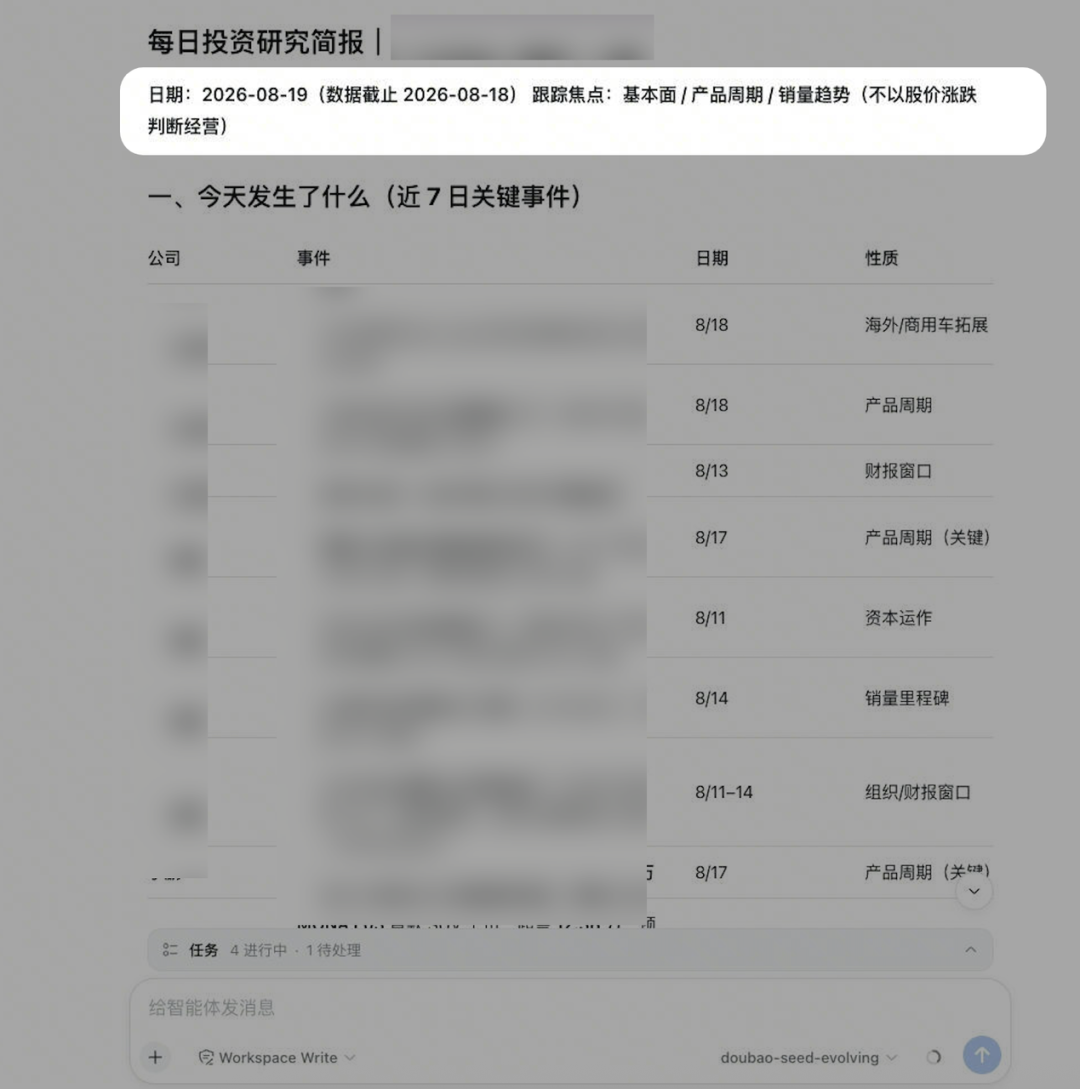
2.2 再用豆包搜索解释“最近发生了什么”,最后生成每日研究简报
2.3 不止生成一次:把研究结果真正留下来
到这里,一个普通 Agent 其实已经可以结束了:任务完成,给出答案。
但小曾想要的是一个长期使用的研究助手,而不是每天重新问一遍。于是他继续对 Agent 说:
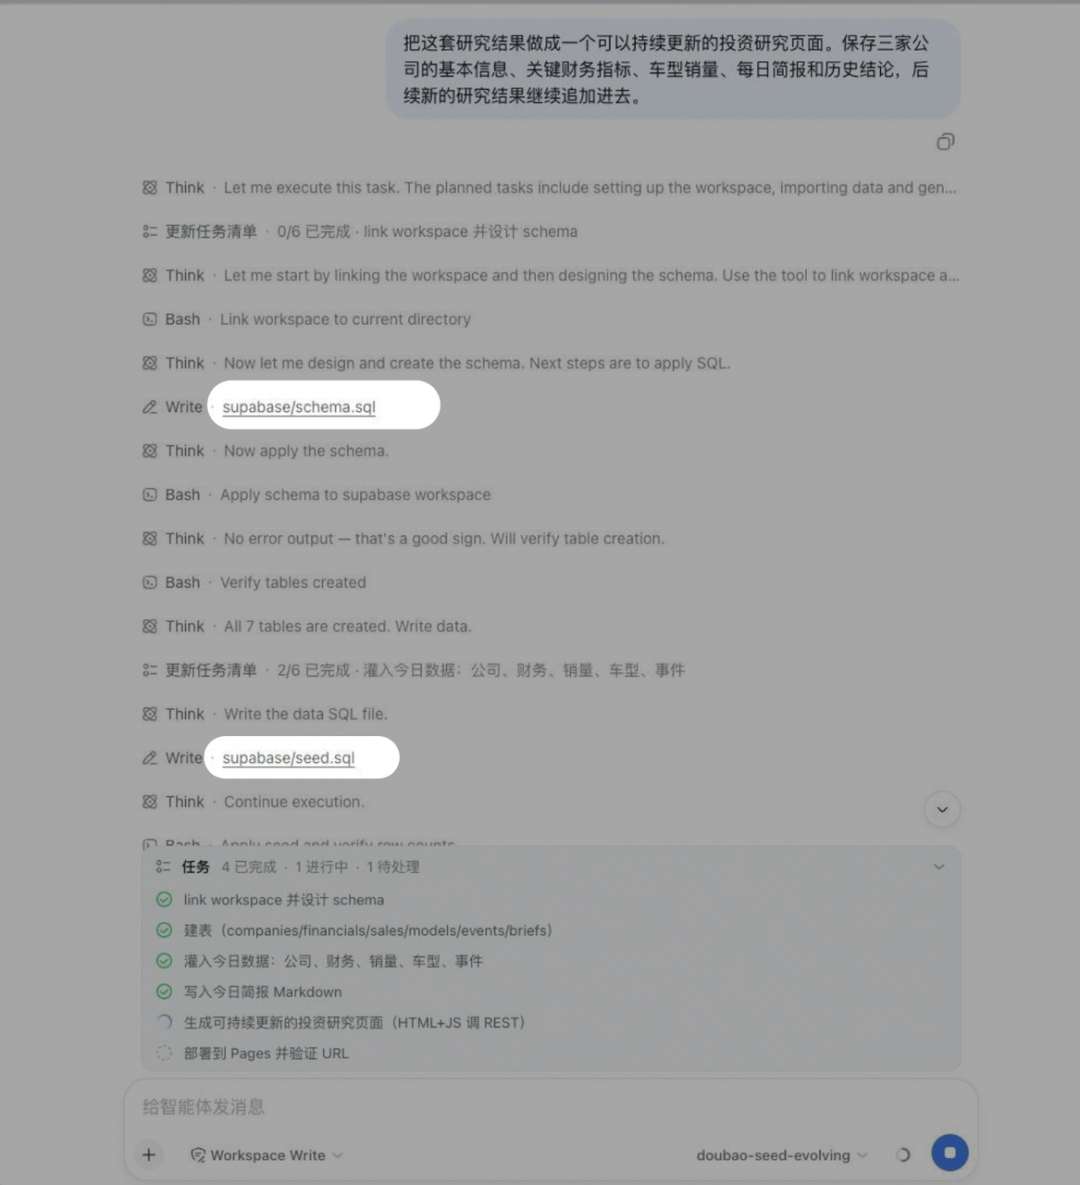
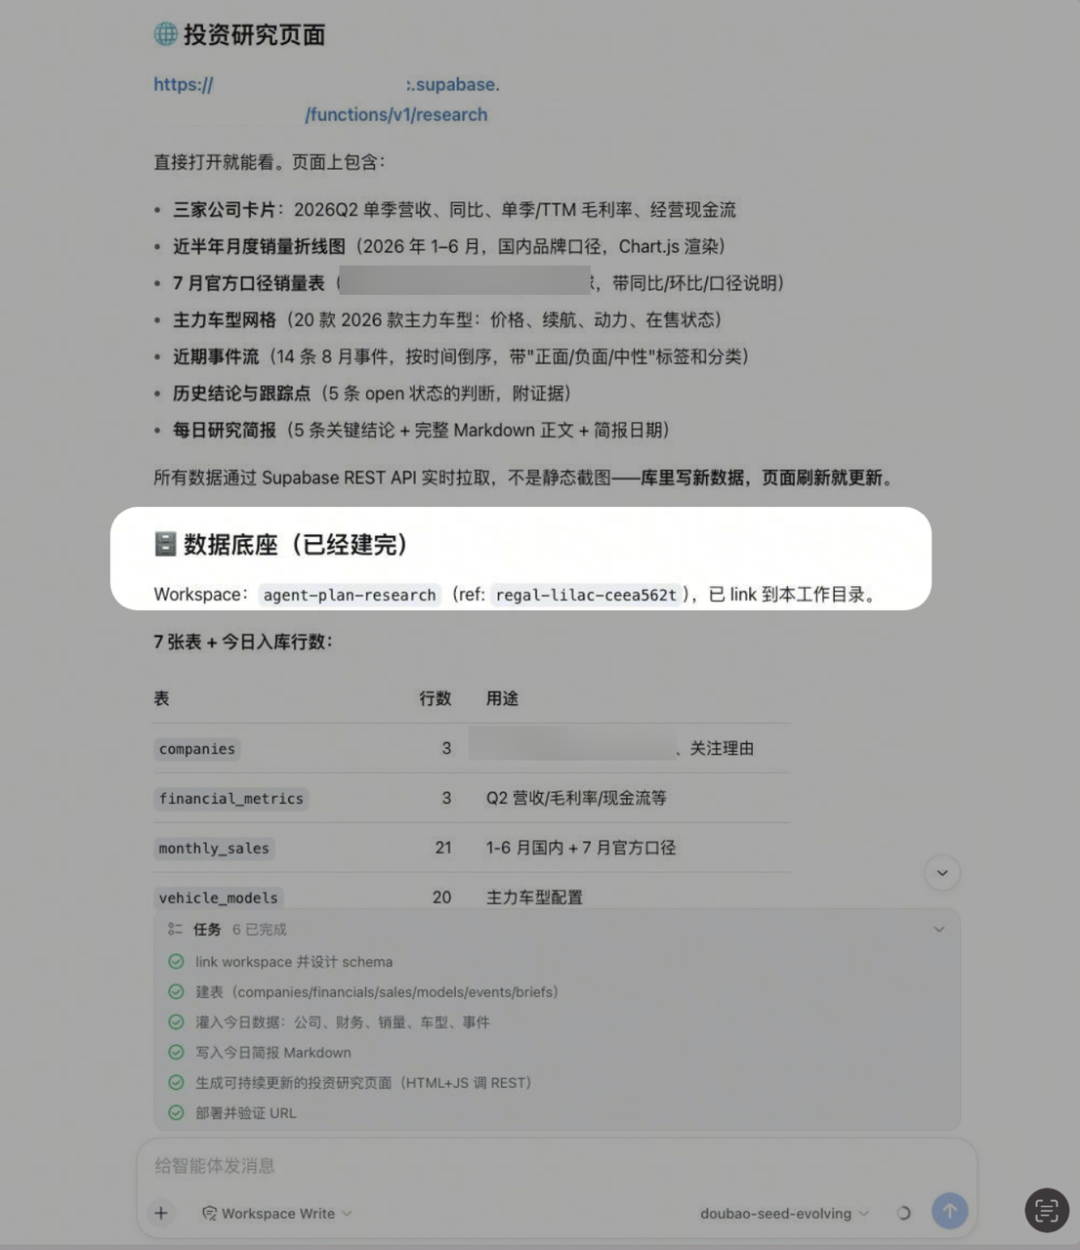
把这套研究结果做成一个可以持续更新的投资研究页面。保存三家公司的基本信息、关键财务指标、车型销量、每日简报和历史结论,后续新的研究结果继续追加进去。
这时,Agent进一步调用 AI Native 开发底座 Harness能力。
2.4 第二次打开,它还记得小曾的习惯
在第一次研究中,小曾已经告诉 Agent:
我更关注基本面、产品周期和销量趋势,不要仅根据短期股价涨跌判断经营变化。
完成首轮任务后,小曾新开一个会话,只问:
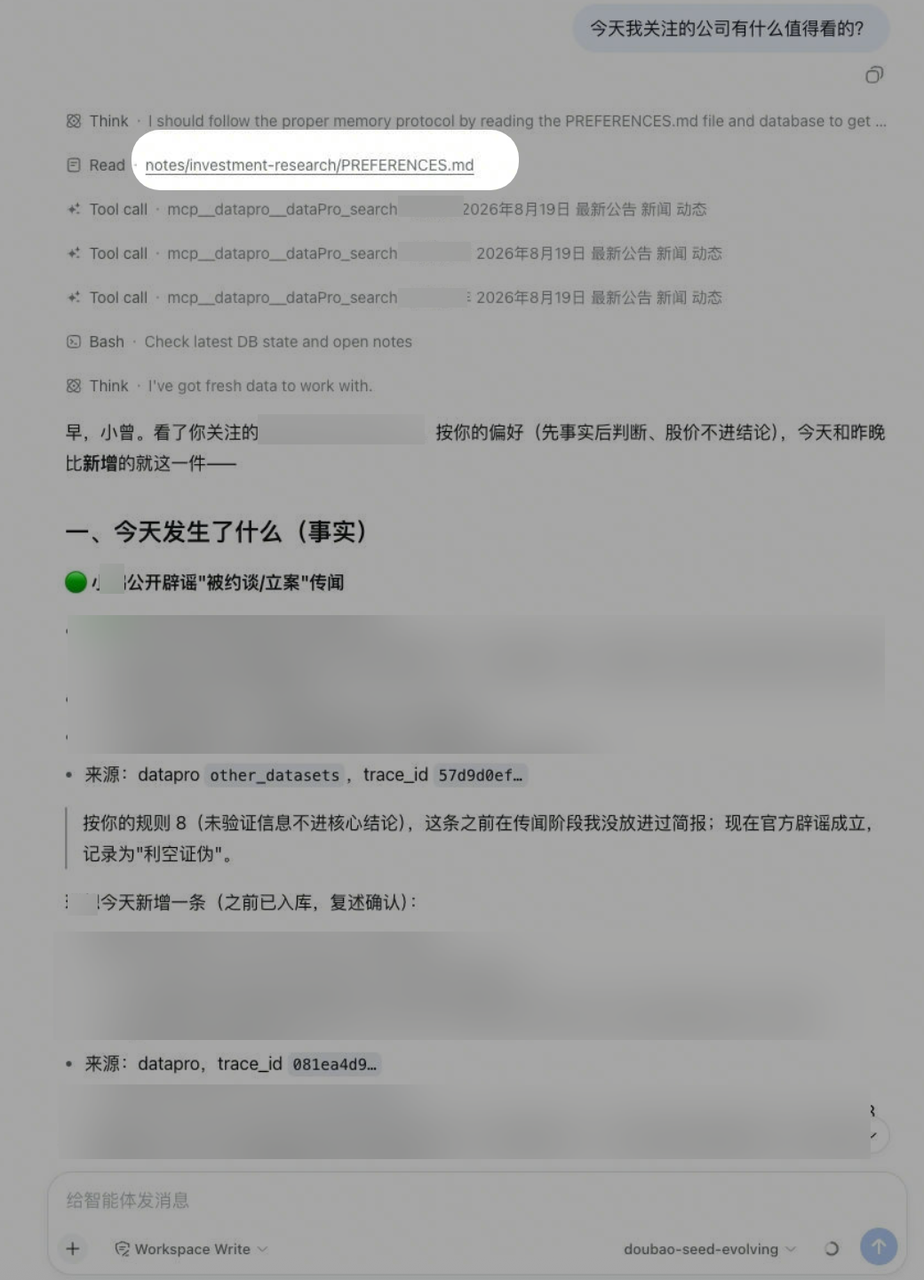
今天我关注的公司有什么值得看的?
基于 OpenViking Context 记忆能力基座的 Agent 会记住小曾的习惯,给出符合小曾要求的回答。
2.5 用一段时间后,它开始学习小曾的研究方法
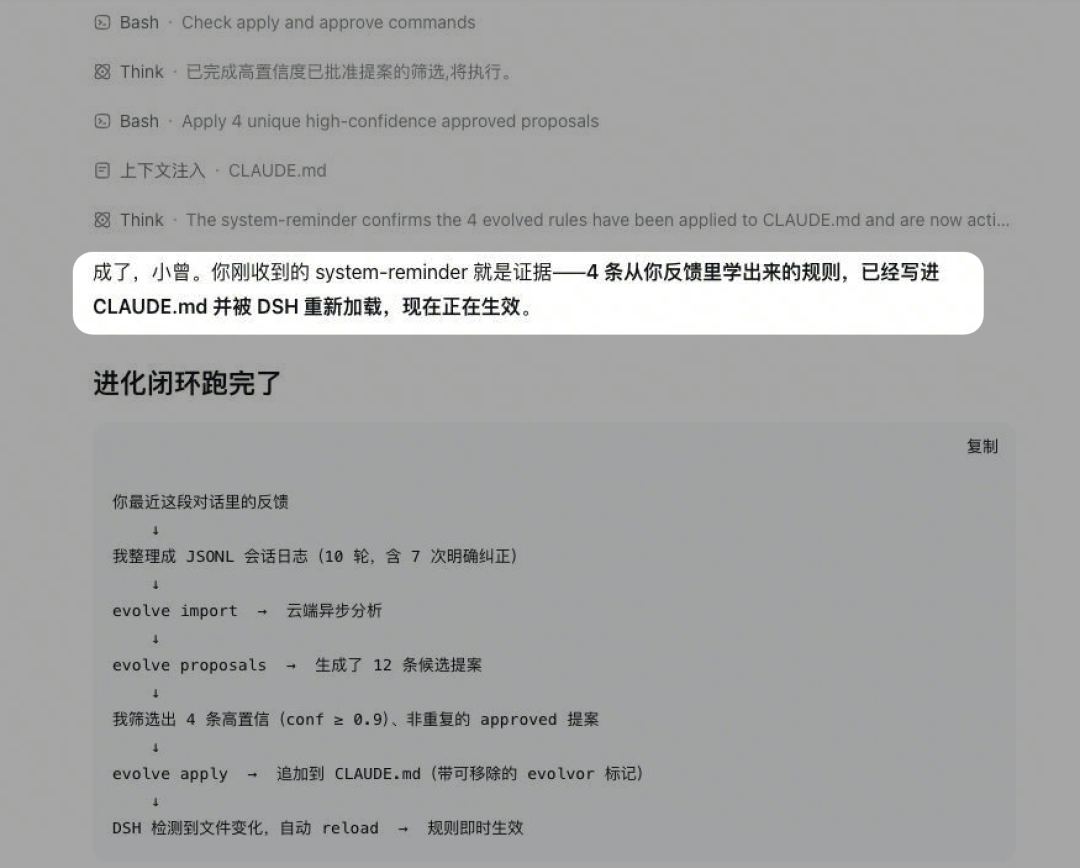
单次看,这些只是普通的人机对话。但当类似反馈在多个任务里反复出现后,Agent 进化能力可以从近期会话中识别这些稳定的工作习惯,并生成长期规则的优化建议,例如:
DeepSeek Harness 把插槽做得薄而开放;Agent Plan 负责把好的插件递到手上,剩下需要输入的,就是无限的创造力。
