Google 开源了一对专门给 AI Agent 用的基础设施项目:AX(Agent Executor)和 Agent Substrate。AX 管上层编排,你写几段 YAML,它负责把一个 Agent 放进隔离沙箱、接好代码仓库和工具、锁死网络出口;Agent Substrate 管底层执行,官方给出的数字是挂起恢复不到半秒、每秒可以做 500 次以上挂起和唤醒,还能把大约 250 个 Agent 塞进 8 个 pod 里轮流跑。两个项目都在 GitHub Trending 上,AX 单日涨了 2300 多个 star。
Google 为什么觉得现有工具不够用?官方博客给的解释是:Agent 开始承接一跑就是几个小时甚至几天的任务,这类长任务脆弱、难管理。AX 的仓库文档把原因写得更细:Agent 这种程序和网站后台不一样,和定时脚本也不一样,它会积累状态,要访问模型接口和外部工具,需要严格隔离,而且没人看管的时候,它会在一个循环里不停地烧 API 费用。这些特征凑在一起,就是一类全新的工作负载,Kubernetes 原生那套抽象(Deployment、Job)没有为它设计。
AX 的解法是把 Agent 运行拆成四种声明式资源,全部写成 YAML:Task 是一个带 CPU 和内存上限的隔离沙箱;Workspace 预先把代码仓库、MCP 工具、技能包装进沙箱,让 Agent 开局就是热的;Gateway 把沙箱能访问的外部主机锁进一张允许列表;Model 集中管理平台调用哪家模型、密钥放哪。一条 ax apply 命令全部提交,命令行用法刻意做成了 kubectl 的样子。
对普通人来说,这套东西解决的是"AI 干活时我怎么放心"的问题。举一个 Gateway 的例子:你可以规定一个 Agent 只准访问模型服务商和你自己的代码仓库,它想去别的地址,流量直接被拦。沙箱里的 CPU 和内存也有上限,Agent 写出死循环代码,烧不掉整台机器。挂起功能则省的是真金白银,Agent 等人工确认的时候先挂起,机器让给别人用,确认完半秒内原地满血复活,接着上次的进度干。
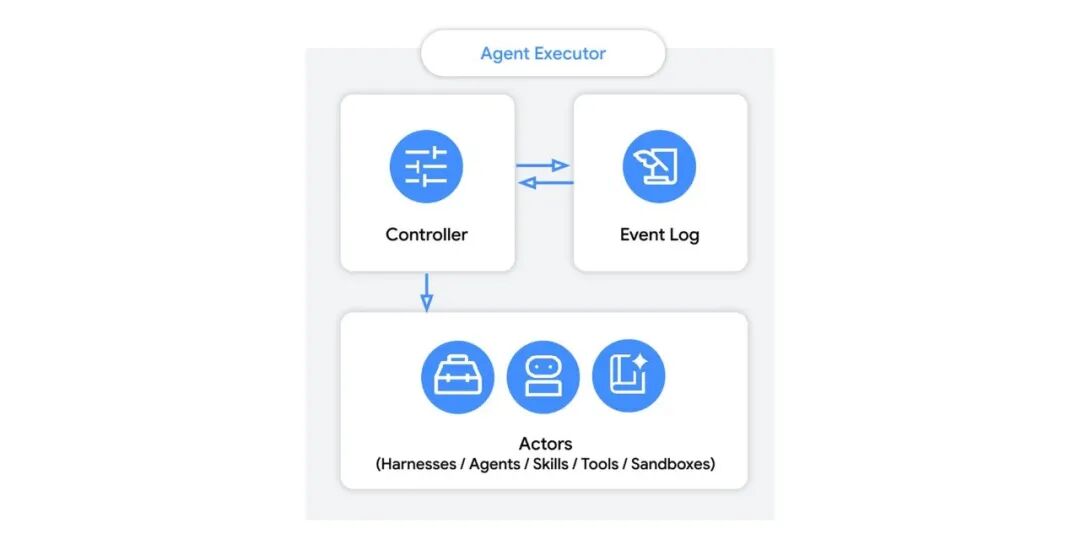
省机器的原理值得单独说。Google 观察到 Agent 大部分时间在等:等模型返回、等用户点头、等外部接口响应。Agent Substrate 于是让大量"actor"(一个 Agent 就是一个 actor)轮流占用少量真正在跑的机器,挂起时把整台沙箱的内存和文件状态拍个快照存起来,唤醒时快照可以在池子里任何一台机器上还原。官方演示里,250 个有状态的 actor 在 8 个 pod 上流转,超卖比例超过 30 倍。这和航空公司的超售逻辑是同一种算账方式:赌所有人不会同时起飞。
想自己上手,门槛是一套 Kubernetes 集群加几个命令行工具,装好后写一份 task.yaml(声明用什么镜像、跑什么命令、挂哪个 workspace、走哪个 gateway),ax apply 提交,ax watch 看进度,ax ssh 能直接钻进沙箱里看 Agent 在干什么。Google 和 Anthropic 的模型配置都有现成样例,密钥走 Kubernetes 的 Secret 机制管理。
两个项目现在都处在早期,README 里印着警告:核心概念和接口还会大改,不适合生产环境。但方向信号很清楚:Agent 的数量往上走之后,"怎么养"会成为一个独立的技术层,Google 已经把这一层摆上了货架。对用得上 Kubernetes 的团队,它是一套可以直接试的开源方案;对其他人,它至少剧透了行业下一步要解决的问题。
参考:GitHub google/ax 与 agent-substrate/substrate / Google Cloud Blog(2026-05-21)
