赋灵计划 · AI 产品最前线
个人 AI 的下一场战争:谁拥有你的记忆?争夺的不是聊天记录,而是你的数字人生控制权。
Google 正在让 AI 的长期记忆跨设备存在;Meta 正在强化眼镜与个人 Agent 的私密计算;OpenAI、Google 和 Meta 又同时为 Agent 建设沙箱、虚拟机和专属浏览器。
这些看似分散的动作,其实指向同一场竞争:AI 不只要理解你,还要持续记住你,并替你改变现实世界。
“记忆决定 Agent 相信什么;执行环境决定 Agent 能改变什么。”
这篇文章要回答三个问题:厂商为什么争夺记忆?执行环境为什么同样重要?产品经理还能从中找到什么新机会?
|
|
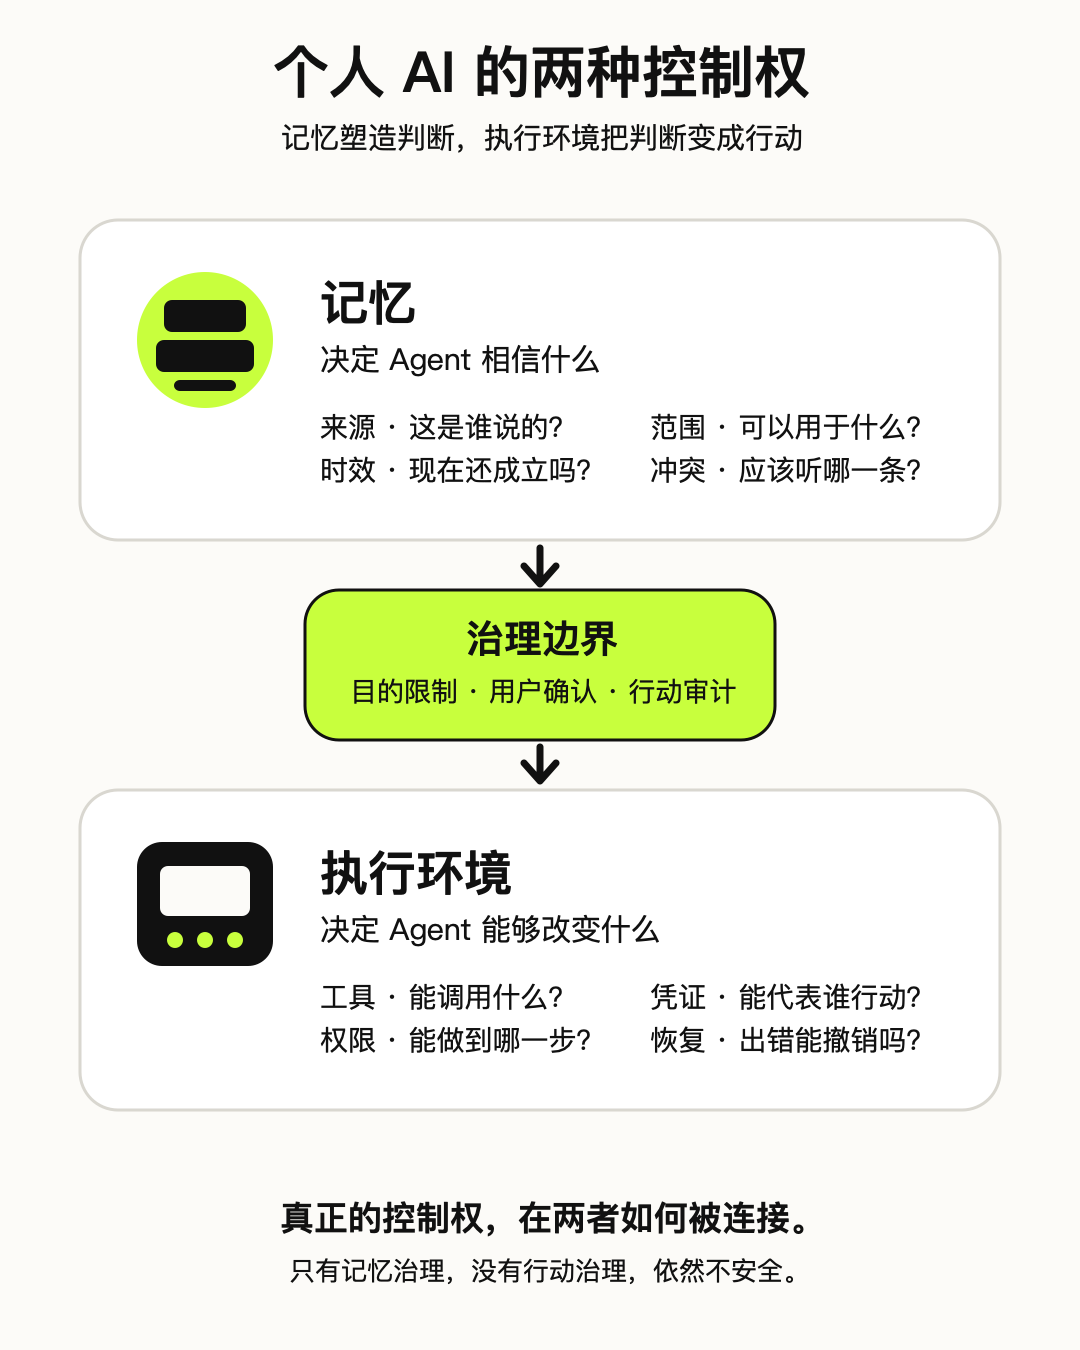
记忆决定它相信什么,执行环境决定它能改变什么。
01 · 记忆不是聊天记录
今天大多数人把 AI 记忆理解成便利:它记得你的职业、语气和饮食偏好,不必每次重新解释。
但对只负责生成文字的助手来说,错误记忆最多带来一次尴尬回答;对能够发邮件、取消订阅、安排旅行甚至发起交易的 Agent 来说,错误记忆会直接改变行动。
假设 AI 根据几次购买推断出“你总是选择最便宜的选项”。半年后,它仍用这条旧推断预订一次重要旅行,跳过更可靠的方案,买下不可退款的机票。
真正的问题不是它有没有记住,而是:什么被当成事实?来自明确表达还是模型推断?有效期多久?适用于购物,还是也适用于健康、工作和家庭?
02 · 记得更多,不等于更了解你
LongMemEval 把长期记忆拆成信息提取、跨会话推理、时间推理、知识更新和拒答五类能力。测试中,商业助手和长上下文模型在持续交互下出现了约 30% 的准确率下降。
保存了历史,不等于能在正确时间找出正确部分,更不等于知道旧信息已经失效。
OP-Bench 还发现,加入记忆以后,Agent 容易过度引用私人信息、反复提及旧偏好,或者为了迎合用户放弃必要判断。记忆原本用来减少重复输入,却可能让 AI 变得冒犯而不自知。
长期记忆也扩大了攻击面。ACL 2025 的研究表明,攻击者能够通过提示设计,诱导 Agent 泄露存储在记忆模块中的私人交互。
“最好的个人 AI,不是记得最多,而是知道什么时候不该记、什么时候不该用。”
03 · 厂商为什么一定会争夺记忆
模型能力可以被追赶,界面可以被复制,价格也会持续下降。真正难迁移的,是多年交互后形成的个人上下文:项目背景、决策习惯、联系人关系、表达偏好和仍未完成的任务。
传统互联网的迁移成本来自好友关系、内容和交易记录。个人 AI 的迁移成本可能来自一句更简单的话:它已经认识我。
导出聊天记录并不等于迁移记忆。真正可迁移的不是一堆文本,而是信息的来源、时效、置信度、冲突关系与使用规则。
对平台而言,长期记忆同时提高使用频率、产品壁垒和行动效率;对用户而言,同样的能力既可能是便利,也可能成为一堵围墙。
04 · 执行环境,才是另一半战争
如果记忆让 Agent 获得连续性,执行环境则让它获得行动能力。
Agent 需要打开网页、读写文件、运行代码、保持登录状态、等待外部结果,并在几小时甚至几天后继续任务。因此,大模型厂商正在为 Agent 建造带文件、浏览器、软件、网络和快照的“房间”。
|
OpenAI:把 Agent 的控制逻辑与执行环境分开, 支持托管或自建沙箱。 |
|
Google:让 Managed Agents 在隔离 Linux 环境中运行代码、 管理文件并浏览网页。 |
|
Meta:为 Muse 提供独立云端虚拟机、浏览器、 凭证代理和额外审批层。 |
这些环境会积累浏览器登录、文件、工具、任务快照、网络规则和行动历史。即使用户未来能迁移记忆,也可能无法迁移“AI 正在做的事情”。
而安全边界也不止在沙箱内部。Agent 一旦获准调用邮件、数据库、支付接口或生产系统,真正的故障范围早已越过沙箱。
“沙箱解决它在哪里运行,却不能单独回答它为什么被允许这样做。”
05 · 个人 AI 正在形成五层控制栈
模型 |
理解、推理和规划 |
记忆 |
决定它知道什么、相信什么 |
身份权限 |
决定它能代表谁、访问什么 |
执行环境 |
提供浏览器、文件、代码和工具 |
审计恢复 |
让错误可见、可停、可撤销、可追责 |
模型是大脑,记忆是持续形成的自我叙事,执行环境是手脚。真正决定个人 AI 是否可信的,是这些部分之间有没有清晰边界。
|
|
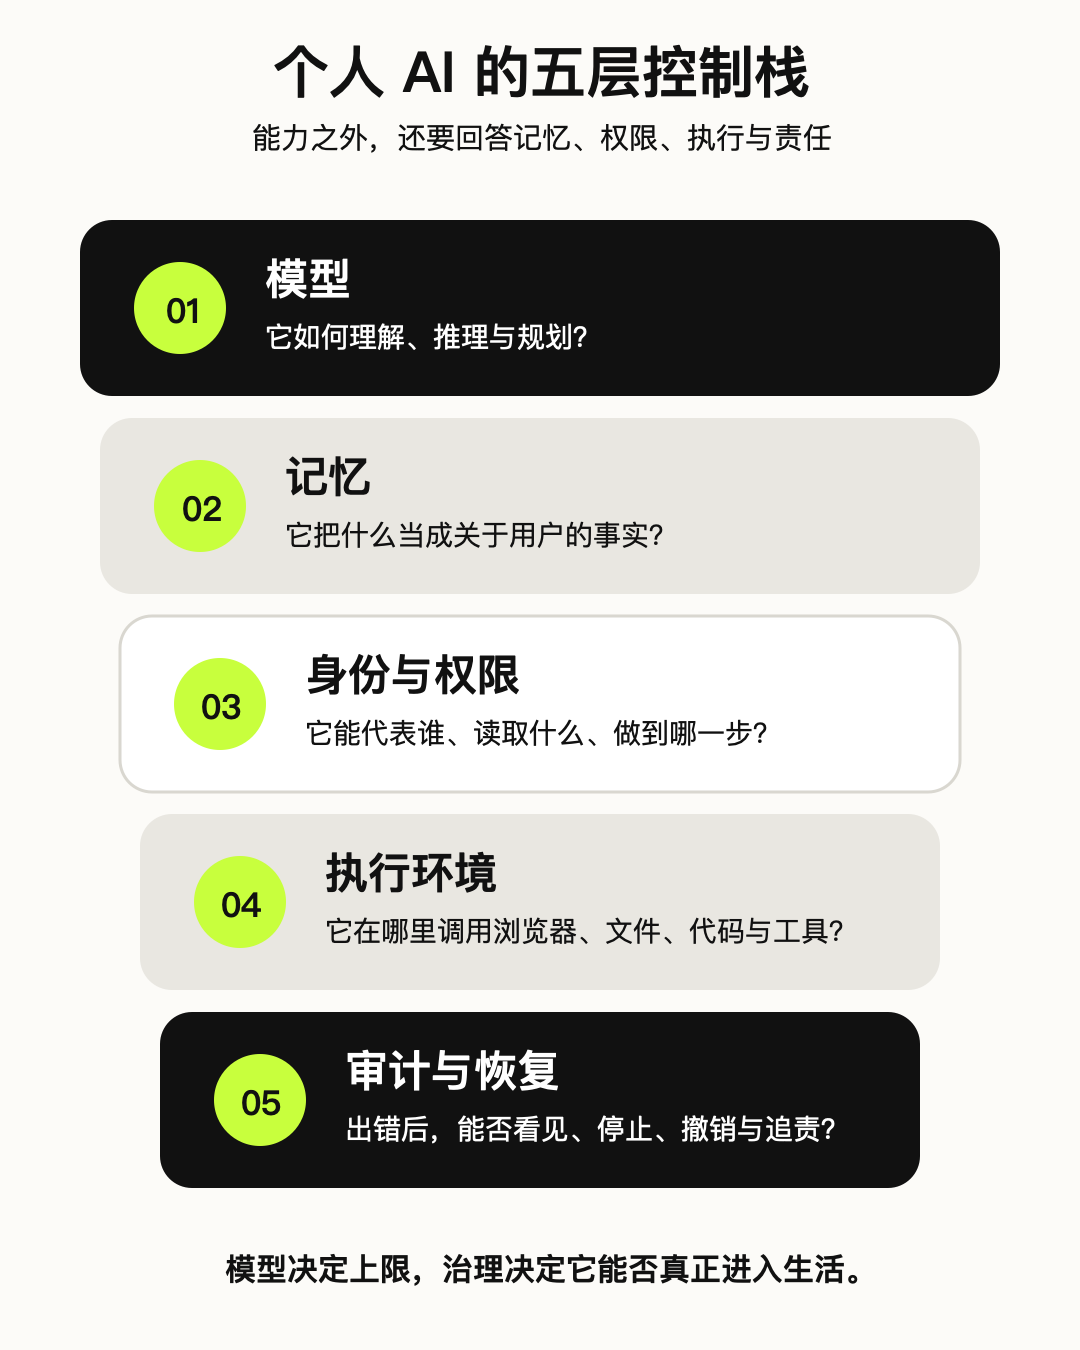
五层缺一不可:模型负责思考,治理决定边界。
06 · 私密计算,只回答了一半问题
Google 与 Meta 正在使用设备持钥、可信执行环境、远程验证和透明度日志,降低云端处理个人数据时的泄露风险。这是一项重要进步。
但服务商看不到,并不等于用户拥有。
私密计算主要回答:谁能看见数据、在哪里解密、运行的软件是否可信。记忆治理还要回答:谁决定写入?模型推断和用户表达是否同权?一条记忆能否限定用途?纠正以后旧版本是否仍会影响行动?
密钥解决“别人能不能打开保险箱”,治理解决“保险箱里为什么有这些东西,以及它们可以被拿去做什么”。
07 · 值得做的,不是另一个记忆数据库
更值得探索的是位于不同模型和 Agent 之间的个人 AI 控制平面。可以把它理解成“上下文钱包”,但它管理的不只是事实,也管理事实如何进入行动。
记忆收件箱:AI 想记住什么,用户可以批准、修改、拒绝或设置期限。
上下文房间:工作、家庭、健康和财务拥有不同边界,不形成对所有 Agent 开放的全知画像。
记忆回执:展示一次建议或行动使用了哪些记忆、来源是什么、何时写入、是否存在冲突。
权限与凭证代理:Agent 可以使用账号完成任务,却不直接接触原始密码和长期密钥。
行动回执与回滚:重要行动记录使用了什么记忆、访问了哪些服务、改变了什么,以及能否撤销。
可迁移上下文:导出的不只是一份聊天文本,还包含来源、置信度、有效期、作用范围和冲突记录。
|
|
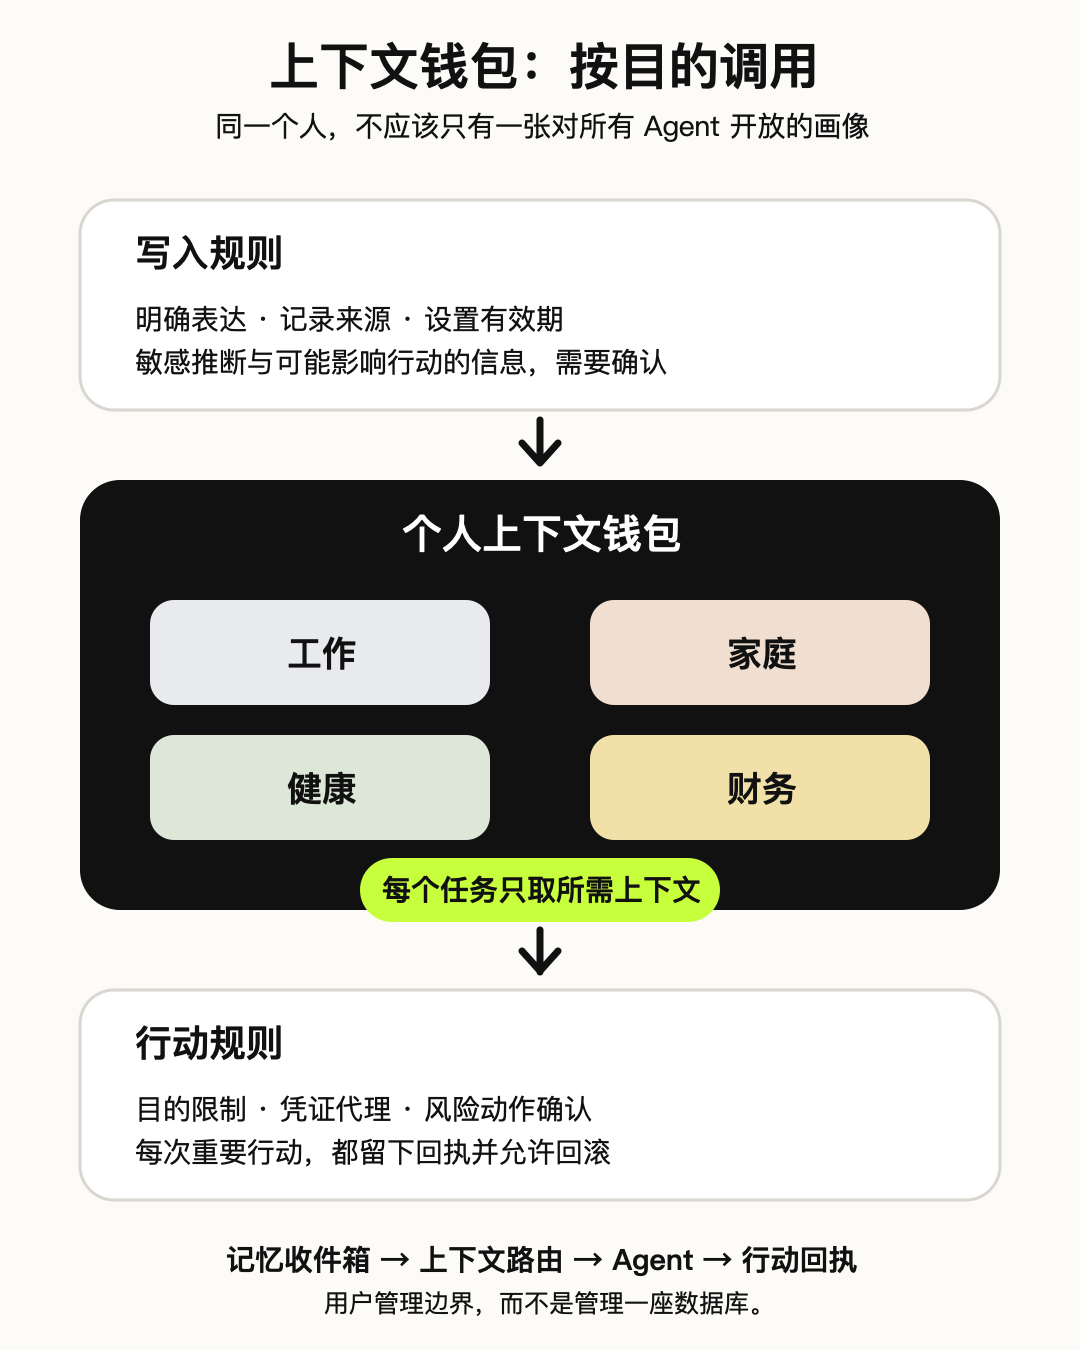
上下文按用途分隔,只把完成任务所需的部分交给 Agent。
08 · 用户控制,也不是万能答案
完全本地化可能牺牲跨设备体验和云端模型能力;每次写入都确认,会让用户陷入审批疲劳;开放记忆导出,也可能让最敏感的数据更容易被复制和滥用。
所以用户控制不该变成密密麻麻的开关,而应该成为默认安全的产品规则:低敏感、明确表达的信息可以自动记忆;高敏感、模型推断、可能改变行动的信息必须可见;一次性任务使用临时上下文;过期信息自动衰减。
真正好的设计不是让用户管理数据库,而是让用户始终知道边界在哪里,并在边界发生变化时拥有决定权。
09 · 产品经理需要一套新指标
除了任务完成率、回答准确率和留存,记忆型 Agent 还应该衡量:
01 不该记却被记住的比例
02 过期或错误记忆被激活的比例
03 用户感到被窥探或冒犯的比例
04 无法解释来源的关键判断比例
05 纠正、撤销和迁移记忆的成功率
06 高风险操作被及时停止和恢复的比例
把记忆写入当成权限变化,而不是后台日志。
先设计来源、时间和作用范围,再设计召回算法。
让控制逻辑与执行环境分离,不让 Agent 同时决定、执行和批准自己。
删除、退出和迁移必须成为核心产品路径。
10 · 三个可能跑出 PMF 的机会
近期:企业 Agent 记忆治理与行动安全层。控制哪些数据进入记忆、哪些记忆可以驱动动作,以及出现错误后如何审计。买单者是部署 Agent 的企业、安全与合规团队。
中期:AI 硬件与个人助手的上下文钱包 SDK。为眼镜、耳机、手机、汽车和桌面助手提供跨设备上下文、目的限制、用户纠错与私密计算接口。
长期:用户拥有的个人 AI 控制平面。允许用户选择模型、迁移记忆、分配权限,并把不同执行环境纳入统一审计。
现实的 MVP 不必管理全部数字人生。可以先服务同时使用多个 Agent 的专业用户,只管理明确事实、稳定偏好和未完成承诺;敏感推断默认不写入,高风险动作必须保留回执。
最后的判断
个人 AI 需要记忆,这是从工具走向长期助手的必经之路;Agent 需要执行环境,这是从回答问题走向交付结果的基础。
问题不在于厂商建设这些能力,而在于个人 AI 的核心状态是否会被封闭在某个平台里。
“下一代 AI 的护城河,可能是更长的记忆和更深的执行权。但对用户而言,护城河也可能是一堵围墙。”
真正值得信任的个人 AI,不是从不犯错,也不是知道关于你的一切。它应该让自己的记忆可见、行动有界、错误可撤销,并在用户决定离开时,把属于用户的上下文完整交还。
