在很多人还在讨论 AI 会不会替代一些初级岗位的时候,更激进的变化已经开始发生了。AI正在参与制造另一个AI。
这两天我看了NaiveAI发布的一篇技术Blog,里面就比较系统地展示了他们用AI研发AI的流程。
从注意力架构的探索,到训练、推理和部署系统的优化,大量代码实现、实验运行、性能分析和结果验证,都由AI在研究员的指导下完成。
研究员主要负责三件事:确定方向,设定约束与评价标准,以及作出关键决策。
这个方向被称为AI4AI,也就是用AI构建AI。 而且,NaiveAI已经把它落成了一套真实运行的研发流程,也在朝递归式自我改进的方向探索。
研究员不再需要亲手完成每一次实现和测试,而是开始管理一套由AI深度参与的实验系统。
那么,当AI可以承担越来越多的研发和试错,人类在整个系统里应该负责什么?
1
先说一个很现实的问题:为什么AI研发需要AI参与?
今天的前沿模型,早就不是几个研究员提出一个新结构,然后把模型训练出来那么简单了。
模型架构、训练数据、算力调度、推理部署和性能评测会互相影响。一次看起来很小的改动,可能要经过多轮实验才能知道有没有效果。
更麻烦的是,局部更快,不代表整个系统更快。 比如一个GPU算子单独测试时节省了几微秒,放回完整模型之后,却可能因为增加了同步和通信,导致端到端性能下降。
这种问题没有办法只靠推理解决,必须真正修改代码、运行测试,再用结果验证之前的判断。
NaiveAI在优化NaiveRT推理系统时,就记录了一个很典型的过程。
研究员设定的目标,是提高N0.5在8张GPU上的单流解码速度,同时保证采样结果的逐位确定性。
接下来,AI参与了整网分析、候选方案实现、数值验证和多卡测试。整个过程一共记录了151轮优化实验,其中63轮被采纳,71轮没有通过验证或被回滚,另外17轮用于探索备选路线。
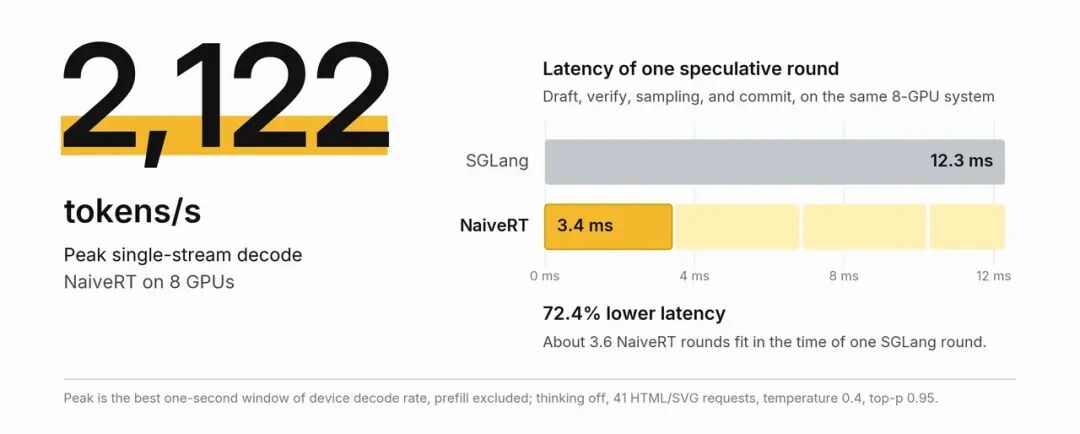
最终,NaiveRT在特定条件下做到了2,122 tokens/s的单流解码峰值。一轮完整投机解码的耗时,也从同一系统上SGLang的12.3毫秒降到了3.4毫秒。
所以说,AI做研发,并不是模型突然给出了一个完美答案。更接近现实的情况是,它可以不断提出方案,再用实验淘汰自己的错误判断。
研发本来就是用大量失败换少量有效结果。当失败实验也可以由AI持续完成,被降低的其实是试错本身的成本。
2
但AI只能优化自己熟悉的系统吗?
如果答案是肯定的,那它更像一个效率很高的自动化工程师,还谈不上参与研究。
NaiveAI还做了另一个实验。 一位研究员把构建世界模型的任务交给Naive-N0.5-Flash,只提供目标、算力预算和评测协议。之后的方案设计、模型训练、评测和结果分析,由N0.5持续推进,并根据实验结果决定下一步尝试。
世界模型并不是NaiveAI原本积累的主要研究方向。
N0.5最初从复现FlowWAM的公开方案开始,在常规方向提升有限之后,它开始调整研究路径:重写视频描述、扩充和筛选训练数据,并测试不同的帧采样与训练配比。
有些尝试确实有效,有些看起来搜索空间更大的方案,结果反而更差。
更值得注意的是,AutoWM后续的提升并不全来自训练。
N0.5发现WorldArena的部分指标不需要真实参考视频也能计算,于是开始利用这些信号选择输出,并调整后处理策略。
经过累计400小时的研究和15轮主要实验,AutoWM按照WorldArena-1 Track 1的公开协议测试,取得77.43分,高于当时榜单上已公开的最高成绩73.64分。
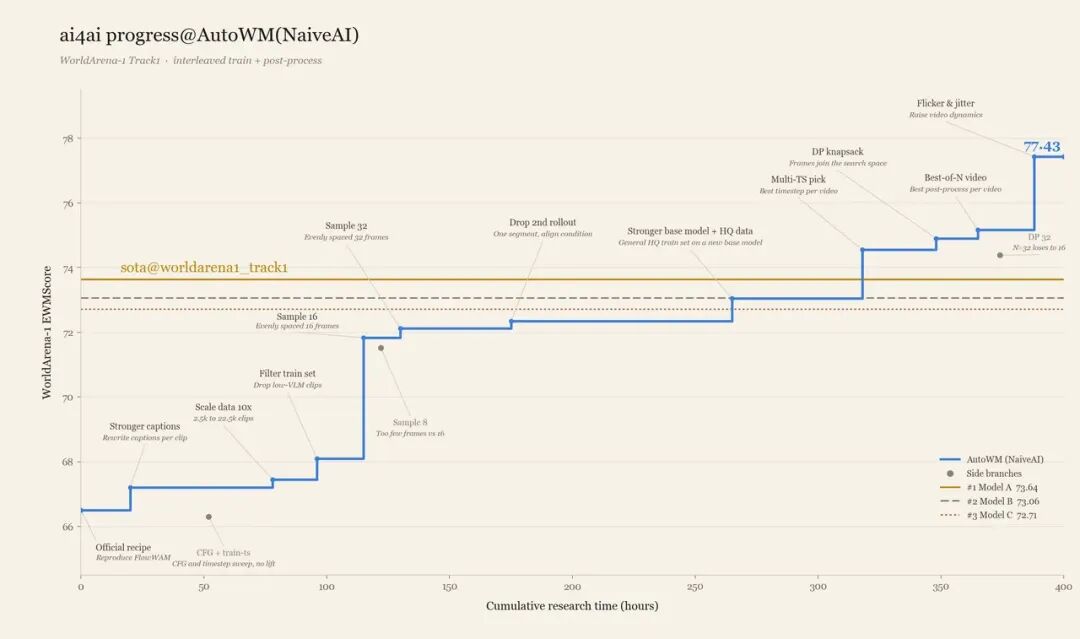
这个成绩说明,在目标和评价标准清晰的情况下,AI已经可以参与一段相对完整的研究过程。
但它也暴露了AI4AI一条很重要的边界。
AI很擅长优化一个明确的指标,可这个指标能不能代表我们真正想要的能力,仍然需要人来判断。如果评价体系设错了,执行能力越强的AI,只会越高效地把方向做偏。
3
Naive-N0.5-Flash本身,也在为这种长时间的研发任务做准备。
它以开源的MiMo-V2.5 base为起点,把原有的全局注意力层替换为DeepSeek稀疏注意力,并通过滑动窗口注意力与稀疏注意力的组合,降低百万token上下文中的计算和访存开销。
这里最关键的变化,是AI从完成一个步骤,开始参与一段持续反馈的流程。
过去,很多AI编程工具交付的是一段代码;现在,模型开始继续追问:代码运行了吗?性能提高了吗?新的修改有没有破坏原来的约束?下一轮应该试什么?
Naive-N0.5-Flash展示的,正是这种趋势的早期形态。
研究员提出问题、设置边界、建立评价体系,AI则把更多想法变成可以验证的实验结果。
而当执行和试错越来越便宜,真正稀缺的会变成好的问题,以及判断结果是否可信的能力。
