REVIEW · OPEN SOURCE
MIT
高德开源 SkillClaw:让 Agent 的技能自己进化
📖 阅读 6 分钟
🏷 分类 开源项目
🛠 工具 SkillClaw
// INTRO
你的 Agent 越用越乱,不是它笨,是没人帮它消化。高德技术团队开源了 SkillClaw——一个让 Agent 技能从真实交互中集体进化的系统。
本文导航
技能库为什么越用越乱
进化器本身就是一个 Agent
8 个用户跑 6 天的实测结果
01
用久了的 Agent,技能库就是一堆乱账
THE PROBLEM
先说个多数人没意识到的事实:Agent 真的会学习。碰到新场景,它会当场生成一个 Skill,下次再遇到就知道怎么处理。这是这几年 Agent 框架都在做的事——写入。
但写入之后呢?没人管了。
我翻了下自己攒的技能库:重复的、过时的、写一半的,堆在一起。像什么?像打游戏打完副本没整理的背包,极品装备和垃圾混在一起。模型越用越聪明,技能库却越用越乱——有用的信号,全被噪声淹没。
问题从来不是 Agent 学得不够多,而是没人帮它消化。
02
高德开源,上线当天冲上 HF 论文榜二
OPEN SOURCE
2026 年 4 月,高德技术团队开源了 SkillClaw,一句话讲清它干的事:让 Agent 的技能从真实交互中集体进化。
项目附带的论文发布在 arXiv(2604.08377),上线当天就冲上 HuggingFace Daily Papers 第二名。开源协议是 MIT,随便用。
它的核心承诺很直接:你像平常一样跟 Agent 聊天,技能进化在后台静默完成,零额外操作。
官方文档里有一句话我印象很深:SkillClaw doesn't make Hermes learn more — it makes everything Hermes has learned actually count. 翻译过来:不是让 Agent 学得更多,是让 Agent 已经学到的真正算数。
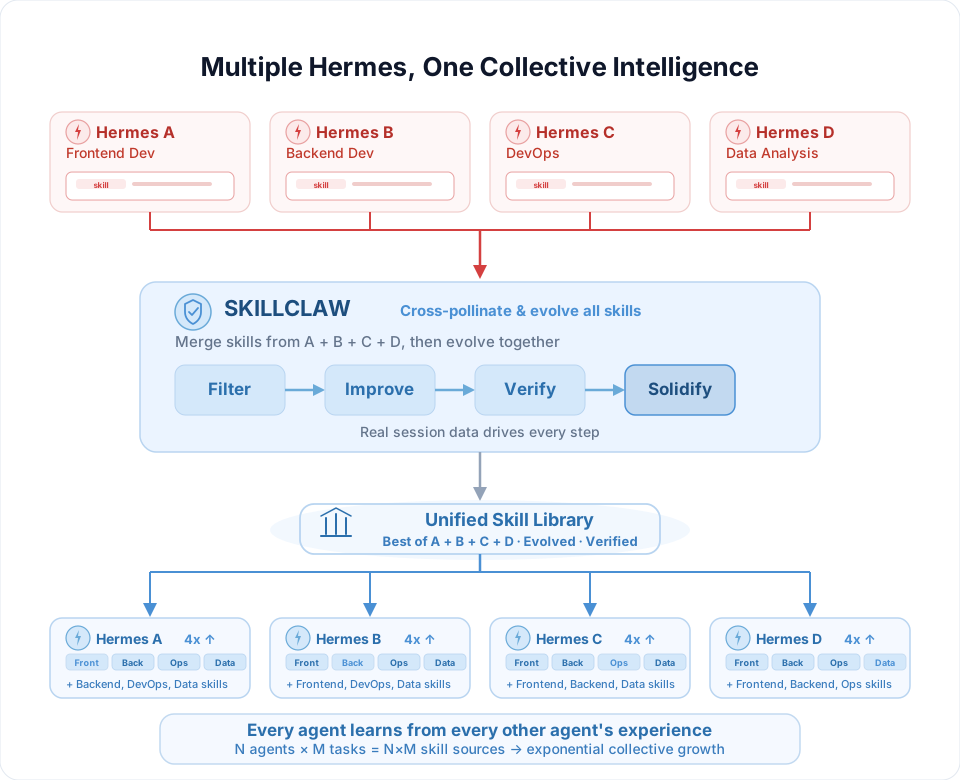
它怎么做到的?把散落在每个会话里的经验,压缩成可复用的技能,验证之后同步回所有实例。技能会跨会话、跨 Agent、跨设备、跨用户持续累积——项目管这叫经验复利。
对比传统静态技能,差距更明显:过去技能靠人工修改、发布新版本,用户之间完全隔离,长尾场景靠开发者穷举;SkillClaw 自动分析实战数据、自动更新,一人踩坑全员受益,用户用得越多覆盖越全。
03
进化器本身,就是一个 Agent
ARCHITECTURE
SkillClaw 分两个组件:
· Client Proxy:跑在你本地的 API 代理,拦截请求、录制会话轨迹、管理技能库。这是上手最小需要的东西
· Evolve Server:后台进化服务,从共享存储拉取会话数据,进化技能再写回。加不加它,决定你只有记录还是真正进化
两个组件只通过共享存储打交道(OSS、S3 或本地文件),互不直接通信,可以分开部署、独立升级。
关键设计在进化器。别的系统做技能整理,用的是规则——按相似度去重、按频率淘汰、按模板合并。确定性很强,但只能覆盖已预见的模式。
SkillClaw 的进化器(Agentic Evolver)本身就是一个 LLM Agent。它主动阅读所有实例聚合起来的会话证据,自主判断每个技能该怎么更新:理解失败根因、区分技能缺陷和环境因素、决定修改范围和方式。三种动作:
· Refine:精炼已有技能,同时保留成功案例里的不变量
· Create:为反复出现但没被覆盖的模式新建技能
· Skip:证据不足或问题不在技能层,跳过,等更多数据
它做的是编辑决策,不是模式匹配。这是 Agentic 的含义,也是它能从个体经验蒸馏出集体知识的根基。

04
只升不降,技能更新也走 CI/CD
VALIDATION
技能更新不会直接发布。SkillClaw 有个 validated 模式:候选更新先进验证队列,客户端空闲时拉取任务,让新旧版本在相同场景下对比跑,只有新版本确实更好才被接受。
这个思路很眼熟——就是 CI/CD。只有通过测试的改动才能合入主干。放到技能上,就是单调性保证:只升不降。
05
一个人踩坑,全团队受益
COLLECTIVE
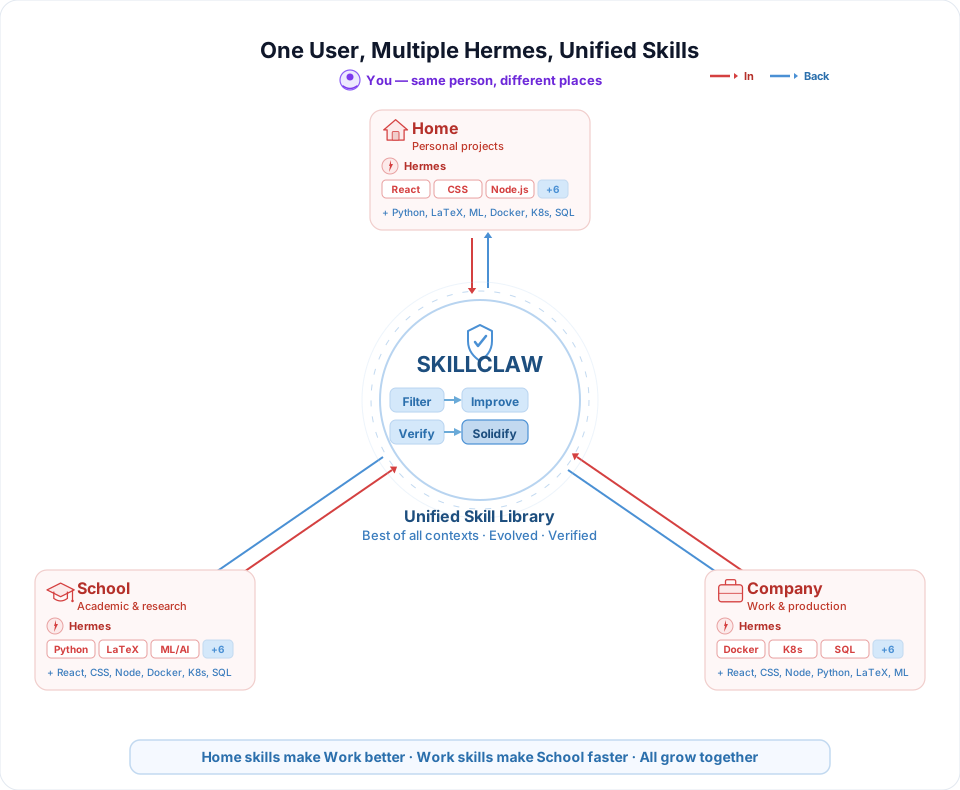
SkillClaw 真正的野心是集体进化,从个人到团队分四层:
· 单用户:自动去重、合并相似技能、淘汰质量差的,你的不同会话之间已经在交换经验
· 多 Agent:同一个项目起了 5 个 Worker,API Worker 发现的坑,Test Worker 不用再踩一遍
· 多设备:家里的学了 React,公司的学了 K8s,技能库统一——知识跟人走,不绑机器
· 多用户:A 调试数据库问题,沉淀成技能,B、C、D 直接受益
NOTE
个人踩坑 → 系统沉淀 → 所有人受益。
06
8 个用户跑 6 天,四类任务全部提升
BENCHMARK
团队在 WildClawBench(60 个真实世界 Agent 任务)上做了验证:模拟 8 个并发用户、6 天的昼夜循环,执行和进化都用 Qwen3-Max。
结果很直观,4 个评测类别全部持续提升:
评测类别
6 天提升幅度
社交互动
+11.72%
搜索检索
+52%
创意合成
+33.33%
安全对齐
+88.41%
但有个诚实的局限:工具使用类和 API 调用类提升明显,纯推理类提升有限——这类问题可能得靠模型本身优化,不是技能层能解决的。而且 8 用户 6 天仍是有限规模的测试,更大规模的验证是后续要做的事。
装它也不需要重构你的工作流,三条命令:
git clone https://github.com/AMAP-ML/SkillClaw.git
bash scripts/install_skillclaw.sh
skillclaw setup && skillclaw start --daemon
然后正常聊天就行。兼容 Hermes、Codex、Claude Code、OpenClaw、QwenPaw 等 10+ 个 Agent 框架,以及任何 OpenAI 兼容 API。
∞
群体智能,不需要共享大脑
TAKEAWAY
把眼光放远一点:Agent 正从单机智能走向团队协作,技能就是新的知识管理。过去知识沉淀在 Wiki、在文档里,未来大概率沉淀在 SKILL.md 里。所有 Agent 框架都在做写入,没人做消化——这个空白,正是 SkillClaw 这类工具瞄准的位置。
SkillClaw 想回答的问题很简单:Agent 能不能有群体智能?
它的答案很有意思——群体智能不需要所有 Agent 共享同一个大脑。让它们各自独立工作,只在 Memory 层面做智能的汇聚和压缩,已经足以让整个集体越用越聪明。
技能只是容器,关键在更新过程本身有没有智能。这一点,对正在搭 Agent 团队的人来说,值得抄作业。
你家的 Agent 技能库乱不乱?评论区聊聊。
• • •
✓ KEY TAKEAWAYS
要点一:Agent 不缺学习能力,缺的是对技能库的消化机制。
要点二:进化器本身是 LLM Agent,做编辑决策而非模式匹配。
要点三:技能更新走验证队列,只升不降,一人踩坑全员受益。