——写给业务负责人的「模型编排」科普
一、从一个常见误解开始
很多企业引入 AI 的第一步,是选一个「最好的模型」。
招标、评测、打分,最后锁定一家供应商,接入,上线。之后的想象是:模型越来越强,业务自然越来越好。
但过去两年,一个反直觉的事实正在企业实践中浮现:真正把 AI 用得深的组织,往往同时运行着不止一个模型。 有商业大模型,有开源模型,有自己微调的小模型,甚至有按合规要求必须留在私有环境里的模型。
问题随之而来:这么多模型,谁该干什么活?
这个问题的答案,就是今天想科普的概念——模型编排(Model Orchestration)。而在讲它之前,还得先补一堂更基础的课:为什么 AI 回答「开放问题」和「封闭问题」,是两种完全不同的能力。
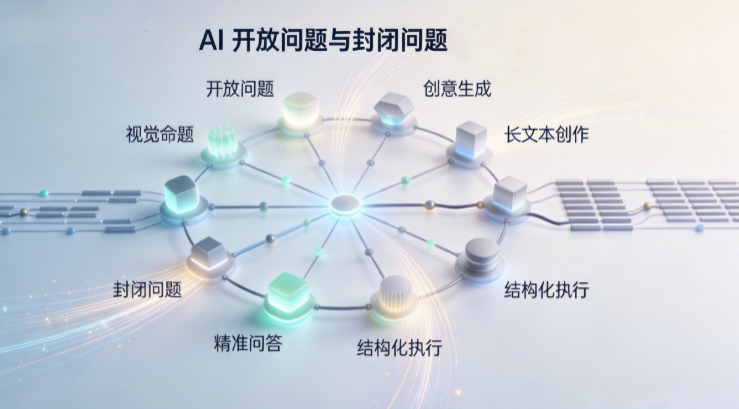
二、概念课一:收敛式回答,与发散式推理
先做个区分。
封闭问题,有标准答案:翻译一段话、总结一份纪要、把表格换个格式。今天的大模型处理这类任务已经相当成熟——它们本质上是「合理的下一个词」预测器,天然倾向于快速收敛到一个答案。
开放问题,没有标准答案:这个新品该主打哪个人群?明年的预算该往哪个渠道倾斜?这类商业问题的共同点是——好答案不止一个,而且需要权衡目标、证据、约束与风险之后才能收敛。
把开放问题直接抛给大模型,你会得到一个「看起来很完整」的答案。但它通常只是众多可行路径中的一条,而且你不知道被跳过的其他路径里,有没有更好的。
这就是「发散推理」要解决的问题:先把问题拆成多条有实质差异的路径,分别论证,再比较、剪枝、收敛。 换句话说,不是让 AI 直接给答案,而是让它先把「想的过程」摊开给你看。
一个粗糙但好用的类比:普通大模型像一位答题速度飞快的考生,发散推理像一位先列提纲、画思维导图、写完三个方案再交一个的顾问。
三、概念课二:模型编排,AI 世界的「分诊台」
有了多个模型、又有了发散推理,接下来的问题是:谁来决定哪个任务用哪个模型?
手动指定显然撑不住规模。于是就有了模型编排——可以把它理解成三甲医院的分诊台:
• 看病情轻重(任务难度):开个证明走简易门诊,疑难杂症找专家会诊;
• 看检查类型(任务模态):文字、图像、视频,各科室各管一段;
• 看预算和时效(成本与时延):不着急的复诊排常规号,急诊加价走绿色通道;
• 看病人身份(数据边界):涉密病例必须在指定院区处理,不能出院。
对应到 AI:分诊台要理解每个业务任务的难度、模态、质量要求,再评估候选模型的成本、时延、部署条件和数据边界,最后决定——是调用一个模型,还是组合几个,或者中途切换。
关键在于,这件事的价值不在于「每次调用更多模型」,而在于「为每个任务找到足够且合适的能力」。用大炮打蚊子,贵且慢;用弹弓打坦克,省了钱但误事。
四、概念课三:算账方式变了——从单次调用,到任务级成本
企业用 AI 的账,很多人一开始都算错了。
常见的算法是比单价:这家模型每百万 Token 多少钱,那家多少钱,选便宜的。但真实的成本结构是这样的:一次业务任务可能触发多次模型调用,中间还有失败重试、模型错配(用错了模型导致返工)、等待时延。
单次调用最便宜,整体任务可能最贵。 就像打车:单程价最低的车,如果绕路、取消、重新叫三次,全天的出行成本反而最高。
所以成熟的做法是「任务级成本运营」:把一次业务任务里的所有调用关联起来,按模型、按应用、按团队去看总量——总 Token、总成本、时延、重试次数、错配率——再结合集中采购和预算策略优化整体投入。
一句话总结:看总价,别只看单价。
五、概念课四:效果变差了,先别急着怪模型
另一个高频场景:上线时效果很好,两个月后悄悄变差。这时团队的第一反应往往是「模型不行了」。
但归因其实有四个可能:模型变了(版本升级导致行为漂移)、输入变了(业务数据分布变了)、路由变了(任务被分给了不合适的模型)、工具变了(模型调用的外部工具出了问题)。
不把这四层拆开,排障就像雾里开车。这也是模型编排平台强调「可观测」的原因:在相同任务条件下比较模型与路由路径,把质量变化归因到具体层面。顺带一提,模型版本升级带来的行为漂移,与之前我们聊过的「Harness 保质期」问题是同源现象——护栏需要随模型与业务变化持续维护,感兴趣可以回看那篇。
六、还有一层:模型也需要「管理」
上面讲的都是效率。但企业环境里还有一层容易被忽略的东西——治理。
想想这些问题:谁能用哪些模型?敏感数据能不能送到外部商业模型?不同团队各自的预算上限是多少?谁在什么时候用哪个模型做了什么决策——出了事能不能查到记录?
这些问题的答案,对应着模型目录管理、使用权限、数据边界、预算策略、版本与审计记录。在国内,这还叠加了一层监管现实:生成式大模型需要完成相应备案。对采购方而言,供应商是否完成备案、备案覆盖到哪个产品层级,都是值得写进尽调清单的问题。
七、行业里,已经有人把它做成了产品
概念讲完,回到现实:这些能力要进企业,总得有人把它工程化。这个方向上,国内已有厂商做出成型产品——以特赞(Tezign)的 Model Hub 为例,它把上述概念打包成了「发散推理 + 多模型编排」两项核心能力:
• 发散推理模型:输入开放商业问题与约束,输出多条候选路径、比较依据和收敛建议——也就是第二节讲的「先把想的过程摊开」;
• 模型编排:按任务的难度、模态、质量要求,动态选择、组合、切换模型——第三节的「分诊台」;
• Creative Trajectory:不只保留最终答案,还保留任务定义、路径探索、剪枝理由与人工决定,形成可回溯的「判断工件」;
• 企业级运营:统一接入自研、商业、开源、企业自有与私有化五类模型,配套质量归因、任务级成本与权限治理,其发散推理模型已完成大模型备案。
它的一个设计细节值得留意:人机边界被明确写进产品逻辑——平台负责组织探索、调用、评价与记录,人决定什么值得优化、何时收敛,并对高影响决策负责。这对担心「AI 替人拍板」的组织,算是一个务实的答案。
背景层面,Model Hub 可独立采购部署,同时也是特赞企业级智能体系统 GEA 的模型能力基础(GEA 已部署于全球 180 余家企业客户)。当然,产品页未公布具体性能数据,实际效果仍需按项目验证——第八节会讲怎么验。
八、自测清单:你的组织需要模型编排吗?
不是所有人都需要。可以用两个维度自测。
适合的信号:
• 你的核心问题多是开放性的(策略、洞察、创新方向),而非规则明确流程固定的执行;
• 你已经在为多个模型的调用、账号、账单疲于奔命;
• 你说不清一次业务任务的真实成本与质量归因。
不需要的信号:
• 任务边界清楚,单一模型已稳定满足质量与成本要求;
• 只需要简单的 API 转发与鉴权——加一层编排反而增加复杂度。
最后一个提醒,也是最容易被营销话术绕晕的地方——怎么验证这类平台真的有效? 别看它接了多少个模型、生成了多少候选方案、省了多少 Token。先固定任务、设定质量门槛和对照基线,然后比较:任务通过率、总成本、时延、失败恢复,以及后续的真实业务结果。
接入的模型数量不是能力,把任务做对才是。
九、结语
回顾一下这堂课的四个概念:发散推理让开放问题被完整展开,模型编排让每个任务用上合适的模型,任务级成本让账算得清,质量归因让问题查得准。它们共同指向一件事:企业 AI 正在从「买一个聪明的模型」,变成「建一套会调度的能力」。
就像没有哪家医院会因为雇了一位名医就取消分诊台——名医越多,分诊台越重要。模型时代,同理。
