Prompt缓存:文档写了什么
本文系统梳理 Anthropic Prompt Caching 的核心机制与生产陷阱:前缀哈希依赖严格顺序、write/read 成本差达12.5倍、1024–4096 token 缓存下限、lookback window 仅20块、breakpoint 位置与 TTL 顺序约束。强调缓存与 token budgeting 需实时查文档,而非依赖认证考试或静态记忆。
到底什么会被缓存,什么不会
Prompt caching 作用的是前缀(prefix),不是请求里随便一段区间。缓存引用的是请求中直到指定 breakpoint 为止的全部内容,而且顺序是固定的:先是 tools,然后是 system prompt,最后是 messages。这个顺序不是摆设。如果两个本来完全相同的请求之间,你的 tool 定义变了,那么排在它后面的 system prompt 和 message 历史也都没法从缓存里取了,因为 prefix 的哈希已经对不上了。Anthropic 自己的失效表把这点写得很明确:tool 定义的改动会同时让 tools、system 和 messages 一起失效,而像切换 web search 这种更小范围的改动,只会让 tools 块失效。
标记 cache breakpoint 有两种方式:一个顶层 cache_control 字段用于自动缓存,或者在各个内容块上显式写 cache_control 来做更细的控制。大多数团队都是先在多轮对话上开自动缓存,等到 prompt 里出现了变化频率明显不同的区块——比如静态的 system prompt 和不断变长的 tool 结果历史——才去做显式 breakpoint。
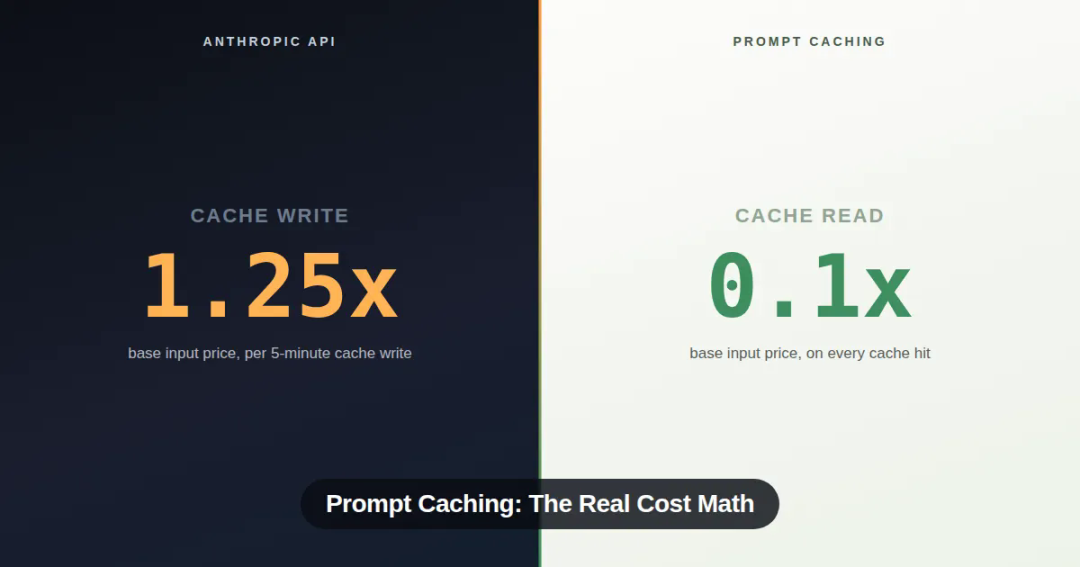
乘数:write 的成本对比 read 的成本
这就是那些和认证沾边的讨论最容易含糊、而真实定价页一点也不含糊的地方。5 分钟的 cache write,成本是基础输入价的 1.25 倍。1 小时的 cache write,成本是基础输入价的 2 倍。而 cache read,不管这个缓存当初是用哪个 TTL 写进去的,在当前大多数模型上都是基础输入价的 0.1 倍[1][2]。在 Claude Sonnet 5 上,2 美元的基础输入价会变成 2.50 美元的 write 和 0.20 美元的 read[2]。在 Haiku 4.5 上,1 美元的基础输入则对应 1.25 美元的 write 和 0.10 美元的 read[2]。
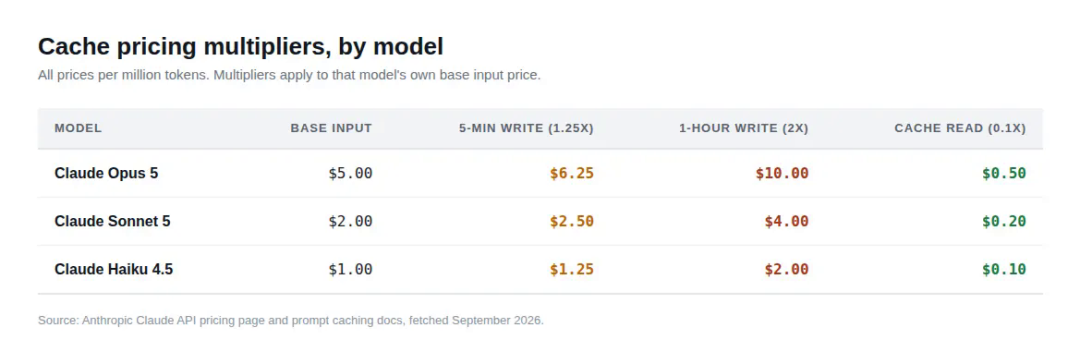
这笔账只有在复用的情况下才划算。一次写完却从来没被读过的缓存,比压根不缓存还贵,因为你白付了那 1.25 倍或 2 倍的溢价。盈亏平衡点取决于你预计在 TTL 窗口内会重读这个前缀多少次,这也正是 1 小时选项存在的原因:对于 agentic 任务或者节奏很慢的对话,5 分钟窗口会在两次读取之间就过期,这时候 write 付双倍仍然比每次重读都吃满输入价便宜。
那个没人检查、直到缓存悄悄失效才知道的 token 下限
存在一个下限。Claude Sonnet 5 和 Claude Opus 4.8 要求可缓存块里至少有 1,024 个 tokens 才会真正触发缓存;Claude Haiku 4.5 则要求 4,096 个。如果你的 prompt 短于这个下限,cache_control 不会报错。它只是安安静静什么都不做,而你还继续按全价付输入费用,心里却以为自己在打折。唯一能发现这件事的办法,就是自己去检查响应对象里的 cache_creation_input_tokens 和 cache_read_input_tokens。这种细节,在教程里很容易跳过,在生产环境里跳过的代价却很高,因为一段简短、静态的 system prompt,恰恰是团队最容易默认它是个安全缓存目标的东西。
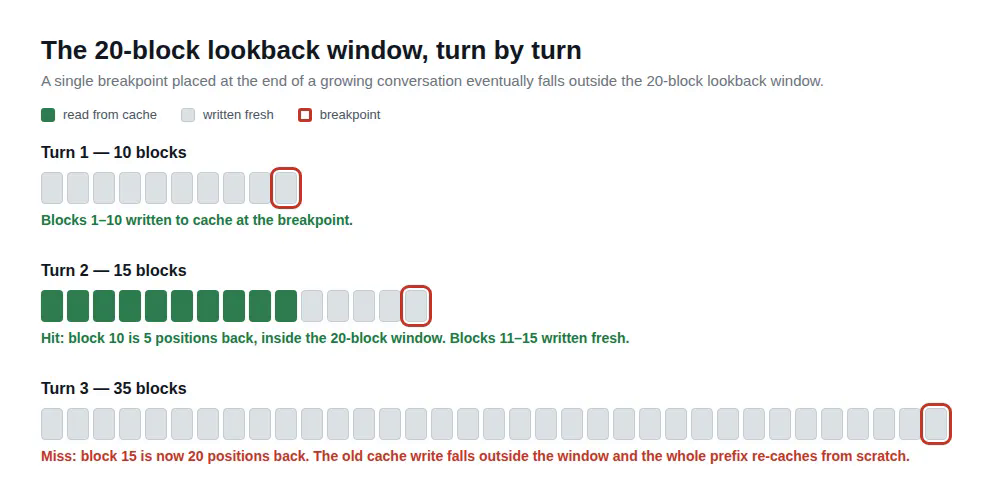
lookback window 也有类似的锋利边缘。系统在每个 breakpoint 上向后回溯找上一次 cache write 时,最多只检查 20 个块位置。在一段不断增长的对话里只在末尾放一个 breakpoint,一旦对话超出你上一次 cache write 大约 20 个块,你就掉出了 lookback window,缓存会悄悄不再命中,你的节省直接归零,而且没有任何可见的报错。Anthropic 给出的解法是在长对话里布置多个 breakpoint,而不是只在尾部放一个,这也解释了为什么对于任何长时间运行的东西,光靠自动缓存并不算一套完整策略。
一个块换个顺序,整个缓存就凉了
缓存失效会沿着 tools → system → messages 这个层级向下级联,而 breakpoint 该放在哪里,规则比听起来要严格:把 cache_control 放在前缀在所有请求间逐字节相同的那最后一个块上,绝不要放在会变化的块上。一个时间戳、一个每请求都不同的 user ID,或者任何一小段动态内容,只要你把它放在 breakpoint 前面,哈希就永远匹配不上之前的写入,于是你又回到每个请求都付全价的境地,同时还以为自己开着缓存。
这里就牵扯到一个我以前写过的老问题:那些把长上下文检索跑通、以为可靠性问题已经解决的团队,会撞上同一类静默失效——和 context drift、以及 lost-in-the-middle 问题属于同一家族,只不过发生在成本层而不是准确率层。没有任何东西报错。系统只是悄悄不再做你当初搭它的那件事。
混用 TTL 还有一个在生产上撞到之前值得先知道的约束:同一个请求里,1 小时的缓存块必须出现在任何 5 分钟缓存块之前,绝不能放在后面。混合请求的计费按三个位置来算:缓存读取算到已有命中的最高点,从那一点到 1 小时 breakpoint 之间的新内容按 1 小时写入计费,更新的部分按 5 分钟写入计费[1]。对于"很少变化的超长 system prompt + 每轮都在变的 tool 结果历史"这种组合,它确实是个很好用的模式,但第一次上手也很容易把顺序搞反。
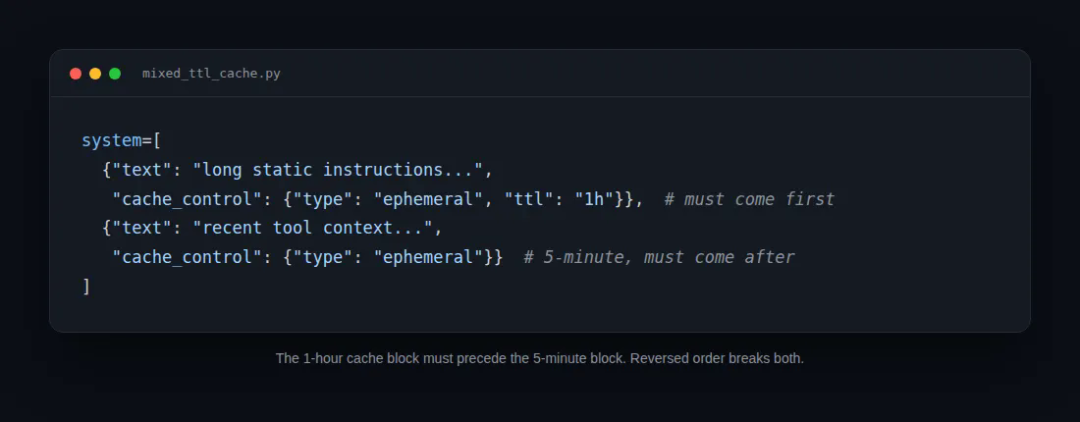
system=[
  {"text": "long static instructions...",
   "cache_control": {"type": "ephemeral", "ttl": "1h"}},
  {"text": "recent tool context...",
   "cache_control": {"type": "ephemeral"}}  # 5-minute, must come after
]
缓存之外的 token budgeting:context window、task budget,以及为什么备考会跳过这些
缓存只是其中一根杠杆。另一根是搞清楚到底什么才算占用你的 context window,而答案比大多数人以为的要宽:input、output 和 thinking tokens 全都算,三种缓存 token 也全都算——input_tokens、cache_read_input_tokens 和 cache_creation_input_tokens——每一项都会计入总量,尽管其中只有一部分会体现在表面价格上[3][4]。Anthropic 专门做了 token 计数端点,就是为了让你在发真实请求之前先查清楚,而且它跑在和实际 message 创建分开的速率限制上,所以查它并不消耗你的请求额度[3]。
当前一代模型还加了一层东西,只逛一眼定价页的话很容易漏掉:部分模型会自动获得 context awareness,API 会把一个实时的预算标记直接注入上下文,比如 <budget:token_budget>200000</budget:token_budget>,之后再来一条提示,显示已用和剩余的 tokens[4]。对于没有自动获得这一能力的模型,Anthropic 提供了一个显式的 beta 版 task-budget 功能,让你手动设置同类的上限[4]。这两者都不是缓存。它们都是"token budgeting"的另一半——而一个像本文这样的标题本来就会让人联想到这些——而且如果你只研究缓存价格表,它们一个都不会出现。
据我所知,这也合理地解释了为什么这件事没进我参加并写在《Back to Writing: My Claude Certification Week》里的那个认证轨道:实现层面的成本机制变得太快,是那种每出一档新模型考纲就得跟着改一遍的东西,而且恰恰是那种"每次现去文档里查比背下来更有用"的知识。我在比较 Opus、Sonnet 和 Haiku 成本时的思路也是同样的逻辑:框架是耐用的,具体乘数不是,而定价页更新的节奏没人能替备考的人控制。
如果说这里有什么实用结论,那就是:缓存和预算这两件事,都该在构建时对着实时文档去核实,而不是一次性背下来的事实。同样的纪律适用于任何你从 API 里想拿结构化保证的东西——这也正是为什么该去用 schema 强约束的 structured outputs,而不是指望一段 prompt 每次都表现得一模一样。
参考资料 平台:Medium / Level Up Coding 原文链接:https://levelup.gitconnected.com/prompt-caching-whats-documented-not-exam-tested-b5bc330002e2[1]
JOTO 企业落地观察
- 企业部署 prompt caching 时,必须将缓存前缀的哈希稳定性纳入工程设计闭环:tools、system、messages 的顺序与内容一致性不再是开发便利性问题,而是直接影响成本复用率的核心契约。任何动态字段(如时间戳、session ID)若误入 breakpoint 前置区域,将导致缓存完全失效且无报错,这要求团队在 prompt 工程阶段即建立严格的 token 流水线审计机制。
- 这类系统的取舍在于:是否为 long-running agent 对话启用多 breakpoint 策略。单 breakpoint 在对话超过 20 块后即退出 lookback window,而 Anthropic 明确建议在长对话中分散布置 breakpoint——这对企业智能体工程意味着需将缓存策略与对话状态机深度耦合,而非作为独立配置项处理。
- RAG 知识工程中常假设静态 system prompt 是天然缓存目标,但本文揭示其可能因低于 1024/4096 token 下限而静默失败。这意味着知识注入模块必须前置 token 计数校验,且不能仅依赖 prompt 文本长度估算,而需调用 Anthropic 的 token 计数端点实测——这对 RAG pipeline 的可靠性验证提出了新环节。
- AI 安全治理需关注缓存机制引入的隐性风险:缓存失效无日志、无错误码,仅表现为成本异常升高;而混用 TTL 时的顺序约束若违反,会导致计费逻辑偏离预期。企业需将缓存行为纳入可观测性体系,对 cache_creation_input_tokens 和 cache_read_input_tokens 字段做持续监控,而非仅依赖表面 API 成本报表。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们