GPT-6 Astra 最被低估的用法,居然在这里?
本文基于 OpenAI 官方文档,系统梳理 GPT-6 Astra 区别于前代模型的核心行为特征:规避 AI 味的禁用词与正面写作规范、长对话中稳定保持指令的高连贯性、对关键歧义主动提问而非默认猜测、编码任务中可显式控制测试粒度与子代理并行化、支持会话中途动态调整推理强度(configuration_update)及实时插入修正。所有建议均源自官方原文,无主观推演。
告别 AI 味
第一个,对于AI味儿的问题,官方原话是这么说的:Astra 有个毛病,会在不同的、互不相关的对话里重复相同的短语,还过度使用格式化。然后他们直接给了一份禁用词清单,让模型别再这么写。
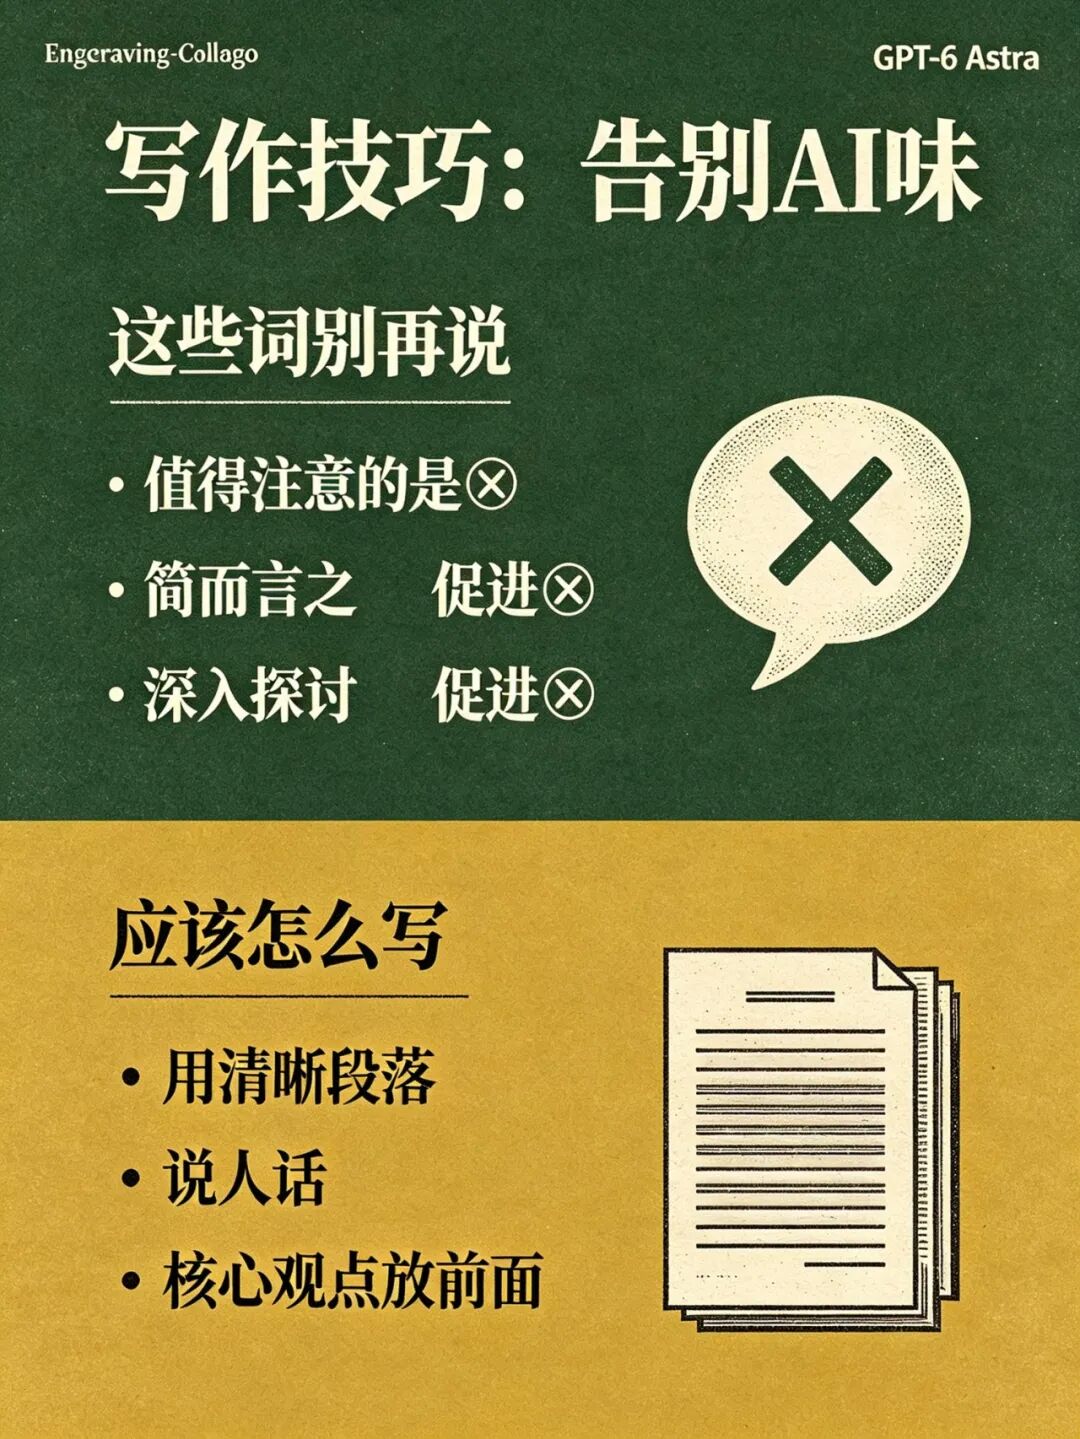
我把原文放这了,你直接复制进自定义指令就能用:
英文原文
Avoid using slop words or phrases like "Bottom Line:" in conclusions, "delve," "foster," "leverage," "it's worth noting," "importantly," "Question? Answer." or "This isn't about X. It's about Y.", "genuinely" or hyphenated compound descriptions and adjectives. Do not use concluding summary statements such as "In short:..", "The simplest mental model is:...". State the intended action directly. Avoid adding what you won't do, what will remain unchanged, or how you'll separate or categorize results. Do not use contrastive framing such as "X, not Y" or "X—not Y" that introduces an unprompted alternative that the user didn't ask about. Avoid invented compound labels like "exact-head checks" and "editorial-row layouts", vague qualifiers, and canned transitions; use plain verbs and prepositions to state the actual relationship directly.
中文翻译
避免使用"口水词"或短语,比如结论里的"Bottom Line:"(归根结底)、"delve"(深入探讨)、"foster"(促进)、"leverage"(利用)、"it's worth noting"(值得注意的是)、"importantly"(重要的是)、"Question? Answer."(问题?答案。)、"This isn't about X. It's about Y."(这不是关于 X,而是关于 Y)、"genuinely"(真正地),或者连字符连接的复合描述和形容词。不要使用总结性结尾陈述,比如"In short:"(简而言之)、"The simplest mental model is:"(最简单的心智模型是)。直接陈述你要采取的行动。避免添加你不会做什么、什么会保持不变,或者你将如何分离或分类结果。不要使用对比框架,比如"X, not Y"(X,而不是 Y)或"X—not Y"(X,而不是 Y),这会引入用户没有要求的、未经请求的替代选项。避免自造的复合标签,比如"exact-head checks"(精确头部检查)或"editorial-row layouts"(编辑行布局),避免模糊的限定词和陈词滥调的过渡;用平实的动词和介词直接陈述实际关系。
光有禁用清单还不够,得配正面规范。官方也给了:
英文原文
Default to using clear, concise paragraphs, each developing one main idea. Use lists only when the information is genuinely parallel, sequential, or easier to compare, and avoid nested lists unless the hierarchy cannot be expressed clearly in prose. Use plain, simple language: familiar words, concrete examples, and precise verbs. Prefer active voice and direct statements. Make sure to state the main point clearly and early, then develop it with the explanation and detail the reader needs. Let each sentence build on what came before. Develop the points that matter and provide enough support to be useful.
Use plain language over jargon, and reference technical details only to the degree that it helps illustrate an idea or your work to the user. Communicate complex concepts in a clear and cohesive manner, and calibrate your writing to the level of background knowledge assumed from the user's prompt and context.
中文翻译
默认使用清晰、简洁的段落,每段展开一个核心观点。只有当信息确实是并列的、顺序的,或者更容易比较的时候才使用列表,避免嵌套列表,除非层级关系无法用文字清晰表达。使用平实、简单的语言:熟悉的词汇、具体的例子、精准的动词。优先使用主动语态和直接陈述。确保把核心观点清楚地、尽早地说出来,然后用读者需要的解释和细节来展开。让每一句话都承接上一句。展开重要的观点,提供足够有用的支撑。
用平实的语言代替行话,技术细节只在有助于向用户说明一个观点或你的工作的程度上才引用。以清晰、连贯的方式传达复杂概念,并根据用户的提示和上下文所假设的背景知识水平来调整你的写作。
这两条要一起用,作为一个组合块放进自定义指令。负面清单禁止坏模式,正面规范建好模式,如果只用一半的话,效果会差很多。
我自己试了试,加了之后写出来的东西确实不一样了。至少不会再通篇都是"值得注意的是"。
对话:它比你想的聪明
加了这个清单之后,没过几轮Astra又开始飘了。一开始我以为是清单没用,后来翻到文档里另一段才明白:Astra 在长任务中保持连贯的能力,比 GPT-5.6 Sol 和更早的模型都更强。
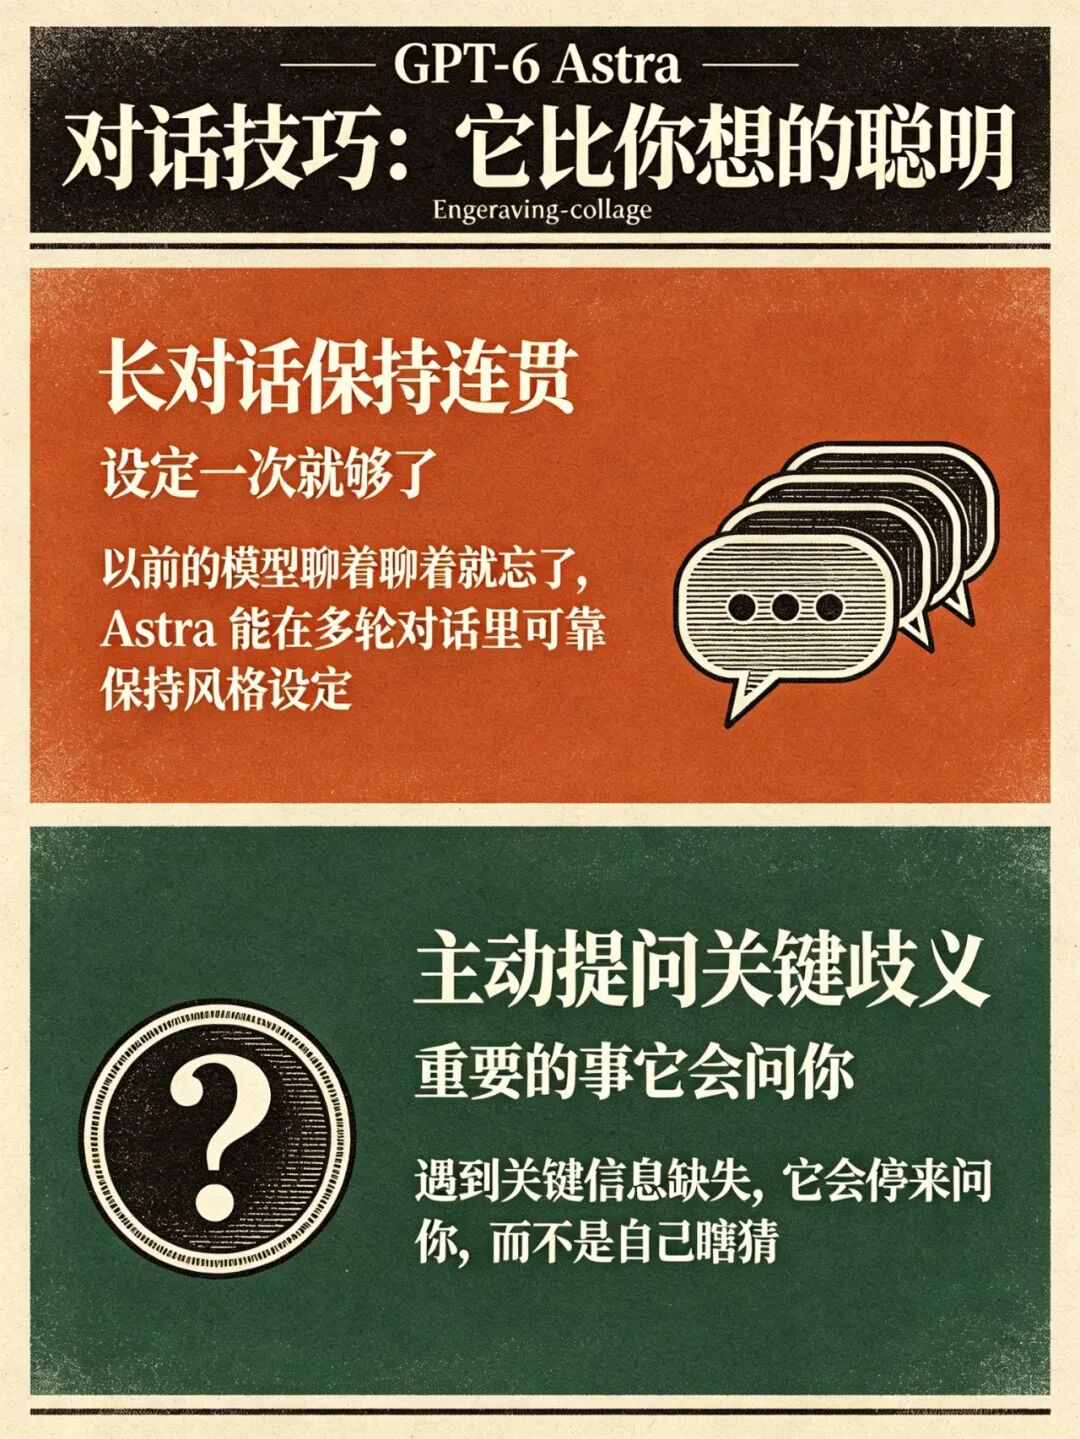
你在对话开头设定的一条风格规则、一个范围约束、一句语气指示,在以前的模型上可能聊着聊着就忘了,你得反复提醒。
Astra 不一样,你设定一次,它能在漫长的多轮对话里可靠地保持下去。
以前写长文,每写一节都要提醒一次"用口语化风格"、"不要用 AI 味词汇"这样的指令,现在开头说一次就够了。
但硬币的另一面是,如果你开头设定错了,这个错误也会持续累积放大,而不是像健忘的模型那样自然淡化。
我之前就是犯了这个错。我在对话开头只写了"用口语化风格",太模糊了,Astra 理解的"口语化"和我想要的根本不是一回事。然后它就一直按那个错误的理解写下去,越写越偏。
所以,用好 Astra 的第一步很简单,把开头的指令设对就行。想清楚再写,写完就别轻易改。
我自己的习惯是,做个技能把风格指令、角色设定、输出格式一次性写清楚,开新会话的第一条消息就让它读取该技能,了解必要要求,然后再开始干活。
开头的指令设对之后,我又遇到了另一个让我不爽的事。
比如,我让它写个功能,它问我"这个参数的默认值你想要多少"。我让它改个 bug,它问我"这个异常你希望怎么处理"。我当时心里很不爽,觉得它什么都问我,要它干嘛。
后来翻了官方文档才知道,这是 Astra 刻意设计的。
以前的模型遇到信息缺失,会按自己的假设继续推进,猜错了也不告诉你。但Astra 不一样,它觉得缺的信息可能显著改变结果时,会直接停下来问你。
其实在日常中,我们通常想要后者:它在关键歧义上停下来问你一句,而不是默默猜错然后基于错误假设建一整个任务。
举个例子。
比如,以前你可能写:"写一个限流功能,用滑动窗口,支持每秒 100 请求,超出返回 429,要有日志,要考虑并发安全,要支持配置化,要……"
现在,你可以直接写:"在这个文件描述的 API 端点上实现限流,用滑动窗口方案。"剩下的它会直接问你。
但这里还有个问题你需要知道…
Astra 只会问真正重要的歧义,不会问你每一个未说出口的偏好。
举个例子,"我希望代码用 TypeScript 而不是 JavaScript",这是你的偏好,它不会主动问,你得自己说。但类似"这个端点的限流阈值应该是多少?",这种的属于信息缺口,缺了它结果会完全不一样,它就会问。
但如果你实在嫌它问太多,官方文档里也给了一个让它更主动的提示词,我放这了,需要的拿去用:
英文原文
You should infer the user's intent and task scope from the instructions and prior conversation context. Your job is to bias towards action and carry the user's intended task to completion. When the user expresses intent to perform new work or fix an existing issue, persist until the user's intended goal is complete. Progress autonomously towards the user's goal (e.g. creating isolated worktrees / checkouts if needed, resolving merge conflicts, read-only actions, creating draft PRs etc.) unless they are clearly destructive or irreversible.
中文翻译
你应该从指令和之前的对话上下文中推断用户的意图和任务范围。你的工作是倾向于采取行动,并将用户预期的任务执行到底。当用户表达了执行新工作或修复现有问题的意图时,坚持下去直到用户的预期目标完成。自主地朝着用户的目标推进(例如,在需要时创建隔离的工作树/检出、解决合并冲突、执行只读操作、创建草稿 PR 等),除非这些操作明显是破坏性的或不可逆的。
编码:省时间的关键
沿着这个继续探索官方文档,开头那个改一行代码跑 20 分钟测试的问题也有答案了。
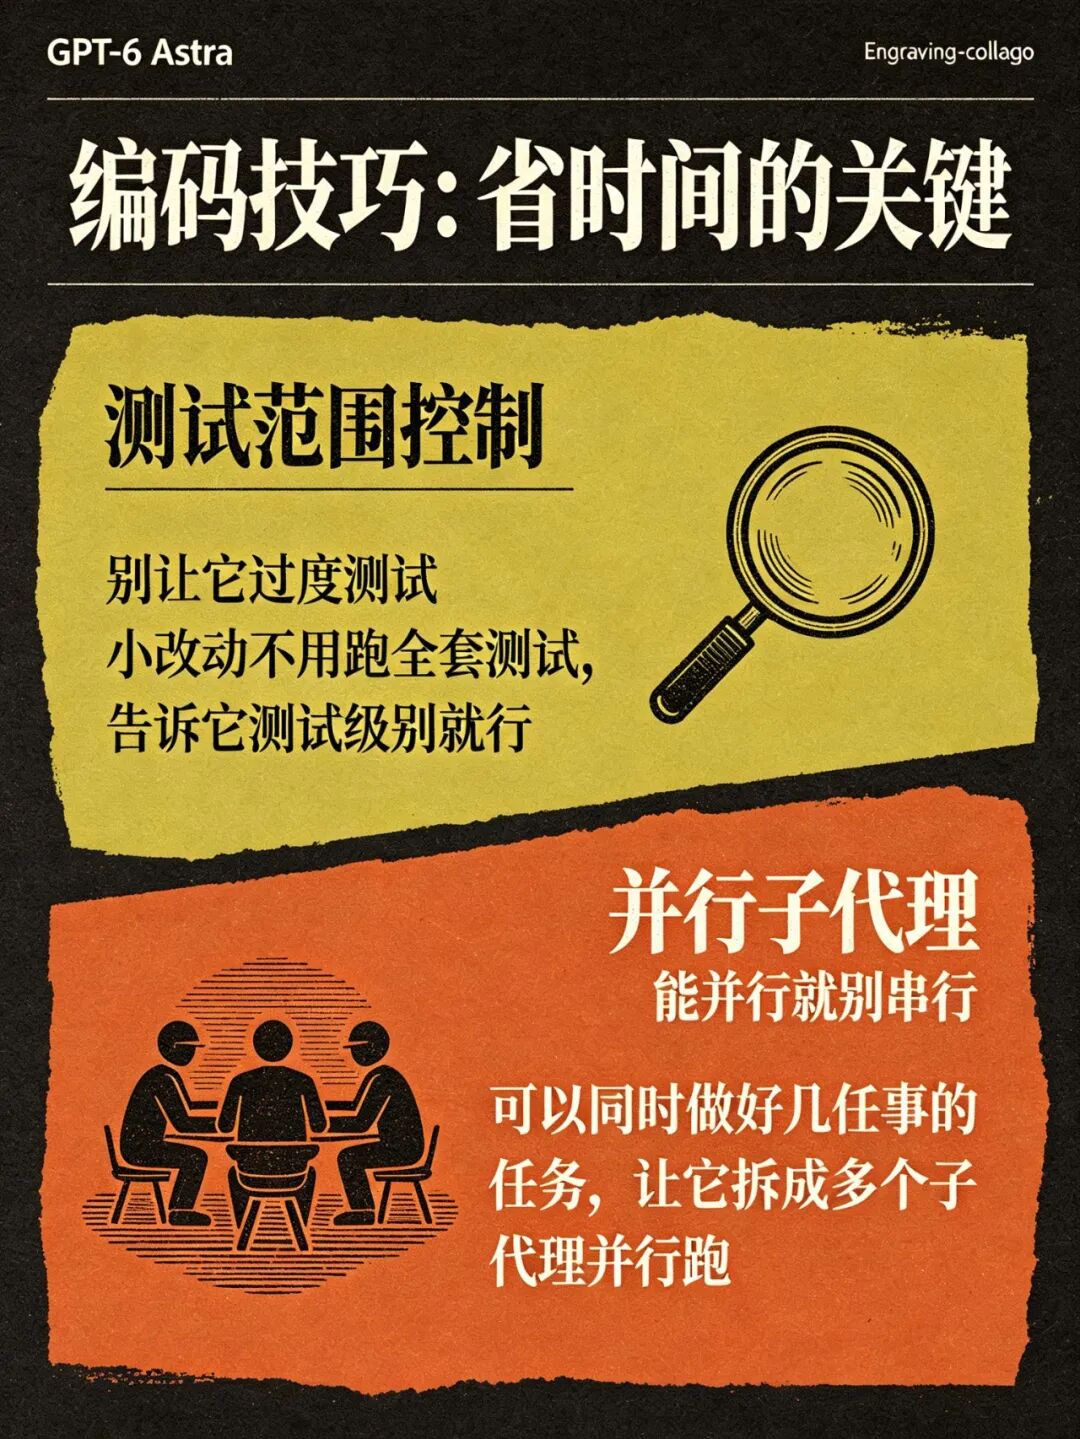
因为官方文档里专门说了这个:对于编码任务,模型倾向于在认为任务完成之前彻底测试。
大变更的时候,这是优点,够严谨。
小修改的时候就很烦了。
我当时就是改了个变量名,它觉得"任务完成之前要彻底测试",然后就给我跑了全套。
由此看出,它一点都不傻,反而太负责任了。
问题出在我身上,我压根没告诉它这个修改有多大影响。
既然如此,那么修复方法就很简单了:显式指定测试级别,不要每次都留给模型自己判断。
官方给的提示词:
英文原文
Do not write tests for reversible, low-impact changes that mirror the implementation. If you do choose to verify your work with tests, make sure that the tests are meaningful and necessary to verify implementation. Run tests appropriate to the change and complete required checks. Once those pass, broaden or repeat testing only when new changes, failures, or unresolved concerns justify it; otherwise, continue toward completing the task.
中文翻译
对于可逆的、低影响的变更,不要写和实现重复的测试。如果你确实选择用测试来验证你的工作,确保这些测试是有意义的、必要的,能够验证实现。运行与变更相称的测试,完成必要的检查。一旦通过了,只有当新的变更、失败或未解决的问题证明有必要时,才扩大或重复测试;否则,继续完成任务。
这一条,是我觉得整篇文档里杠杆率最高的指令之一,做编码工作的一定要加上。
我加了之后,改小修改的时候它果然不跑全套测试了,省了好多时间。
测试的问题解决之后,我慢慢发现 Astra 还有一个能力很多人都没用好:Astra 可以分解任务并把工作拆分给多个并行运行的子代理。
但官方文档里提到了一个注意事项:模型可能比你工作流所期望的更不频繁地进行委派。
说白了,本来可以同时做好几件事的任务,它默认可能只会一件一件做,不会主动帮你并行起来。
我自己试了几次,确实如此。有时候一个任务明显可以拆成几块并行做,但它就是按顺序一块一块来。
修复方法和测试范围一样,需要你明确说出来。
英文原文
If at any point you can parallelize work by delegating tasks to another agent (no matter if you are the root or subagent), you should do so using collaboration tools if it could save time or improve quality.
中文翻译
如果在任何时候你可以通过把任务委托给另一个代理来并行化工作(无论你是根代理还是子代理),只要这能节省时间或提高质量,你都应该使用协作工具来这样做。
这个适用场景包括:跨多个不相关来源的研究、几个不相关功能的实现、任何组件确实不需要实时看到彼此进度的事情。但本质上是顺序性的任务,不建议因为 subagent能力存在就强行并行化。
高级功能:很少有人知道
这些都是 Astra 跟以前模型不一样的地方, 但还有两个功能,我觉得特别实用,但你可能不太清楚。
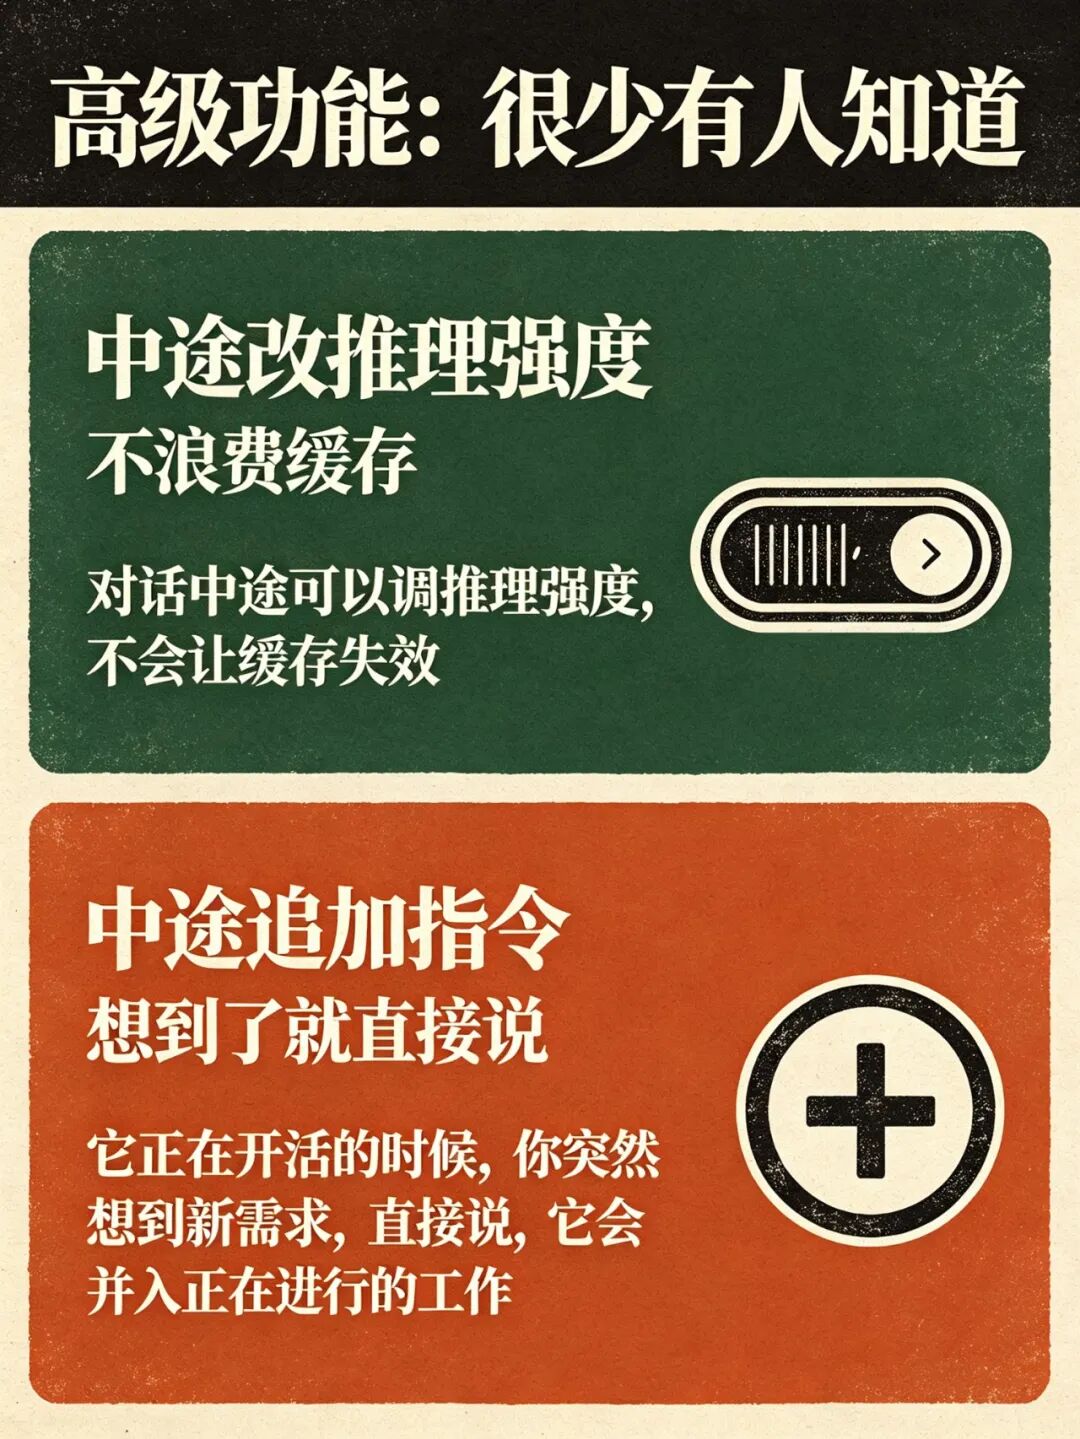
第一个:中途可以改推理强度,不浪费缓存。
在 Astra 之前,推理强度是请求级设置。你为一个难题调高,下一轮再调低,就会改变请求前缀并使整个对话的 prompt 缓存失效。
而Astra 引入了 configuration_update,可以从对话中的某个点开始改变推理强度,而不使缓存失效。
所以,后面你可以这样使用Astra 模型:
- 以默认推理强度开始一个会话做日常工作
- 中途遇到真正困难的问题,发
configuration_update调高推理强度 - 问题解决后再降回来
这跟强度分层的思路是一致的,只不过 Astra 让这种升级在会话中途变得实际可行,以前的模型做不到。不过要说明的是,这个功能似乎对开发者有效,但对普通用户的效果还有待观察。
第二个:中途发现遗漏了什么,直接说,不用等它写完。
很多人把这个功能只当"紧急刹车"用,但其实它应该是常规操作。
比如,它正在写代码,你突然想起来还要处理一个边界情况,直接发:"实际上,还要处理输入为空的边界情况。其他你已经开始的部分保持原计划。"
它会把这个修正并入正在进行的工作,而不需要等它写完再开一轮修正。
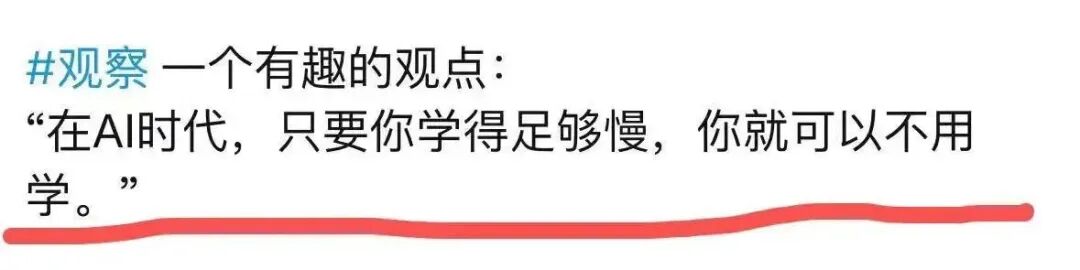
翻完那份官方文档,我最大的感受是:我们以前学的那些提示词技巧,有很多在 Astra 上已经过时了。
那些技巧本身没错,只是模型已经变了。
Astra 更聪明、更谨慎、更有自己的行为模式。
我把官方文档地址放这了,还有些我没讲到的,你去翻翻,比看十篇二手教程都有用:
https://developers.openai.com/api/docs/guides/latest-model
JOTO 企业落地观察
- 企业部署 Astra 类模型时,需重构提示工程体系:原有针对 GPT-4/5 的通用指令模板不再适配,必须依据其‘主动提问’‘强指令记忆’‘测试保守性’三大行为特征,重新设计角色设定、任务边界声明与反馈机制,否则将导致任务漂移或响应效率下降。
- 这类系统的取舍在于:用‘主动提问’换取结果可靠性,但代价是交互链路变长。企业智能体工程中若需严格遵循 SOP 或对接确定性接口,应预置高频歧义的标准应答库,而非依赖模型临时询问,否则会阻塞自动化流水线。
- RAG 知识工程需同步升级:Astra 对上下文指令的长期保持能力,要求 RAG 检索结果必须包含明确的约束条件(如‘仅限 2024 年后政策’‘忽略草案版本’),否则模型会将模糊知识源作为默认前提持续演绎,放大幻觉风险。
- AI 安全治理面临新挑战:Astra 的‘configuration_update’机制允许运行时动态提升推理强度,这意味着同一会话中模型能力等级可突变。企业需在沙箱环境中监控该调用行为,防止因强度跃升导致敏感数据处理逻辑绕过原有合规校验路径。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们