缓存到缓存(C2C):让大模型跳过文本,直接交换KV表征
清华大学等团队提出C2C技术,使多LLM系统绕过低效文本交接,直接通过键值缓存传递内部表征。实验显示准确率提升3.1–5.4个百分点,延迟最高降低14.41倍,但需访问推理栈内部结构。
当一个多大型语言模型(multi-LLM)系统通过文本在不同模型之间传递工作——无论是路由器在不同模型间切换,还是智能体协作完成某项任务——第一个模型必须将其所知内容压缩为文本,而下一个模型则必须读取该文本并重建其中所含信息。这种交接过程可能导致信息丢失,并增加推理时间。
缓存到缓存(Cache-to-Cache) (C2C)是由清华大学及其他中国研究机构的研究人员提出的一种技术,旨在通过让模型利用其键值(KV)缓存中存储的内部表征进行信息交换,而非仅依赖中间文本,从而解决上述问题。
在研究人员的实验中,相较于基于文本的通信方式,C2C将准确率提升了约3.1至5.4个百分点,并降低了所测试各模型对的延迟。对于构建模型路由器或多智能体系统的企业的团队而言,该结果表明通信层本身即可成为一个优化目标。
C2C还契合更广泛的多模型人工智能研究方向,即让模型直接交换内部表征,而非强制所有交接均通过文本词元(text tokens)进行。该工作发表于ICLR 2026会议;研究人员于9月表示,他们计划发布一个 “由智能体管理的KV缓存”(agent-managed KV-Cache)实现方案及配套服务系统。
文本是模型之间的昂贵瓶颈
多大型语言模型系统具有不同配置。在协作系统中,各模型承担不同角色,并交换分析结果、指令或部分解决方案;在路由系统中,协调器(orchestrator)会随着对话或工作流的推进,在具备不同能力与成本的模型之间切换。
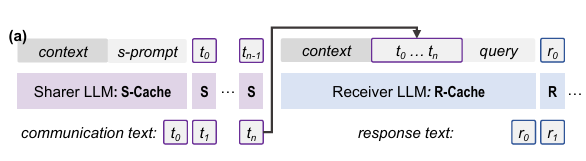
经典文本到文本通信为大型语言模型(LLM)推理增加了开销(来源:arXiv)
这些系统通常依赖文本词元在模型之间传递信息。研究人员指出,这带来了三个问题。
第一个问题是信息丢失。模型在内部以高维数值状态表示上下文;为通过文本进行通信,它必须将该表征的一部分压缩为一串文本词元;接收模型随后需解读该词元序列,并构建自身对发送模型原意的理解,此过程可能造成信息丢失。
另一个问题是文本信息可能存在歧义。研究人员以一个编码员(Coder)模型与一个写作者(Writer)模型共同修改HTML文档为例说明这一点:编码员理解<p>标签在文档中标识某一特定结构位置,但其文本指令未能足够精确地传达该信息,导致写作者未能将所请求的内容置于正确位置。
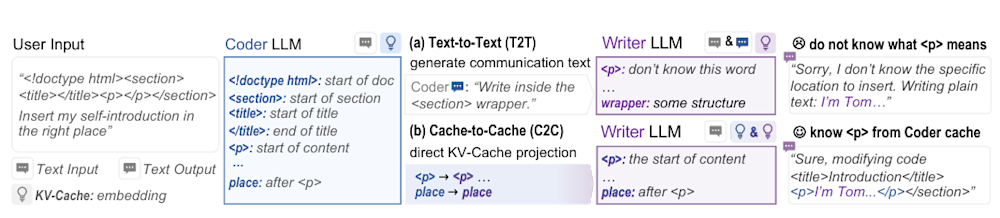
大型语言模型(LLM)之间的文本到文本通信可能引发歧义与混淆(来源:arXiv)
最后,基于文本的通信给人工智能系统施加了沉重的推理成本。第一个模型必须逐个生成其消息词元;这些词元随后被添加至第二个模型的输入中,后者必须处理更长的上下文,方能生成响应。交接内容越长,两个模型所需完成的工作量就越大。在上下文较长或智能体间反复交接的系统中,此类通信开销可能迅速累积。
将KV缓存转变为通信层
C2C试图通过利用模型已自然生成的表征——即KV缓存——进行通信,从而避免额外的文本生成以及接收方对交接文本的处理。
当一个大型语言模型(LLM)首次处理提示(prompt)时,会运行一个“预填充”(prefill)阶段,将输入转换为内部的键(key)和值(value)表征;这些表征被存储于KV缓存中,并在模型生成响应过程中重复使用;这些缓存的键与值状态编码了模型从上下文中推导出的信息。
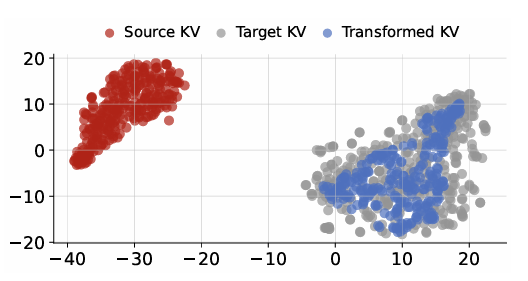
实验表明,KV缓存可在不同模型之间转换而无需重新处理词元(来源:arXiv)
研究人员首先检验KV缓存能否充当通信媒介。其实验表明,KV缓存中存储的信息可在不延长缓存长度的前提下得到增强,且由一个模型生成的缓存可被转换至另一模型的表征空间。
C2C建立在上述发现基础之上。两个模型处理相同的上下文:其中一个作为“共享者”(Sharer),另一个作为“接收者”(Receiver)。一个经训练的缓存融合器(cache fuser)将共享者的缓存映射至接收者的表征空间,再将其与接收者自身的缓存相融合;一个经学习的门控机制(learned gate)控制接收者模型的哪些层应接收额外信息。
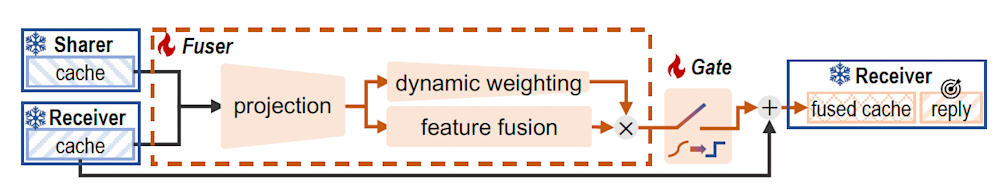
缓存到缓存(Cache-2-cache)架构(来源:arXiv)
在路由系统中,这使得接收者可在无需中间文本消息的情况下整合共享者缓存中的信息。两个模型仍各自处理共享上下文以构建自身的KV缓存。在协作系统中,它则在文本之外创建了另一条通信通道。
C2C的实际应用
研究人员在包括MMLU-Redux、OpenBookQA、ARC-Challenge和C-Eval在内的推理与知识基准测试上对C2C进行了测试。固定Qwen3-0.6B作为接收者,并采用三种不同共享者模型,C2C使接收者的平均准确率相较其单独工作时提升了约9.6至11.9个百分点,较文本到文本通信方式高出约3.1至5.4个百分点。这些是基准测试结果,而非针对生产环境中智能体实际工作负载的测试。延迟测量在单块Nvidia A100显卡上、批处理大小为1的条件下进行。
延迟提升幅度因模型对而异显著。在三种主要共享者配置下,C2C分别比文本到文本通信快3.46倍、1.51倍和14.41倍。14.41倍的结果来自以Qwen3-4B Base作为共享者的情形;研究人员指出,该模型有时会忽略文本通信指令,生成超出预期长度的消息,致使文本基线特别缓慢。
在一次文本到文本通信的实验中,共享者平均生成了80个通信词元;生成这些词元耗时1312毫秒;最终生成的消息还增加了接收者需处理的词元数量。相比之下,C2C仅需约90毫秒的缓存融合时间,且无需生成任何文本词元。
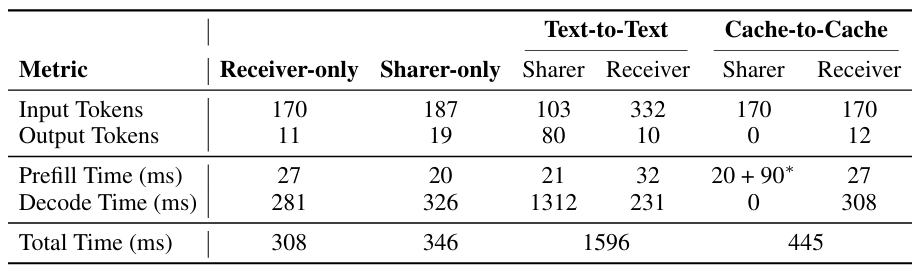
C2C结果
该技术在两个模型具有不同架构或专业分工时同样有效。测试组合包括Gemma到Qwen、Qwen Math到Qwen以及Qwen Coder到Qwen。在实验报告的全部五种异构及互换模型配置中,C2C均优于文本通信。
部署C2C所需条件
C2C无需对任一参与的大型语言模型(LLM)进行微调。研究人员冻结共享者与接收者模型,仅使用标准的下一词元预测(next-token prediction)目标来训练缓存融合模块。
然而,跨模型通信需要工程工作。不同模型可能具有不同的分词器、层数和表示尺寸。C2C 对齐由不同分词器生成的词元,并在融合其缓存之前映射对应的 Transformer 层。训练该桥接模块也存在前期成本。研究团队已发布 C2C 代码和配置 ,采用 Apache 2.0 许可证托管于 GitHub,并同时发布 预训练的 C2C 融合器检查点 ,托管于 Hugging Face。
一个注意事项是:由于 C2C 需要读取、转换并替换内部 KV 缓存状态,因此它要求推理栈暴露这些内部结构。这使得该技术目前主要适用于控制自身推理栈的团队,而不适用于仅通过封闭 API 将模型拼接在一起的应用程序。
大语言模型彼此通信时或许并不需要依赖词元
C2C 属于更广泛的一类研究方向,该方向质疑文本是否应继续作为多模型 AI 系统内部的默认接口。
其中一个例子是英伟达(Nvidia)关于 跨模型 KV 缓存传输的研究。当系统在长时间运行的会话中切换模型时,新模型通常需重新处理累积的上下文并重建其缓存。而英伟达则将现有缓存映射为目标模型的格式。在兼容的模型对上,英伟达研究人员报告称,该技术的运行速度比重新填充(re-prefilling)快 2.7 至 25 倍。
尽管英伟达的技术在源模型与目标模型之间传输完整的 KV 缓存,C2C 则让两个模型各自处理上下文,再融合其缓存,从而使接收方(Receiver)能够受益于另一模型的语义表示。
该领域另一个例子是 RecursiveMAS,这是一种多智能体框架,以连续潜在表示替代智能体之间传递的文本消息。其实验结果显示,相比其基于文本的递归对应版本,推理速度最高提升 2.4 倍,词元使用量减少 75.6%。
这些机制各不相同,但共享同一底层假设:当模型无需先将所有内容翻译为文本时,它们之间的通信可能更加高效。
目前,C2C 是一项研究成果,而非生产级架构:它需要访问模型内部结构,且其性能增益是在基准测试中测得,而非真实的企业级智能体工作负载。
JOTO 企业落地观察
- 对企业部署而言,C2C要求团队自控推理栈并暴露KV缓存状态,意味着当前仅适用于拥有底层模型部署能力的AI工程团队,不兼容纯API调用型SaaS集成方案。
- 对智能体工程而言,C2C提供了一条独立于文本消息的语义通信通道,可缓解协作中因 标签定位歧义等导致的任务错位问题,但需额外开发跨分词器、跨层数的缓存对齐模块。
- 对FDE落地而言,C2C虽在基准测试中展现显著性能增益,但其未在真实企业工作流中验证,且依赖异构模型间缓存映射训练,短期内难以作为标准化通信层纳入通用AI员工架构。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们