GLM-5.3发布:后训练驱动的编程智能体跃升与网络安全能力意外突破
Z.ai发布GLM-5.3,基于7430亿参数基础模型,通过扩展长周期强化学习后训练显著提升编程与网络安全能力;已在Cursor中发现潜在严重漏洞,但API与开源权重将延后开放,并引入可信访问管控。
中国人工智能初创公司Z.ai,因其日益壮大的、主要为开源的GLM系列大语言模型而享誉国际, 今日发布了GLM-5.3, 该版本在长周期编程能力方面取得显著提升,并在网络安全能力方面实现了一次更重大——且潜在敏感性更高——的跃升。
据z.ai开发者倡导者Lou在X平台发布的消息,GLM-5.3的网络安全能力目前已发现AI编程初创公司Cursor中一个“潜在严重漏洞”, 该公司近期被SpaceX收购,。VentureBeat亦已在X平台向Cursor发出确认请求,目前正等待回应。 (注:原文此处为句号,但根据上下文及标点逻辑,应与前句合并为完整句子;译文严格按原文结构保留句号)VentureBeat也已在X平台向Cursor发出确认请求,目前正等待回应。
GLM-5.3最初仅 限于 通过该公司GLM编程计划(GLM Coding Plan)及ZCode编程环境提供,而API访问权限与开源权重(open weights)将在“完成安全评估与加固工作后”陆续推出,该公司表示。
Z.ai表示,其计划在发布约两周后公开模型权重。
对企业级开发者而言,此次发布的亮点并不仅在于又一轮基准测试性能提升。Z.ai称,GLM-5.3沿用了GLM-5.2的同一基础模型,所有改进均完全源自在更多环境、更广泛任务类型以及额外强化学习算力支撑下的后训练扩展。
这使得GLM-5.3成为一次检验前沿规模基础模型在不经历另一次昂贵预训练周期前提下,所能被推向极限程度的试验。
Z.ai在其技术公告中写道:“GLM-5.3所做的一切仅为扩展后训练。” 技术公告。
结果表明尚有可观提升空间。但这也为一家开源模型开发商带来了非同寻常的问题:据Z.ai称,随着后训练规模扩大,网络安全能力的提升速度超出预期,尤其当任务从漏洞识别逐步演进至构建完整利用链(exploitation chains)时更为明显。
路透社周五报道称,Z.ai还将针对该模型部分更高级能力引入管控措施,包括对敏感功能采用“可信访问”(trusted access)机制。
无需更换基础模型的大规模编程能力跃升
GLM-5.3基于GLM-5.2背后的7430亿参数规模基础模型构建,而非替换该模型。Z.ai转而扩展了其此前已围绕长周期强化学习搭建的后训练系统。
这些训练环境日益趋近完整的工程任务,而非孤立的编程练习。
Z.ai描述了若干场景:智能体可访问代码库、文档、计算集群、存储系统及实验结果,随后需诊断问题、修改系统、运行实验,并在确保正确性的前提下展示可衡量的改进效果。部分任务旨在模拟一名资深工程师数日的工作量。
该方法在其报告的评测中产生了显著的代际生成性能提升。
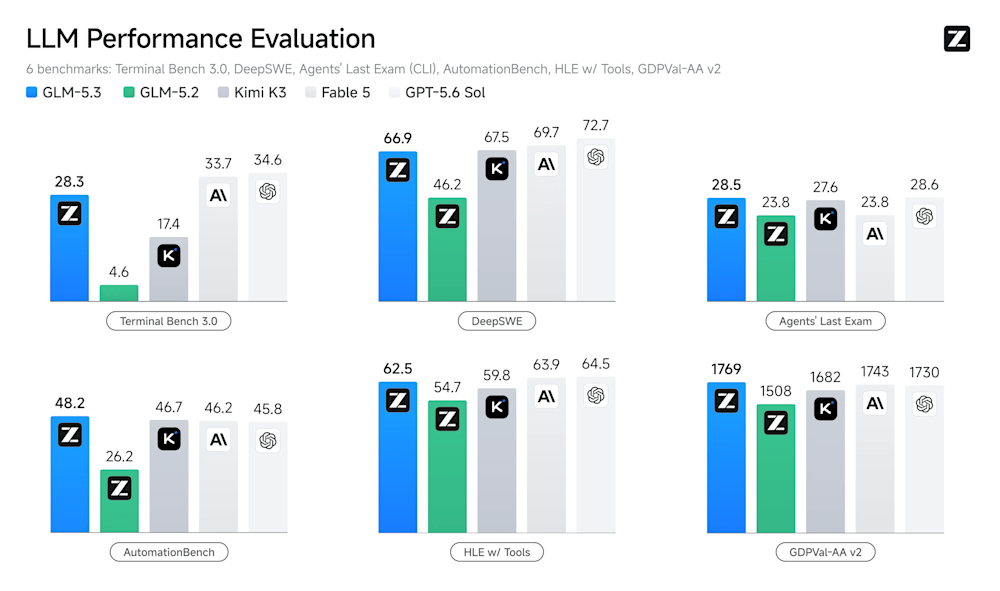
GLM-5.3在Terminal-Bench 3.0上的得分由4.6跃升至28.3,在DeepSWE v1.1上由46.2升至66.9,在AutomationBench上由26.2升至48.2;在Agents' Last Exam CLI上则由23.8提升至28.5。
该模型并未在所有前沿竞品中全面领先。Z.ai自有的基准测试表显示,在Terminal-Bench 3.0上,GPT-5.6 Sol得分为34.6,Claude Fable 5为33.7,而GLM-5.3为28.3;在DeepSWE v1.1上,GLM-5.3得分为66.9,而GPT-5.6 Sol为72.7,Fable 5为69.7。
但Z.ai亦强调效率,而非仅关注基准测试排名。
在其私有Z.ai Code Bench评测中,GLM-5.3在最高推理设置(Max reasoning setting)下达成34.5%的结果,同时每项任务消耗约75,000个输出token;GLM-5.2则在消耗约96,000个token时达成23.4%。在高努力度设置(High effort)下,GLM-5.3以约50,000个输出token达成31.4%,而Z.ai报告的Claude Opus 4.8在消耗120,000个token时达成29.5%。
由于Code Bench是Z.ai自有的私有评测,上述对比应视为公司报告结果,而非独立测量结果。尽管如此,降低token消耗的同时提升任务完成率,对企业部署编程智能体具有重要运营意义——因长时间运行的循环会迅速加剧推理成本与延迟。
网络安全能力的发展速度超出Z.ai预期
更不同寻常的发展在于网络安全领域。
Z.ai将漏洞发现环境纳入GLM-5.3的后训练组合,本意是期望模型在发现软件缺陷方面有所提升。然而,该公司表示,模型能力却开始沿利用链进一步发展。
Z.ai写道:“随着我们扩展后训练,网络安全能力的发展速度超出了我们的预期。”
GLM-5.3的z.ai基准测试结果。图片来源:z.ai
在用于测试源代码层面漏洞发现与验证的CyberGym评测中,GLM-5.3得分为84.5%,高于GLM-5.2的77.2%。该成绩亦略高于Z.ai报告的GPT-5.6 Sol得分83.6%及Mythos 5得分83.8%。
但这一优势并未延伸至整个利用栈(exploitation stack)。在ExploitBench上,GLM-5.3得分为54.4%,超过GLM-5.2的24.4%两倍以上,但仍远低于Z.ai报告的GPT-5.6 Sol得分76.5%及Mythos 5得分78%。
类似地,在ExploitGym上,GLM-5.3在标准化的两小时预算内完成105项任务,六小时内完成130项,而GLM-5.2对应数据分别为29项与39项。Fable 5分别达成181项与247项,GPT-5.6 Sol则为216项与293项。
演进方向可能比排行榜位置更具意义。
Z.ai表示,其与中国安全团队的合作,在经专家评审、筛选与去重后,已在269个项目中发现2436个漏洞。其披露日志(disclosure ledger)列明其中1097个属严重或高危级别,53个已公开披露,2383个截至发布之时仍处于禁运(embargo)状态。
这正构成前沿模型提供商日益面临的张力:使模型在软件工程中更具实用性的长周期智能体能力,同样使其成为更强大的安全研究人员——并可能成为更强大的进攻型操作者。
GLM-5.3还要求开发者更改调用模型的方式
正在迁移现有GLM应用的开发者应注意一项破坏性API行为变更。
GLM-5.3支持三级推理努力度设置—— low, high 以及 max ——其中 max 为默认设置,亦为Z.ai推荐的编程设置。但与此前版本不同,推理(thinking)功能不可禁用。
当前发送 thinking.type: "disabled" 的应用程序必须将该值更改为 enabled 并在将模型标识符切换为 GLM-5.3 之前指定推理努力程度。否则,Z.ai 表示该请求将失败。
这使得 GLM-5.3 成为一次真正的迁移,而不仅仅是某些生产应用中简单的模型名称替换。
从 GLM-4.5 到 GLM-5.3:Z.ai 快速进军智能体工程(agentic engineering)
GLM-5.3 是 Z.ai(前身为智谱 AI,Zhipu AI)向编码智能体(coding agents)及长期自主工程工作负载快速转型的最新一步。
2025 年 7 月发布的 GLM-4.5 奠定了上述大部分方向。这款参数量达 3550 亿的混合专家(mixture-of-experts)模型旨在融合推理、编码与智能体能力;而更小的 GLM-4.5-Air 则拥有总计 1060 亿参数。Z.ai 以开源权重形式发布这些模型,并强调其与智能体框架的集成。
GLM-4.6 于同年 9 月发布,将上下文长度从 128,000 提升至 200,000 个 token,并针对包括 Claude Code、Cline、Roo Code 和 Kilo Code 在内的多种环境中的编码、工具使用及智能体工作流进行优化。Z.ai 还开始更加重视真实世界编码评估中的 token 效率,而非仅关注基准测试性能。
更大的架构跃迁出现在 2026 年 2 月发布的 GLM-5 中。Z.ai 将模型参数量从 GLM-4.5 的 3550 亿扩展至 7440 亿,其中活跃参数为 400 亿,并将预训练数据量提升至 28.5 万亿 token。该版本还引入了名为“slime”的异步强化学习基础设施,并明确将 GLM 系列重新定位为面向“智能体工程”(agentic engineering)和长周期任务。
截至 6 月,GLM-5.2 已将该战略转化为更直接的企业级方案。这款参数量达 7530 亿的模型配备了稳定的 100 万 token 上下文窗口,以 MIT 许可证开源权重,并支持超过 20 种编码环境。它还推出了 IndexShare 技术,通过在稀疏注意力层间复用索引器,降低极长上下文带来的计算负担。
GLM-5.2 的定价为每百万 API 输入 token 1.40 美元、每百万输出 token 4.40 美元,缓存输入价格则显著更低,使 Z.ai 在技术和定价两方面均成为专有前沿实验室的竞争对手。
Z.ai 的雄心亦已超出模型开发范畴。路透社上月报道称,智谱 AI(Zhipu AI)通过香港股票发售筹集约 314 亿港元(约合 40 亿美元),所筹资金将用于研发、算力基础设施、人才引进及业务拓展等领域。
综观上述发布,可见一条清晰一致的演进路径:GLM-4.5 实现了推理、编码与智能体能力的统一;GLM-5 大幅扩展了基础模型规模;GLM-5.2 聚焦于长上下文与长周期工程任务;而 GLM-5.3 当前正试图通过后训练(post-training)从同一基础模型中提取远超以往的能力。
定价、ZCode 与可用性
GLM-5.3 现已通过 Z.ai 的 GLM 编码计划(GLM Coding Plan)及 ZCode 提供。
ZCode 是该公司自研的编码智能体环境,支持长期运行的“目标”(Goal)任务,涵盖规划、实现、测试与验证全流程。它还提供对运行中任务的远程控制功能,并可在 macOS、Windows 和 Linux 系统上使用。
目前,个人版 GLM 编码计划起售价为每月 12.60 美元的 Lite 版(含每周 10,000 积分);Pro 版标价为每月 56 美元,用量为 Lite 版的六倍;Max 版每月 117.60 美元,用量为 Lite 版的十四倍。团队版 Standard 与 Premium 席位则分别标价每人每月 88 美元与 188 美元。
Z.ai 还已将编码计划转为基于积分的配额体系,对输入 token、缓存输入 token 和输出 token 分别计费。在公司工作日非高峰时段调用 API 仅消耗正常积分的 50%。
公司在本次发布的启动材料中尚未提供 GLM-5.3 的通用 API 定价,因此在分阶段 API 接入上线前,尚难以直接比较其整体生产环境 API 成本与 GLM-5.2 或其他竞争性前沿模型的成本。
这一分阶段发布,或许最终将成为 GLM-5.3 最关键的部分。
过去一年,Z.ai 致力于推行一种以宽松权重许可、低成本推理及兼容现有编码智能体生态为重心的开源模型战略。GLM-5.3 展示了该战略在某一敏感领域可能取得的过度成功:更强的自主工程能力,也意味着更强的自主安全研究能力。
其结果是,该模型在推进 Z.ai 编码雄心的同时,迫使公司直面与最大型闭源前沿实验室相同的“能力与访问权限权衡”(capability-versus-access tradeoff)。
因此,对企业开发者而言,GLM-5.3 值得关注的原因有二:其编码成果进一步表明,日益强大的智能体可通过更优的后训练与环境实现,而无需持续重建底层基础模型;其网络安全成果则揭示出,决定这些智能体如何分发,可能与决定其如何训练同等重要。
JOTO 企业落地观察
- 对企业部署而言,GLM-5.3强制启用三级推理努力度且不可禁用thinking,意味着现有GLM应用需重构调用逻辑,迁移成本高于简单模型替换,凸显API兼容性管理在智能体工程落地中的关键性。
- 对智能体工程而言,GLM-5.3证明仅通过后训练扩展(而非重训基础模型)即可在Terminal-Bench等任务上实现性能翻倍,验证了‘环境复杂度+强化学习算力’作为智能体能力增长新杠杆的有效性。
- 对AI安全治理而言,该模型在CyberGym达84.5%、ExploitBench达54.4%,且已发现2436个漏洞(1097个高危),迫使Z.ai采用‘可信访问’机制——表明开源模型厂商正面临与闭源巨头同等的能力分发权衡难题。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们