ScholarEvolve:无需重训练,从论文自动提取代码升级AI智能体框架
UCSB与微软提出ScholarEvolve框架,通过解析arXiv论文自动生成可插拔模块代码,将Qwen3.5-27B在AppWorld任务完成率提升12.4个百分点,性能逼近GPT-5.4,全程不更新模型权重。
AI智能体正被赋予优化自身组件的能力,例如提示词(prompts)、上下文管理、工作流和代码。然而,当前的自演化框架优化器通常依赖于底层模型已有的知识,或智能体迄今所探索过的执行轨迹。
加州大学圣塔芭芭拉分校(UCSB)与微软的研究人员开发了一种新框架,旨在解决这一瓶颈。该框架被称为 ScholarEvolve,它能自动从研究论文中提取新信息,并将其转化为智能体框架(harness)的代码升级。
在基准测试中,ScholarEvolve 将开源权重模型 Qwen3.5-27B 在 AppWorld Normal 测试集上的任务完成率从 69.0% 提升至 81.4%,在未更新模型权重的前提下,填补了约 74% 与 GPT-5.4 的性能差距。
对于企业工程团队而言,该方法提供了一条无需重新训练底层模型即可提升智能体性能的路径,同时也为持续升级框架以适配不熟悉 API 的场景建立了蓝图。
当前框架优化器遭遇瓶颈之处
过去一年中,自动化框架优化框架普遍遵循两条路径之一。特定组件类工具,例如 Google 的 WikiSkill、 Microsoft 的 SkillOpt以及 Memento-Skills,通过分析智能体的执行轨迹来优化堆栈中的单一部件,例如技能库或记忆存储。
与此同时,全框架优化器(full-harness optimizers),例如 Salesforce 的 DarwinX、 小米的 HarnessX、 Self-Harness以及斯坦福大学的 Meta-Harness,则使用一个编码元智能体(coding meta-agent)检查失败轨迹,并重写智能体的脚手架(scaffolding)或运行规则。
尽管这些方法有效,但 UCSB 与微软的研究人员指出,仅依赖执行反馈会形成一个闭环,迅速达到收益递减的临界点。
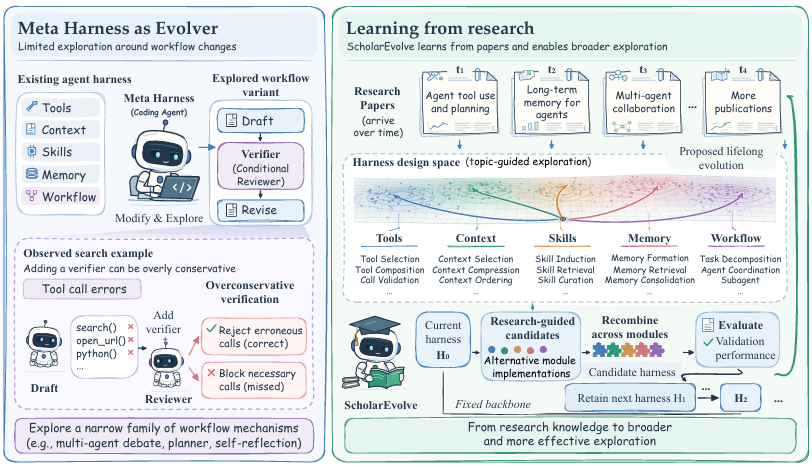
元框架演化 vs 外部研究(来源:arXiv)
首先,元智能体受限于底层模型的参数化知识。正如研究人员所写:“元智能体提出的机制取决于其主干模型(backbone)的知识与推理能力。一次失败轨迹可能暴露出某项缺失能力,却几乎无法指明构建该能力所需的具体技术。”
当编码元智能体在执行轨迹中反复观察到工具调用错误时,它往往退回到熟悉的软件范式,例如插入验证步骤或引入多智能体辩论循环。在该研究的一个示例中,元智能体注意到搜索与 Python 工具调用反复出错,于是添加了一个条件评审模块(conditional reviewer module),用于验证每一项操作。尽管该验证器成功拦截了错误调用,但它变得过于保守,阻塞了完成任务所必需的有效 API 调用。
另一个问题是,基于轨迹的演化具有被动性。“由执行轨迹与反馈驱动的演化,其证据仅来源于已遭遇过的情形,”研究人员写道,“在实际部署中,某项缺陷可能在积累足够证据以触发有效更新之前,就已影响用户。”
这些局限性促使研究团队提出一个根本性问题:“一位经验丰富的研究人员将如何发现智能体自身经验尚未揭示的改进方案?”
ScholarEvolve 架构内部
ScholarEvolve 分析训练集中的失败案例, 在研究文献中搜索可解决这些问题的技术,将这些技术实现为框架模块,并测试它们协同工作的效果。
为防止对智能体某一部分的代码修改破坏其他部分,ScholarEvolve 将智能体框架划分为五个具有严格输入输出接口的独立模块:工具接口(tool interface)、上下文管理(context management)、技能(skills)、记忆(memories)以及智能体工作流(agentic workflows)。
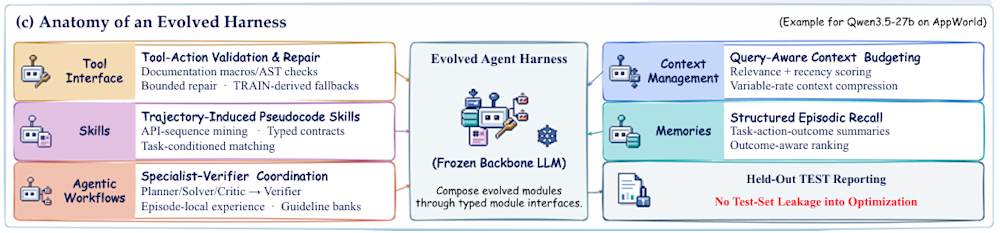
演化的框架组件(来源:arXiv)
优化流水线分四个阶段运行:
失败审计与文献检索: 一名审计模型(auditor model)检查训练集中的失败任务,识别通用能力缺口,例如丢失对早期观测结果的追踪,或无法从语法错误中恢复。随后,它生成搜索查询,从 arXiv 中检索相关研究论文及摘要。
主题建模以实现多样化探索: 为避免检索到相似论文,ScholarEvolve 使用一种名为 TopicGPT 的主题建模方法,按各模块内机制家族(mechanism families)对论文进行聚类。然后,它利用不同机制确保编码智能体测试不同的工程思路。
蓝图与健康探针:针对每篇选定论文,一名研究智能体(research agent)通读全文及任何官方代码,生成一份变异蓝图(mutation blueprint)。一名编码智能体(coding agent)为该特定模块编写 Python 实现,同时保持其余四个模块固定不变。自动化健康探针(automated health probes)验证新代码能否顺利导入、是否遵守接口契约、是否生成有效操作,之后才启动全面评估。
模块交叉与选择: 一旦各个模块升级版本在验证集上完成评分,ScholarEvolve 即采用遗传交叉(genetic crossover)过程,将表现最优的模块组合成完整框架。每个组合候选方案均需在验证任务上接受联合回归测试(joint regression testing),并经统计检验,确保仅有经确认的改进才能取代当前优胜方案(champion)。
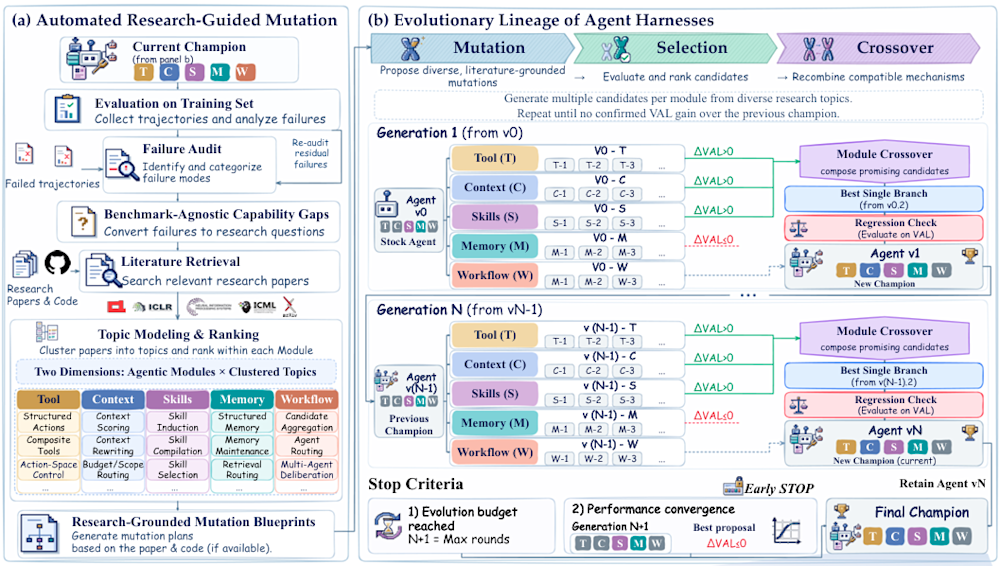
ScholarEvolve 流程(来源:arXiv)
例如,当 ScholarEvolve 应用于 AppWorld 环境下的 Qwen3.5-27B 时,它 产生了三项显著改进:
修复盲目 API 调用(工具接口): 基础智能体频繁生成无效 Python 语法,或在未查阅文档的情况下猜测 API 参数。ScholarEvolve 实施了来自 ToolACE-R 论文的一种机制:在执行前增加抽象语法树(AST)检查以验证 Python 调用,并加入一个宏(macro),可在运行时动态打印 API 文档。
防止丢失观测结果(上下文管理): 长交互历史导致智能体超出上下文预算或丢失对早期证据的追踪。借鉴一篇关于提示压缩限制的论文, 关于提示压缩限制的论文该框架构建了一个查询感知型预算分配模块,在保持系统策略不变的前提下,依据任务相关性和时效性对对话历史进行评分,并据此分配字符预算,同时保留时间顺序。
避免重复发明 API 调用序列(技能): 学者演化(ScholarEvolve)并未让智能体在每次运行中都从零开始重新发现多步 API 调用,而是应用了 Skill-as-Pseudocode 论文的方法:它从成功的训练运行中挖掘出反复出现的 API 调用序列,并将其编译为带类型的伪代码模板。
ScholarEvolve 实际运行示例
研究人员在两个模拟企业工作流部分环节的交互式基准测试上评估了 ScholarEvolve:AppWorld(智能体跨多个应用程序编写代码并调用 API)和 tau-Bench Telecom(智能体与模拟用户协作排查客户服务、移动数据及消息收发问题)。他们以 Qwen3.5-27B 和 GPT-5.4-mini 为基础模型演化出基础框架(harness),并将其与初始框架、斯坦福大学的 Meta-Harness 以及一系列前沿模型进行对比测试。
在所有测试指标上,ScholarEvolve 均提升了两种基础模型的能力。在 AppWorld 上,演化的 Qwen3.5-27B 框架在任务目标完成率(TGC)上提升了 12.4 个百分点,在场景目标完成率(SGC)上提升了 20.2 个百分点(SGC 要求在同一场景的三种不同变体中均取得成功)。在 Telecom 上,其将 GPT-5.4-mini 的表现从 72.7% 提升至 81.9%。
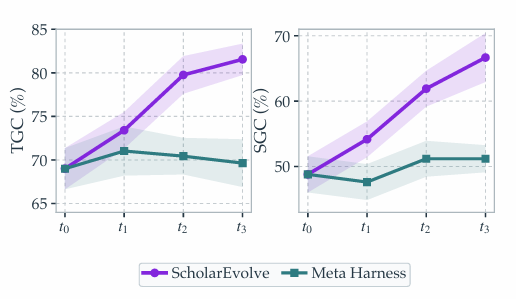
ScholarEvolve 与 Meta Harness 对比(来源:arXiv)
研究人员写道:“因此,框架(harness)设计对给定基础模型(backbone)所展现的能力具有显著影响。”
对企业开发者而言,实验中凸显出若干详细发现:
对未见过的应用程序和复杂 API 的零样本泛化能力: AppWorld 挑战赛测试智能体在 Amazon 和 Gmail API 上的表现,而这些 API 在演化过程或验证集中从未出现过。使用演化的框架后,Qwen3.5-27B 的表现从 49.6% 提升至 63.6%(+14.0 分),比 Meta-Harness 高出 9.0 分。
为何孤立优化单个模块会误导团队: 在一项针对开发任务的消融研究中,Qwen3.5-27B 单独升级技能模块得分为 75.4%,而 Skill-as-Pseudocode 模块单独得分较低,为 73.7%。然而,当该 73.7% 的技能模块与演化的工具接口、上下文、记忆及工作流模块组合使用时,整体系统性能显著更强(任务完成率为 84.8%,高于 80.7%)。“因此,独立模块得分并不能识别出最强的模块组合,”作者写道。
任务中途错误恢复能力: 在生产环境中,工具调用不可避免地会失败。区分可靠智能体与脆弱智能体的关键在于其对回溯信息(tracebacks)的响应方式。在 AppWorld 挑战赛中,在遭遇中间 Python 执行错误的运行中,演化的 Qwen3.5-27B 框架完成了 59.9% 的任务,而基础框架仅为 44.9%。“这些轨迹统计数据显示,仅凭中间工具错误无法完整评估智能体能力:许多成功任务需利用返回的错误信息来修正后续操作,”研究人员写道。
企业团队的实施注意事项
研究人员提供了一个 GitHub 仓库链接,但截至本文发表时该仓库为空。论文附录中包含了所选五个框架模块的代码片段。由于基础模型权重在整个过程中保持冻结,工程团队无需管理自定义模型检查点。
如果您希望应用这些洞见,请注意 ScholarEvolve 会检索论文及 与该研究相关的可用官方代码,其自动化健康探测(health probes)会检查 Python 可导入性、接口兼容性、构件(artifact)构建以及有效动作格式。论文未描述任何安全扫描机制,以审查所检索论文或第三方代码是否存在恶意依赖项、不安全执行模式或提示注入漏洞。
企业团队不应允许元智能体(meta-agent)在生产环境中引入未经审核的研究衍生代码变更。相反,团队应构建一个安全审核网关,或将该框架指向一个经过审核的内部知识库,其中包含已审核的论文与工程设计文档。
还需注意,框架演化无法修复智能体流水线中的所有问题。它可帮助改进智能体的输出格式、上下文预算管理以及从 API 回溯中恢复的能力,但无法替代 API 网关处的确定性策略防护措施,也无法修复上游检索流水线薄弱的问题。
研究人员还测试了三轮连续的文献更新,期间未更改 Qwen 的模型权重或此前收集的任务数据。在 AppWorld Normal 上,三轮更新均带来性能提升,但该实验并未在生产环境中测试持续适应能力。
研究人员写道:“基于文献的演化天然支持主动适应:新发表的论文可在部署智能体中实际观察到对应故障之前,就提供潜在的改进方案。例如,一个已部署的智能体可每月审阅最新研究成果,并针对验证任务评估有前景的更新。”
JOTO 企业落地观察
- 对企业部署而言,该方法提供了一条免模型重训的渐进式升级路径:工程团队可每月扫描新论文并验证模块更新,但必须建立安全审核网关,因当前框架未内置恶意依赖或提示注入检测机制。
- 对智能体工程而言,研究证实孤立优化单模块(如仅升级技能)可能误导选型——73.7%得分的Skill-as-Pseudocode模块与其余演化模块组合后,系统级任务完成率达84.8%,凸显模块接口契约与协同验证(joint regression testing)的关键性。
- 对AI安全治理而言,ScholarEvolve暴露了元智能体自生成代码的风险边界:其健康探针仅校验Python可导入性与接口兼容性,未覆盖第三方代码的安全执行、权限控制或供应链漏洞,企业不可直接将检索所得论文代码投入生产环境。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们