四台 DGX Spark:环网 vs 交换机差的不是一根线,是“拓扑自由”的定价
本文对比四台 DGX Spark 采用环网直连与配备 200G 以太网交换机两种方案:环网虽省下 ¥8,000–8,700 交换机成本,但八个高速口全被占用,无冗余、无管理网接口,非相邻节点需中转导致带宽争抢,且不被 NVIDIA 官方支持;交换机方案提供任意两节点一跳直达、拓扑灵活、可平滑扩容,本质购买的是「拓扑自由」与运维下限。
环网的本质:用全部端口换掉一台交换机
“我先买四台 Spark,拿线串起来,不买交换机行不行?省下来的钱,够不够再添一张卡?”如果你是做 AI 产品的销售,这个问题几乎一定会遇到。它听起来是在省钱,其实客户在问一个更根本的东西:愿不愿意用拓扑上的束缚,去换掉交换机那笔开支。
四台 DGX Spark 恰好卡在一个微妙的分界线上——环网“能跑”,但跑法和交换机有本质区别,而且四台无交换机的环网并不在 NVIDIA 的官方支持清单里;线缆看着省,其实两边都得买,真正被省掉的只有那台交换机。
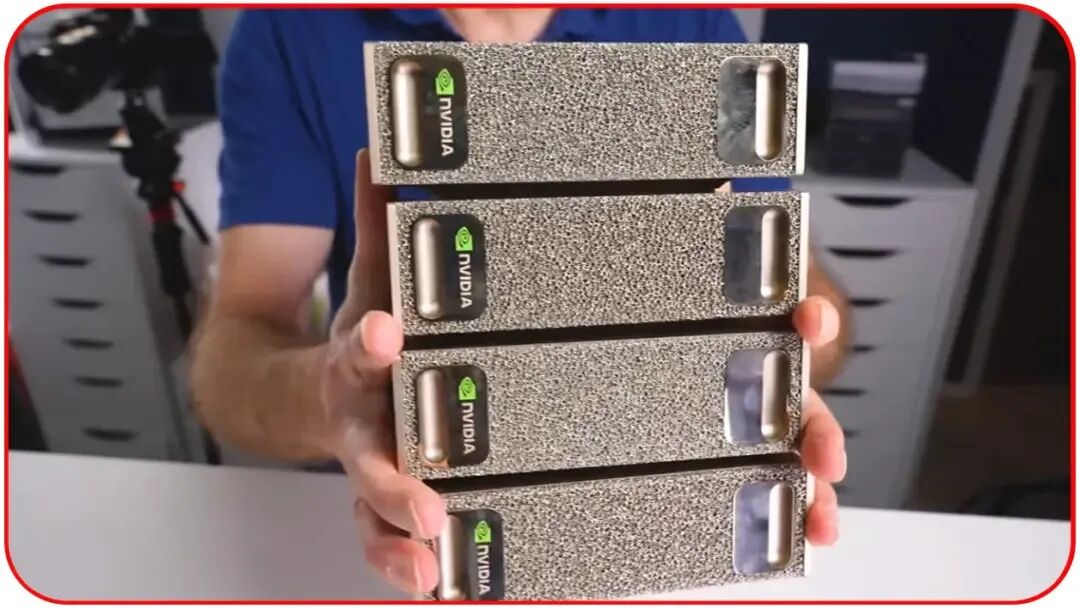
硬件事实:每台 Spark 只有两个可用高速口
DGX Spark 每台背面有两个 QSFP 端口(ConnectX-7),单口标称 200 Gb/s,且只支持以太网配置——不是 InfiniBand。这意味着一台 Spark 最多同时参与两条高速点对点链路。
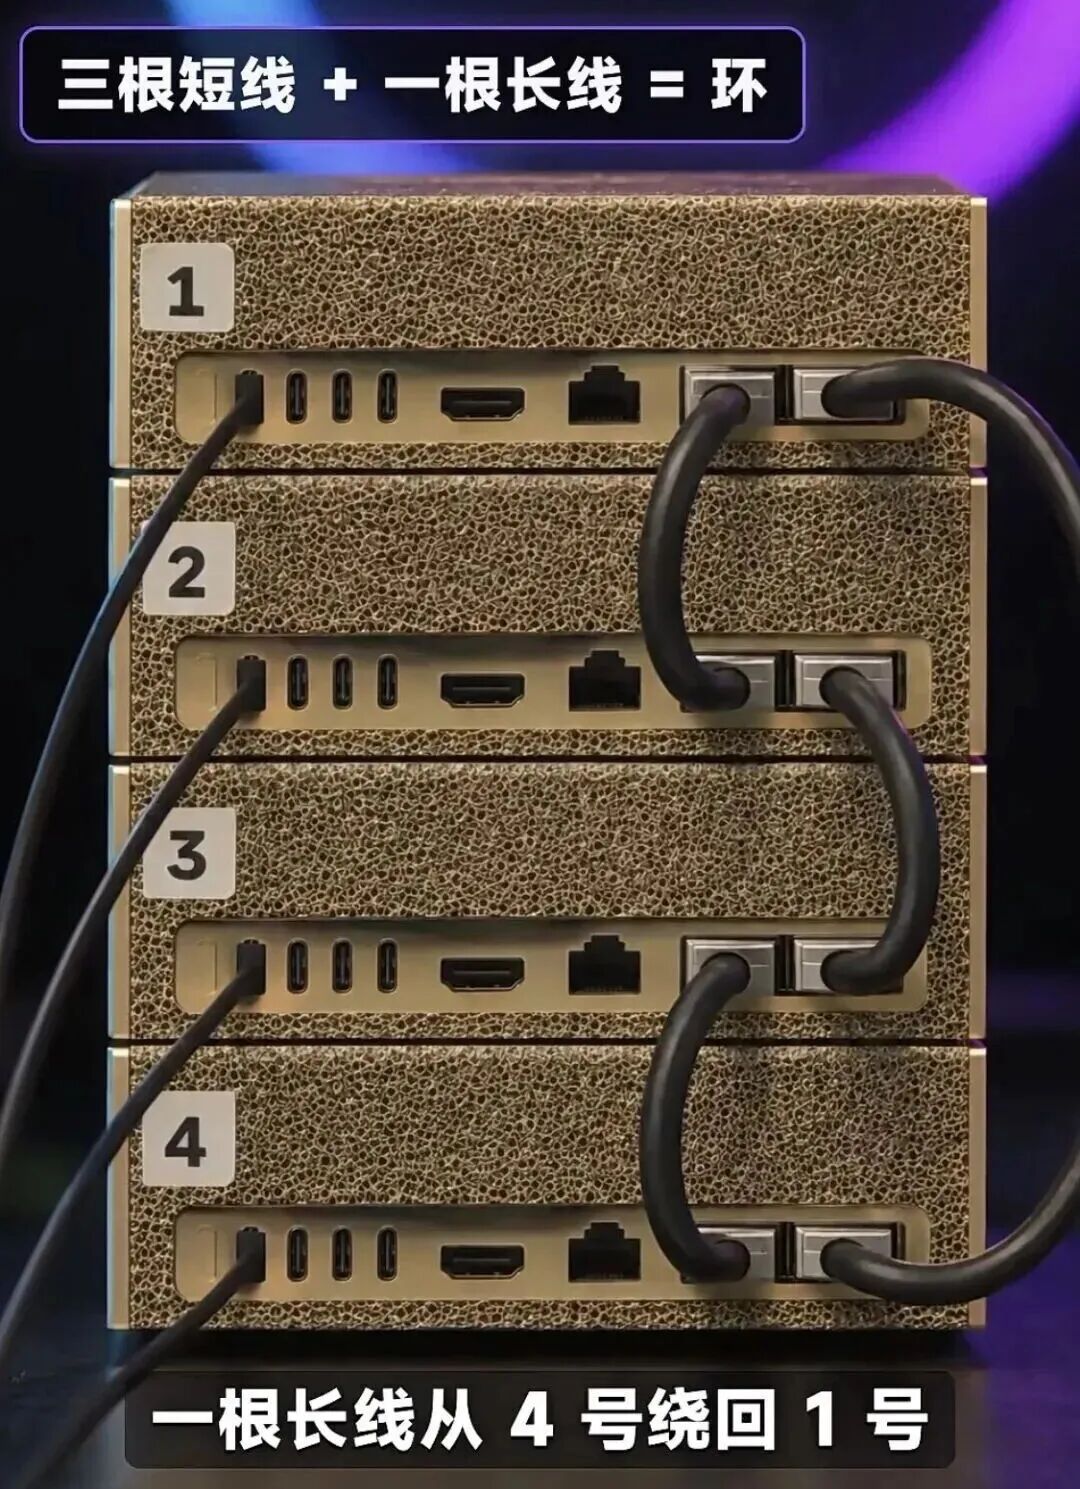
四台机器做环网,就是让每台机器一个口接左边邻居、一个口接右边邻居,四根线首尾相连,八个口一个不剩,全程不经过交换机。这就是“环网”的物理本质。
但有个容易被忽略的细节:环网会把两个口全部占满,一台不剩。这意味着没有空口留给管理网、存储网,也做不出第二条独立路径做冗余;反过来,任意一根线掉了,环就退化成一条链,非相邻通信得先绕远。
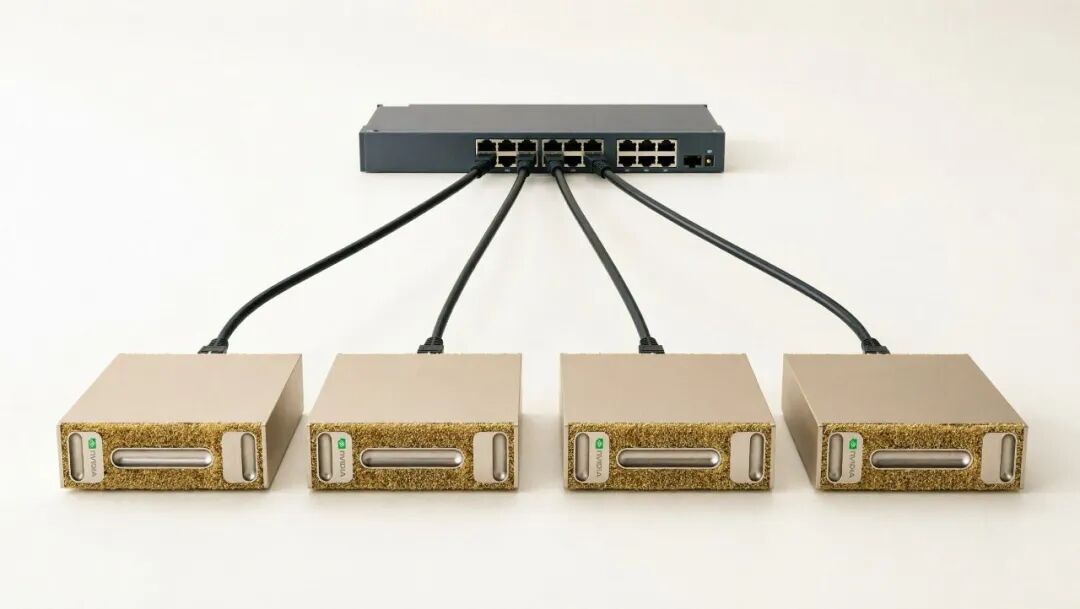
交换机方案则不同:每台 Spark 只用一个 200G 口上行到交换机,另一个口还空着,可以留给管理网、存储网或第二条链路。任意两台之间的通信都是“一跳”——A 的上行进交换机、从 B 的上行出来,不经过第三台机器中转。“一跳”不是物理直连,但它不占用别人的端口带宽,也不吃掉别人的算力。
预算对比:环网省下的就是那台交换机
先把账说清楚:在“四台”这个节点数上,环网能省掉的只有交换机本体。四根线材两边一样要买,所以真实差价就是那 ¥8,000–8,700,而不是“网络侧零成本”。真正拉开差距的不是这张预算表,而是它的最后两行——扩展性和隐性成本。
| 对比维度 | 四台环网(无交换机) | 四台 + 200G 交换机 |
|---|---|---|
| 核心网络设备 | 无 | 1 台 200G/400G 以太网交换机(如 MikroTik CRS804 DDQ,4 个 400G 口,约 ¥8,000–8,700;品牌机型则要 ¥53,000–154,000 量级。注:这个价位常被引用的 NVIDIA Quantum 是 InfiniBand 交换机,Spark 的 CX-7 只有以太口,接不上,只能当价格参照) |
| 线缆 / 光模块 | 4 根 QSFP DAC,约 ¥3,290–5,340:便宜的 200G QSFP56 线材约 ¥3,300,NVIDIA 验证的 QSFP112 线材约 ¥5,000;若走长距离改用 AOC/光模块,还会再高一截 | 同样是 4 根 DAC,价格与环网基本一致(约 ¥3,290–5,340);端口余量要看选型:CRS804 DDQ 只有 4 个 400G 口,四台刚好占满,要加第 5 台得靠 400G 分线(一拆二)或换 8 口机型 |
| 网络侧一次性投入(粗算) | 约 ¥3,290–5,340(只有线缆) | 交换机 ¥8,000–8,700 + 同价线缆 ≈ ¥12,000–13,000(入门 200G 口径,不含品牌机型溢价) |
| 占四机总价的比例(按四机约 ¥12 万口径) | 约 3%–4%(仅线缆) | 约 10%(含线缆);单看交换机约 7% |
| 加第 5 台的成本 | 八个口全被邻居占满,没有空口可用;要加机器只能上交换机,或把整套拓扑推倒重来 | 取决于端口余额:8 口及以上机型直接加线;4 口机型(如 CRS804 DDQ)需 400G 分线或换机 |
| 隐性成本 | 要自定义 NCCL 构建与拓扑规划(官方不支持四机环网)、NCCL 逻辑环须与物理布线对齐、非相邻流量争抢链路导致有效吞吐下降 | 交换机配置、固件与无损网络调优(RoCE PFC/ECN 等)需要一定网络工程投入 |
所以严格说,环网省的不是“网络的钱”,而是“一台交换机的钱”——八千多,一次性。值不值,要看这八千多挡住的是多少麻烦:后面几节讲的就是这些麻烦。
真正拉开差距的是扩展性:四台环网是一锤子买卖——八个口全部用完,第五台只能推翻重来;交换机方案从 4 台加到 8 台,只要端口还有余额,就是多插几根线的事。
本地部署:“能跑”和“跑得顺”是两回事
先看两机实测:单跳带宽上,直连和交换机几乎持平。NCCL 带宽——两台 QSFP 直连约 21.77 GB/s(理论值 25 GB/s 的 87%),经交换机约 22.14 GB/s(89%)。差距不到 2%,基本可以当作噪声。也就是说,只要通信只发生在相邻节点之间,环网并不吃亏。
那四台场景的麻烦在哪?不在“一根线的带宽”,而在“非相邻节点怎么说上话”。
环网里,节点 A 和 C 之间没有直连,流量只能经 B 或 D 中转:A→B→C 也好,A→D→C 也好,都要在一台机器上“先收进来、再发出去”。中转不是免费的——B 的两个口既要服务自己的流量,又要替别人过路,同一段 200G 链路被两种需求分着用,A↔C 的有效吞吐会明显低于 200G。整环只有四条 200G 链路,却要装下四台机器之间所有的两两通信;而交换机方案里,任意一对节点都有一条独占的 200G 上行可用。
这里有一条比论坛帖子更硬的边界:NVIDIA 官方支持的拓扑只有三种——两机直连、三机环网、四机配 200G 以太交换机。四机无交换机环网属于社区自建路线,需要自定义 NCCL 构建和拓扑规划,官方不背书,也扩不到第五台。论坛里的结论同样直接:星型/交换机拓扑给每台 Spark 一条独立的 200G 路径;环网给非相邻流量加跳数、抢带宽,相邻节点省下的那点延迟盖不过这笔账。
软件层面还有个坑,很多初级销售不会主动提,但部署时一定会撞上:
环网要跑好,NCCL 的逻辑 ring 必须和物理 ring 对齐。NCCL 默认的 ring 顺序由 rank 编号决定——如果 0→1→2→3 的通信环和实际网线连接的物理邻居不一致,每一次 all-reduce 都会在错误的链路上绕行,带宽和延迟双双劣化。
社区的开源方案(如基于 NCCL 网卡/拓扑插件自己构建的 Mesh 方案)做了大量拓扑感知和子网匹配工作,来适配这种“无交换机直连”场景。这本身就说明:环网不是插上线就完事,它需要额外的软件层去“理解”物理拓扑,这份活儿通常落在集成商头上。
交换机方案里,NCCL 面对的是一个抽象后的 fabric,拓扑对集合通信基本透明,ring/tree 等图可以自由选择——不需要为了让软件迁就布线而反复调 rank 顺序,加机器、改拓扑也不用重排通信环。
一张表看懂全部差异
| 维度 | 四台环网 | 四台 + 200G 交换机 |
|---|---|---|
| 交换机成本 | ¥0 | ¥8,000–8,700(MikroTik 级)/¥53,000+(Quantum 级,IB 口,Spark 接不上,仅作对照) |
| 线缆 / 光模块 | ¥3,290–5,340(4 根 DAC) | ¥3,290–5,340(同为 4 根) |
| 四机网络总投入 | 约 ¥3,290–5,340 | 约 ¥12,000–13,000 |
| NCCL 点对点带宽(两机实测) | ~21.8 GB/s(直连) | ~22.1 GB/s(交换) |
| 非相邻节点 | 无直连,须经邻居中转 | 一跳直达,不占第三方端口 |
| 拓扑灵活性 | 固定环,rank 顺序须匹配物理 | 任意 peer 可达,图自由选 |
| 加第 5 台 | 拓扑失效,必须改架构 | 端口有余额即可加线;4 口机型需分线 |
| 部署复杂度 | 布线最简单,但要自定义 NCCL 与拓扑规划 | 配置有学习曲线,管理标准化 |
| 适用场景 | 固定 3–4 台、不再扩容、能自己啃软件 | 4 台以上、策略可能变 |
给客户的一句话建议
四台 DGX Spark 用环网,“省一台交换机”是真的;“省钱”要看你把工程师的时间算不算钱。
它真正适合的,是那种客户:“我很确定很长一段时间就是这四台,拓扑不变,我也愿意花时间调软件,让 NCCL 迁就布线,并且接受这条路线没有官方支持。”
而只要客户对下面任何一条有要求——
- 以后可能加到六台、八台;
- 中途换一种并行策略;
- 部署时少折腾 rank 和子网,出了问题有人兜底。
那台交换机加上线材,一万二三的投入;买到的不只是几个端口,是任意两两直达的“拓扑自由”,也是运维的下限。
四台,是环网的经济性窗口,也是它的能力边界。
把这句话讲清楚,比替客户“省”一台交换机更有价值。
| 随身话术卡· 四台 Spark 网络方案(可直接照着讲) |
|---|
· 每台 Spark 只有 2 个 200G 以太口;四台连成环,两个口全被邻居占满,没有空口留给管理网。 · 环网省的就是那台 ¥8,000–8,700 的交换机;四根线两边都得买(¥3,290–5,340),省下的是整台交换机,不是“网络不要钱”。 · 单跳带宽:直连 21.77 GB/s、经交换机 22.14 GB/s,几乎没差;环网的亏在非相邻流量和扩容。 · 最硬的一条:四机无交换机环网不在 NVIDIA 官方支持清单里,八个口也用满,第五台只能推倒重来。 |
JOTO 企业落地观察
- 对企业部署意味着:四台 Spark 环网方案虽具短期成本优势,但其拓扑刚性将显著抬高后续智能体工程迭代门槛——任意模型并行策略变更(如从 Ring-AllReduce 切换至 Hierarchical AllReduce)均需重新校准物理-逻辑拓扑映射,无法通过配置热更新完成。
- 这类系统的取舍在于:是否将“网络可演进性”列为基础设施核心指标。环网将网络层锁定为不可变资产,而交换机方案使网络成为可编程底座,支撑 RAG 知识工程中动态数据分片、跨节点向量检索等弹性负载模式。
- 对 AI 安全治理而言,环网缺失独立管理网接口构成隐性风险:所有运维通道(如固件升级、日志采集、安全审计)被迫复用训练流量平面,无法实现控制面与数据面隔离,违反零信任网络分段基本原则。
- 在 FDE 驻场共创场景中,环网方案将 NCCL 拓扑调优责任完全转移至客户侧工程师,而交换机方案因具备标准 RoCE 无损网络能力,可由 FDE 直接交付开箱即用的通信基线,缩短客户从硬件上架到首个分布式训练任务跑通的周期。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们