AI会议转写真正的难点,不是识别内容而是认出谁在说话
Nvidia 发布 Nemotron 3 Diarization 模型,专注说话人分离(最多8人、支持实时),参数约1亿、免费开放。其核心价值在于将“谁在什么时候说话”从语音识别中解耦,但不解决“这个人是谁”的身份映射问题。DER 错误率14.7%,但实际效果受人数、噪声、混响影响显著;缓冲时长与准确率存在明确取舍。
会议转写的真正瓶颈是说话人分离
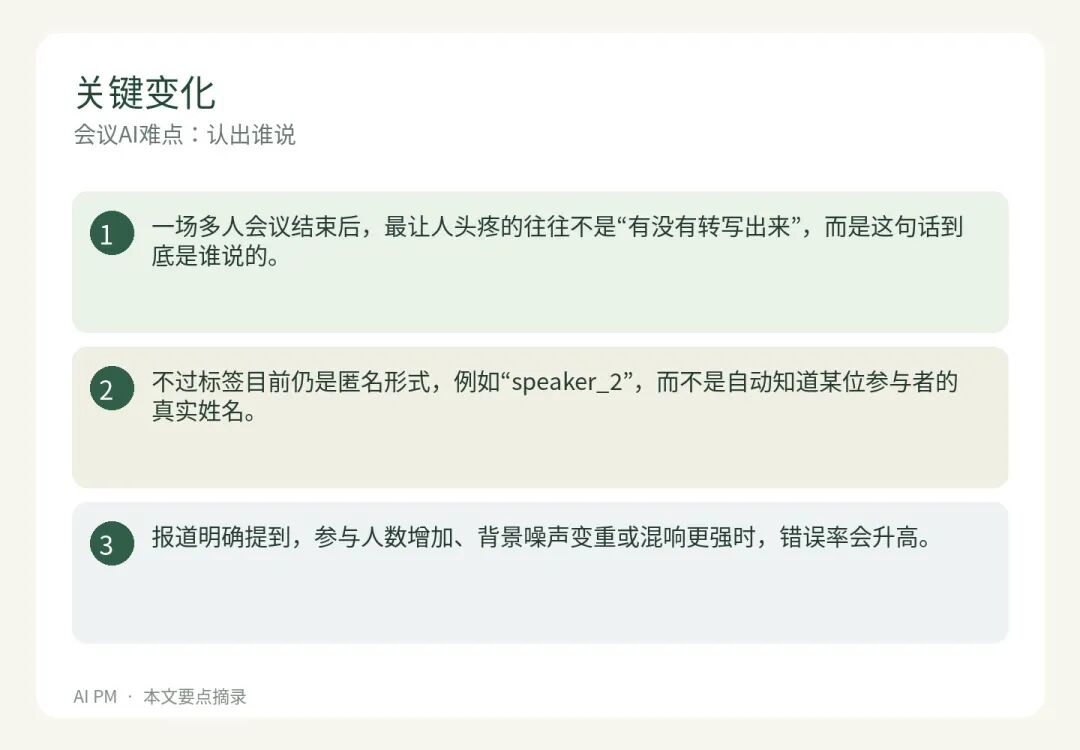
一场多人会议结束后,最让人头疼的往往不是“有没有转写出来”,而是这句话到底是谁说的。
两个人同时开口、有人临时加入、会议室有回声,都会让一份逐字稿失去实际价值。没有说话人信息,产品经理很难整理决策,销售很难回看客户异议,研究团队也很难把访谈内容准确归到不同受访者名下。
Nemotron 3 Diarization 的定位与能力
9月27日,The Decoder 报道 Nvidia 发布了 Nemotron 3 Diarization。它解决的不是通用语音识别,而是说话人分离,也就是判断一段音频中“什么时候是谁在说话”。按照报道,这个模型约有1亿参数,权重免费开放,可以区分最多8位说话人,也能识别多人同时说话。它既支持录音,也支持实时音频。
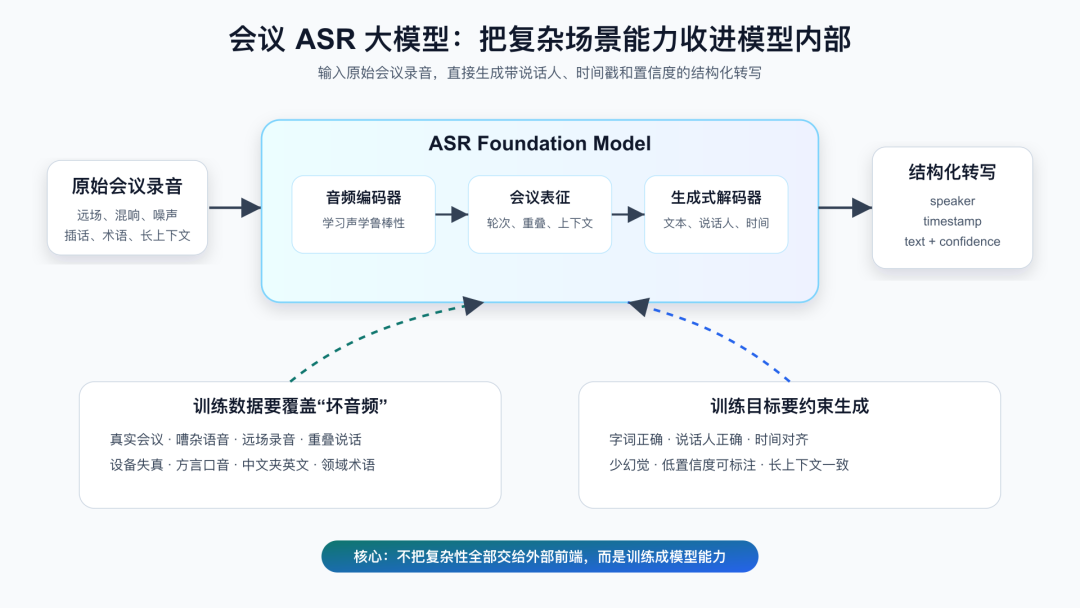
这项变化值得关注的地方,在于它把“会议转写”拆成了两个环节:先判断说话人和时间,再把语音内容转成文字。报道举例称,如果和 Parakeet 这类语音识别系统配合,就能生成带说话人标签的转写稿。不过标签目前仍是匿名形式,例如“speaker_2”,而不是自动知道某位参与者的真实姓名。
说话人分离 ≠ 身份识别
这一区别很关键。说话人分离回答的是“谁在什么时候说话”,身份识别回答的才是“这个人是谁”。前者可以成为会议纪要、访谈整理和客服质检的基础,后者还需要结合参会名单、声纹、登录信息或人工确认。把匿名标签直接写成真实姓名,会让一个看起来很完整的会议纪要埋下更大的错误。
性能指标需回归真实场景
从公开报道披露的测试结果看,Nemotron 3 Diarization 在 VoiceArena Diarization Benchmark v1 上的 DER 为14.7%,排名第一。DER 可以理解为说话人分离错误率,评测会把重叠说话计算进去,甚至会把说话人切换时很短的时间错位计为错误。报道还称,它领先于下一名系统的19.3%,并且相较上一代 Streaming Sortformer,在8个测试场景、使用1.04秒缓冲时,平均错误率降低41%。
这些数字说明了模型在特定基准和测试设置下的表现,但它们不等于任何会议场景都能达到同样效果。报道明确提到,参与人数增加、背景噪声变重或混响更强时,错误率会升高。对实际产品来说,这些条件比榜单名次更值得放进需求评审表。
缓冲时长决定产品取舍
另一个直接影响体验的参数是音频缓冲。报道显示,缓冲可以在4个等级之间设置,从30.4秒降到0.32秒。缓冲更短,通常意味着更低延迟,但准确度也会下降。
这其实是一个很典型的产品取舍:实时字幕、直播纪要和会议提醒需要尽快给出结果,可能愿意接受更多修正;录音归档、访谈研究和法务复核则更重视分段稳定,愿意等待更久。模型本身提供了不同缓冲档位,产品就需要根据场景选择,而不是简单地把“实时”当成唯一目标。
完整工作流中的责任边界
如果把它放到一条完整工作流里,可以这样理解:音频输入先交给说话人分离模块,得到按时间切分的匿名说话人标签;语音识别系统再把每一段转换成文字;最后由会议产品负责合并时间轴、生成纪要,并让用户修正“speaker_1”对应的实际参会者。每一步解决的问题不同,任何一步出错,最终文档都可能看起来流畅却归因错误。
因此,AI 产品经理评估这类模型时,至少要问四个问题。第一,产品更在意低延迟,还是更在意说话人边界准确?第二,典型场景有几位参与者,重叠发言是否常见?第三,输入是近距离麦克风,还是远场会议室录音?第四,匿名标签由谁确认并映射到真实身份?
第四个问题尤其容易被忽略。说话人分离做得再好,也只是提供了一组时间片段和匿名标签。身份映射、错分修正、多人同时发言时的展示方式,仍然属于产品设计和人工校验问题。模型能力的提升,未必会自动变成用户感知到的体验提升。
落地价值取决于结构化能力
对个人用户来说,这类模型最现实的价值,是让长录音不再只有一整段文字,而是多了一层可检索的结构:谁提出了问题,谁给出了回应,哪些结论发生在多人讨论之后。对团队产品来说,真正的竞争点可能不只是“转写更准”,而是能否把说话人、时间、原文和行动项连成一个可修改、可追溯的记录。
判断一款会议 AI 是否值得接入时,可以先看三个指标:在自己的典型录音中,重叠说话和背景噪声下的分段表现;实时模式下可接受的延迟;以及用户修正说话人标签的成本。公开基准适合帮助我们发现方向,真实工作流才决定产品是否值得采用。
如果你正在设计会议纪要、访谈分析或客服质检产品,最先要明确的问题不是“模型能不能识别8个人”,而是“我们的用户愿意为更快的结果接受多少次人工修正”。这通常比一个漂亮的榜单数字更接近最终价值。
JOTO 企业落地观察
- 说话人分离能力的成熟,使企业构建 RAG 知识工程时可更精细地锚定原始对话片段——例如将“销售A提出的异议”与“技术B的回应”分别向量化,而非混入同一文本块,从而提升问答溯源准确性。
- 当会议系统将说话人标签作为结构化元数据输出,企业智能体工程可基于此设计角色感知的摘要逻辑(如仅提取决策者发言生成纪要),但需同步建立人工映射机制,避免依赖模型直接绑定真实身份。
- 该模型未解决身份确认问题,意味着企业在部署会议智能体时,必须在应用层设计可信的身份绑定路径(如对接会议系统登录态、预置参会名单、支持声纹备案),否则匿名标签将导致知识归因失效。
- 缓冲时长与准确率的权衡,对企业 FDE 驻场共创提出新要求:需联合客户共同定义“可接受延迟”阈值,并据此配置模型参数与前端交互逻辑,而非默认启用最低延迟档位。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们