给大模型装上“一双耳朵”:小米开源空间音频理解大模型 MiDashengLM-Spatial
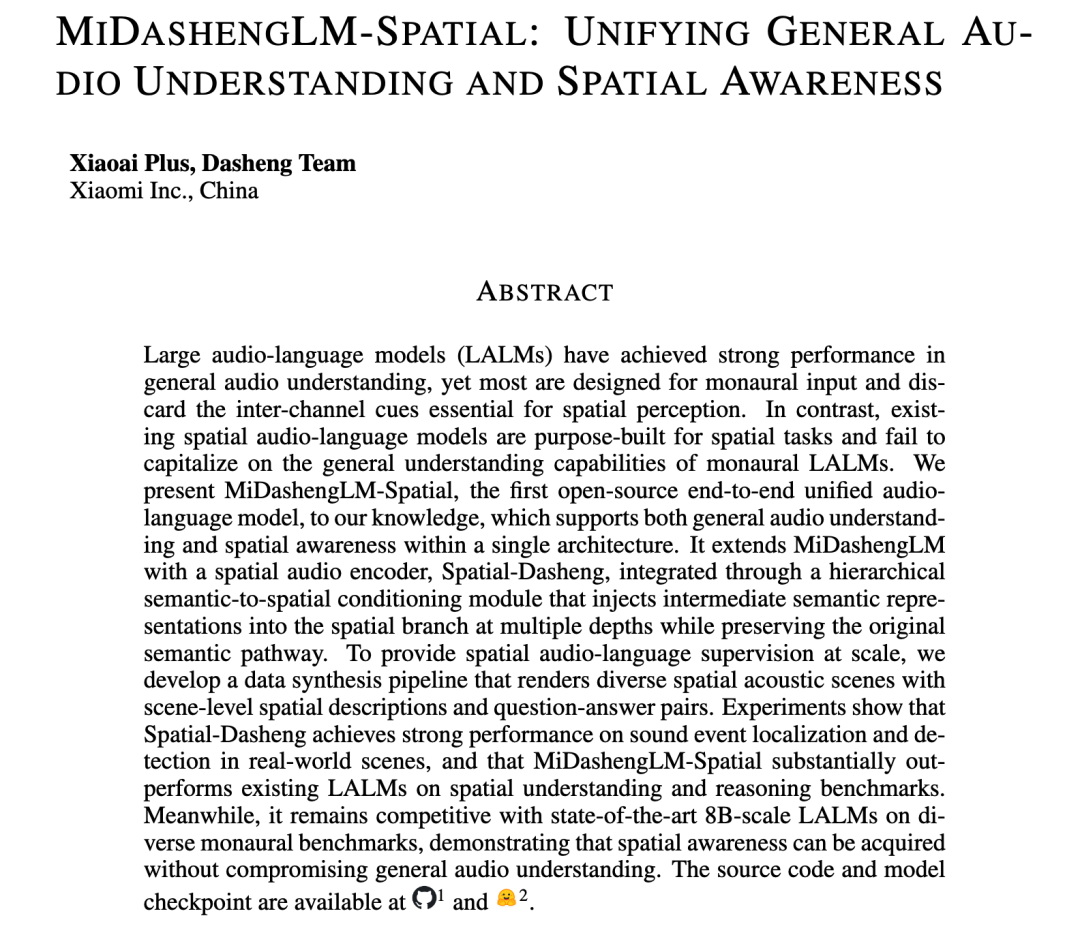
小米开源 MiDashengLM-Spatial,业界首个端到端空间音频理解大模型。该模型以 MiDashengLM-7B 为基座,采用双分支音频编码器架构,在保留通用音频理解能力的同时,新增空间感知与推理能力,支持声源定位、轨迹追踪、相对位置判断等任务。模型已开源权重与代码,Apache 2.0 许可,将应用于智能家居、汽车座舱等场景。
人类的空间听觉与机器的感知瓶颈
想象你正穿行在嘈杂的街道上,忽然有人喊你的名字。不必回头,你就可以本能地判断出声音来自哪个方向,还能大致估计出对方离你有多远,然后顺势转身,朝那个方向寻去。
人类听到的并不仅仅是“什么声音”,还包括“声音来自哪里”以及“声源与我处于怎样的空间关系”。双耳接收到的相位差(Interaural Phase Difference, IPD)和响度差(Interaural Level Difference, ILD),以及声波经过头部和耳廓反射、衍射后产生的细微变化,共同帮助我们感知声音的方向、距离和运动状态。
然而,对于机器而言,理解声音背后的空间信息往往受到物理条件的制约,例如麦克风的数量、布局方式和设备形态等。因此,相较于识别语义内容,机器要准确感知声源的位置、距离和运动状态,无疑更具挑战性。
从“一只耳朵”到“一双耳朵”:Dasheng 系列的技术演进
近年来,大语言模型(Large Language Model, LLM)在语音、图像等多模态领域快速发展,空间智能也成为人工智能的重要方向。空间智能,是机器感知、理解和推理三维物理世界的能力,也是实现全场景智能生态的重要基础,为小米“人车家全生态”战略提供了重要技术支撑。但现有主流多模态 LLM 大多只有“一只耳朵”,故无空间听觉能力。
过去两年,小米先后发布并开源了声音基座模型 Xiaomi Dasheng(https://github.com/xiaomi/dasheng)及声音理解大模型 MiDashengLM-7B(https://github.com/xiaomi-research/dasheng-lm)。相关技术已在小米智能家居、汽车座舱等场景实现超过 30 项落地应用,能够对语音、环境声音和音乐进行统一感知与理解。
今天,小米带来 Dasheng 系列的重要新成员——MiDashengLM-Spatial。该模型以 MiDashengLM-7B 为基座,进一步为声音理解大模型赋予“一双耳朵”,使其不仅能够听懂声音的内容,还能感知声音来自何处、如何在空间中分布。据我们所知,MiDashengLM-Spatial 是业界首个开源的端到-end空间音频理解大模型,在保留基础音频理解能力的同时,具备空间感知与推理能力,推动音频大模型从“听懂声音”进一步迈向“理解声音所处的空间”。
技术核心:双分支编码器与场景级数据合成
▍双分支音频编码器
当前主流多模态大语言模型在声音、语音和音乐理解方面已展现出优异性能,并在部分基准测试中达到甚至超过人类水平。然而,面对多声道音频,这些模型通常将各声道信号在声道维度上进行简单平均,将其转换为单声道输入,因而缺乏对空间信息的建模能力。
与此同时,多声道音频在格式和声道配置上存在较大差异,相关数据规模也远小于单声道音频。这不仅限制了模型的通用性,也使其难以通过统一的数据扩展实现规模化提升。
基于此,我们最终采用双分支音频编码器方案:利用规模远小于原始 MiDashengLM 音频数据(>100 万小时)的双耳音频数据(~1 万小时),在 MiDashengLM 的基础上扩展空间理解能力,同时保持其通用音频理解性能。
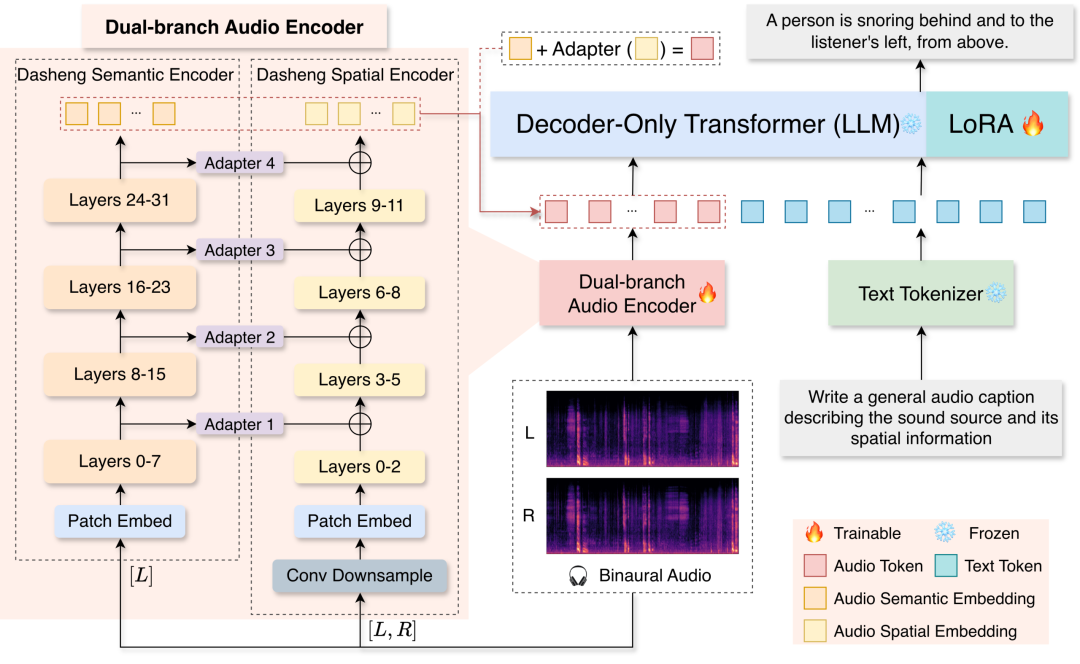
Dasheng Semantic Encoder 完整继承 MiDashengLM 的原有音频编码器,其骨干网络基于 Dasheng-Huge (0.6B);Dasheng Spatial Encoder 则采用轻量化的 Dasheng-Base(86M)架构。两条分支结构同源,参数规模不同,分别负责提取音频的语义信息和空间信息。
两条分支通过跨层语义到空间特征注入 (Hierarchical Semantic-to-Spatial Conditioning) 的方式连接:语义分支不同层级的中间特征经映射后,逐层注入空间分支,与其特征进行融合。该连接方式使空间分支充分利用语义信息,增强对复杂空间声学场景中声源的感知、定位与分离能力;同时,单向注入不改变语义分支原有的信息流,从结构上保持模型通用音频理解能力的稳定性。最终,两条分支分别生成音频语义 Token 和空间 Token,并通过特征映射统一融合为完整的音频 Token,供后续语言模型进行音频理解与空间推理。
▍场景级空间数据合成
空间音频理解不仅需要识别语音、环境声和音乐等基础内容,还需要感知声源的绝对位置、声源之间的相对空间关系,以及声源随时间发生的动态变化。因此,空间与时序信息的联合建模至关重要。
尽管公开音频资源十分丰富,且各类声音已得到系统性收集,但现有数据格式复杂多样,并以单声道音频为主,能够支持空间音频理解的数据仍十分稀缺。为此,我们基于头相关传递函数(Head-Related Transfer Function, HRTF)与虚源法(Image Source Method,ISM)模拟不同室内声学环境,合成时长约 1 分钟的双耳音频场景,包含多个静态或动态声源,如下图所示(俯视图)。
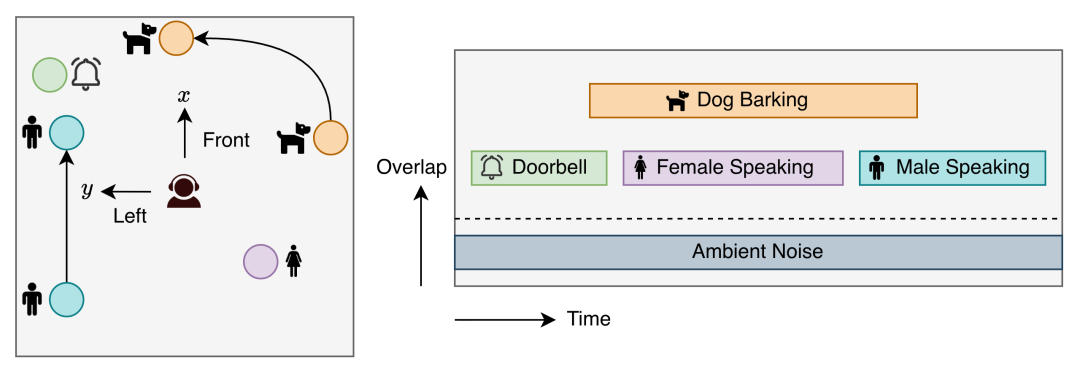
每个声源的语义描述继承自原始单声道数据,其空间位置、运动轨迹和时序变化则由参数化合成过程精确记录。基于这些结构化元数据,我们进一步利用 LLM 生成场景级空间音频描述,构建同时覆盖声音内容、时空关系与动态变化的训练数据。
Spatial Caption: The scene begins with a doorbell ringing in front-left of the listener, overlapping with a dog barking as it moves counter-clockwise from the listener’s front-right and below to directly in front and below. Next, a woman statically positioned behind and to the listener’s right asks, “Who is at the door?” Finally, a man moves from the back-left to the front-left of the listener and says, “I’ll take a look.”
性能验证:空间能力登顶,基础能力不降
▍空间理解:大幅超越主流开闭源模型
MiDashengLM-Spatial 在空间音频理解方面具备显著优势:
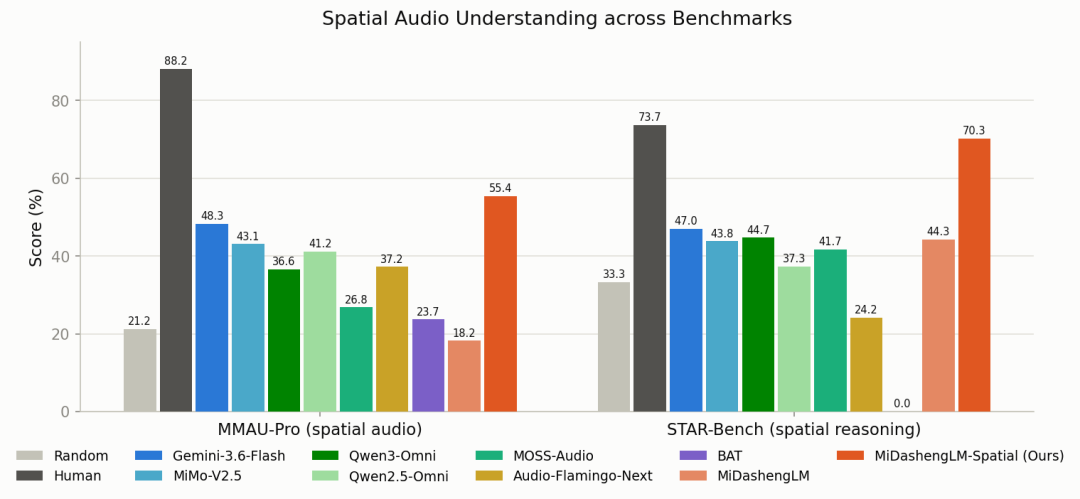
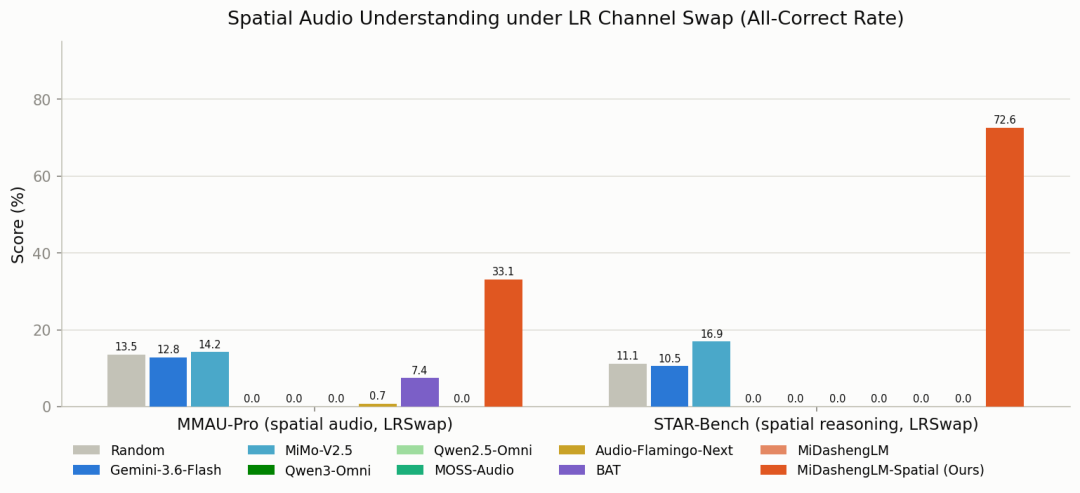
已有研究表明,部分音频理解基准对真实音频能力的要求有限:即使仅依赖语言先验和世界知识,将原始音频替换为高斯噪声,甚至完全屏蔽音频信号,LLM 仍可能取得较高分数。空间音频理解类基准测试也同样发现类似现象,例如,图中所示的单声道音频理解模型(Gemini-3.6-Flash、Qwen3-Omni 和 Moss-Audio)在空间相关任务上的表现均明显高于随机猜测水平。因此我们引入声道轮换(左右声道交换)策略,以进一步检验模型是否真正具备空间听觉能力。
对于双耳音频,声源的左右定位线索通常编码在 IPD 和 ILD 中。若声源位于左侧,交换左右声道后,其空间位置应相应映射到右侧,模型的判断也应随之发生变化。基于该特性,我们选取问答数据中仅涉及左右方向判断的样本,分别评估模型在声道轮换前后的表现,包括预测是否符合空间变化规律,以及交换前后均答对的全正确率(All-Correct Rate)。相比单次问答准确率,该指标能够更有效地检验模型是否真正利用双耳声学线索进行空间理解,而非依赖语言先验或数据偏差作答。
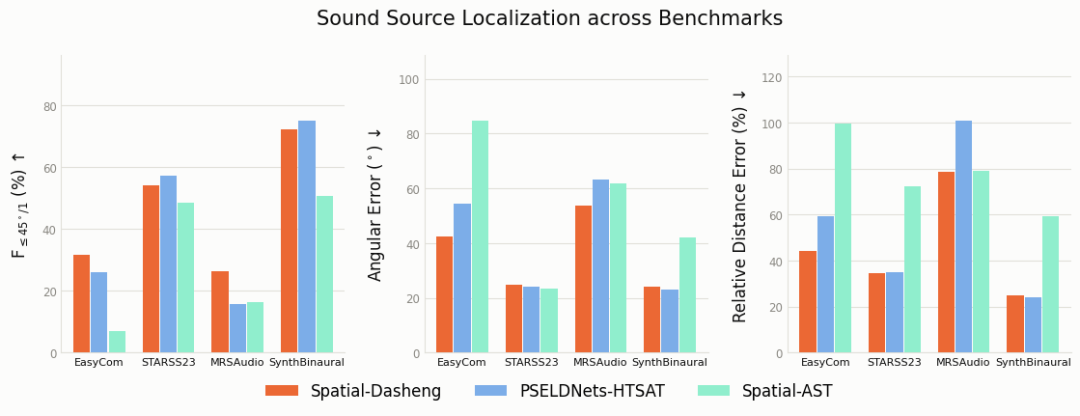
MiDashengLM-Spatial 的空间音频编码器是其空间感知与理解能力的核心。在真实场景声源定位数据集上,该空间音频编码器展现出优异的定位性能,并超越多种专业空间声源定位模型。
▍通用理解:与基座持平,部分基准更优
MiDashengLM-Spatial 在音频问答、语音识别和音频描述等基础音频理解任务上的表现与 MiDashengLM 基本持平,并在部分基准测试中取得更优成绩。
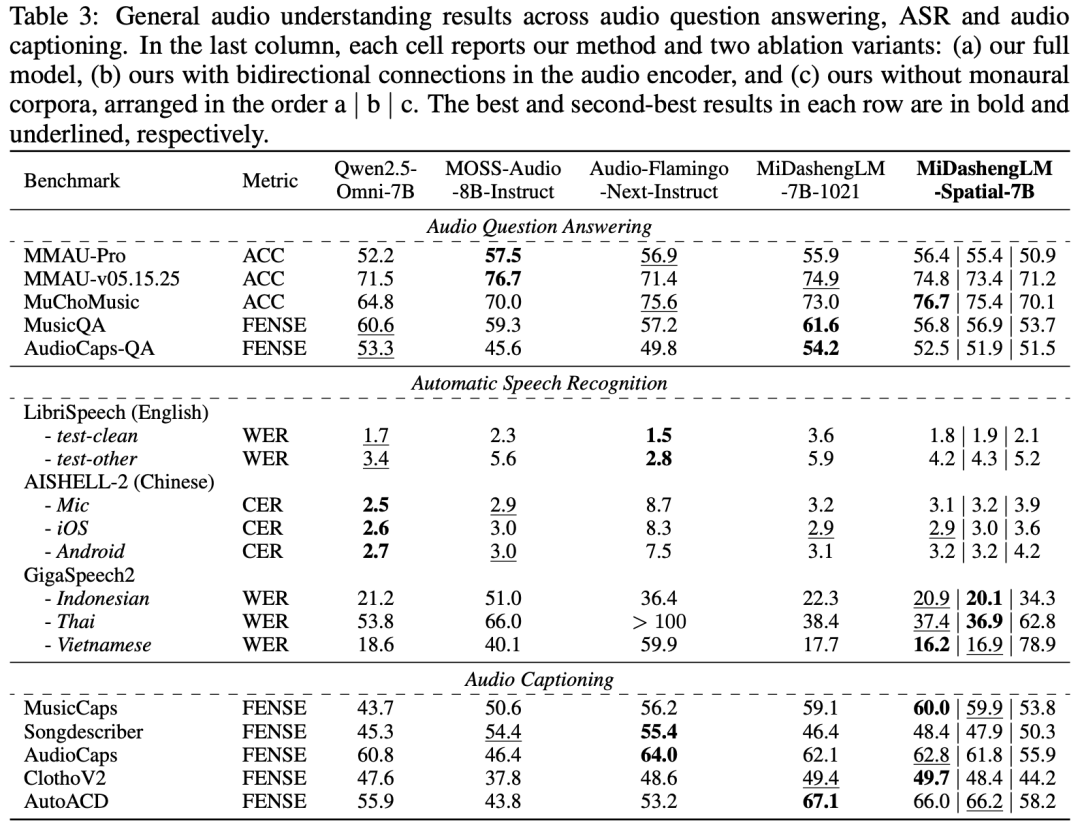
这一优势得益于其双分支音频编码器架构。该架构在模型结构上解耦音频的语义信息与空间信息,在拓展空间理解能力的同时,保持了原有基础的音频理解性能。
在线体验:佩戴耳机亲耳验证空间感知力
以下 4 条双耳音频示例,涵盖方位判断、轨迹追踪、相对位置关系与空间说话人推理,戴上耳机听听模型答得对不对:
Prompt: Which direction are the two boys in : left side : right side : directly ahead
Ground Truth: B: right side
MiDashengLM-Spatial: B: right side
Prompt: What is the motion path of the alarm bell? : From left to right : From right to left : Remains unchanged
Ground Truth: A: From left to right
MiDashengLM-Spatial: A: From left to right
Prompt: Who is more to the left, male or female? : Male : Female : Same position(equally left)
Ground Truth: B: Female
MiDashengLM-Spatial: B: Female
Prompt: Which speaker has children? (A) The mic-holder (B) the person in the right (C) the person in the left
Ground Truth: The mic-holder
MiDashengLM-Spatial: A. The mic-holder
全面开源:开放权重与代码,赋能“人车家全生态”
小米拥有丰富而多元的硬件生态,产品在真实物理空间中与用户持续交互,因此不仅需要“听见”声音,更需要感知并理解声音所处的空间。作为小米“人车家全生态”战略的重要技术支撑,MiDashengLM-Spatial 为 LLM 赋予了空间听觉能力,助力提升模型在复杂用户场景中的理解与泛化能力,开启全场景音频理解的新篇章。
在经典的“鸡尾酒酒会”场景中,模型可以利用不同说话人的空间方位线索,增强复杂声学环境下的语音识别与语义理解能力,提升说话人日志的准确性与鲁棒性;在家庭场景中,模型不仅能够理解家庭成员“说了什么”,还能结合声源的方向与距离判断“用户在哪里”,进而帮助系统调度附近的智能终端就近响应,推动小爱同学从被动接收指令走向主动感知与服务;在自动驾驶场景中,模型可以利用环境声音的方向信息,辅助弥补视觉盲区,及时识别潜在风险,提升车辆主动安全能力;在机器人等场景中,MiDashengLM-Spatial 则进一步补足音频模态的空间智能能力,为机器感知、理解并响应真实三维环境提供新的技术路径。
今天,MiDashengLM-Spatial 正式开源。我们将完整公开模型权重和推理代码,并以 Apache 2.0 许可证发布,诚邀全球开发者、行业伙伴和学术机构将其免费用于商业产品集成或学术研究。同时,该模型也将陆续应用于小米智能家居、汽车座舱等场景,以空间听觉能力进一步提升“人车家全生态”的交互体验。
我们期待与广大开发者和研究者携手,基于 Dasheng 共同推动全场景音频理解的发展。
开源链接:
项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/
技术报告:https://arxiv.org/abs/2610.11156
评估代码(GitHub): https://github.com/xiaomi-research/midashenglm-spatial
模型结构与权重(HuggingFace):https://huggingface.co/mispeech/midashenglm-spatial
JOTO 企业落地观察
- 空间音频理解能力对企业部署多模态智能体具有结构性意义:当终端设备(如车载麦克风阵列、家庭中枢)具备空间声源定位能力,企业可构建“声源-设备-动作”的闭环响应逻辑,无需依赖显式唤醒词即可触发上下文感知服务。
- 双分支编码器架构对 RAG 知识工程提出新要求:空间 Token 与语义 Token 的分离建模意味着需同步维护两类向量索引,企业知识库需支持空间关系元数据(如声源方位、距离、运动矢量)的结构化标注与检索。
- 声道轮换验证法揭示了一类典型 AI 安全治理缺口:若模型仅靠语言先验作答,其空间判断不可信;企业在部署此类模型时,必须将声道鲁棒性测试纳入上线前必检项,否则可能在真实多径反射环境中失效。
- 该模型在“鸡尾酒会”与家庭场景中的应用描述,指向 FDE 驻场共创的关键价值点:空间音频理解高度依赖本地声学环境参数(如房间混响时间、墙面吸声系数),需工程师现场采集校准数据,无法纯云端适配。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们