H-JEPA:面向物理世界的多层级抽象规划世界模型
AMI实验室提出H-JEPA,一种具备多时间尺度与多抽象层级的世界模型架构。它通过分层表征解耦长期目标规划与即时动作控制,在导航与操作任务中提升成功率并降低规划计算量,显著优于单层JEPA及共享潜在空间的分层基线。
Yann LeCun 所在的先进机器智能(AMI)实验室及学术机构的研究人员已开发出 H-JEPA,这是一种世界模型架构,能够利用环境的不同表征,在不同时间尺度上进行规划。
与扁平化 JEPA 世界模型相比,H-JEPA 在导航任务上的准确性更高,同时规划所需的计算量更少。
该研究旨在解决构建能理解并作用于物理世界的 AI 系统所面临的一项挑战。例如,一个在建筑物内导航的机器人必须在决定前往何处的同时,逐时刻控制其运动。H-JEPA 通过跨不同抽象层级进行规划来应对这一挑战,使系统能够在高层级上推理其目的地,并逐步将规划转化为精确的物理动作。
为何 JEPA 世界模型需要层次结构
联合嵌入预测架构 (JEPA)无需预测每个低层级细节即可学习建模世界。与试图预测像素等细粒度细节的生成式模型不同,JEPA 模型将图像或视频等观测数据编码为潜在表征(latent representations),即一组紧凑特征,用以捕捉场景中的信息。这使得 JEPA 模型比生成式模型高效得多,并在导航物理环境或操控物体等无需生成像素的任务中具有高度准确性。
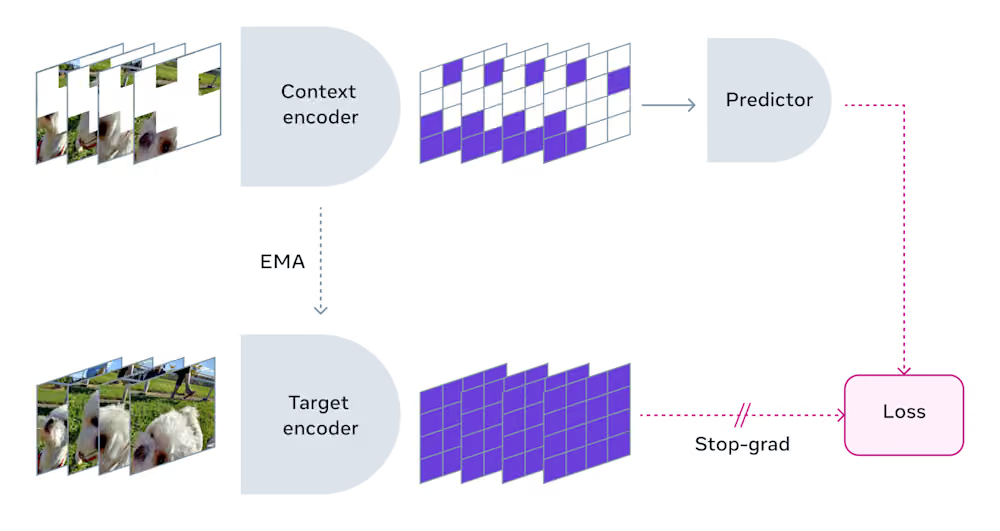
V-JEPA 架构(来源:Meta)
在动作条件化 JEPA 中,模型除接收视觉数据外,还接收动作输入。它可模拟不同动作序列的后果,并将预测结果与目标进行比较。
现有方法面临两个相关问题:预测遥远结果可能需模拟大量微小步骤,从而增加计算成本,并导致微小误差级联放大;与此同时,模型必须在同一表征中既追踪细粒度物理动力学,又评估其向长期目标的进展。
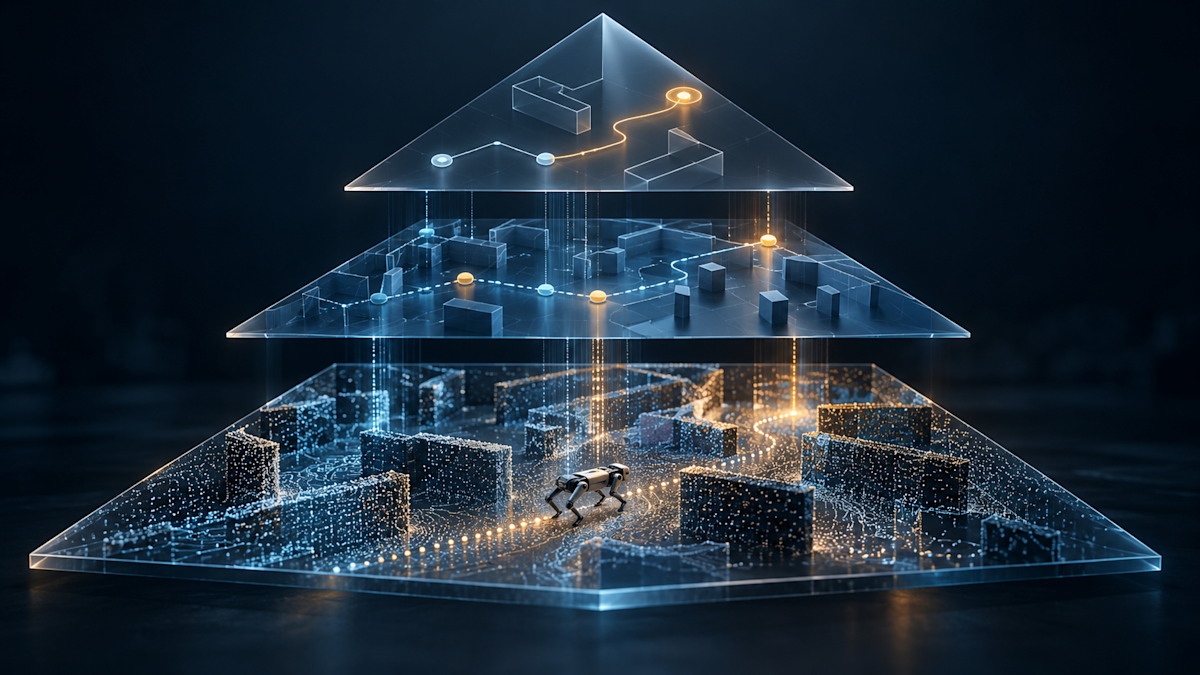
以一只四足机器人穿越迷宫为例:控制其运动时,腿部位置至关重要;但负责选择路径的规划器主要需要的是机器人的位置信息。若在同一潜在表征中同时编码机器人位置及其细粒度物理运动,则会使任务变得复杂且难以学习。
H-JEPA 通过在不同层级学习表征来解决该问题:长程规划可使用与处理即时动作的模型不同的信息。
H-JEPA 如何学习与规划
H-JEPA 在观测序列及其连接动作的序列上进行训练。最低层级对视觉观测进行编码,并基于先前状态和动作预测下一个潜在状态;更高层级则接收下一层级的表征,并预测跨越更长时间间隔的状态转移。
每一层级均拥有各自的状态编码器、动作编码器和预测器。状态编码器在对应时间尺度上表征环境;动作编码器在相应时间间隔内对动作进行汇总;预测器则学习被表征状态的变化方式。
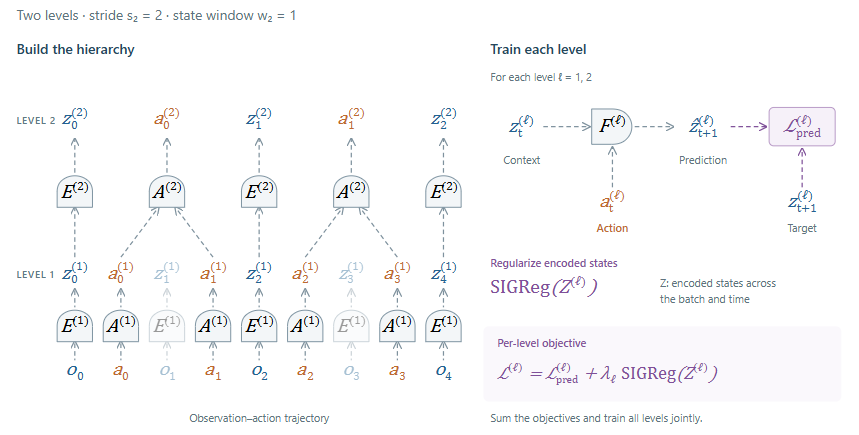
H-JEPA 架构(来源:H-JEPA 项目页面)
研究人员对整个层级结构进行端到端训练。每一层级将其预测的表征与观测到的未来表征进行比对。一种正则化机制防止模型对所有观测生成相同的表征。来自高层级的训练信号亦会流经低层级编码器。
各层级之间的时间间隔是预定义的,但其表征所保留的信息则是习得的。当环境中某些部分以不同速度变化时,高层级可保留那些在较长时间内仍具可预测性的缓慢变化特征,同时舍弃快速变化的细节。
在迷宫示例中,最低层级需要机器人的关节构型以预测其即时运动;而更高层级则可在不保留全部细节的情况下保留机器人的位置信息。
在规划过程中,H-JEPA 在每一层级对当前观测和目标观测进行编码。高层级规划器在其潜在空间中搜索其预测结果更接近目标的动作。
其预测状态成为下一层级的子目标,后者进而搜索达成这些子目标的动作。每一层级逐步细化规划,直至最低层级生成可供执行的基本动作。
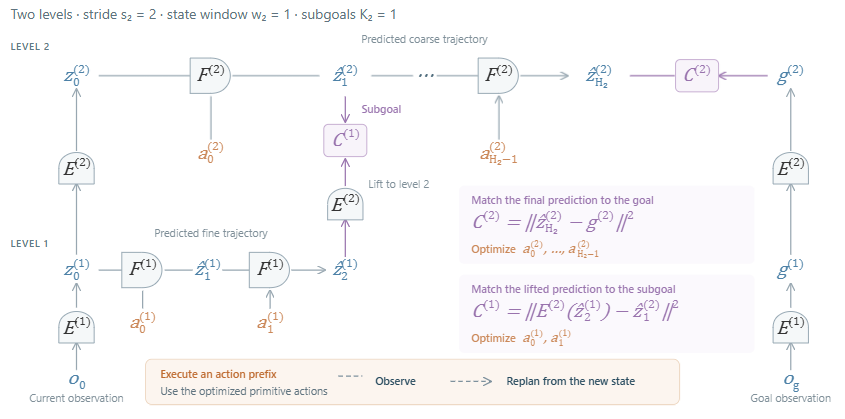
H-JEPA 规划过程(来源:H-JEPA 项目页面)
在迷宫中,顶层可专注于向目的地推进,而较低层级则负责处理更短的转移及物理运动。
在执行一段短动作序列后,系统根据新观测以及其预测轨迹与实际轨迹之间的偏差更新规划。
H-JEPA 的实际应用
研究人员在四个模拟导航与操作环境中对 H-JEPA 进行了评估:FourRoom Distractors、Visual AntMaze、Push-T 和 OGBench Cube。他们将其与单层级 JEPA 模型 LeWM 及另一采用共享潜在空间进行分层规划的世界模型 HWM 进行了对比。
在 FourRoom、AntMaze 和 Cube 中,将层级数增至三级通常提升了成功率,同时降低了规划计算量。在 AntMaze 中,学习独立表征的优势最为显著:三级 H-JEPA 的成功率接近 HWM 的两倍。
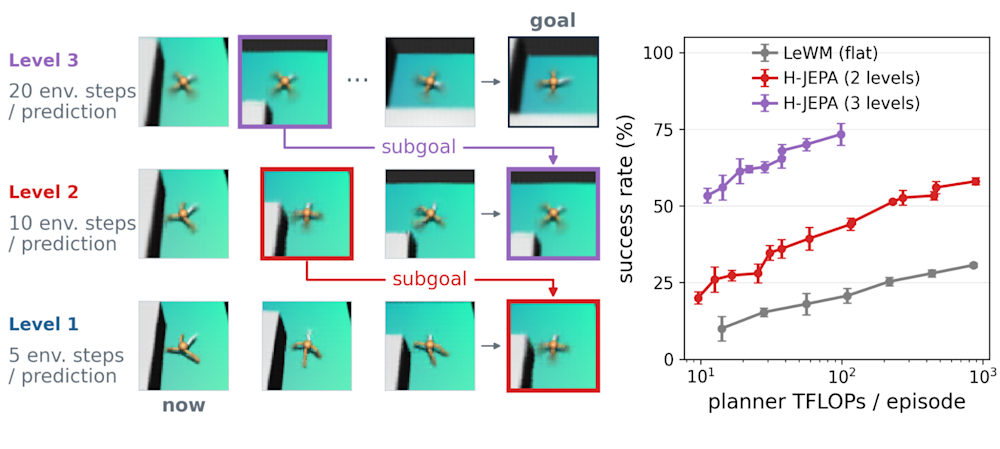
H-JEPA 在行业基准测试中的结果(来源:H-JEPA 项目页面)
在 AntMaze 中,机器人位置信息在高层级表征中仍可恢复,而关于其腿部构型的信息则逐渐消失。高层级表征还能提供沿迷宫走廊至目标距离的更平滑估计,从而为规划器提供更清晰的绕墙导航信号。
研究团队随后在 DROID 数据集上测试了 H-JEPA;该数据集包含真实机器人操作视频,涵盖不同物体、光照与背景。纯预测式训练倾向于保留静态场景细节,却丢失关于运动机器人的重要信息。为此,他们增加了“逆动力学”(inverse dynamics)目标,即预测连接两个观测状态的动作,此举有助于保留与动作相关的信息。H-JEPA 在离线规划保真度方面优于基线模型,且所需规划器计算量更少。
H-JEPA 或适用于机器人导航、仓库自动化及需协调长期目标与精确物理运动的操作系统。然而,该模型并非没有局限:实验表明,更多层级并不总是更好,其优势取决于训练数据的覆盖范围。
研究人员提出将高层级表征与语言相连接,这最终可能使智能体以指令而非目标图像的形式接收目标。目前,H-JEPA 展示了为即时运动与远期目标分别学习不同表征的潜力。
JOTO 企业落地观察
- 对企业部署而言,H-JEPA验证了‘按时间尺度分离表征’可降低实时规划算力需求——在仓库AGV或机械臂调度等工业场景中,企业有望以更低成本部署高鲁棒性自主系统,尤其适用于边缘算力受限但需长程目标对齐的产线环境。
- 对智能体工程而言,H-JEPA明确要求各层级配备独立的状态/动作编码器与预测器,并支持端到端联合训练;这提示工程师需重构传统单流世界模型Pipeline,将‘层级间信息流设计’(如高层梯度反传至低层编码器)纳入核心架构考量,而非仅堆叠模块。
- 对FDE落地而言,该研究指出‘更多层级不总更好’且性能高度依赖训练数据覆盖范围——这意味着企业在构建行业专用世界模型时,必须同步投入高质量、多尺度动作-观测配对数据采集,而非仅依赖仿真泛化;否则分层结构可能加剧分布外失效风险。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们