GitHub Copilot Fusion:模型编排系统以半价成本实现近顶级编码智能体性能
GitHub推出Copilot Fusion——非新模型而是运行时编排引擎,通过动态路由与多模型协同,在独立测试中以51%更低任务成本达成接近Claude Opus 5.5的编码性能,同时缩短40%耗时、减少约50% token用量。
微软子公司及广受欢迎的代码仓库托管服务 GitHub 正推出一套系统,用于决定应由哪些AI模型来处理软件开发任务——据独立测试显示,该系统在成本约为领先编程智能体(coding agent)一半的情况下,性能可接近后者。
在 10月28日举行的GitHub Universe大会上,该公司推出了全新的GitHub Copilot Fusion系统,该系统可在不同模型之间路由请求,并在单个任务内协调各模型工作。
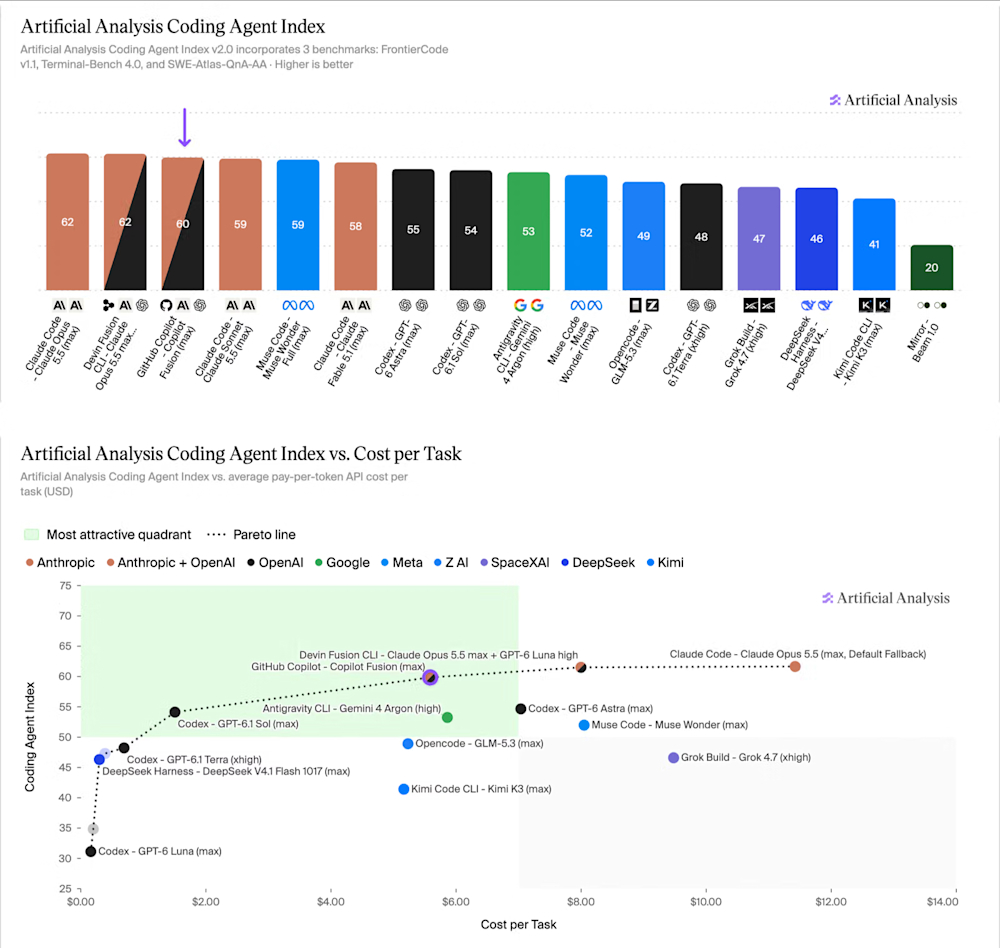
在 人工智能分析公司(Artificial Analysis)于10月28日发布的测试报告中,Fusion Max平均每项任务花费5.59美元,而Claude Code在Anthropic公司Claude Opus 5.5模型的Max设置下运行时,每项任务平均花费11.42美元——降幅约为51%;与此同时,其在该公司“编程智能体指数”(Coding Agent Index)上的得分仅比后者低2分。
该结果为GitHub提供了外部测量依据,以支撑其主张:即智能模型选择可使昂贵的AI辅助开发更具经济性。
GitHub 还表示 Fusion Max完成这些基准测试任务所用时间,比Claude Code配置缩短约40%。
微软首席执行官萨提亚·纳德拉(Satya Nadella)曾宣传最高可达77%的成本节约潜力,但这一更高数值源自一项独立的、由公司内部报告的评估,而非人工智能分析公司(Artificial Analysis)所测得的平均值。上述各项主张共同将任务层级的成本(而非任一基础模型的价格)置于GitHub面向软件团队推广的核心位置。
在接受VentureBeat采访时, GitHub首席产品官马里奥·罗德里格斯(Mario Rodriguez) 表示,Fusion旨在减轻模型选择负担,同时提升已完成工作的经济效益。这一区别对正在评估较低AI推理成本是否能转化为更少整体工程投入的企业客户而言至关重要。
Fusion是一种编排引擎,而非另一款AI模型
Fusion评估涉及推理、代码生成、调试和工具使用的任务,然后决定是将请求发送给单一模型,还是协调多个模型协同工作。它整合了GitHub早期研究预览项目Project HydraFusion所开发的能力及其自动模型选择功能。
“它不是一款模型,而是在运行时起作用的编排引擎,”罗德里格斯向VentureBeat表示。他称,Fusion既可路由单个请求,也可为完成某项任务而编排多次模型调用。
罗德里格斯表示,GitHub还改变了开发者接触该技术的方式。该公司不再将其视为产品线中又一款独立模型,而是作为具备不同工作强度等级的可选模式呈现。“你只需启用它,随后便拥有三种推理强度等级:标准(Standard)、高(High)与极致(Max)。”他说。
标准(Standard) 优先选用通用型模型以满足日常编码需求
高(High) 针对更困难的工作
极致(Max) 面向最复杂的任务。
该系统采用三种执行模式:
单次(Single) 直接将工作发送至一个模型
级联(Cascade) 从成本较低的模型开始,再判断是否接受其输出,抑或将其升级至更强模型
评审(Critique) 由一个模型起草答案,另一个模型进行审查,原始模型再据此修订其响应。这些区别已在 GitHub的发布文档中阐明。
“我们设有一种单一模式,即直接进入我们认为最适合该任务的模型,”罗德里格斯解释道。他还把“评审”模式描述为一种方式,即将更强大的智能引入审查流程,而非在每个阶段都分配最昂贵的模型。他表示,此举目的在于让人们专注于其软件想要实现的目标:“他们无需时刻思考该使用哪款模型。”
人工智能分析公司(Artificial Analysis)在Fusion所用模型池中识别出Anthropic与OpenAI两家公司的模型,包括Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra与GPT-6 Sol。具体使用的模型可能因请求而异,亦取决于组织设定的策略。
独立基准测试所揭示的内容——以及未揭示的内容
人工智能分析公司(Artificial Analysis)通过GitHub Copilot CLI,在其“编程智能体指数”(Coding Agent Index)v2.0版本中测试了Fusion的极致(Max)设置;该指数对三项编码评估赋予同等权重。
图片来源:人工智能分析公司(Artificial Analysis)
Fusion综合得分为60分,而采用Opus 5.5 Max设置的Claude Code得分约为62分。另一竞争性编排系统Devin Fusion在采用Opus 5.5 Max与GPT-6 Luna High组合时,得分为62分,平均每项任务成本为8.00美元。
在成本方面,Fusion平均每项任务5.59美元,明显优于Claude Code(Opus 5.5)的11.42美元及Devin Fusion的8.00美元。人工智能分析公司(Artificial Analysis)还测得Fusion每项任务消耗约720万个token,约为Opus 5.5 Claude Code配置token用量的一半,亦比Devin Fusion低约30%。这表明,节省成本至少部分源于减少模型运算量,而不仅在于使用单价更低的token。
然而,在该指数各组成部分上的表现并不均衡。在Terminal-Bench 4.0测试中,Fusion以71分领先报告中讨论的所有系统。在聚焦于代码仓库变更的编码评估FrontierCode中,Fusion得分为51分,落后于Opus 5.5 Claude Code的56分及Devin Fusion的54分。在SWE-Atlas-QnA-AA代码仓库问答评估中,Fusion得分为57分。换言之,接近的综合得分并不意味着Fusion在所有类型的编码任务中均胜出。
上述均为基准测试成本,并非GitHub新推出的AI积分采购方案下特定企业实际支付金额的公开估算。人工智能分析公司(Artificial Analysis)的文章亦未报告支撑GitHub“耗时缩短40%”主张的每项任务完成时间数据;该比较仍属GitHub自行报告,尽管性能、token用量及成本的测量已获独立验证支持。
更大的77%数值需进一步区分。正如 肯·杨(Ken Yeung)在《人工智能经济》(The AI Economy)中所报道,GitHub自身在DeepSWE基准测试及Copilot智能体框架(agent harness)下的测试显示,Fusion高(High)与极致(Max)设置在任务完成率上,较同类前沿模型配置最高高出8.7分,同时估算成本最多降低77%。
该对比涉及不同的测试条件及报告的最大降幅;不应与Artificial Analysis针对Opus 5.5测得的大约51%平均成本优势相混淆。本文审阅的材料中未提供底层DeepSWE配置及各任务具体结果。
GitHub的商业逻辑基于一项重要区分:在基准测试运行中节省资金,未必等同于降低软件交付的总体成本。团队仍需考虑人工审核、错误、重试、集成,以及代理输出后续所需的任何安全工作。微软CoreAI执行副总裁Jay Parikh在 GitHub Universe发布会中强调了更广泛的目标:“完成的工作,而非更多代码,才是关键产出。”
模型级计费、一项临时折扣及一项新企业选项
Copilot Fusion目前已在GitHub所有Copilot订阅计划中普遍可用,支持VS Code、Copilot应用、Copilot CLI及JetBrains IDE;对其他客户端的支持正在规划中。GitHub表示,用户将按Fusion所调用的每个底层模型的标准费率分别计费。
GitHub还为付费Copilot订阅用户提供一项临时优惠:使用Fusion时,模型费用可享30%折扣。该促销降价与基准测试中测得的任务成本节约是相互独立的。
Rodriguez将Fusion的经济性归因于其路由与编排决策,而非GitHub对高成本请求的补贴。他的解释并未确立GitHub的利润率,亦不保证每一项工作负载的成本均低于手动选择单一模型。
此外,GitHub正为符合条件的GitHub Enterprise Cloud客户提供另一种Copilot采购方式。企业客户无需为每位已获许可的Enterprise用户额外购买Copilot订阅;若通过GitHub或微软账户团队采购,则可将Copilot包含在内,并按企业预算计量AI使用量付费。
《 已发布条款 》明确规定:此类用户不享有每人每月的AI积分配额;计量式使用自首次请求起即开始计费。
此项区分并非纯理论问题。即使AI预算耗尽,代码补全与下一次编辑建议功能仍保持可用;但Copilot Chat、代码审查及云端Copilot则需有可用预算方可使用。
现有Copilot Business与Copilot Enterprise订阅方案继续提供,而自助式接入新安排将分阶段上线。GitHub亦列出Copilot Standalone方案,面向无GitHub Enterprise许可证的企业账户用户,定价为每位用户每月10美元。
这些细节厘清了访问权限与计费结构,但本文审阅的材料仍未提供一个实际的企业案例,展示典型开发团队在新安排下每月AI积分消耗情况。采购方需将其实际用量与预算限额同现有按席位计费条款进行比对。
项目、持久化会话及更广泛的用户群体
GitHub正将Copilot从代码建议拓展至开发者可规划工作、委派任务并检查结果的平台。Copilot应用除编程外,亦支持需求规格说明、设计讨论及遥测数据分析。
Copilot Projects 允许用户在多个代码仓库上启动并行的云端代理会话,并通过单一界面跟踪全部会话。
会话连续性 使开发者可在Copilot应用、网站、命令行及VS Code之间自由切换,而不丢失同一云端代理的上下文。
Rodriguez确认该功能支持跨设备持续工作,包括移动端。这对代理在开发者合上笔记本电脑或转向项目其他部分后仍持续工作的团队而言可能至关重要。
Rodriguez还将此次变更定位为一种既向非专业人士开放开发能力、又不限制资深工程师的方式。“这适用于所有人,”他表示。他描述了GitHub的愿景:降低软件创建门槛,同时赋予熟练开发者更高杠杆率,并指出该平台拥有逾2.25亿名开发者的社区。
他还讨论了GitHub努力从代理会话中保留有用信息,并将其注入组织关于技术领域、工作流及开发实践的知识库中。
GitHub正在扩展 Copilot Automations :团队可手动启动代理工作流、设定调度或通过事件触发,随后基于过往结果审阅并批准自动化建议的改进措施。该审批要求确保当工作流提议修改自身指令时,仍保留人工决策环节。
企业级模型管控与代码质量
动态模型路由引发一项治理问题:若系统自动选择供应商,企业能否强制规定允许使用的模型?
GitHub的 Fusion发布说明 称该系统尊重企业及组织层级的模型策略。管理员可查看适用于Fusion的模型集合,单独禁用特定模型以供Fusion使用,并配置默认努力程度。当被问及组织是否能获得所用模型的可见性时,Rodriguez给出了肯定答复;但本次访谈未明确说明每请求级审计细节的精确粒度。
Rodriguez还强调,更多AI驱动的开发活动催生了新的安全与审核需求。GitHub已推出 Max 层级的 Copilot代码审查功能,该层级独立于Fusion Max,另提供Lite与Balanced两种选项。
该公司表示,该新层级在ReviewBench上针对严重问题取得了最高F1分数,尽管其Universe发布会未包含详细分数分解。Rodriguez还介绍了AI辅助安全扫描功能,旨在发现传统静态分析可能遗漏的漏洞。
更多代理需要更多基础设施
GitHub正在扩大支撑上述产品的基础设施。在其 Universe发布会中,该公司称其于2026年新增了160拍字节高速存储、400万CPU核心及每秒50太比特网络容量。
GitHub亦正转向多区域Azure部署,目标于2027年初完成;同时重新设计Git架构,实现计算与存储分离,并降低协调开销。
Rodriguez将该项工作与代理引发的代码仓库读写量增长联系起来。随着更多自动化会话获取代码、修改文件并提交变更,软件开发基础设施本身必须支持更高并发度的工作负载。
对企业采购方而言,Fusion的吸引力将取决于这些变更是否能在总成本更低的前提下产出更高接受度的软件——而不仅是一次更廉价的基准测试运行。GitHub现已拥有独立证据表明,其模型编排能力可在约一半实测任务成本下,接近领先编码代理的性能水平。更严峻的考验在于:工程团队在计入审核、治理、可靠性及变更部署全部成本后,能否观察到同等程度的提升。
JOTO 企业落地观察
- 对企业部署而言,Fusion将计费单位从‘模型调用’转向‘任务完成’,并引入按预算计量式采购,但未提供典型团队月度AI积分消耗案例,采购方需自行比对实际用量与席位制成本,决策依赖内部用量建模能力。
- 对智能体工程而言,Fusion明确采用Single/Cascade/Critique三种执行模式,尤其Critique模式将强模型限于审查环节而非全程使用,为构建高性价比多阶段智能体流水线提供了可复用的架构范式,且已整合Project HydraFusion研究成果。
- 对AI安全治理而言,Fusion支持企业级模型策略管控(如禁用特定模型),但每请求级模型审计粒度未明确;同时新增Max级代码审查与AI辅助漏洞扫描,表明安全能力正从单点工具向嵌入式、分层级的智能体工作流中演进。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们