技术解读|听懂情绪,回应有性格:语音模型的共情与人设能力
本文详解 Qwen-Audio-3.1-Realtime 模型如何通过融合语义理解、情绪感知、共情策略与人设表达,实现语音交互中的共情响应与角色化表达。方案涵盖结构化标注、策略建模、数据构建、监督微调与强化学习,并在 EchoMind、Stage3-Multi 等四项共情测试及 CharacterEval、Emotion-Cross 等四项人设基准上完成验证。
语音理解:从听懂内容,到理解表达方式
传统的“语音转写—文本理解—回复生成”链路,能够保留用户表达的文字内容,却可能弱化语气、情绪和非语言声学事件。仅依赖转写文本,模型难以区分某些字面相同、实际诉求不同的表达。
我们的方案同时考虑两类信息:
语义信息:用户说了什么,当前话题是什么,与前文存在怎样的关联。
副语言与声学信息:用户如何表达,包括情绪及其强度、语速、哭腔、叹气等声音线索。
这些信息需要结合起来理解,而不是各自独立判断。例如,叹气并不必然意味着悲伤,语速加快也不一定代表焦虑。模型需要依据音频与上下文形成判断,避免仅凭文字或单一声学信号推测用户状态。
策略建模:让共情成为可训练的回应决策
共情回应的重点,是根据用户当下的诉求,选择合适的回应方式。
为此,我们将共情拆解为三类结构化信息:
情绪与声学标注:识别主次情绪、情绪强度及相关声学事件。真实数据通过多模态模型听取音频完成标注,并进行高置信筛选,减少缺乏声学依据的判断。
用户意图标注:区分共情交流、对话控制与功能请求,并进一步识别倾诉、求安慰、求建议、分享喜悦等细分诉求。
回应策略表:结合意图、情绪与声学线索,明确回应侧重、可采用的表达方式,以及应避免的行为。涉及危机场景时,安全要求优先。
同一套策略表贯穿数据生成与强化学习评分,使训练样本中的目标行为与后续优化时的评价标准保持一致。
回应规划:兼顾用户诉求与角色表达
训练样本在最终回复之前包含一段结构化的回应规划,用于组织三类判断。用户表现出了怎样的状态、真正希望得到什么,以及当前角色应当怎样回应。
这一设计将情绪理解、意图识别与表达策略连接起来。模型不仅学习生成一句合适的回复,也学习在不同场景下调整回应侧重:什么时候应该先承接情绪,什么时候可以提出建议,什么时候需要收起玩笑并认真回应。
为控制推理文本长度,数据流水线会对超过约 250 字的推理内容进行压缩,并保留关键情绪依据、用户意图、角色口吻与回应边界。这里描述的是训练数据中的回应规划机制,不意味着这些内容需要向用户展示。
人设设计:表达可以变化,底线保持一致
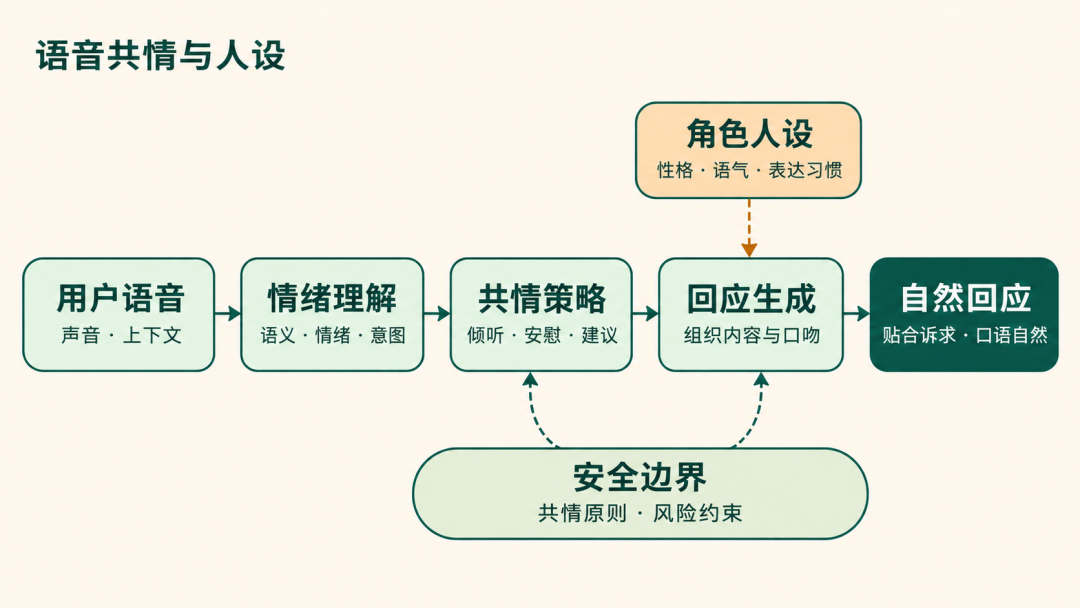
共情决定回应是否合适,人设决定回应以怎样的性格和口吻呈现。
我们维护了一个可注入系统提示词的人设库。例如,阿侃偏机智直率,黛黛带有俏皮与傲娇感,团团温暖积极,黑土则采用嘴硬心软的损友式表达。面对同一段情绪对话,不同角色可以采用各自的表达方式,同时回应用户的实际诉求、遵守相同的安全边界。
设计上采用角色设定与共享规则分层解耦:
角色层定义性格、语气与表达习惯。
共享规则层统一约束安全边界、语音表达要求与共情原则。
这意味着,角色可以调整表达方式,却不能改变基本行为要求。用户真正难过时,俏皮角色也需要减少调侃;直率角色可以坦诚,但不能以“人设”为理由伤害用户。
数据构建:合成与真实语料互补
训练数据由两条流水线分别构建,再进入统一的后处理流程。
可控合成数据。按照目标情绪与意图分布生成用户画像及单轮、多轮对话,再通过 TTS 合成带有相应表达特征的语音。叹气、哭腔等事件通过标签控制,同一会话保持音色一致,并校验合成文本与原始内容的一致性。
真实对话数据。先通过文本模型完成意图粗筛,再由多模态模型听取音频,精标情绪与声学信息,将音频标注资源集中到相关样本。
两类数据随后经过回应规划生成、人设分配、回复续写、推理压缩与训练格式转换。合成数据提供可控覆盖,真实数据则补充生活化表达与更复杂的语音条件。
两阶段训练:建立基础行为,再优化回应质量
第一阶段采用监督微调(SFT),让模型学习音频条件下的共情与人设表达。输入包含用户语音和角色设定,监督目标包含结构化回应规划与最终回复,帮助模型建立从感知用户状态到选择表达方式的基本路径。
第二阶段采用 GRPO 强化学习,进一步优化回应质量。模型针对同一场景生成多条候选回复,裁判模型依据动态评分表逐条评价,推动策略向更符合要求的方向更新。
评分表由策略表与当前轮次的情绪、声学及意图标注共同生成,重点检查:
是否承接了用户情绪与核心诉求;
是否合理利用了相关声音线索;
是否采用了合适的回应策略,并避开禁忌行为;
是否口语自然、适合语音播报;
是否在保持人设的同时遵守安全要求。
两个阶段沿用一致的行为目标。SFT 建立基本的回应方式,GRPO 则根据具体场景对候选回复评分,进一步优化回应的贴切度、自然度和稳定性。
共情评测:多项测试集联合验证
本次共情评测汇总 EchoMind、内研合成测试集Stage3-Multi、Stage3-Single 以及内研录制测试集 Test-Human 四项测试集的结果,对比 gpt-realtime-2-low、seeduplex-1.2.6.1 和 Qwen-Audio-3.1-Realtime-Plus。下表按测试集展示得分,用于观察模型在不同测试集上的共情表现。
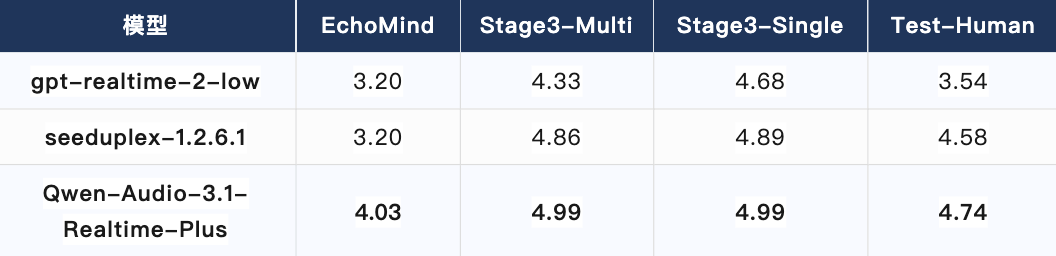
Qwen-Audio-3.1-Realtime-Plus 在四项共情测试中均取得最高分。其中,Stage3-Multi 与 Stage3-Single 均为 4.99,Test-Human 为 4.74,展现了模型在多项共情测试中的优势。
在 EchoMind 上,Plus 得分为 4.03,比 seeduplex 高出 0.33 分,比 gpt-realtime-2-low 高出 0.83 分。这一成绩体现了模型的共情优势,同时在该基准上仍有进一步提升的空间。
人设评测:多项基准检验角色表达
人设评测汇总 PersonaSession 下的 CharacterEval、Emotion-Cross、Advancement-100 与 RMT-Bench 四项基准,比较三个模型在不同人设测试上的表现。各项结果分别展示,不将不同基准的分数直接合并为单一结论。
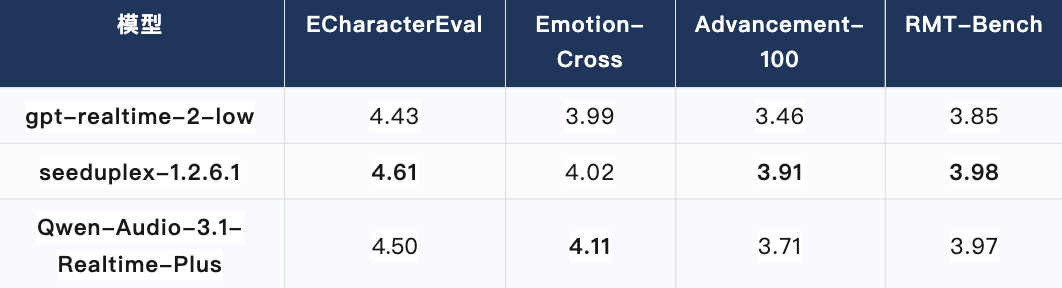
Plus 在 Emotion-Cross 上取得最高分,四项人设得分均高于 gpt-realtime-2-low。其中,Emotion-Cross 得分为 4.11,高于 seeduplex 的 4.02 和 gpt-realtime-2-low 的 3.99,是本次人设评测中的突出表现。
人设能力的提升仍不均衡。在 CharacterEval 和 Advancement-100 上,Plus 分别为 4.50 和 3.71,低于 seeduplex 的 4.61 和 3.91;在 RMT-Bench 上,两者接近,Plus 为 3.97,seeduplex 为 3.98。这些差距也是后续打磨角色表达能力的重点。
结语
语音陪伴的自然感,来自模型能否结合声音和上下文理解用户此刻的诉求,再选择合适的回应方式。共情策略让模型知道何时先倾听、何时给出建议,人设则让不同角色能够用各自的方式作出回应。
从标注、数据构建到 SFT 和 GRPO,这套方案将共情策略与角色表达落实到训练样本和评分标准中,再通过公开、内部及跨人设评测观察模型在不同场景中的表现。我们希望,用户换一个角色,能听出表达上的区别,也能获得同样符合共情原则与安全要求的回应。
JOTO 企业落地观察
- 语音智能体在客服、陪伴、教育等场景落地时,共情能力并非“锦上添花”,而是影响用户信任与留存的核心指标;企业需将情绪标注、意图分层、安全边界等要素纳入 RAG 知识工程的元数据体系,而非仅依赖大模型隐式学习。
- 人设库的分层解耦设计(角色层 + 共享规则层)为企业提供了可复用的智能体治理框架:角色可快速迭代适配业务线,而合规、安全、品牌语调等共享规则可集中管控、统一升级,降低 FDE 驻场共创中的策略对齐成本。
- GRPO 强化学习所依赖的动态评分表,本质是将企业服务 SOP 显性编码为可执行、可评测的 AI 行为准则;这对金融、医疗等强监管行业尤为关键——模型不是“学会共情”,而是“被训练为始终遵循某套已验证的服务逻辑”。
- 合成数据与真实数据双流水线构建方式,揭示了企业语音智能体工程的关键矛盾:生活化表达必须来自真实语料,但长尾风险与冷启动覆盖必须依赖可控合成。企业需建立“合成-标注-回测-反哺”的闭环,而非将二者割裂为训练与评测两个阶段。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们