MiniMax发布M3.1 Flash:低成本企业智能体模型,性能逼近DeepSeek但幻觉率达93%
MiniMax新推M3.1 Flash模型,在Automation-Bench等企业工作流基准上超越DeepSeek V4.1 Flash-1017,单任务成本仅0.22美元,但AA-Omniscience测试显示其幻觉率高达93%,凸显高性价比与低可靠性间的典型权衡。
中国人工智能公司 MiniMax已发布M3.1 Flash,这是一款新型人工智能模型,专为处理复杂的企业工作流、软件开发及计算机使用任务而设计,其成本显著低于许多竞争性前沿模型——包括在中国广受欢迎的竞品DeepSeek在高峰时段的成本。
MiniMax表示,其新模型运行速度比前代产品快近3倍,同时将AI智能体的整体使用成本降低了70%。我们将在 VentureBeat的智能体基础设施栈峰会(Agentic Infrastructure Stack Summit) 上深入探讨团队如何削减上下文和Token成本,该峰会将于10月28日在旧金山举行。
但更有趣的证据来自独立测试: Artificial Analysis 在其智能指数(Intelligence Index)上为M3.1 Flash评出 42分,较前代MiniMax M3提升13分,且每项任务评估成本不足前代的一半。
这使得M3.1 Flash与Z.ai的GLM-5.3 Flash持平,略高于Google的Gemini 3.8 Flash,并逼近 DeepSeek V4.1 Flash-1017 ——另一款新型、低成本的中国人工智能模型——其得分为45。
然而,存在一项重要限制:Artificial Analysis还发现,尽管M3.1 Flash正确回答了超过一半的事实性知识问题,但它表现出极高的倾向生成错误答案,而非承认自身不确定性。
这些结果既凸显了低成本中国人工智能模型日益增强的竞争力,也揭示了企业在将此类模型部署于需要高准确性、高可靠性及最低人工监督的任务时必须权衡的取舍。
独立测试表明,MiniMax以更低价格接近DeepSeek
根据 Artificial Analysis的评估,M3.1 Flash在最大推理努力设置下实现智能指数得分为42,而其前代M3为29分。
这代表实测能力出现大幅进步,同时也将完成一项智能指数任务的平均成本从 约0.51美元降至仅0.22美元——降幅近57%。
其最接近的竞争对手包括GLM-5.3 Flash(每项任务约0.28美元,得分为42)、DeepSeek V4.1 Flash-1017(每项任务约0.26美元,得分为45)以及Gemini 3.8 Flash(每项任务约1.24美元,得分为41)。
尽管M3.1 Flash在整体指数上仍落后于Anthropic和OpenAI最先进前沿系统,但其相对强劲的性能与低廉运营成本的结合,使其成为运行需执行大量任务之AI系统企业的理想候选者。
Artificial Analysis发现其在复杂推理方面取得尤为显著的改进。M3.1 Flash在《人类最后一考》(Humanity's Last Exam)中得分为 48%,高于M3的39%,优于GLM-5.3 Flash的40%和DeepSeek V4.1 Flash-1017的43%,并追平Gemini 3.8 Flash。
在物理推理基准测试CritPt上,MiniMax得分从仅4%提升至22%,领先于GLM-5.3 Flash的15%和Gemini 3.8 Flash的18%,仅略逊于DeepSeek的24%。
该新模型在智能指数评估期间使用的输出Token数量也更少——据Artificial Analysis公告,约为1.89亿个,而GLM-5.3 Flash约为3.24亿个,Gemini 3.8 Flash约为3.34亿个。
这一点至关重要,因为开发者需为人工智能模型生成的Token付费,包括完成困难任务所需的中间推理步骤。一款能在生成更少Token的同时达成可比结果的模型,所能带来的节省远超公开API费率差异。
MiniMax聚焦企业自动化、编程与计算机使用
在其 官方公告中,MiniMax强调该模型可在业务软件、编程环境及计算机界面中执行跨应用的长序列操作。
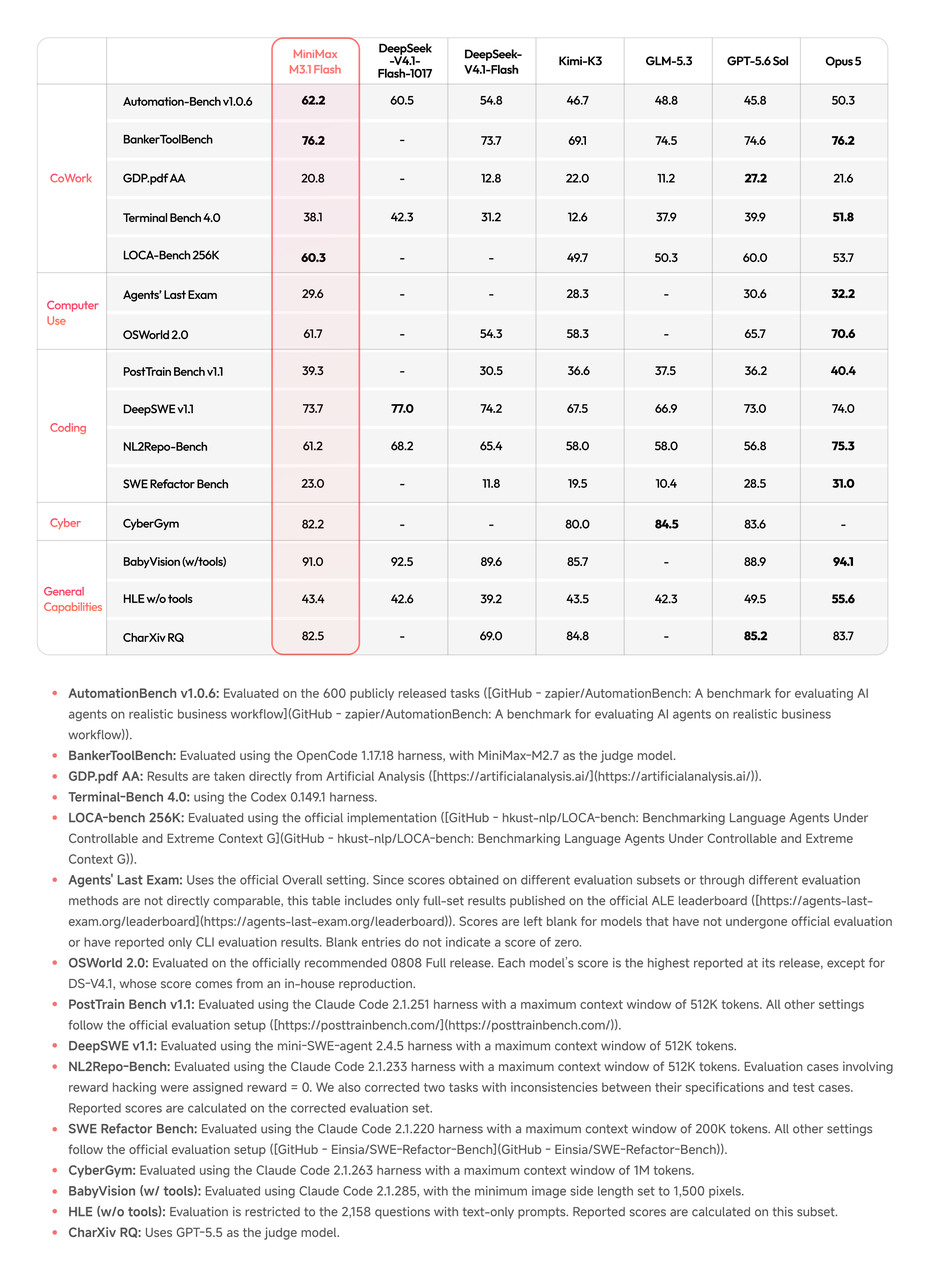
该公司在Automation-Bench v1.0.6(一项针对销售、营销、运营、客户服务、财务及人力资源等业务场景中所用应用程序的企业工作流测试)上报告得分为62.2。
图片来源:MiniMax
该分数略高于DeepSeek V4.1 Flash-1017的60.5分,并大幅超越MiniMax对比中GPT-5.6 Sol与Claude Opus 5的报告结果。
在BankerToolBench(一项评估涉及文档一致性、合规性及工具使用的多步骤金融工作流的基准测试)上,M3.1 Flash得分为76.2,与该公司测试结果中的Claude Opus 5持平。
其编程能力结果同样具备竞争力。MiniMax在DeepSWE v1.1上报告得分为73.7%,而Claude Opus 5为74%,GPT-5.6 Sol为73%,DeepSeek V4.1 Flash-1017为77%。
在计算机使用方面,该模型在OSWorld 2.0上得分为61.7,在《智能体最后一考》(Agents' Last Exam)上得分为29.6,这两项均用于评估人工智能系统操作软件及完成复杂专业任务的能力。
尽管这些数值落后于最强的Anthropic与OpenAI模型,但MiniMax附带的成本对比表明,该公司能以显著更低的任务成本提供其中大部分实际能力。
该公司还在网络安全基准测试CyberGym(聚焦漏洞发现与验证)上报告得分为82.2。
这些均为基准测试结果,而非已记录的生产部署;不同评估设置亦使直接比较不够完美。尽管如此,它们表明低成本模型正日益适用于此前需依赖昂贵得多替代方案的严苛企业工作。
93%的幻觉率引发对其可靠性的质疑
Artificial Analysis得出的最具影响性发现之一关乎事实准确性。
在其 AA-Omniscience基准测试M3.1 Flash 正确回答了56%的问题,而 DeepSeek V4.1 Flash-1017 为43%,GLM-5.3 Flash 为28%。
然而,Artificial Analysis 发现 MiniMax 几乎尝试回答了所有问题,产生了 93% 的幻觉率 (依据该基准测试的定义)。
重要的是,这并不意味着其全部答案中有93%是错误的。该指标衡量的是非正确回答中完全错误的回答所占比例,而非部分回答或拒绝回答。
换言之,当 M3.1 Flash 未能提供正确答案时,它 压倒性地选择给出一个错误答案 ,而非承认自己不知道。
这种行为导致其整体 AA-Omniscience 得分仅为16,尽管该模型在事实回忆方面表现相对较强。
对于考虑部署AI代理以自主更新记录、分析财务文件、调研客户或做出运营决策的企业而言,这一区别意义重大。仅凭高基准智能分数,并不能保证模型将可靠地识别自身局限性。
因此,企业在将 M3.1 Flash 应用于知识密集型工作流时,可能需要额外的验证机制、检索系统、防护措施或人工审核,以降低输出自信但错误内容的风险。
API 定价起始为每百万输入 token 0.15 美元,开源权重将于10月23日发布。
MiniMax 通过其 第一方 API、M Plan 订阅服务以及 MiniMax Code 桌面应用程序提供 M3.1 Flash。
该模型定价为 每百万输入 token 0.15 美元,每百万输出 token 0.60 美元,缓存输入则仅需每百万 token 0.015 美元。
按此费率,一项消耗一百万未缓存输入 token 并生成一百万输出 token 的工作负载,其模型使用费用为 0.75 美元,不包括其他基础设施或应用支出。
这使得 M3.1 Flash 成为当前全球范围内可用的最廉价前沿 AI 模型之一。
模型 | 输入(美元/百万) | 输出(美元/百万) | 总计(美元/百万) | 来源 |
|---|---|---|---|---|
0.10 美元 | 0.20 美元 | 0.30 美元 | ||
MiMo-V2.6-Flash | 0.14 美元 | 0.28 美元 | 0.42 美元 | |
GPT-6 Luna | 0.10 美元 | 0.50 美元 | 0.60 美元 | |
DeepSeek-V4.1-Flash-1017 — 非高峰时段 | 0.15 美元 | 0.60 美元 | 0.75 美元 | |
MiniMax-M3.1-Flash | 0.15 美元 | 0.60 美元 | 0.75美元 | |
MiMo-V2.6-Pro | 0.435美元 | 0.87美元 | 1.305美元 | |
MiniMax-M3 | 0.30美元 | 1.20美元 | 1.50美元 | |
LongCat-2.0 — 限时促销 | 0.30美元 | 1.20美元 | 1.50美元 | |
DeepSeek-V4.1-Flash-1017 — 高峰时段 | 0.30美元 | 1.20美元 | 1.50美元 | |
LongCat-2.0 — 标准版 | 0.75美元 | 2.95美元 | 3.70美元 | |
Gemini 3.8 Flash — 截至2026年12月31日 | 0.75美元 | 3.75美元 | 4.50美元 | |
Muse Spark 1.1 / 1.2 / 1.3 | 1.25美元 | 4.25美元 | 5.50美元 | |
Muse Spark Open — Together AI 无服务器平台 | 1.25美元 | 4.25美元 | 5.50美元 | |
GLM-5.3 | 1.40美元 | 4.40美元 | 5.80美元 | |
Grok 4.7 — 提示词(prompt tokens)数量 ≤200K | 2.00美元 | 6.00美元 | 8.00美元 | |
Qwen3.8-Max | 2.00美元 | 6.00美元 | 8.00美元 | |
Gemini 3.8 Flash — 自2027年1月1日起生效 | 1.50美元 | 7.50美元 | 9.00美元 | |
GPT-6 Sol | 2.00美元 | 10.00美元 | 12.00美元 | |
Claude Sonnet 5.5 | 2.00美元 | 10.00美元 | 12.00美元 | |
Gemini 4 Argon — 初期定价 | 2.00美元 | 10.00美元 | 12.00美元 | |
Grok 4.7 — 超过20万提示词元 | 4.00美元 | 12.00美元 | 16.00美元 | |
Grok 4.7 Fast(Cursor)—— 输入长度不超过25.6万词元 | 4.00美元 | 12.00美元 | 16.00美元 | |
GPT-5.4 | 2.50美元 | 15.00美元 | 17.50美元 | |
Kimi K3 | 3.00美元 | 15.00美元 | 18.00美元 | |
Claude Opus 5.5 | 4.00美元 | 20.00美元 | 24.00美元 | |
Grok 4.7 Fast(Cursor)——输入长度超过256K,最高达500K | 6.00美元 | 18.00美元 | 24.00美元 | |
Gemini 4 Argon——入门期后定价 | 4.00美元 | 20.00美元 | 24.00美元 | |
Muse Wonder 1.0 | 4.00美元 | 20.00美元 | 24.00美元 | |
Sakana Fugu Ultra(≤272K) | 5.00美元 | 30.00美元 | 35.00美元 | |
Claude Opus 5.5——快速模式 | 8.00美元 | 40.00美元 | 48.00美元 | |
Claude Fable 5 / Claude Mythos 5 | 10.00美元 | 50.00美元 | 60.00美元 | |
Claude Fable 5.1 / Claude Mythos 5.1 | 10.00美元 | 50.00美元 | 60.00美元 | |
GPT-6 Astra——标准模式 | 10.00美元 | 50.00美元 | 60.00美元 | |
GPT-6 Astra——快速模式 | 20.00美元 | 100.00美元 | 120.00美元 |
该模型支持文本和图像输入、文本输出,以及大小为 一百万个token的上下文窗口,据Artificial Analysis报道。
MiniMax还声称,该模型能够 每秒生成超过200个token,其中位数输出速度持续超过每秒170个token。
该公司将性能提升部分归因于更高的稀疏性(sparsity),这是一种旨在减少生成响应所需计算量的架构方法。
该模型权重在发布时仍为专有,但MiniMax表示计划于 10月23日发布这些权重。该公司尚未公布此次发布的许可条款,因此目前尚无法判断企业能在多大范围内修改或自行托管该模型。
在另一项重要披露中,MiniMax透露,M3.1 Flash的早期版本此前曾以代号 Space Bunny匿名运行,在其身份被公开披露前已处理了超过200万亿个token。该公司尚未提供该使用情况的详细分解数据。
MiniMax表示,一款能力更强的Pro版模型也在规划之中,但尚未宣布其发布日期。
对于企业AI团队而言,M3.1 Flash进一步表明,针对编程与自动化任务的强劲性能正以日益降低的价格提供。其第三方基准测试结果强化了这一论点,而幻觉(hallucination)相关发现则凸显出:在决定哪些AI模型可被信任用于实际业务运营时,价格与智能评分仅是方程的一部分。
希望以更少的token和更小的上下文让您的智能体(agents)发挥更大效能?请申请参加VentureBeat举办的 Agentic Infrastructure Stack Summit,时间是10月28日,地点为旧金山。
JOTO 企业落地观察
- 对企业部署而言,M3.1 Flash在BankerToolBench和Automation-Bench中与Claude Opus 5持平或反超,且API成本仅为后者的1/10,表明金融、运营等中高频、中低风险自动化场景可优先试点,但需强制接入事实核查模块或RAG增强层以抑制93%幻觉率。
- 对智能体工程而言,该模型在OSWorld 2.0和Agents' Last Exam中达61.7/29.6分,配合百万token上下文与200 token/s生成速度,适合构建长链跨应用操作智能体;但其高幻觉倾向要求工程侧必须设计‘拒绝回答’触发机制与输出置信度校准流程。
- 对AI安全治理而言,93%幻觉率并非指答案错误率,而是指‘非正确回答中完全虚构内容占比极高’,这暴露出现有AA-Omniscience等基准无法替代真实业务中的不确定性识别能力评估;企业需将‘是否主动拒答’纳入智能体SLA核心指标,并配套人工审核兜底策略。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们