代码智能体框架成本可增三倍却未提准确率:山东大学实证研究
山东大学研究发现,复杂编码框架(如Claude Code)使单任务成本最高达简易框架的3倍,但在447项任务中未带来统计显著的准确率提升;框架切换导致的结果波动(13%)与同一配置重复运行的波动相当。
根据一项新研究,围绕AI代码模型的‘框架’(即其系统提示、工具及上下文管理规则)可能使解决编码问题的成本增加至三倍,却并未带来可测量的准确率提升。 AI供应商经常宣传框架更新带来的准确率提升。但更复杂的框架是否真能提升智能体解决编码问题的能力,尚不明确。
山东大学的研究人员 对该问题进行了实证检验。他们固定底层模型,对近500项软件工程任务测试了三种生产级框架。 在更大规模的任务集上,最复杂与最简化的框架在五个百分点的误差范围内产生了统计上等效的成功率,而第三种框架表现更差。
在45项最难任务中,更换框架导致智能体所解决问题发生变化的频率,与重复运行同一未变更配置的频率大致相当:两种情况下均为13%(以中位数计)。与此同时,研究人员发现,使用同一模型时,不同框架每项任务的成本差异最高可达三倍。
对于企业技术领导者和开发者而言,这些发现 警示人们不应仅依据微小的、单次运行基准测试差异来选择代码智能体。 团队需要同时考察 任务成功率与每项任务成本。
为何框架基准测试可能产生误导
公开排行榜通常比较运行不同框架的代码智能体,因而难以分离出框架本身的贡献。 一些研究报告称,在保持模型不变而仅更换框架的情况下,分级任务得分的差异可达 23.8分,Pass@1指标的差异可达27.4个百分点。 与此同时,智谱AI(Zhipu AI)宣称其ZCode框架相较于Claude Code框架,在使用相同模型时提升了2.4分。
该新研究警告称,这些数字因两个原因而难以解读。第一, 许多已发表的对比实验 每种配置仅运行一次,而相同条件下重复运行同一测试可能产生差异显著的结果。 论文援引的一项独立研究发现, 在SWE-bench Verified数据集上对完全相同的配置重复运行10次,结果导致 得分差异 达2.2至6.0个百分点。若未对基线配置进行重复运行,团队便无法判断得分差异源于框架本身,还是源于随机的运行间波动。
第二, 被比较的框架往往并不处于同等条件。论文援引的一项研究显示,同一框架在使用最小化基准适配器时得分为19.1%,而在使用完整适配器时得分为73.4%,所用底层模型完全相同。
测试条件也可能扭曲结果。 当研究人员审核早期启用网络功能的运行时,他们发现 439次DeepSeek与Qwen试验中有312次(71%)从GitHub检索到了原始人工编写的修复方案。研究人员剔除了这些运行,并在最终评估中屏蔽了网络访问。
对生产级框架进行直接对比测试
为衡量框架的实际贡献,研究人员测试了三种生产级框架:Claude Code、OpenCode以及mini-SWE-agent——一种极简的开源框架,仅用约100行Python编写,仅暴露一个bash工具且不执行任何上下文压缩。
研究人员让五种模型均通过全部三种框架运行:两种本地部署的开源权重模型(Qwen3.6-35B-A3B与Qwen3.8-27B),以及三种通过API调用的模型(DeepSeek-V4-Flash、GLM-5.3-Flash与HY4-Preview)。他们还使用Claude Opus 5作为Claude Code内部的顶级锚点模型。
他们在隔离容器中,对来自SWE-bench Verified数据集的492项离线任务评估了这些智能体:其中45项最难任务(人类需耗时1至4小时以上),其余447项任务。 全部五种模型均在45项任务子集上进行了测试,但仅两种Qwen模型在更大规模任务池中接受了测试。
更复杂的框架并未展现出一致的准确率优势。 在447项任务池中,重量级的Claude Code与极简的mini-SWE-agent得分相差不超过两个百分点,并且在五个百分点误差范围内被判定为统计上等效 (两种Qwen模型均如此)。在45项最难任务中,约八分之一的问题(13%)在更换框架后在通过与失败之间发生切换。 重复运行同一框架也产生了相同的中位数切换率。 即使在DeepSeek-V4-Flash模型上测试DeepSeek官方命令行框架,其 通过率也落在其他三种框架的范围内——但却是所有在该模型上测试的框架中每次试验成本最高的。
研究人员写道:“供应商为其自身模型定制的框架并不能带来分数优势。”
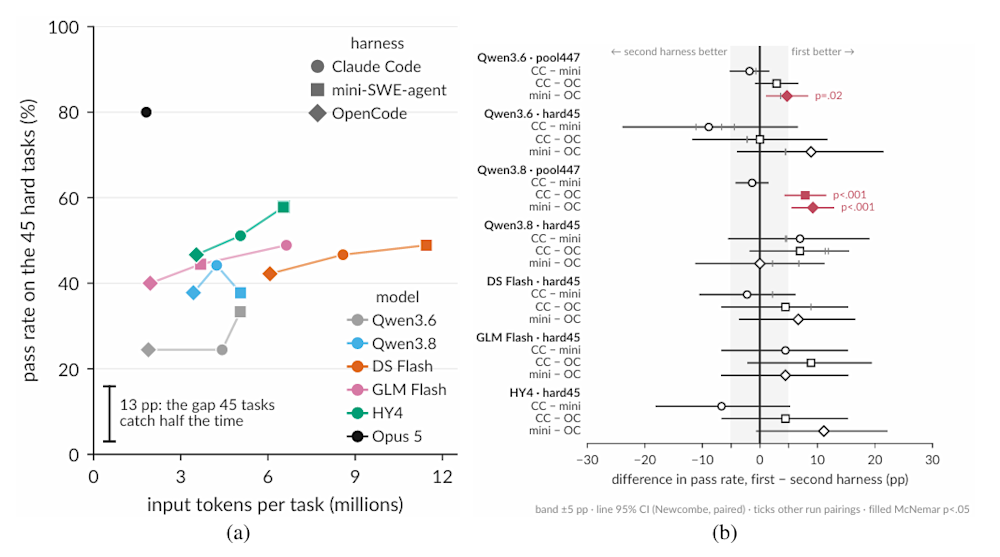
不同框架-模型组合对token用量、准确率及任务通过/失败切换的影响(来源:arXiv)
唯一能突破统计噪声阈值的框架效应是负面效应:OpenCode在大规模任务池上的得分落后最多达9分。 在Qwen3.8-27B模型上,该差距约一半源于模型在步骤中途达到32,000 token输出上限而被迫中止运行,此时往往尚未写出代码补丁。 Claude Code在相同模型上也触达了同一上限,但会自动提示模型继续生成。
尽管更复杂的框架未表现出一致的准确率提升,框架选择却对推理成本产生了显著影响。
研究人员写道:“使用同一模型、同一任务集及同一价目表时,不同框架的每项任务成本差异最高可达3倍。”
在GLM-5.3-Flash模型上,Claude Code中一次试验的成本几乎是mini-SWE-agent的两倍,超过OpenCode的三倍。 然而,OpenCode亦因调用模型次数更少而提前终止,这促成了其更低的成本。 全部三种框架从工具调用中返回的文本量大致相同。 这种差异也始于首次API调用:各框架通过其系统提示词和工具模式(tool schemas)发送的固定上下文量存在显著差异。Claude Code为16,581个token,OpenCode为7,025个token,mini-SWE-agent为829个token。由于智能体在每一轮均重新发送完整对话记录,该初始开销会随步骤数成倍放大, 研究人员推断,Claude Code还通过重复发送模型的中间推理块(intermediate reasoning blocks)进一步增加了开销。
研究人员解释道:“决定各框架单步开销差异的是其自身文本,而非代码仓库内容。”
尽管这些循环中96%至99%的输入token命中了服务商的提示词缓存(prompt cache),但不同供应商缓存计费费率的差异导致总费用重新计算后显著上升,而未改变给定模型下最昂贵框架的排序。
在DeepSeek-V4-Flash模型上,成本排序亦发生变化:mini-SWE-agent每轮试验需141次模型调用,高于Claude Code的104次,且成本略高——每轮试验约15.2美分,对比14.6美分。
验证框架税(Harness Tax)
这些发现印证了一项 HarnessTax 研究,该研究由加州大学伯克利分校Sky Computing实验室与Arena的研究人员开展。伯克利团队在Claude Code、OpenAI的Codex CLI以及Pi(一种仅含四个基础工具的极简开源框架)上评估了七种模型。 他们从两个基准测试中各选取30项任务进行测试,每项任务重复三次,并 发现框架选择仅使通过率(pass rates)产生几个百分点的微小变化,却可使推理成本最高增至五倍。
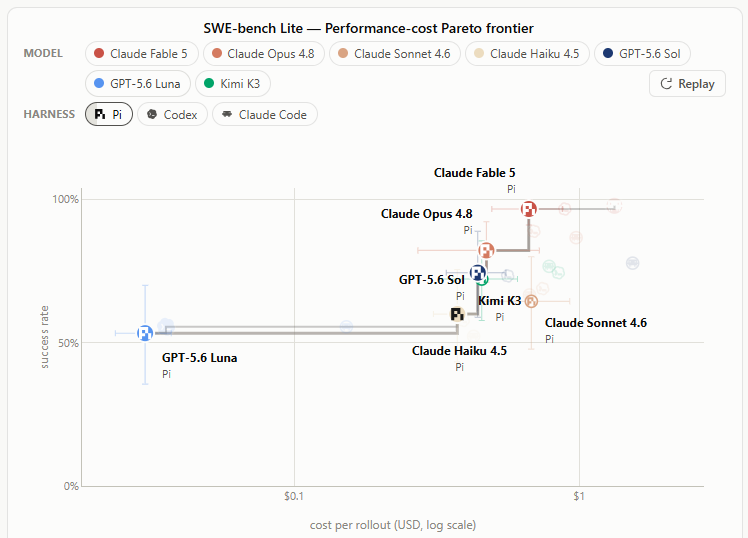
框架税(Harness Tax)(来源:GitHub)
伯克利研究人员发现,成本差异可始于首次模型调用。在全部七种模型中,Claude Code的初始上下文平均规模超过Pi的10倍以上,主要原因在于其更长的指令与工具模式。
伯克利的HarnessTax研究表明, 更复杂的框架在其所测试的基准上对平均任务成功率提升甚微。 新研究将该发现向前推进一步, 在更大规模的任务集上测试通义千问(Qwen)的270亿与350亿参数模型,并将框架差异与常规运行间变异(run-to-run variation)进行比对。 正如山东研究人员针对其测试中得分最低的模型Qwen3.6-35B-A3B所指出的, “最弱的模型并非对框架最敏感。”
面向企业构建者的实用启示
这一成本关切不仅限于编程智能体。在VentureBeat Intelligence九月发布的 VB Pulse调查中,使用所列智能体编排平台的107家企业的23家(21%)尚无自动化机制来终止智能体的token消耗。
该研究为企业工程负责人及开发AI应用或为编程工具分配预算的开发者提供了若干实用经验:
对照噪声基底(noise floor)审阅供应商基准测试结果:由于约八分之一的任务结果可能在完全相同的多次运行中发生翻转,一个包含45项任务的评估套件仅能在一半情况下检测出13个百分点的差距;即便使用447项任务,也只能在研究人员所观测到的任务级变异水平下分辨出5.2个百分点的差异。 在研究人员所观测到的任务级变异水平下。构建者应将单次运行对比中声称的2至3个百分点框架增益视为未经证实的主张, 并将研究人员建议的基准配置自行运行两次, 在采用更复杂支架(scaffold)前, 如研究人员所建议的那样, 在采用更复杂支架前。
精简首轮(turn-one)前置说明(preambles)与工具模式(tool schemas): 系统提示词与工具模式随每一步发送,尽管已缓存的token可能按较低费率计费。 当研究人员移除Claude Code的文件编辑工具,迫使Claude Opus 5通过bash编辑文件时, 其成功率仍处于对照组运行的结果范围内。 团队应测试是否 采用轻量级命令行工具 替代数十种静态工具模式 可在不损害任务完成率的前提下降低成本。
根据模型-框架组合调整推理预算(thinking budgets): Claude Opus 5运行于一年前发布的Claude Code版本(默认关闭扩展推理功能), 解决了45项任务中的34项,相较新版(解决35至36项)仅需其平均预估API成本的44%(每轮试验73美分,对比约1.65美元)。 然而,团队不可假设推理预算的开关操作不会带来后果。例如,对Qwen3.6关闭推理功能导致mini-SWE-agent的通过率下降11个百分点,而 Claude Code与OpenCode所呈现的变化则落在运行间变异范围内。 结果表明,调整推理预算的影响取决于模型-框架组合,而不仅取决于模型本身。团队应在调整思维参数以降低成本之前,对其确切的技术栈进行基准测试。
研究人员总结道:“在供应商之间传递的数值首先是初始调用值、每步增长量以及步数。”
希望以更少的 token 和更少的上下文让您的智能体(agents)发挥更大效用?请申请参加 VentureBeat 举办的 Agentic Infrastructure Stack Summit(智能体基础设施栈峰会),该峰会将于10月28日在旧金山举行。
JOTO 企业落地观察
- 该研究揭示企业部署编程智能体时,盲目采用供应商宣传的‘高级框架’可能徒增推理成本——例如Claude Code在GLM-5.3-Flash上成本超mini-SWE-agent近2倍,但成功率无差异,提示技术选型须同步监控每任务成本与成功率双指标。
- 对智能体工程实践构成直接警示:框架设计(如系统提示长度、工具模式冗余、中间推理块重传)是token开销主因,而非模型能力本身;移除Claude Code文件编辑工具后成功率未降,说明精简首轮preamble与工具集可在不损效果前提下显著降本。
- 研究证实框架性能差异常被运行间随机变异(如SWE-bench Verified上10次重复得分波动达2.2–6.0个百分点)所掩盖,这对AI安全治理中的基准可信度提出挑战——企业若依赖单次测试结果做采购决策,可能误判框架真实效能,需强制要求供应商提供多轮重复测试数据。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们