Anthropic发布Claude Opus 5.5:性能超越Fable 5.1,API成本直降60%
Anthropic推出专为智能体编程与知识工作优化的Claude Opus 5.5,在Terminal-Bench、FrontierCode等关键基准上大幅领先Fable 5.1,同时API输入/输出单价降至4/20美元每百万token,较Fable 5.1便宜60%;OpenAI同步发布GPT-6 Sol与Luna,以更低价格切入任务经济竞争。
Anthropic 今日发布了Claude Opus 5.5,这是其全新前沿模型,专为长期运行的编码智能体、研究及专业知识工作而设计;该模型在性能上超越、同时在成本(通过应用程序编程接口,即API)上低于Anthropic此前的旗舰模型 Mythos 5.1和Fable 5.1,后者仅数周前刚刚发布。
Anthropic对Opus 5.5的API定价为每百万输入token 4美元、每百万输出token 20美元,较Opus 5降价20%;同时宣称,由于该模型完成任务所需token数量更少,典型工作负载的整体成本因此降低约40%。
Anthropic还将缓存写入(cache-write)定价下调20%,从每百万token 6.25美元降至5美元;缓存读取(cache-read)成本降幅更为显著,从每百万token 0.50美元降至0.20美元。
令人印象深刻的是,Opus 5.5在实现上述成本优势的同时,在多项基准测试中亦取得Anthropic模型迄今最高分之一,涵盖智能体式编码(Terminal-Bench 4.0、FrontierCode v1.1 Main、CursorBench 4.0)、知识工作(GDPval-AA v2.1)、科学与跨学科推理(Terminal-Bench-Science 0.1³、Humanity's Last Exam)等多个领域。
Opus 5.5的基准测试成绩大幅超越Anthropic此前面向公众的旗舰模型Fable 5.1 ,甚至 尽管Fable 5.1的API价格高出150% 。
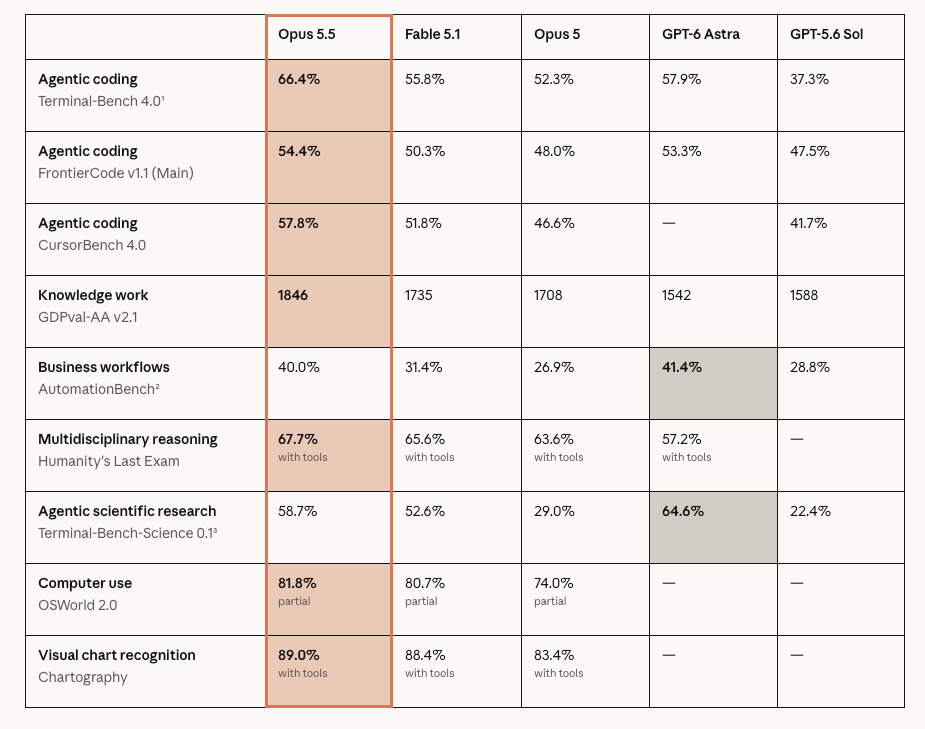
Claude Opus 5.5基准性能对比表截图。图片来源:Anthropic
此次发布正值前沿模型供应商日益转向以‘每美元所能完成的有用工作量’而非单纯基准分数作为竞争焦点。
模型 | 输入(美元/百万) | 输出(美元/百万) | 总计(美元/百万) | 来源 |
0.10美元 | 0.20美元 | 0.30美元 | ||
MiMo-V2.6-Flash | 0.14美元 | 0.28美元 | 0.42美元 | |
GPT-6 Luna | 0.10美元 | 0.50美元 | 0.60美元 | |
DeepSeek-V4.1-Flash — 非高峰时段 | 0.15美元 | 0.60美元 | 0.75美元 | |
MiMo-V2.6-Pro | 0.435美元 | 0.87美元 | 1.305美元 | |
MiniMax-M3 | 0.30美元 | 1.20美元 | 1.50美元 | |
LongCat-2.0 — 限时促销 | 0.30美元 | 1.20美元 | 1.50美元 | |
DeepSeek-V4.1-Flash — 高峰时段 | 0.30美元 | 1.20美元 | 1.50美元 | |
DeepSeek-V4-Pro — 非高峰时段 | 0.66美元 | 1.98美元 | 2.64美元 | |
LongCat-2.0 — 标准版 | 0.75美元 | 2.95美元 | 3.70美元 | |
Gemini 3.7 Flash — 截至2026年12月31日 | 0.75美元 | 3.75美元 | 4.50美元 | |
Gemini 3.8 Flash — 截至2026年12月31日 | 0.75美元 | 3.75美元 | 4.50美元 | |
DeepSeek-V4-Pro — 高峰时段 | 1.32美元 | 3.96美元 | 5.28美元 | |
Muse Spark 1.1 / 1.2 / 1.3 | 1.25美元 | 4.25美元 | 5.50美元 | |
GLM-5.3 | 1.40美元 | 4.40美元 | 5.80美元 | |
Grok 4.7 — 输入提示词数 ≤200K | 2.00美元 | 6.00美元 | 8.00美元 | |
Qwen3.8-Max | 2.00美元 | 6.00美元 | 8.00美元 | |
Gemini 3.7 Flash — 自2027年1月1日起生效 | 1.50美元 | 7.50美元 | 9.00美元 | |
Gemini 3.8 Flash — 自2027年1月1日起生效 | 1.50美元 | 7.50美元 | 9.00美元 | |
GPT-6 Sol | 2.00美元 | 10.00美元 | 12.00美元 | |
Claude Sonnet 5 | 2.00美元 | 10.00美元 | 12.00美元 | |
Grok 4.7 — 超过200K提示词(prompt tokens) | 4.00美元 | 12.00美元 | 16.00美元 | |
Grok 4.7 Fast(Cursor)—— 输入长度不超过256K | 4.00美元 | 12.00美元 | 16.00美元 | |
GPT-5.4 | 2.50美元 | 15.00美元 | 17.50美元 | |
Kimi K3 | 3.00美元 | 15.00美元 | 18.00美元 | |
Claude Opus 5.5 | 4.00美元 | 20.00美元 | 24.00美元 | |
Grok 4.7 Fast(Cursor)——输入长度>256K,最高达500K | 6.00美元 | 18.00美元 | 24.00美元 | |
Sakana Fugu Ultra(≤272K) | 5.00美元 | 30.00美元 | 35.00美元 | |
Claude Opus 5.5——快速模式 | 8.00美元 | 40.00美元 | 48.00美元 | |
Claude Fable 5.1/Claude Mythos 5.1 | 10.00美元 | 50.00美元 | 60.00美元 | |
GPT-6 Astra——标准模式 | 10.00美元 | 50.00美元 | 60.00美元 | |
GPT-6 Astra——快速模式 | 20.00美元 | 100.00美元 | 120.00美元 |
同样在今日, OpenAI发布了GPT-6 Sol与GPT-6 Luna,这是其GPT-6系列产品线中两款成本更低的成员。Sol的输入代币单价为每百万2美元,输出代币单价为每百万10美元——恰好为Opus 5.5基础费率的一半。
Luna进一步降至每百万0.10美元/0.50美元,即在原始输入与输出定价两方面均比Opus 5.5低97.5%。
同日发布的多款模型凸显了一个日益重要的企业级问题:关键不在于哪家供应商拥有单一能力最强的模型,而在于每单位资金所能完成的有用自主工作任务量。
代理式编程(Agentic coding)是Opus 5.5的核心卖点
Anthropic最突出的性能主张集中于软件工程任务,此类任务要求智能体(agent)在代码库中长期持续工作,而非仅回答孤立的编程问题。
该公司报告称 在Terminal-Bench 4.0上得分为66.4%,相较Fable 5.1的55.8%与Opus 5的52.3%。在FrontierCode v1.1 Main基准测试中,Anthropic报告Opus 5.5得分为54.4%,而Fable 5.1与Opus 5分别为50.3%和48.0%。在CursorBench 4.0上,Opus 5.5达到57.8% 54.4%,相较Fable 5.1的50.3%与Opus 5的48.0%。而在CursorBench 4.0上,Opus 5.5达到57.8% 57.8%,相比之下,分别为51.8%和46.6%。
令人印象深刻的是,Opus 5.5 在实现上述表现的同时,还在多项基准测试中取得了Anthropic迄今报告过的最高分,包括智能体编程(agentic coding)、知识工作(knowledge work)以及科学与跨学科推理(scientific and multidisciplinary reasoning)。其各项得分普遍超过Anthropic此前面向普通用户的旗舰模型Fable 5.1,而Opus 5.5的基础API代币定价则比Fable 5.1低60%。
Anthropic还提到了大规模真实世界编程工作负载。一位早期测试者在不到一天时间内完成了一项68万行代码的迁移任务。 另一位测试者 使用Opus 5.5在不到三小时内审核并修复了一个20万行的代码库,而据称Opus 5完成同样任务耗时超过20小时,且消耗的代币数量是Opus 5.5的2.5倍。
在一项将HAProxy从C语言翻译为Rust语言的内部实验中,Anthropic表示Opus 5.5与Fable 5.1均通过了该项目几乎全部的回归测试,但Opus 5.5耗时 9.5小时,而Fable 5.1耗时12小时 ,且成本 降低51%。
GitHub首席产品官Mario Rodriguez在一份由Anthropic提供的声明中表示,Opus 5.5在Copilot CLI与VS Code测试中,所用代币数与步骤数均为GitHub所测得的“最少之一”,同时以少于Opus 5一半的步骤解决了更多终端任务。其他早期测试方(包括Lovable、Spotify与Optiver)也报告了轮次(turns)、输出代币数或执行时间的类似减少。
这些结果由供应商选定的客户所提供,而非独立评估,但它们指向了Anthropic希望企业买家关注的运营指标:即在实际完成工作之前,发生了多少编排(orchestration)、重试(retrying)及代币消耗。
GPT-6 Sol改变了成本对比格局
OpenAI正以GPT-6 Sol与Luna提出基本相同论点——但其原始API价格显著更低。
Sol的定价为每百万输入/输出代币2美元/10美元,定位为支持重复性复杂任务,包括编程、调试、功能开发与数据分析。
Luna定价为每百万输入/输出代币0.10美元/0.50美元,面向高吞吐量任务,例如信息抽取、摘要生成与简单问答。OpenAI顶级模型GPT-6 Astra则仍保留给对能力上限要求高于成本考量的工作负载。
这使得Sol成为Opus 5.5更相关的价位竞争对手:其未缓存代币价格恰好 低50%。
缓存机制缩小了部分价差。OpenAI表示GPT-6对已缓存输入读取提供90%折扣,这意味着已缓存Sol代币价格为每百万0.20美元——与Anthropic为Opus 5.5列出的名义缓存读取费率相同。Luna对应的费率为每百万仅0.01美元。
OpenAI还表示,GPT-6可在开发者调整推理努力程度或启用/禁用工具时保持已缓存上下文,从而可能提升长期运行智能体中的缓存复用率。
然而,原始定价并不能确立整体工作负载成本。一个更便宜的模型若需更多调用次数、生成更多代币,或失败频率高到需要频繁重试,则可能反而更昂贵。
目前,尚无 公开、统一测试框架下GPT-6 Sol与Claude Opus 5.5在主要智能体基准测试中的直接对比。
OpenAI报告称GPT-6 Sol在AutomationBench 1.0.6上xhigh努力等级下的得分为 33.2%,单任务成本为0.27美元。与此同时,Anthropic报告了一项Zapier早期访问评估结果,显示Opus 5.5在相同基准上的得分为 40.0%。
单看数据,Opus 5.5在任务完成率上占优,而Sol价格则大幅更低。
但OpenAI指出,其发布中引用的竞品结果源自公开报告,而非在相同评估环境中生成,因此这两项数值不应视为受控的直接对比结果。
OpenAI还表示,Sol在FrontierCode 1.1 Main基准测试中xhigh努力等级下可达到与Claude Fable 5.1相当的性能,且成本低得多。Anthropic自身发布的Opus 5.5则显示该新模型在FrontierCode上优于Fable 5.1;但两家公司仍未公布采用同一测试框架与设置进行的Opus 5.5与Sol直接对比运行结果。 FrontierCode 1.1 主版本 成本大幅降低。Anthropic 自己发布的 Opus 5.5 版本在 FrontierCode 上将新模型置于 Fable 5.1 之上,但两家公司仍未发布采用相同测试框架和设置的 Opus 5.5 与 Sol 的直接对比结果。
Luna与Opus的直接竞争关系较弱,更可能作为一种潜在的路由替代方案。OpenAI报告称Luna在DeepSWE v1.1上以最大努力等级取得66.6%的得分,并表示其性能可媲美旧版高端Claude配置,而单任务成本仅为后者的极小一部分。
这为企业提供了另一选项:无需将智能体工作流中的每一步都发送至前沿价位模型。
知识工作遵循相同的效率策略
Anthropic还将Opus 5.5定位用于金融分析、研究、文档生成及其他专业工作流。
在 GDPval-AA v2.1这一涵盖44个职业的基准测试中,Anthropic报告称 Opus 5.5得分为1846 Elo,而Fable 5.1与Opus 5分别为1735与1708。
在一项内部研究评估中,一个自动化评分器会拒绝任何包含虚构数字或引述的报告。Anthropic表示 Opus 5.5生成的18份报告中有16份通过了该检验 在不同努力程度设置下均达到了其质量阈值,而Fable 5.1和Opus 5在任何一次尝试中均未达到该阈值。由于这是Anthropic设计的内部测试,应将其视为支持性证据,而非独立基准测试。
这一区别至关重要,因为供应商正强调任务经济学。GPT-6 Sol的发布同样聚焦于专业工作流及每次成功任务的成本,而非单纯发布孤立的智能分数。OpenAI表示,Sol在xhigh努力程度下,甚至可在AutomationBench上超越低努力程度的GPT-6 Astra,同时每次运行成本显著更低。
当前浮现的趋势是模型路由(model routing),而非单一模型标准化:对最难、最模糊的任务使用昂贵模型,对重复执行任务使用价格较低的模型,而对范围高度受限的子任务则使用Luna等极低成本层级。
开发者可获得更低的Opus价格,但也面临破坏性变更。
Opus 5.5拥有 100万token上下文窗口,同步支持最多 128,000个输出token ,并使用API模型ID claude-opus-5-5。Anthropic还通过其Message Batches API在Beta配置下支持最高达300,000 token的输出。
但Opus 5.5并非所有Opus 5应用的即插即用替代方案。
自适应推理(Adaptive thinking)现为 始终启用状态,开发者通过 effort 参数控制推理深度,而非关闭推理功能。强制调用工具可能返回错误;推理块(thinking blocks)与其生成所依赖的模型及对话绑定;旧版 computer_20251124 computer-use工具在Claude API及Google Cloud上被拒绝;而将工具调用之间文本作为进度更新向用户暴露的应用程序,可能需要更改其处理推理块的方式。
对于生产环境中的智能体系统,这些是影响工具路由器、持久化对话状态、回归测试及用户界面的重要变更。
安全控制也可能改变运行时行为。
Anthropic将Opus 5.5的能力提升与围绕网络安全、生物学及模型蒸馏(model distillation)的额外控制措施相结合。
部分网络安全请求可被透明地路由至Opus 4.8,而针对敏感生物学工作的保护措施亦可类似地触发回退行为。Anthropic表示,经审核的组织可通过其验证计划获得更广泛的访问权限。
Anthropic报告称,在其涵盖约2,000种场景的自动化行为审计中,Opus 5.5在几乎所有指标上均优于近期发布的Claude模型。
在一项新的约束评估中,该公司称Opus 5.5试图绕过边界的频率较Opus 5或Claude Mythos 5.1降低了约 85% 。该公司同时警示,部署前可靠检测每一次失败仍是尚未解决的问题。
OpenAI同样强调Sol与Luna在对齐(alignment)方面的改进,报告称其关于已完成编码工作的误导性声明及其他不良智能体行为的发生率有所降低。该公司强调,这些评估刻意采用对抗性方式,不应被解读为常规使用下的故障率。
竞争正转向每项完成任务的成本。
Claude Opus 5.5已通过Anthropic的API,以及AWS、Google Cloud和微软生态系统提供。
GPT-6 Sol与Luna已通过OpenAI的API以 gpt-6-sol 和 gpt-6-luna形式提供,并正通过ChatGPT Work与Codex逐步推出。
因此,在周二双线发布之后,竞争格局比一份基准排行榜更为复杂。
Anthropic已大幅降低高端Claude能力的价格:Opus 5.5在Anthropic报告的大多数基准测试中均超越其此前面向公众开放的旗舰型号,而基础API token单价却降低了60%。OpenAI则在曲线另一端作出回应:Sol的未缓存token价格为Opus 5.5的一半,而Luna则为无需旗舰级推理能力的工作设立了更廉价的层级。
在两款新模型均出现在受控、同框架(same-harness)评估之前,将选择简化为单一的价格-性能优胜者为时过早。
对企业团队而言,更具实用价值的对比正日益转向内部:在其实际计划部署的工作负载中,任务成功完成率、token消耗量、缓存复用率、延迟、返工率及人工干预频次。
模型之战已不再仅关乎谁能产出最高分,而日益关乎谁能将前沿智能转化为每美元所能完成的最多工作量。
JOTO 企业落地观察
- 对企业部署而言,Opus 5.5将高端模型的单位任务成本显著压低(如HAProxy迁移成本降51%),但其强制启用自适应推理、工具调用兼容性变更及安全回退机制,要求企业重审智能体系统的工具路由逻辑、对话状态持久化设计与回归测试覆盖范围。
- 对智能体工程而言,Opus 5.5在Terminal-Bench 4.0(66.4%)、CursorBench 4.0(57.8%)等代理式编码基准上的领先表现,配合100万token上下文与128K输出能力,为长周期代码库操作类智能体提供了更优基座;但需注意其推理块绑定模型与对话的特性,影响进度反馈与用户界面设计。
- 对AI安全治理而言,Opus 5.5在自动化行为审计中绕过边界的尝试频率较Opus 5降低约85%,且新增网络安全与生物学敏感请求的透明路由机制(如自动回退至Opus 4.8),表明厂商正将安全控制从静态策略转向动态、场景化干预,这对企业合规审计与敏感任务隔离策略提出新要求。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们