AI 手机只是起点,高通要为智能体铺一条全栈技术路线
高通在骁龙峰会上宣布向智能体 AI 全栈解决方案公司演进,推出第六代骁龙 8 双旗舰平台,重构 CPU/NPU/内存/连接架构以支持终端侧 MoE 模型、跨设备情境感知与持续运行的个人智能体。其技术路线已从「设备中心」转向「智能体中心」,覆盖终端、边缘与数据中心。
AI 正成为高通整张技术路线图的中心
「这次骁龙峰会最令人兴奋的地方在于,我认为我们终于步入了一个可以清晰看见 AI 智能手机形态的阶段」高通公司总裁兼 CEO 安蒙在峰会第一天说道。
炎热的美国茂宜岛,早上不到 8 点,会场里已经聚集了来自全球的媒体、开发者、合作伙伴和产业人士。让大家等待的并不只是又一代手机芯片,而是在寻找一个更大的答案——随着 AI 从手机里的一项功能,演进为能够跨终端理解意图、保存情境并代表用户采取行动的智能体,CPU、GPU、NPU、内存和连接将如何被重新组织,手机、PC、耳机、眼镜等终端之间的关系将如何改变?
过去,AI 是高通技术路线图中的一条能力线;如今,AI 正在成为重新定义整张路线图的中心。
这也是今年骁龙峰会释放出的更大信号:高通正在向覆盖终端、边缘和数据中心的智能体 AI 全栈解决方案公司加速演进。下一代 AI 手机只是这个故事最先被看见的入口。
意图驱动体验,芯片需重构工作流
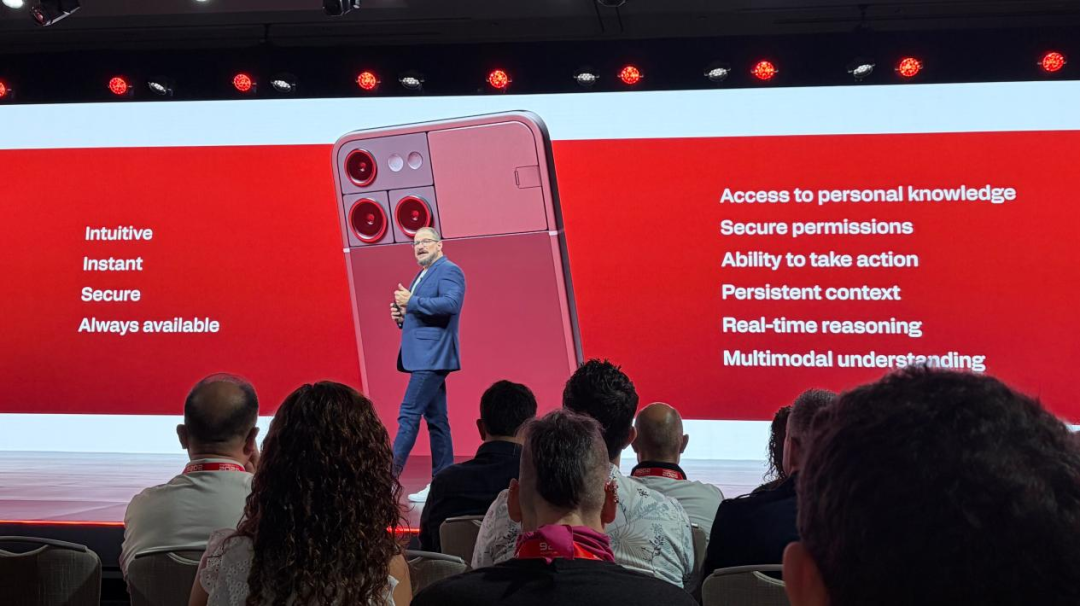
安蒙认为,在新一代手机上,意图应该是需要给用户带来最大感知变化的地方。这其中,交互方式的改变和智能体执行能力是需要提供给用户的新价值。
这对芯片提出了高能效、全天候续航等新需求。「最早的骁龙 8 系平台要回答的是,能不能让手机以 1GHz 甚至更高的主频运行高级操作系统,同时撑满一天续航。今天也是类似的挑战,只是换成了一个持续运行的智能体。」安蒙笑谈道。
过去,AI 是芯片路线图中的一项能力;现在,AI 正在成为定义整张路线图的起点。CPU、GPU、NPU、内存、连接乃至设备形态,都开始围绕智能体的工作方式重新设计。
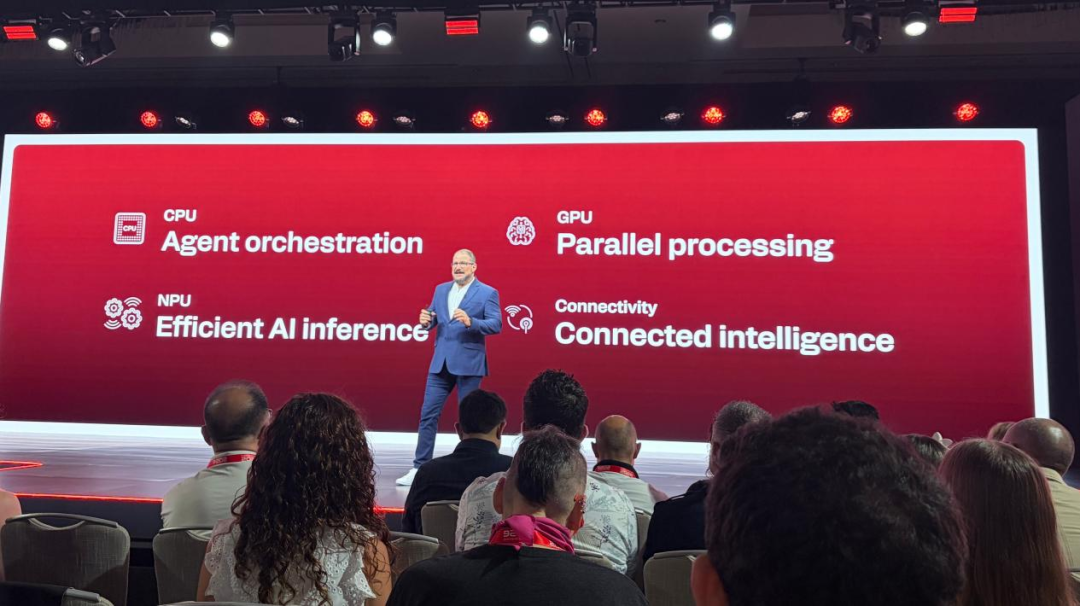
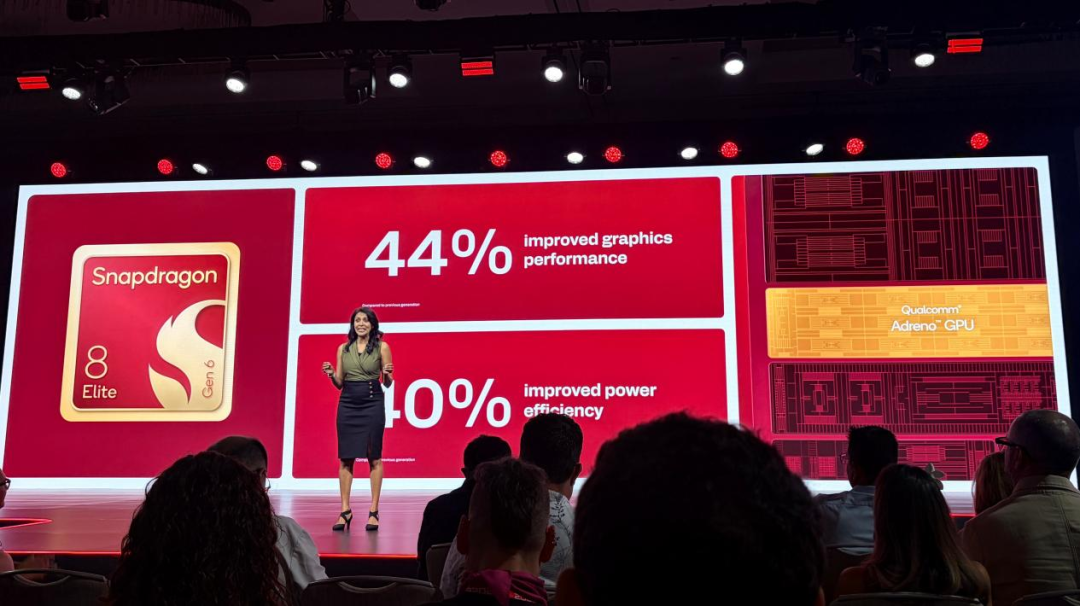
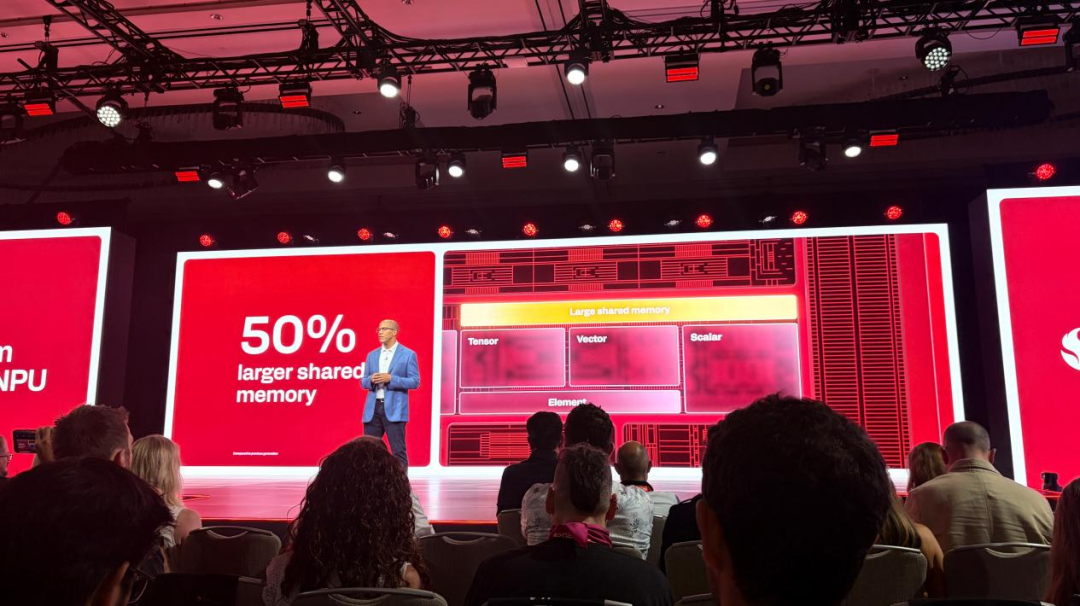
过去,CPU、GPU、NPU 更像是一颗芯片里的不同功能模块;现在,全新推出的第六代骁龙 8 超级至尊版围绕着智能体的完整工作流重新分工。CPU 正如智能体的「规划器」,主频在行业内首次突破 5GHz;NPU 则通过扩大与计算单元紧密耦合的本地内存,减少对外部 DDR 的频繁访问,并支持最高 300 亿参数的 MoE 模型在终端侧运行。更关键的是,高通首次在旗舰线同时推出第六代骁龙 8 超级至尊版和第六代骁龙 8 至尊版,这两款旗舰移动平台。
智能体时代的芯片竞争,不再只是比谁的单项算力更高,而是比谁能以更低功耗,把感知、推理、规划和执行组织成一套持续运行的系统。
此外,安蒙还预告在数据中心领域已经亮相过的 HBC(High-Bandwidth Compute,高带宽计算)将以协处理器的形式进入骁龙平台,把内存和 AI 计算拉得更近,让下一代 AI 手机拥有更强大的响应速度、能效和性能,更多细节将在 MWC 巴塞罗那 2027 上正式发布。
从「设备拥有 AI」到「智能体调度设备」
过去高通从设备出发思考 AI。手机有影像功能,就让 AI 把手机的图片处理能力发挥得更好;PC 有更强的计算能力,就让 AI 帮助用户提升生产效率。
但现在,高通开始从个人智能体的角度出发,来思考不同设备形态会在下一个节点上为个人智能体提供什么服务,这些服务需要什么样的能力?
以手机为例,手机仍然是个人 AI 体系里的核心节点,但是今年的旗舰手机竞争的底层问题已经发生了变化。小米 18 Pro 首发第六代骁龙 8 至尊版, NPU 在部分模型上的预填充性能提升最高 80%;同时在系统层面搭载澎湃 OS 4 和超级小爱 2.0;小米官方已经将 AI 能力从单纯的问答,推进到任务编排、跨应用执行和跨设备协同。手机厂商开始关注的问题,也从我如何通过这款处理器增加我的产品力,变成了我的这部手机能够让智能体替用户完成什么。
而在众多 AI 设备中,PC 正在成为智能体的生产力节点。
这两年发布的搭载骁龙 X2 系列的 PC 可谓是「智能体 PC」,骁龙 X2 Elite AI 性能达到 85 TOPS,PC 开始具备了让智能体长时间在本地运行的条件。
而今年更有意思的变化是,PC 厂商甚至开始重新寻找自己在 个人 AI 体系中的位置。
谷歌推出 Googlebook,把 Gemini Intelligence、Android 生态和 PC 结合起来,强调 PC 与 Android 手机之间的跨设备体验;
微软则继续强化 Surface 的本地 AI 能力。峰会期间展示的 Surface Pro 12 英寸和 Surface Laptop 13 英寸都搭载了 Snapdragon X2 Plus,本地 AI 推理速度较上一代提升 80%,续航时间超过 15 小时。
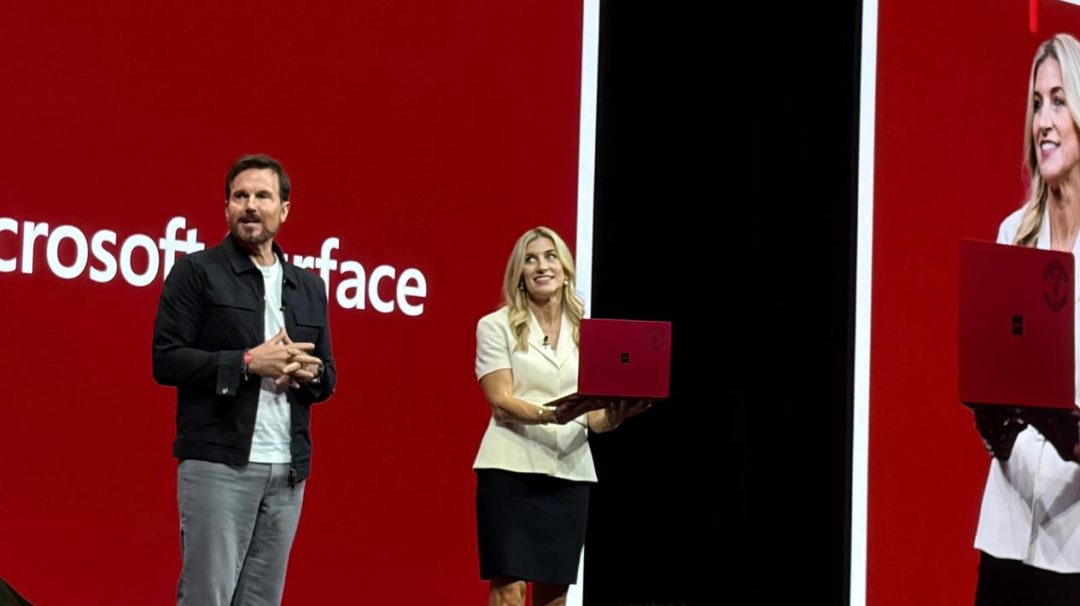
与此同时,一些原本并不属于传统 PC 阵营的玩家,也开始尝试重新定义「电脑」是什么。Qwen Book 直接将自己定义为「智能体电脑」,采用平板+键盘的形态,并围绕 AI 入口、Skill 等机制重新设计人与电脑之间的交互方式。
当 AI 拥有视觉和声音之后,耳机与眼镜就不再只是外设,而可能成为智能体理解现实世界的感官。今年骁龙峰会,高通重新定义音频平台。
过去,音频芯片解决的核心问题是让耳机听起来更好、连接更稳定、延迟更低、降噪更强。高通将第二代骁龙音频平台至尊版定义为首款面向智能体体验打造、融合高品质音频与语音、终端侧智能和连接能力的音频平台。此外,它进一步引入骁龙畅听应用与智能体,让耳机、耳塞和眼镜可以直接连接 AI 助手、服务和内容。高通正在把平台的边界从「芯片」向「设备与服务之间的连接层」延伸。
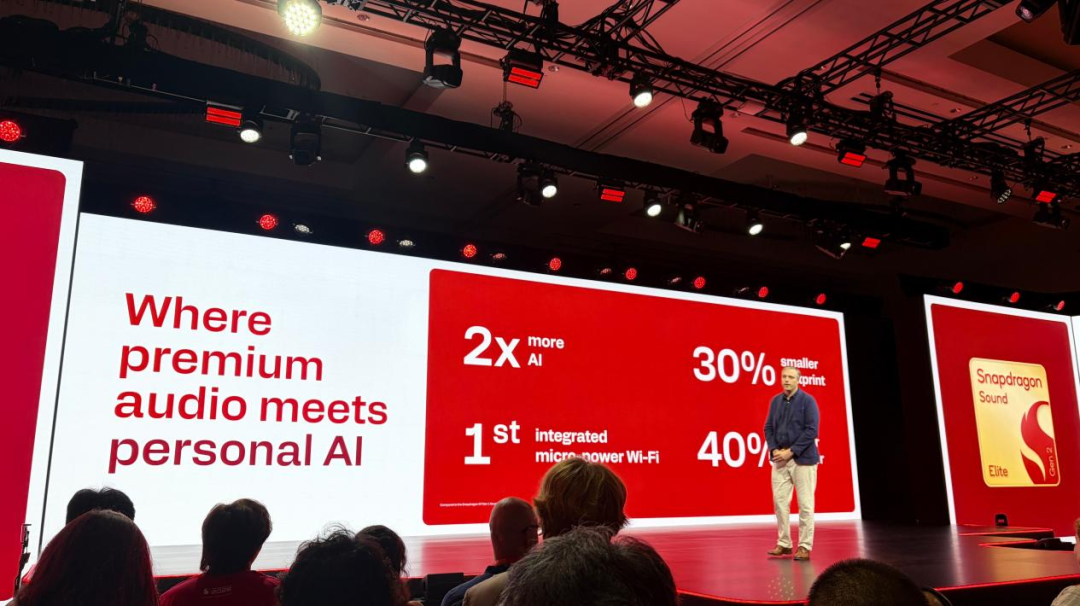
具体而言,第二代骁龙音频平台至尊版与前代平台相比 AI 能力提升高达 2 倍,峰值 AI 算力为 128 GOPS 、每周期可执行 256 次 MAC 运算,同时集成超低功耗 Wi-Fi 6E,让耳机、眼镜等设备可以直接连接云端 AI 服务;相比上一代平台,功耗最高降低 40%,平台尺寸最高缩小 30%。
在音频能力提升的情况下,个人 AI 未必一定要长出一个全新的「AI 硬件」物种,也可能通过升级已有设备,逐渐进入人的日常生活。耳机、智能眼镜,以及高通此次提到的 AI Pin 类产品形态,都是这种思路的代表。
像是耳机,过去是一个「播放设备」,但现在可以成为「个人智能体的常驻感知交互的入口」。它不需要用户掏出手机、打开一个 App、输入 Prompt,可以直接通过语音发生交互,提供实时翻译、环境理解、情境辅助、语音交互等能力。
高通还展示了一款与 Cleer 合作的概念设备,一款带摄像头的耳机、高通特别强调,这类带摄像头的音频设备并不只是为了「拍照」,而是可以持续获取用户所处环境的上下文,让智能体知道用户正在看什么、身处什么场景,从而提供更加实时的辅助。
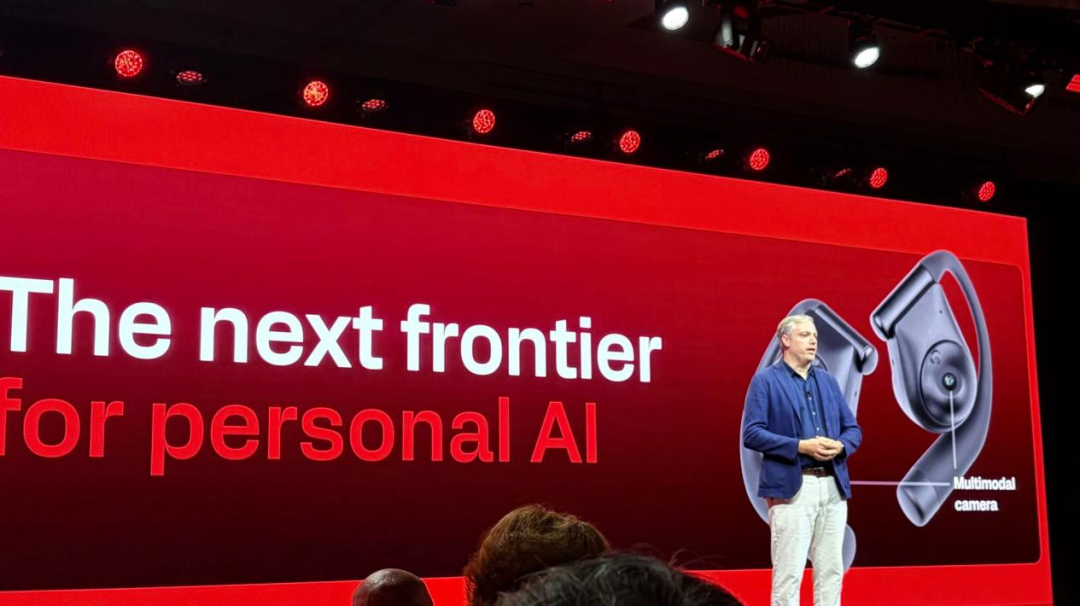
与具备显示和更完整视觉处理能力的智能眼镜相比,带摄像头的音频设备更强调以轻量化方式获取环境上下文。
高通还在峰会上介绍了 AI Pin 这类新的可穿戴设备形态。人只需要表达意图,设备负责直接把智能体召唤出来。
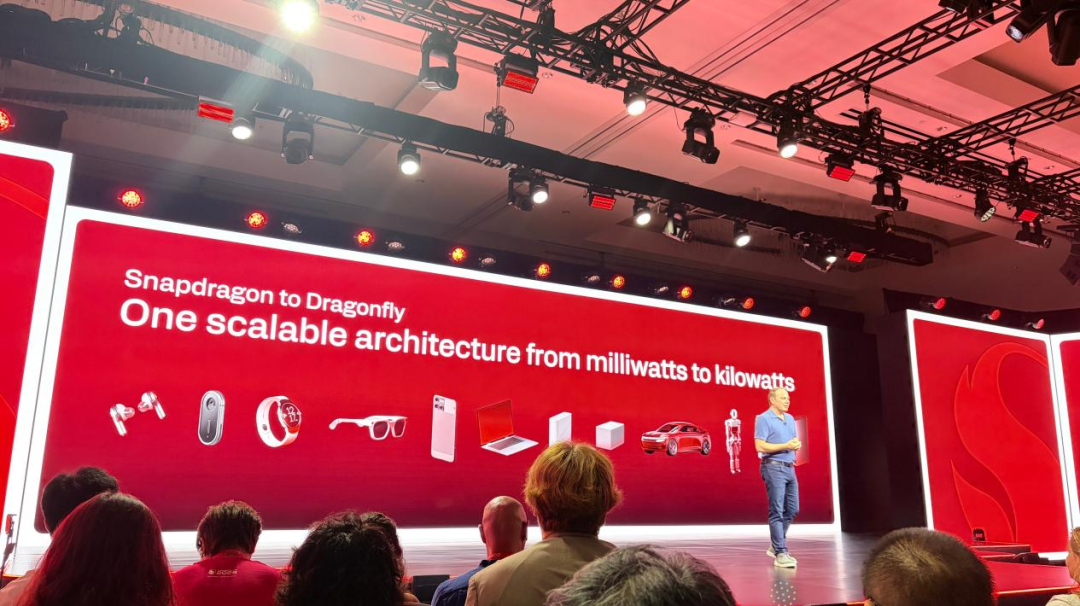
下一代个人计算的核心,可能不再是某一台设备,而是能够跟随用户在不同设备之间持续存在的情境信息与个人智能。无论智能流淌到哪里,它都需要一个计算、连接与感知的底层支撑。
从设备芯片到智能体基础设施
如果未来的计算不再以设备为中心,而是以「人的智能体」为中心,那么计算的边界也开始重新设定。
未来,人们可能通过眼镜感知现实世界,通过耳机听见环境,通过手机了解信息,在 PC 上处理复杂任务,在汽车里接触更大的地图信息,再把更复杂的推理交给边缘或者云端。
智能体天然需要在不同设备之间流动,也需要根据任务的复杂程度分配计算资源。高通要做的是,将过去几十年积累的能力重新组合。它开始要解决的问题是,如何让智能体在整个计算网络中找到最合适的地方完成任务,并持续运行。
对高通来说,相对好回答的是,极低功耗下完成高性能计算的能力。从手机 SoC 起家,高通长期解决的核心问题之一,就是如何有限的功耗、体积和散热条件下,把越来越多的计算能力塞进移动设备。
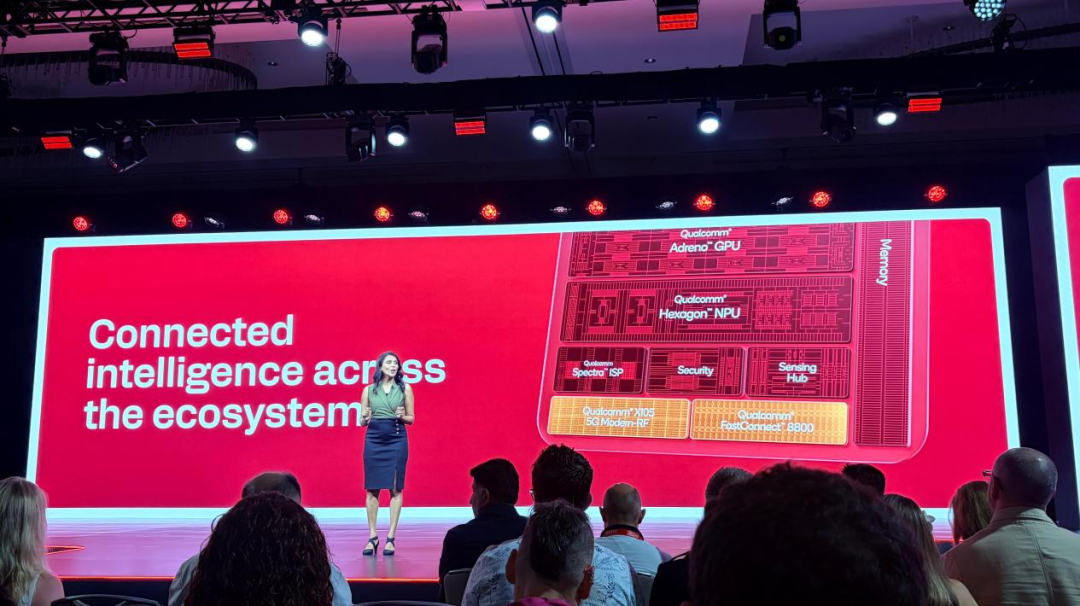
目前,新一代传感器中枢搭载双 Micro NPU,可在低功耗状态下持续处理环境声音等传感任务;第二代骁龙音频平台至尊版的 AI 性能翻倍,功耗降低 40%,让耳机可以全天在线。在手机上,超级至尊版的 CPU 和 GPU 能效分别提升 37% 和 40%,又通过创新的 Offset PoP 封装和 2nm 工艺等让持续极限性能提升至两倍。
在智能体时代,连接不再只是传输计算结果的通道,它开始参与决定计算在哪里发生。
全新骁龙移动平台至尊版搭载的高通 FastConnect 8800,首次将 4×4 Wi-Fi 引入移动连接系统,支持 Wi-Fi 8,峰值速率达到 11.6Gbps,同时具备近距离感知 AI 等能力。高通对 Wi-Fi 8 的思考,也不再只是「更快」,而是为连接带来 AI 原生智能,满足当前 AI 需求的现实场景。
同时,6G 在高通的技术路线中,也被定义为 AI 原生的基础设施。
一方面,设备可以通过更高速的上行,把现实世界中的视觉、声音和环境信息实时送入网络,为智能体提供更完整的上下文;另一方面,计算也不再集中在某个中心节点,而是从终端延伸到边缘、基站、区域数据中心,再到大型数据中心,根据任务和环境动态分配。
安蒙此前也表示,AI 正成为无线数据流量增长的核心驱动力,让 6G 的研发与落地成为行业必然。6G 这一代专为 AI 设计的无线技术,将围绕连接、计算、感知三大基石构建,它将为行业提供 AI 模型演进所需的关键数据处理能力,依托感知基础设施打造前所未有的全新服务,同时推动网络从单纯的连接载体,演进为支撑众多行业发展的核心计算系统。
硬件决定智能体跑得多快,软件决定它能走多远。今年 7 月完成对 Modular 的收购后,高通进一步补齐了面向异构 AI 计算的软件平台能力,希望让开发者能够以更统一的方式,将模型部署到从骁龙(Snapdragon)到跃龙(Dragonwing)、再到飞龙(Dragonfly)的不同计算平台上。
高通要重写自己的边界
从这个角度看,高通正在发生的变化,并不是简单地从一家手机芯片公司变成一家业务更多元的半导体公司,而是试图把过去积累的 AI、计算、连接和高能效重新组合起来,并将这些能力规模化部署到数十亿设备之中。这意味着,高通正在从过去的「提供处理器」,走向「提供智能体运行所需要的计算基础设施」。
从骁龙到跃龙,再到飞龙,高通正在尝试构建的,不是一组彼此分散的产品线,而是一条贯穿个人终端、边缘设备和数据中心的 AI 计算连续体。
高通过去最擅长的,是让连接和计算进入更多设备;而在智能体时代,它需要证明的,是如何让智能在这些设备之间持续流动。
但从更大的芯片产业历史来看,真正决定下一轮格局的,往往并不只是一次性能升级,而是当计算范式发生变化时,谁能率先重新定义自己的能力边界。
这不是高通一家公司需要回答的问题。今天的 ARM 想要从一家 IP 公司走向更广阔的计算世界,英特尔也在寻找 PC 之外的新计算位置。
今天的高通,在端侧上率先给出了自己的答案。从手机、PC 到耳机和眼镜,从低功耗感知、异构计算到连接和 AI 软件栈,高通正在把 AI 从某一颗芯片上的功能,提升为贯穿技术路线图的核心逻辑。它的目标也不再只是提供更快的处理器,而是成为智能体跨越终端、边缘和云端运行时的计算与连接底座。
如果说智能手机时代,高通抓住的是移动计算的入口,那么智能体时代,它希望抓住的,是智能发生的每一个地方。
JOTO 企业落地观察
- 企业部署智能体时,若依赖多终端协同,必须评估芯片级 AI 能力的异构一致性——高通双旗舰策略表明,同一架构下不同性能档位的平台,正成为保障跨设备智能体连续性的基础硬件前提。
- 智能体工程中「感知-推理-执行」闭环对内存带宽与低延迟提出刚性要求,高通扩大 NPU 共享内存、引入 HBC 协处理器等举措,提示企业在设计终端侧智能体时需前置规划 KV-cache 存储路径与 DDR 访问频次。
- RAG 知识工程在终端侧落地面临模型规模与上下文长度限制,高通支持 300 亿参数 MoE 模型及长上下文推理,意味着企业可探索更轻量但结构更复杂的本地知识代理,而非仅依赖云端检索增强。
- AI 安全治理需覆盖从芯片到连接的全链路,高通将 Wi-Fi 8、6G 定义为 AI 原生基础设施,说明企业构建智能体系统时,无线协议层的安全建模与上下文传输加密将成为不可绕过的治理环节。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们