MFS:给 Agent 一个可搜索的上下文文件系统
Zilliz 开源的 MFS(Multi-source File-like Search)将代码仓库、文档、数据库、聊天记录等多源信息统一组织为类文件系统结构,提供 search/grep/ls/cat 等命令接口。它不把搜索结果当答案,而是返回 source + locator,支持 Agent 回溯原始证据。架构采用 thin client + stateful server 设计,强调权限隔离与生产就绪能力。
Agent 需要的上下文层,不只是把更多文档塞进向量库,而是能先找到候选,再回到原始来源读取证据。
Zilliz 开源的 MFS,全名是 Multi-source File-like Search。
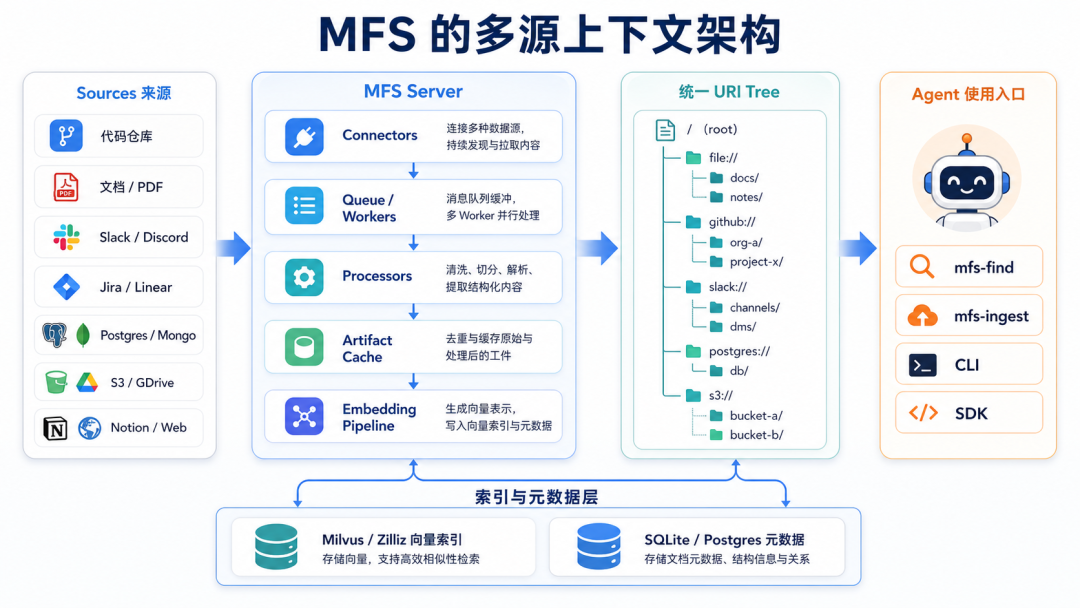
它的目标很明确:把代码仓库、文档、记忆文件、技能、聊天记录、工单、数据库、对象存储这些分散来源,组织成一个统一的、可搜索又可浏览的文件空间。Agent 不需要记住每个系统的 SDK,也不需要为 Slack、Postgres、GitHub、S3 各写一套检索逻辑;它面对的是一组稳定 URI 和几条熟悉的命令:search、grep、ls、tree、cat、head、tail。
这类项目和普通 RAG 的差异在这里:MFS 不把搜索结果当答案。它强调的是一个更接近工程师日常工作的证据路径:先搜索候选,再用路径和 locator 回到原始对象,读取可引用的证据。
问题在哪里
现在的 Coding Agent 已经能读代码、改文件、跑命令,但它面对的项目上下文越来越分散。
一个真实任务里,关键信息可能同时在这些地方:
- 代码仓库里的实现和测试。
AGENTS.md、CLAUDE.md、memory.md、SKILL.md里的长期规则。- Notion、Google Drive、PDF、设计文档里的背景说明。
- Slack / Discord / Gmail 里的决策讨论。
- Jira / Linear / GitHub Issues 里的任务状态。
- Postgres / Mongo / BigQuery / Snowflake 里的业务记录。
- S3 / GDrive / Web 页面里的外部资料。
只靠 grep,前提是你知道在哪个目录、搜哪个词。只靠向量库,问题会变成另一种:搜索能给出片段,但 Agent 仍然需要判断这段来自哪里、是否过期、能不能继续打开源文件核对。
MFS 选择把这些来源都转成 file-like tree。它给每个来源保留可以继续浏览的路径,而不是把所有东西揉成一坨“知识库”。
比如:
mfs add path/to/repo
mfs add github://your-org/your-repo --config ./github.toml
mfs add postgres://prod/orders --config ./pg.toml
mfs add slack://acme --config ./slack.toml

mfs search "为什么当时回滚 burst guard" --all
mfs cat slack://acme/channels/oncall/messages.jsonl --locator '{"id":"..."}'
对 Agent 来说,这比“把所有文档 chunk 塞进上下文”更可控。它可以先定位,再逐步读取,不需要把整个世界一次性塞给模型。
架构怎么分
MFS 是一个 thin client over stateful server 的架构。
客户端包括 Rust 写的 mfs CLI、SDK,以及两个 Agent skills:mfs-ingest 和 mfs-find。客户端主要负责解析命令、带上 endpoint/token、必要时打包上传本地文件,然后调用 HTTP /v1 API。
状态都在服务端:mfs-server 负责 connector、队列、worker、处理器、配置、凭证、缓存、向量索引和元数据。
这层拆分很关键。
如果每个 Agent CLI、每个插件、每个脚本都直接打开本地向量库,很快会遇到文件锁、状态漂移、索引版本不一致的问题。MFS 让一个 server 持有状态,CLI、SDK、Agent skill 都只是它的客户端。
后端也按本地到生产做了可替换设计:
| 层 | 本地默认 | 生产替换 |
|---|---|---|
| 向量索引 | Milvus Lite | self-hosted Milvus / Zilliz Cloud |
| 元数据 | SQLite | Postgres |
| 缓存 | 本地文件系统 | 可按部署扩展 |
| 嵌入模型 | 本地 ONNX | OpenAI / Gemini / Voyage / Jina / Mistral / Ollama 等 |
这说明 MFS 的定位不只是一个本地小工具。它希望同一套接口能从单机 Agent 工作流,扩展到团队级上下文服务。
搜索只是第一步
MFS 文档里最值得保留的一句话是:search gives candidates, not answers。
搜索结果只是候选,不应该直接被 Agent 当成事实引用。MFS 的结果会带 source 和 locator。source 是对象 URI,locator 是能重新打开精确位置的定位信息。文本和代码通常是行号范围,结构化数据可能是主键字段。
所以一个健康的使用流程是:
mfs search或mfs grep找候选。- 从结果里拿到
source和locator。 - 用
mfs cat --range或mfs cat --locator重新打开原始对象。 - 只把必要证据放进 Agent 上下文。
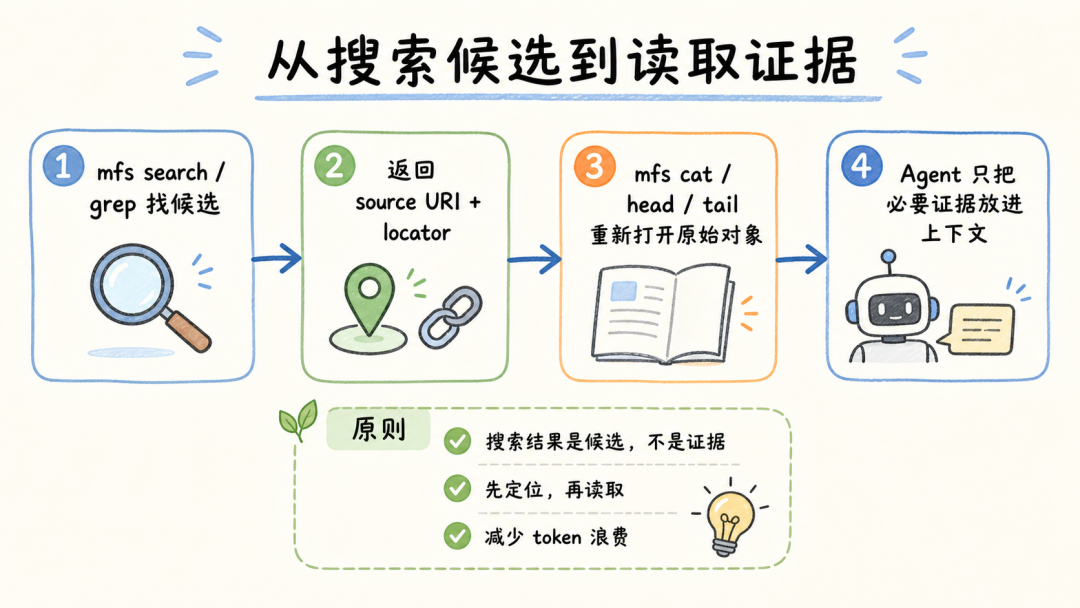
这和前端工程里调试问题很像。你不会只看搜索摘要就改代码,也不会只看监控标题就下结论。你会点进日志、PR、commit、issue、配置文件,确认原始证据。
MFS 把这个习惯做成了 Agent 的工具接口。
它的 mfs-find skill 也把这个规则写得很清楚:大范围、跨来源、概念式查询适合用 MFS;已知文件和精确字符串,普通 grep / rg 更直接。MFS 主要补上“来源太多、措辞不确定、需要语义召回和证据回读”的那一层。
Ingest 不是小事
多源上下文层最难的部分,往往在 ingest pipeline,而不在搜索框。
MFS 把来源接入分成 connector,再把 connector 里的对象送进两条处理路径。
第一条是 Object Lane。每个文件、图片、表格行、消息流都被拆成独立 object task,进入持久化队列。worker 取出任务后做转换、切分、embedding,再写入 Milvus。中间有一个有界的 in-memory chunk queue,用来给 embedding consumer 做背压,避免上游无限制造 chunk 把内存打爆。
第二条是 Job Lane。它处理目录 summary 这类跨对象工作。目录摘要需要按树结构从底向上折叠,不能只看单个文件。最终它也会变成 chunk,进入同一个 embedding tail。
这套设计的价值在于:不同来源、不同对象形态、不同粒度的工作,最后收敛到同一条 chunk → embedding → index 路径里。新 connector 不需要重新发明向量库、缓存、队列和检索逻辑,只要把外部系统映射成 URI tree 和 object。
这也是 MFS 相比“写一个简单 MCP + vector DB”的区别。后者能很快跑通 demo,但一旦遇到半路失败、重复同步、删除、重命名、模型缓存、队列取消、部分索引可用,就会变成状态工程。
多源不是无限权限
MFS 的 connector catalog 很宽:file、web、S3、Google Drive、Notion、Postgres、MySQL、Mongo、BigQuery、Snowflake、GitHub、Jira、Linear、HubSpot、Zendesk、Slack、Discord、Gmail、Feishu 等都在文档里。
但它没有把凭证随便丢给 Agent。
connector TOML 里不直接保存 raw secret,只保存引用:env:VAR_NAME 或 file:/abs/path。token、password、credential file 在 server 进程环境或 server 可读文件里解析。客户端和 Agent 只看到引用,不直接接触原始密钥。
这点对团队部署很重要。
Agent 需要读上下文,不代表它应该拿到所有系统的明文凭证。上下文层如果要进入生产环境,权限和凭证边界必须在系统设计里,而不是靠提示词要求 Agent “不要泄露”。
MFS 目前也保留了一些明确边界:部分 connector 是 optional extras,不是每个 server 都默认安装;结构化数据库通常需要 [[objects]] 配置 text fields、locator fields 和 metadata fields;大规模外部来源要先 probe / estimate,再决定是否同步。
换句话说,它更像一个上下文基础设施,不是一个开箱即用的聊天插件。
怎么选择
把 MFS 放到 Agent 上下文工具路线里,会更清楚。
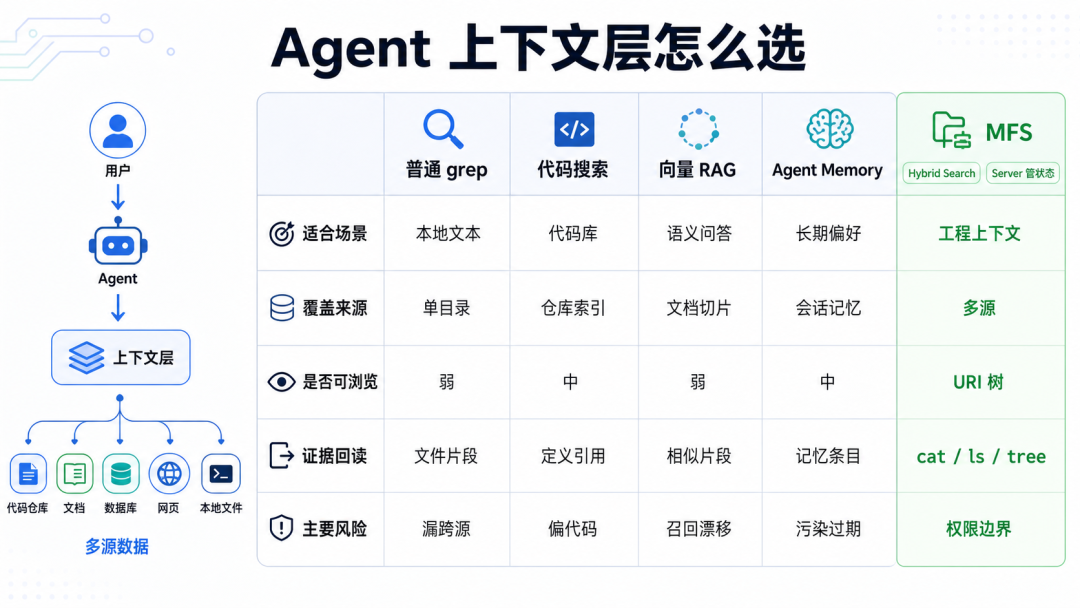
我的判断是:MFS 适合两类场景。
第一类是个人或小团队的 AI Coding 工作流。你已经有多个仓库、文档、历史记忆、issue、聊天记录,Agent 经常需要跨来源找证据。这个时候 MFS 可以作为本地上下文入口,让 Agent 不再只靠当前工作目录和几份 Markdown。
第二类是要构建 Agent 产品的人。MFS 提供 CLI、SDK 和 HTTP API,自己的应用可以把它当成 retrieval/context base layer,不必从 connector、chunking、embedding、Milvus schema、缓存和队列开始造。
但它不适合所有任务。
如果你知道就在当前仓库搜一个函数名,rg 更快。如果你只需要给一个 bot 存几条用户偏好,Agent memory 更轻。如果你只是做固定文档问答,一个简单 RAG 服务可能够用。MFS 的价值要在多源、跨格式、需要证据回读、需要 Agent 自己浏览的场景里才明显。
对研发团队的启发
研发团队做 Agent 产品时,Agent 能不能持续工作,经常取决于更底层的上下文接口。
一个产品级 Agent 至少要回答这些问题:
- 它从哪里找证据?
- 它怎么知道搜索结果能不能引用?
- 它如何回到原始来源读取上下文?
- 它是否能跨代码、工单、聊天、数据库、文档一起查?
- 它拿到的是明文凭证,还是受控的 server-side connector?
- 它读入上下文之前,有没有路径、locator、metadata 和权限边界?
MFS 给出的答案是 file-like interface:把复杂来源收敛成 URI tree,再把搜索、浏览、读取这些动作做成 Agent 已经熟悉的命令。
这个方向值得关注。未来 Agent 产品里的上下文层,大概率不会只是“一个向量库 + 一个 prompt”。它会更像一个可搜索、可浏览、可审计、可恢复的文件系统接口。
Agent 上下文工程的关键,是从候选回到证据,从片段回到来源。
JOTO 企业落地观察
- 企业部署多源上下文系统时,需优先评估 connector 的权限模型是否满足最小权限原则——MFS 将凭证解耦至 server 端并仅传递引用,为企业级权限治理提供了可复用的设计范式。
- 智能体工程中,若 Agent 需频繁跨异构系统执行证据回读,传统 RAG 的“向量召回+拼接摘要”模式易导致溯源断裂;MFS 的 source+locator 机制强制引入可验证路径,提升了智能体输出的可审计性。
- RAG 知识工程正从“静态 chunk 注入”转向“动态上下文装配”,MFS 的 Object Lane + Job Lane 双通道 ingest 架构,为企业构建支持增量更新、失败重试与元数据富化的知识管道提供了工程参考。
- AI 安全治理要求上下文层具备凭证隔离与访问边界控制能力;MFS 对 connector 配置中 raw secret 的显式禁止,以及 optional extras 的模块化设计,降低了企业在生产环境中实施细粒度权限管控的改造成本。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们


