OpenAI Evals技术拆解:Agent评测的入门教科书
OpenAI Evals 是一个开源评测框架,核心是标准化的注册表机制、严格可复现的日志体系和模型即裁判(LLM-as-a-Judge)范式。它支持从单轮文本生成到多步 Agent 行为轨迹的评估,通过 JSONL 数据集、YAML 配置与解耦的 Solver/Completion 组件实现灵活扩展,为复杂推理、工具调用与状态变更类任务提供结构化评测能力。
框架概述与核心设计哲学
1.1 什么是 OpenAI Evals
OpenAI Evals 是 OpenAI 开源的用于评估 OpenAI 模型(及集成自定义模型的系统)的框架和数据集注册库(Registry)。
本质定位:它不仅是一个测试运行器(Test Runner),更是一套标准化的评测协议。
诞生背景:在 GPT-4 发布前夕,OpenAI 需要一套大规模、标准化、可快速迭代的机制来测试模型在各种学术、专业及安全场景下的表现。他们将这套内部工具开源,旨在让整个社区共同贡献高质量的评估测试集。
生态作用:它确立了早期基于 JSONL 的测试数据集规范以及 LLM-as-a-Judge 的评估模式,为后续 LangChain/LangSmith、LlamaIndex 等框架的评测设计提供了重要借鉴。
1.2 核心设计原则
OpenAI Evals 的底层设计围绕着三个关键原则展开:
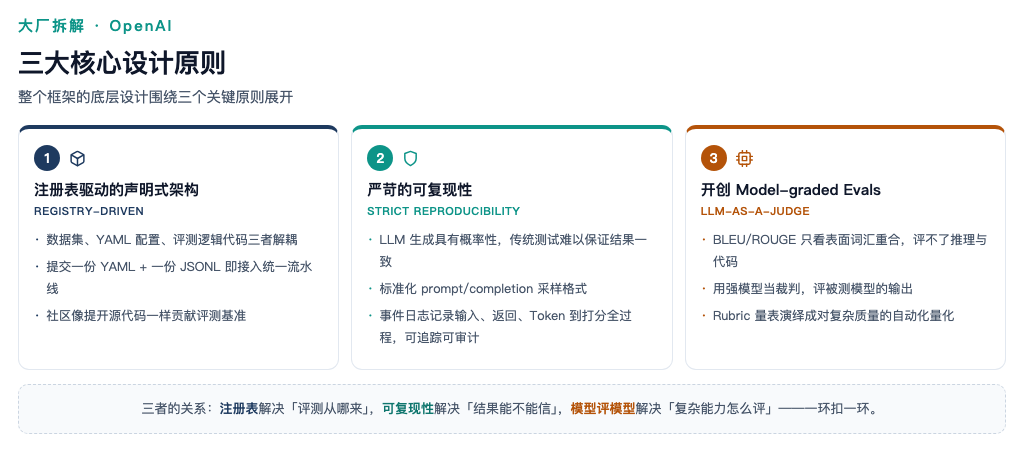
① 社区驱动的注册表机制(Registry-Driven Architecture)
Evals 采用了「声明式注册表」的概念。将测试数据集(Data)、评测任务配置(YAML)和评测逻辑代码(Python)解耦。
任何开发者只需要提交一个符合规范的 YAML 配置文件和一个 JSONL 数据集,就能无缝集成到一个统一的评测流水线中。
这种设计极大地降低了贡献测试集的门槛,使得社区可以像提交开源代码一样提交评测基准(Benchmarks)。
② 严苛的可复现性(Strict Reproducibility)
由于大语言模型的生成过程具有概率性(Non-deterministic),传统的测试方法极难保证结果一致。Evals 规范了:
- 数据采样格式:标准化的 prompt/completion 输入输出结构。
- 日志系统(Event Logging):每次评测都会生成带有唯一标识的 JSON/JSONL 日志,记录从输入 Prompt、模型原始返回、Token 消耗,到最终 Matcher/Scorer 断言打分的全过程,确保任意一次评测可追踪、可审计。
③ 开创性的 Model-graded Evals(LLM-as-a-Judge)
这是 OpenAI Evals 贡献最大的设计范式。
传统局限:传统的 NLP 评估指标(如 BLEU、ROUGE)依赖表面词汇重合度,无法评估复杂推理、开放式问答、代码质量及 Agent 执行轨迹。
模型评测模型:Evals 引入了用强大的模型(如 GPT-4)作为裁判(Judge)来评估被测模型(Client/Subject Model)输出的模式。
Rubric 打分制:通过传入严格设计的打分量表(Rubric)和评估 Prompt(如判断答案是否包含事实性错误、是否符合安全策略等),实现了对复杂文本质量的自动化量化。
1.3 OpenAI Evals 在 Agent 场景下的演进逻辑
在早期,OpenAI Evals 主要用于测试单轮/双轮的文本补全或 QA 问答。但随着 Agent 架构的演进,评测对象从简单的「文本生成」变成了「行为决策」:
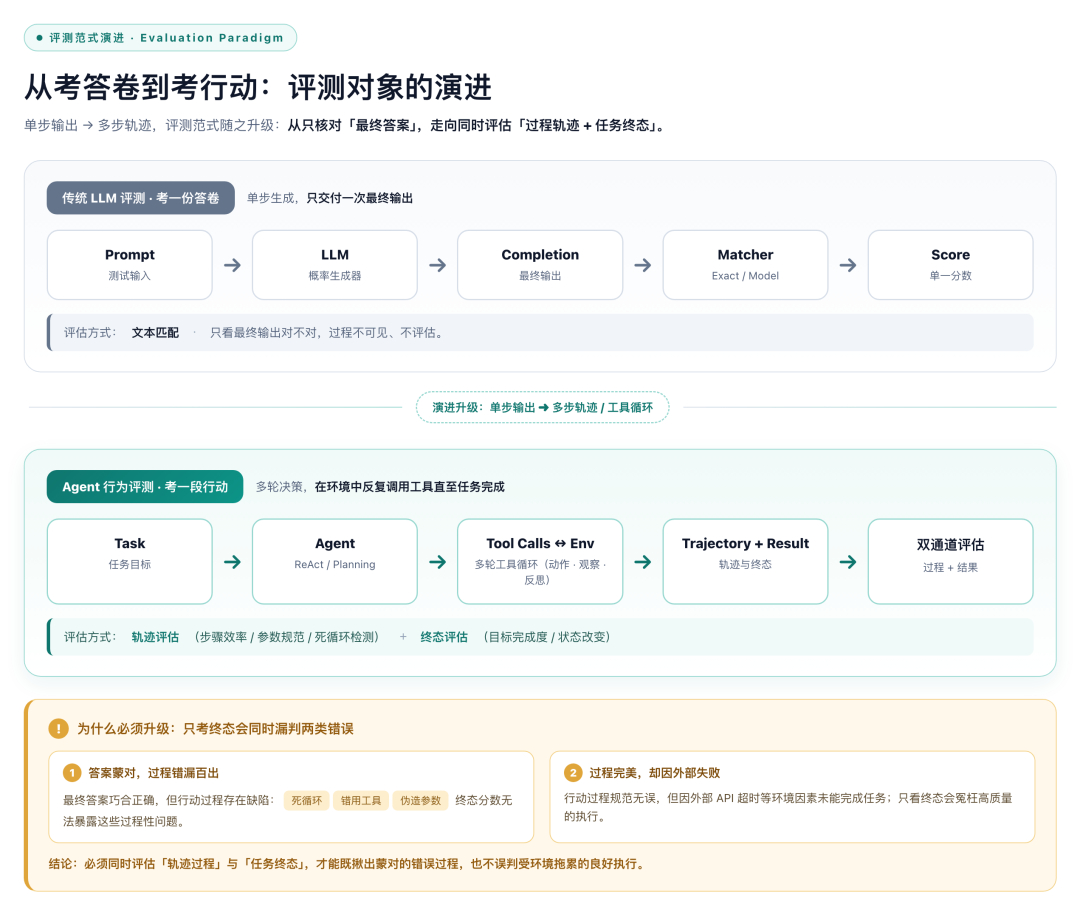
单步输出 → 轨迹评估(Trajectory Evaluation):不仅看最终任务是否完成,还要分析 Agent 执行的思考链(CoT)、工具选择的合理性以及是否有循环重试的无效消耗。
文本匹配 → 环境状态变化(State Change Assertions):评估 Agent 执行后的真实副作用(例如数据库是否按预期写入、沙箱文件是否正确生成)。
这需要我们对 OpenAI Evals 的底层抽象(Solver、Eval、Registry)进行针对性的剖析。
核心架构与工作流拆解
要真正驾驭 OpenAI Evals(or 基于其思想构建企业级评测系统),必须彻底理解其四大核心支柱:Registry(注册表)、Eval(评测逻辑)、Solver(求解器)与 Completion(模型交互)。
下面我们将从底层架构设计、核心代码抽象以及配置规范三个维度进行全景式拆解剖析。
2.1 整体架构与核心组件抽象
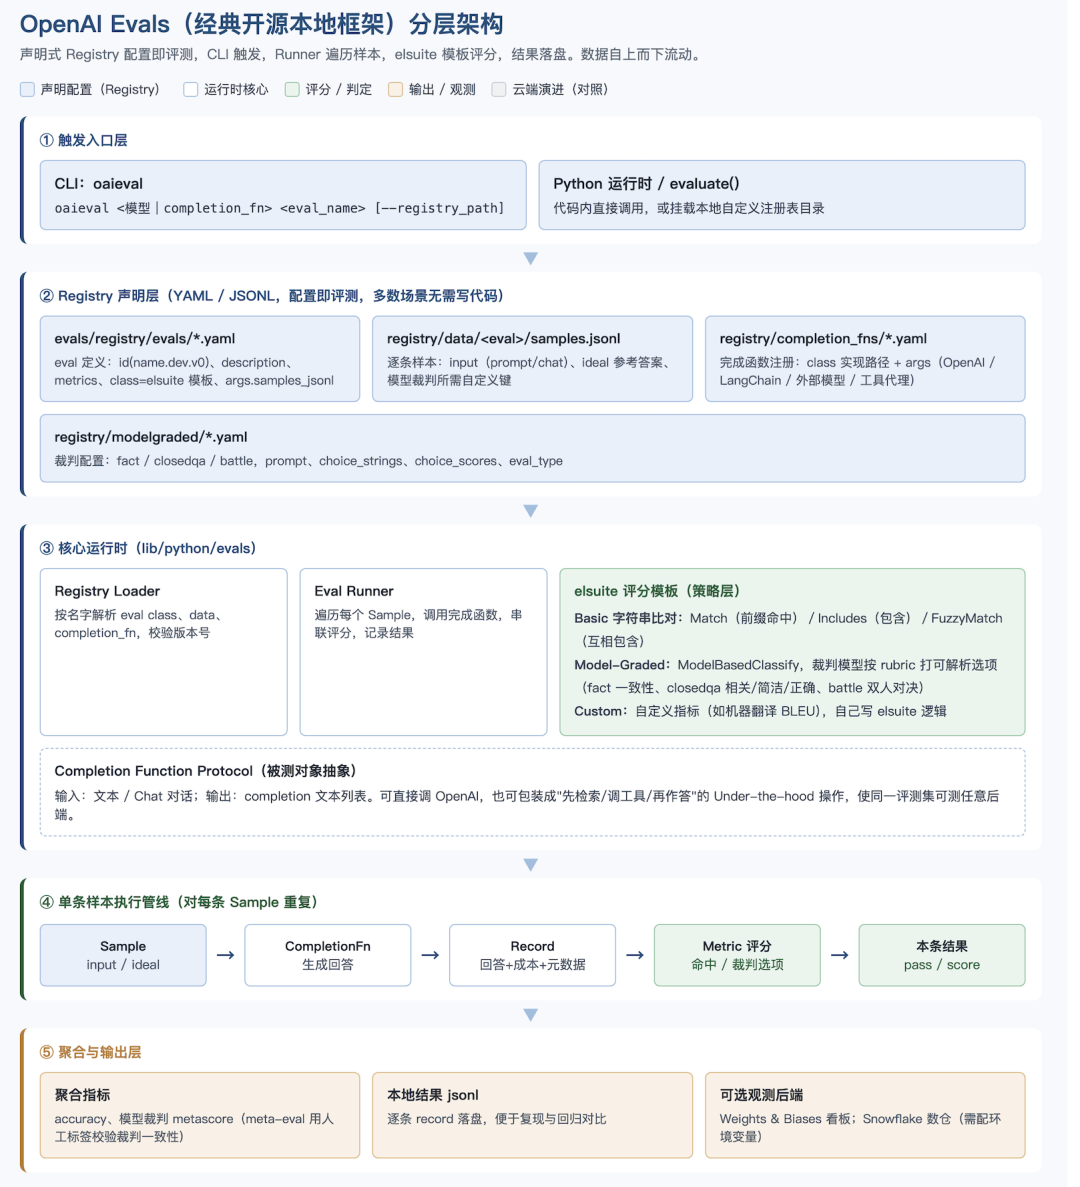
OpenAI Evals 的代码结构非常轻量,其核心设计采用了解耦的插件化架构:
① Registry(注册表系统)
Registry 是整个框架的「资产管理中心」。它通过本地目录结构(默认在 evals/registry/)或远程仓库,将静态资源分类管理:
- data/(数据集):以 JSONL(JSON Lines)格式存储的测试样本。每一行是一个独立的测试用例(Test Case)。
- evals/(评测定义):以 YAML 格式编写的配置文件,将数据集、评测逻辑(Python 类)以及超参数绑定在一起。
- solvers/ 与 completion_fns/(模型与求解器):定义如何与底层大模型交互,或如何组装 Agent 的执行逻辑。
② Eval(评测核心类)
每一个评测任务(Task)在底层都继承自一个基础的评测类(如 Eval)。它主要负责:
- 初始化测试数据流。
- 驱动评测循环(Evaluation Loop)。
- 调用评分函数(Scorer)对模型输出进行量化打分。
③ Solver 与 Completion Fn(求解与补全)
Completion Fn:封装了对 OpenAI API(或其他模型如 Anthropic、本地开源模型)的调用,处理重试、速率限制(Rate Limit)和 Token 统计。
Solver:比 Completion 更高一层,负责把测试输入(Input Prompt)转化为复杂的对话历史,或者包装成支持多轮交互、Function Calling / Tool Use 的 Agent 执行器。
2.2 Registry 系统深度解析:YAML 与 JSONL 规范
在 OpenAI Evals 中,「零代码定义评测(Code-free Evaluation Definition)」是通过 YAML 和 JSONL 的组合实现的。
① 数据集规范:JSONL 格式
每一行必须是一个合法的 JSON 对象,通常包含 input(输入/Prompt)和 ideal(标准答案/期望输出)字段。例如,一个用于测试逻辑推理的测试集 logic_test.jsonl:
{"input": "如果所有 A 都是 B,所有 B 都是 C,那么所有 A 都是 C 吗?请回答是或否。", "ideal": "是"}
{"input": "小明有 3 个苹果,吃了 1 个,又买了两箱(每箱 10 个),请问现在一共有多少个苹果?", "ideal": "22"}
② 任务配置文件:YAML 规范
在 evals/registry/evals/ 目录下创建一个 YAML 文件(例如 my_logic_eval.yaml),将测试集与对应的评测算法绑定:
my_custom_logic_eval:
    id: my_logic_eval.val.v0
    metrics: [accuracy]
    eval_spec:
        class: evals.evals.match:MatchEval
        completion_fns: [gpt-4o]
        args:
            samples_jsonl: logic_test.jsonl
id:该评测任务的全局唯一标识符,可以通过命令行直接调用:oaieval my_custom_logic_eval gpt-4o。
class:执行该评测的 Python 类(例如基础匹配评测 MatchEval 或自定义的复杂评测类)。
completion_fns:指定本次评测挂载的目标被测模型。
2.3 评测执行流程(Execution Flow)全景拆解
当我们在终端执行 oaieval 命令时,框架内部会严格按以下 5 个阶段推进:
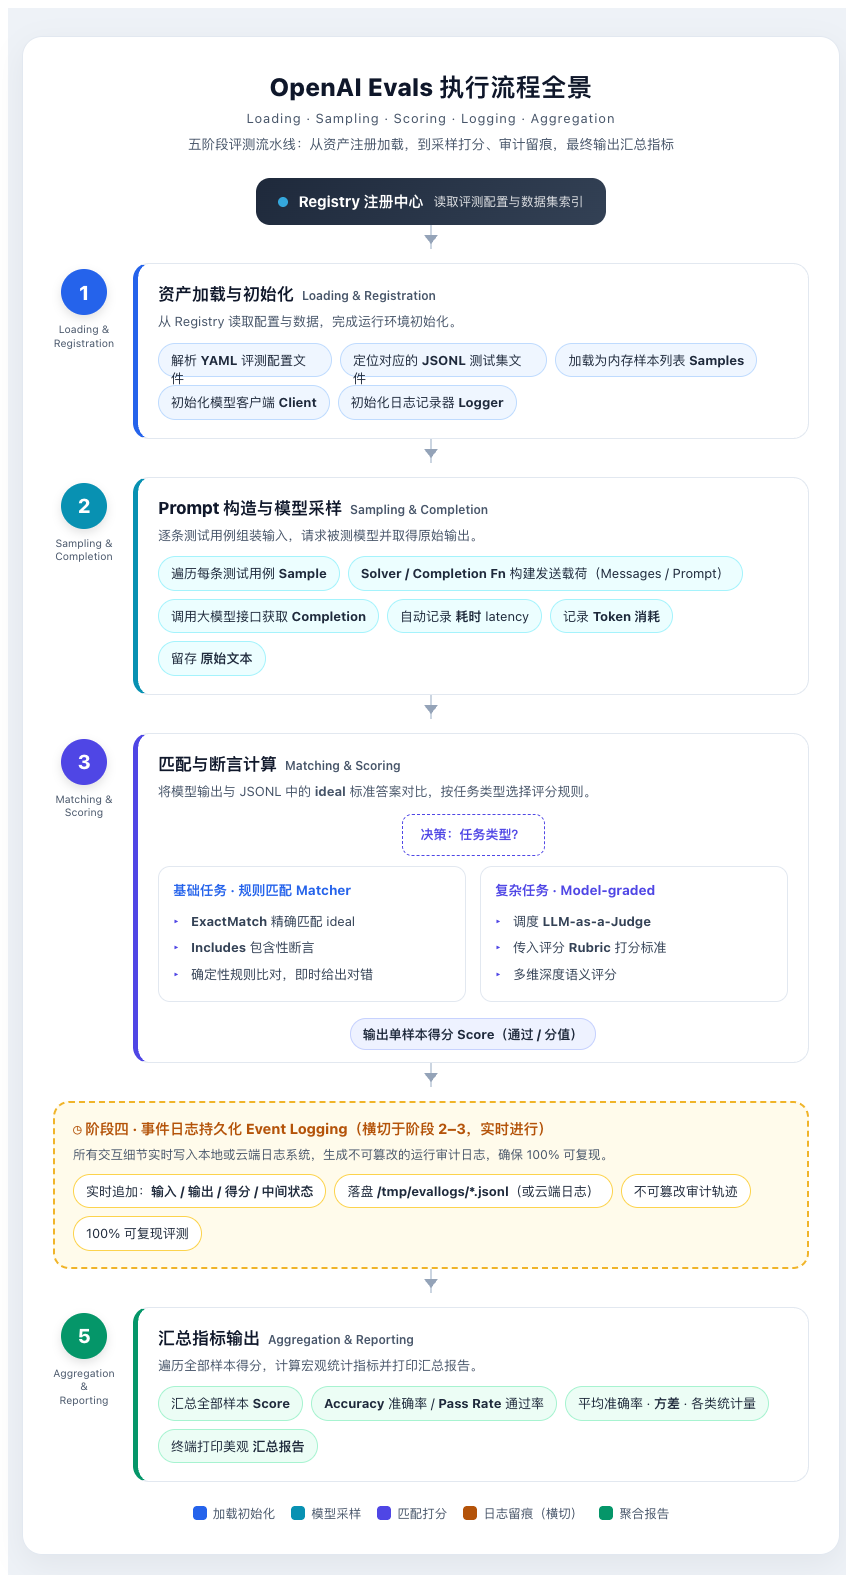
- 阶段一:资产加载与初始化(Loading & Registration)——从 Registry 读取配置与数据。解析 YAML 配置文件,定位对应的 JSONL 测试集文件,将其加载为内存中的样本列表(Samples)。同时初始化模型客户端(Client)与日志记录器(Logger)。
- 阶段二:Prompt 构造与模型采样(Sampling & Completion)——组装输入并请求被测模型。对每一条测试用例,通过 Solver 或 Completion Fn 构建最终的发送载荷(Messages / Prompt),调用大模型接口获取原始输出(Completion)。框架会自动记录耗时、Token 消耗及原始文本。
- 阶段三:匹配与断言计算(Matching & Scoring)——应用 Matcher 或 Model-graded 规则。将模型的输出与 JSONL 中的 ideal(标准答案)进行对比。基础任务使用 ExactMatch 或 Includes;复杂任务则调度 LLM-as-a-Judge 传入评分 Rubric 进行深度打分。
- 阶段四:事件日志持久化(Event Logging)——生成不可篡改的运行审计日志。所有交互细节(输入、输出、得分、中间状态)会被实时写入本地或云端的日志系统(通常保存在 /tmp/evallogs/ 下的 JSONL 文件中),确保每次评测具备 100% 的可复现性。
- 阶段五:汇总指标输出(Aggregation & Reporting)——计算整体 Accuracy、Pass Rate 等宏观指标。遍历所有测试样本的得分,计算平均准确率、方差及各类统计指标,并在终端打印出美观的汇总报告。
2.4 核心代码剖析:自定义一个基础 Eval
为了让架构落地,我们可以看一个简化的 Python 自定义 Eval 实现逻辑。OpenAI Evals 的评测类核心通常继承自 Eval 基类:
import inspect
from evals.api import CompletionFn
from evals.eval import Eval
from evals.record import RecorderBase

class SimpleMatchEval(Eval):
    def __init__(self, completion_fns: list[CompletionFn], samples_jsonl: str, *args, **kwargs):
        super().__init__(completion_fns, *args, **kwargs)
        self.samples_jsonl = samples_jsonl
        # 加载 JSONL 测试集
        self.samples = self.get_samples(samples_jsonl)

    def eval_sample(self, sample: dict, rng):
        # 1. 提取输入与标准答案
        prompt = sample["input"]
        ideal = sample["ideal"]
        # 2. 调用模型生成结果
        completion = self.completion_fn(prompt=prompt)
        # 3. 执行断言匹配 (Matcher)
        matched = ideal.strip() in completion.strip()
        # 4. 记录详细日志
        self.recorder.record_match(matched, expected=ideal, gm_output=completion)
        return {"accuracy": float(matched)}

    def run(self, recorder: RecorderBase):
        # 驱动整体评测循环
        samples = self.samples
        scores = [self.eval_sample(sample, None) for sample in samples]
        # 计算并返回最终聚合指标
        return {"accuracy": sum(s["accuracy"] for s in scores) / len(scores)}
Model-graded Evals:LLM-as-a-Judge 深度解析与实战
在复杂的大语言模型与 Agent 应用场景中,传统的确定性指标(如 ExactMatch、Includes 或基于词表重合度的 BLEU/ROUGE)显得捉襟见肘。例如,当评估一段开放式长文总结、创意写作、代码重构方案或 Agent 的多步骤推理时,标准答案往往不是唯一的。
Model-graded Evals(模型辅助评测 / LLM-as-a-Judge)正是 OpenAI Evals 框架最具革命性的设计。它通过引入一个能力更强、表现更稳定的裁判模型(Judge Model,通常为 GPT-4o 或更高级别的模型),对被测模型(Client Model)的输出进行语义级、多维度的自动化量化打分。
3.1 Model-graded Evals 的底层原理与工作机制
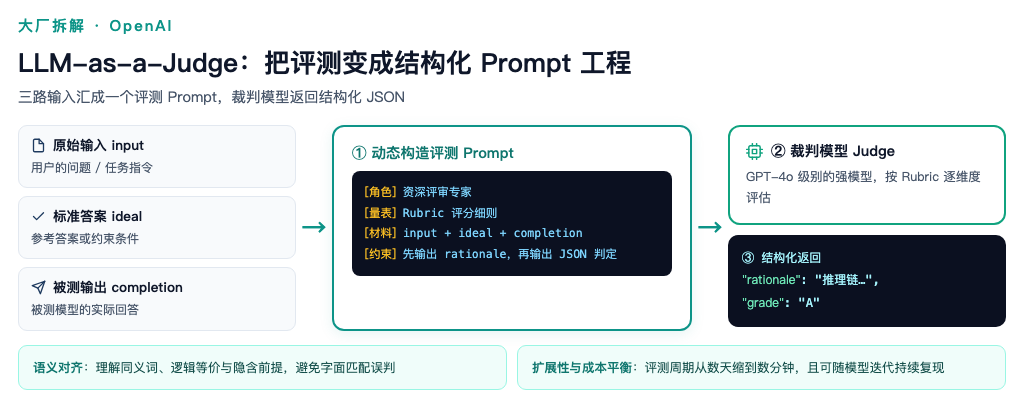
LLM-as-a-Judge 的核心思想是将评测任务本身转化为一个结构化的 Prompt 工程问题。
- 核心运行步骤
收集上下文:评测引擎收集测试样本的原始输入(input)、标准参考答案或约束条件(ideal)以及被测模型的实际输出(completion)。
动态构造评测 Prompt:将上述内容填入预定义的评测模板中。该模板包含明确的角色设定、打分标准(Rubric)以及对输出格式的严格约束(通常要求输出 JSON 格式,包含推理过程 rationale 和判定结果 score/grade)。
调用裁判模型:向裁判模型(如 gpt-4o)发送该 Prompt。
解析与清洗:利用正则化或结构化解析器(如 JSON Mode),从裁判模型的文本回复中提取出最终得分与判定理由。
- 为什么选择模型作为裁判?
语义对齐(Semantic Alignment):能够理解同义词、逻辑等价性、隐含前提和语境,避免了传统字面匹配的误判。
扩展性与成本平衡:虽然调用 GPT-4 作为裁判有一定成本,但相比于大规模人工评估(Human-in-the-loop),它将评测周期从「数天」缩短至「数分钟」,且可随着模型迭代持续复现。
3.2 Rubric 设计方法论与工程实践
在 Model-graded 评测中,评测 Prompt(即 Rubric,评分量表)的质量决定了评测结果的生死。设计不当的 Rubric 会导致裁判模型出现「宽松倾向」「幻觉打分」或「随机性过高」。
一个工业级的 Rubric 必须包含以下四大核心要素:
- 明确的角色与权限定义(Role & Persona)
赋予裁判模型客观、严谨、不偏不倚的专家身份。
「你是一个资深的软件工程架构评审专家,负责评估生成代码的安全性、可维护性及逻辑正确性。」
- 多维度评分细则(Granular Grading Criteria)
切忌只给一个笼统的「请打分(1-5)」。必须为每个分数段制定可观测的硬性行为特征(Behavioral Anchors):
分数 5(优秀):完全满足需求,代码无内存泄漏风险,边界条件处理完整,命名规范。
分数 3(及格):满足核心功能,但存在未处理的边界异常,或代码复用性较差。
分数 1(不及格):逻辑存在根本性错误,或未能实现指定核心功能。
- 强制要求「思考链(Chain-of-Thought, CoT)优先」
要求裁判模型在输出最终结论前,必须先输出详细的分析推理过程(rationale)。这能显著提高模型打分的准确性与稳定性:
「在得出最终判定前,请在 rationale 字段中逐一比对模型的输出与标准答案的异同,指出具体的亮点或硬伤。」
- 格式硬约束(Structured Output)
强制要求输出为标准 JSON,便于下游自动化脚本解析:
{
    "rationale": "模型的输出正确识别了边界条件...",
    "grade": "C"    // 或符合特定区间的数值
}
3.3 OpenAI Evals 中的内置配置:ModelGradedSpec
在 OpenAI Evals 框架中,可以通过 YAML 文件直接声明一个基于模型的评测任务,而无需编写复杂的 Python 逻辑。
YAML 配置范例(model_graded_eval.yaml):
factuality_eval:
    id: factuality_test.val.v0
    metrics: [model_graded_accuracy]
    eval_spec:
        class: evals.evals.modelgraded.classify:ModelBasedClassify
        completion_fns: [gpt-3.5-turbo]
        args:
            # 指定裁判模型
            model: gpt-4o
            # 评分提示词模板的路径或内联定义
            prompt: factuality_judgement
            choices:
                - "A"    # 回答完全准确,无幻觉
                - "B"    # 回答包含部分事实错误或无关信息
                - "C"    # 回答完全错误
其中,prompt 对应系统注册表中的一个 Prompt 模板文件,定义了如何把 input、ideal 和 completion 组合并传给 gpt-4o 进行多分类或二分类判定。
3.4 编写自定义的模型辅助评分函数(Python 实战)
在更复杂的 Agent 评测场景中(如评估 Agent 生成的多步推理轨迹),我们需要编写自定义的 Python 评分函数。以下是一个生产环境级别的自定义 Model-graded Scorer 实现框架:
3.5 Model-graded Evals 的常见陷阱与规避策略
在实际落地大模型与 Agent 评测时,必须警惕以下工程隐患:
- 裁判模型的位置偏差(Position Bias)
现象:当需要裁判模型在多个候选答案中对比(A/B Testing)时,模型往往更倾向于选择排在前面的答案。
对策:在评测多答案对比时,采用交叉对比(Swap Test)策略——交换 A 和 B 的位置运行两次,结果一致才计入有效分。
- 冗长偏好偏差(Verbosity Bias)
现象:裁判模型通常会给那些「写得更长、更有气势」但实际上包含废话的回答打更高分。
对策:在 Rubric 中明确加入负向约束:「如果回答包含冗余、车轱辘话或不必要的长篇大论,应当在分数中予以扣除。」
- 成本与延迟控制
对策:在开发调试阶段,使用较小、较便宜的模型(如 gpt-4o-mini)作为代理裁判进行快速迭代;在基准测试(Benchmark)发布和最终验证阶段,再切换到高精度的 gpt-4o。
面向 AI Agent 的轨迹评估与高级扩展
随着大语言模型应用从「单轮文本生成」全面迈向「多步自主决策的 AI Agent」,传统的评测范式遭遇了根本性的局限。在传统的评测中,我们只关心 Final Output(最终输出)是否正确。然而,对于一个复杂的 Agent 而言:
即使最终答案碰巧蒙对了,中间的推理过程可能已经错漏百出(例如:陷入死循环、调用了错误的工具、伪造了不存在的参数)。
或者是中间步骤极其完美,但由于外部 API 瞬时超时导致最终任务失败。
因此,面向 AI Agent 的评测必须从「终态评估(State Evaluation)」升级为「全轨迹评估(Trajectory Evaluation)」。
4.1 Agent 评测的核心挑战
与静态大模型评测相比,Agent 评测面临三个高维度的工程挑战:
组合爆炸的决策路径(Combinatorial Explosion of Paths):在多步任务中,Agent 在第 t 步的选择会直接影响第 t+1 步的环境状态。错误一旦发生,后续的整个轨迹都会发生偏离。评测系统需要能够识别「错误是在哪一步首次引入的」。
环境的动态性与副作用(Dynamic Environments & Side Effects):Agent 经常需要调用真实世界的工具(如执行 SQL 写入、调用支付接口、操作文件系统)。如何在不污染生产环境的前提下,为 Agent 提供安全、可隔离、可重置的评测沙箱(Sandboxing)?
长程规划与死循环检测(Long-horizon Planning & Loop Detection):Agent 经常会陷入自我重复的死循环(例如反复调用同一个工具且传入完全相同的无效参数)。评测框架必须具备对「认知死锁」的捕捉能力。
4.2 轨迹评估(Trajectory Evaluation)的架构与设计模式
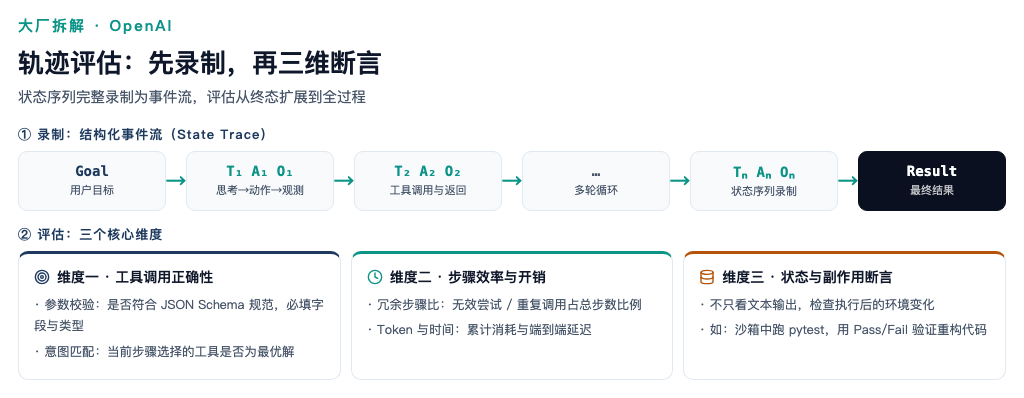
轨迹评估的核心,是将 Agent 在执行任务时产生的状态序列(State Trace)完整录制下来,形成一个结构化的事件流:
Trajectory = [ (Goal),
              (Thought₁, Action₁, Observation₁),
              ...,
              (Thoughtₙ, Actionₙ, Observationₙ),
              (Final Result) ]
在 OpenAI Evals 的思想框架下实现 Agent 轨迹评估,通常分为以下几个核心维度:
维度一:工具调用正确性(Tool Call Correctness)
参数校验(Argument Schema Validation):检查 Agent 传递给 Tool 的参数是否符合 OpenAPI/JSON Schema 规范,是否存在必填字段缺失或类型错误。
意图匹配(Intent Matching):在当前步骤下,Agent 选择的工具是否是最优解(例如:在需要查询实时天气时,是否正确调用了 get_weather 而非盲目猜测)。
维度二:步骤效率与开销监控(Efficiency & Cost Metrics)
冗余步骤比(Redundancy Ratio):计算轨迹中无效尝试、重复调用或错误重试的步数占总步数的比例。
Token 与时间开销:评估完成该任务所消耗的累计 Token 数及端到端延迟。
维度三:状态机与副作用断言(Environment State Assertions)
不仅看文本输出,还要检查任务执行后的环境变化。例如:在测试一个代码重构 Agent 时,评测脚本会在沙箱中运行单元测试套件(pytest),直接用客观的 Pass/Fail 来验证 Agent 修改的代码是否真正通过了编译与测试。
4.3 实战演练:构建一个面向 Agent 轨迹的 Evaluator
下面是一个用 Python 实现的轻量级 Agent 轨迹评估器,它能够自动检测 Agent 在多轮交互中是否存在无限死循环以及关键工具调用遗漏:
import json

class AgentTrajectoryEvaluator:
    def __init__(self, required_tools: list[str], max_allowed_steps: int = 10):
        self.required_tools = required_tools
        self.max_allowed_steps = max_allowed_steps

    def evaluate_trajectory(self, trajectory: list[dict]) -> dict:
        """评估 Agent 的执行轨迹,返回多维度的诊断报告"""
        total_steps = len(trajectory)
        # 1. 检查是否超时/超步数
        exceeded_steps = total_steps > self.max_allowed_steps
        # 2. 提取所有被调用的工具名称
        executed_tools = []
        tool_call_signatures = []
        for step in trajectory:
            if "tool_call" in step:
                tool_name = step["tool_call"]["name"]
                tool_args = json.dumps(step["tool_call"]["args"], sort_keys=True)
                executed_tools.append(tool_name)
                tool_call_signatures.append(f"{tool_name}:{tool_args}")
        # 3. 检查死循环(连续调用完全相同的工具和参数)
        has_infinite_loop = False
        if len(tool_call_signatures) != len(set(tool_call_signatures)):
            # 存在重复的工具调用签名
            # 进一步检查是否有连续完全相同的行为
            for i in range(len(tool_call_signatures) - 1):
                if tool_call_signatures[i] == tool_call_signatures[i + 1]:
                    has_infinite_loop = True
                    break
        # 4. 检查是否遗漏了必要的关键工具
        missing_tools = [tool for tool in self.required_tools if tool not in executed_tools]
        # 5. 综合评分计算
        score = 1.0
        if exceeded_steps:
            score -= 0.3
        if has_infinite_loop:
            score -= 0.5
        if missing_tools:
            score -= 0.4 * (len(missing_tools) / len(self.required_tools))
        score = max(0.0, score)
        return {
            "total_steps": total_steps,
            "executed_tools": executed_tools,
            "missing_tools": missing_tools,
            "has_infinite_loop": has_infinite_loop,
            "exceeded_steps": exceeded_steps,
            "trajectory_score": score,
            "passed": score >= 0.7
        }
4.4 在 Evals 中集成 Agent 求解器(Solver)与评测循环
为了将上述轨迹评估逻辑无缝嵌入到类似 OpenAI Evals 的运行框架中,我们需要编写一个自定义 Solver,负责驱动 Agent 的 ReAct(Reasoning and Acting)循环,并将完整的交互过程记录到 Recorder 中:
class ReActAgentEval:
    def __init__(self, agent_runner, evaluator: AgentTrajectoryEvaluator):
        self.agent_runner = agent_runner
        self.evaluator = evaluator

    def run_evaluation_sample(self, sample: dict) -> dict:
        user_goal = sample["input"]
        expected_ideal = sample["ideal"]
        # 1. 启动 Agent 执行,捕获全轨迹
        trajectory, final_answer = self.agent_runner.run(user_goal)
        # 2. 调用轨迹评估器进行多维度诊断
        evaluation_report = self.evaluator.evaluate_trajectory(trajectory)
        # 3. 结合终态内容进行文本比对或 Model-graded 判定
        final_match = expected_ideal.strip() in final_answer.strip()
        evaluation_report["final_answer_match"] = final_match
        # 4. 综合判定
        overall_success = evaluation_report["passed"] and final_match
        evaluation_report["overall_success"] = overall_success
        return evaluation_report
优缺点评估与现代评测生态演进
回顾前四个模块,我们系统拆解了 OpenAI Evals 的底层哲学、核心架构、Model-graded 评测以及面向 Agent 的轨迹评估。作为现代 LLM 评测的「开山鼻祖」,OpenAI Evals 奠定了无数设计规范,但在真实的工业级研发(特别是复杂的 AI Agent 落地)中,它也暴露出了一些局限性。
同时,过去几年中,以 LangSmith、Arize Phoenix、Braintrust 和 Promptfoo 为代表的现代可观测性(Observability)与评测平台蓬勃发展。本模块将深度剖析 OpenAI Evals 的局限,并对比现代生态的演进路径。
5.1 OpenAI Evals 的核心局限性
尽管思想超前,但将 OpenAI Evals 直接应用于企业级复杂系统(如研发自动化 Agent 或分布式存储控制面 Agent)时,会面临以下现实痛点:
- 重静态离线跑分,轻生产态持续监控(Offline vs. Online Gap)
OpenAI Evals 本质上是一个离线批处理测试运行器(类似传统的 pytest 或单元测试)。它依赖预先写好的 JSONL 数据集。
然而,复杂的 AI Agent 在生产环境中面对的是长尾、不可预测的真实用户输入。Evals 缺乏将「生产环境中的线上交互(Production Traces)」一键转化为回归测试用例(Regression Test Cases)的敏捷闭环。
- 分布式与大规模并发支持不足
原生 Evals 的执行引擎对本地运行和基础文件日志(JSONL)依赖较重,在需要高并发、分布式并行评测海量 Agent 轨迹时,缺乏原生集群调度和高效的向量化检索支持。
- 协作看板与可视化交互缺失
Evals 早期版本主要通过命令行输出和本地日志查看结果,缺少面向跨职能团队(产品经理、安全合规、研发)的直观 Web 协作看板(Dashboard),无法直观对比多次迭代间的指标漂移。
- 状态隔离与沙箱管理空白
对于涉及复杂工具调用(如数据库读写、文件修改)的 Agent,Evals 框架本身没有提供标准化的沙箱(Sandbox)环境管理和自动回滚机制。
5.2 现代 AI 评测与可观测性生态全景对比
为了克服上述局限,现代评测生态将「可观测性(Tracing)」与「评测(Evaluation)」深度融合。下表对主流评测工具进行了多维度对比:
| 维度 / 框架 | OpenAI Evals | LangSmith (LangChain) | Arize Phoenix | Braintrust | Promptfoo |
|---|---|---|---|---|---|
| 核心定位 | 开源基准评测框架 | 端到端 LLM 应用生命周期与可观测性 | 开源 AI 可观测性与嵌入式评测(专注于嵌入向量与评估) | 企业级高性能评测与数据管理平台 | 命令行优先的 Prompt 与安全红蓝对抗测试 |
| 评测驱动 | 声明式 YAML + JSONL 静态数据集 | SDK 埋点 + 生产轨迹回放 + 数据集标注 | OpenTelemetry 自动埋点 + 实时评估 | 极速的数据集管理、在线/离线混合评测 | CI/CD 自动化集成、断言驱动测试 |
| Agent 轨迹追踪 | 弱(需自定义 Solver 与记录) | 极强(原生支持 LangGraph/Agent 步骤深度追踪) | 强(依托 OpenTelemetry 实现分布式链路追踪) | 强(支持复杂的多步 LLM 调用与工具轨迹) | 中(侧重单轮输出与安全护栏) |
| LLM-as-a-Judge | 原生支持(ModelGradedSpec) | 内置丰富 Evaluators(Correctness, Hallucination 等) | 提供开箱即用的评测器与嵌入式分析 | 高性能、低延迟的自定义评估函数支持 | 支持基于断言与模型的混合评分 |
| 适用场景 | 经典基准测试研究、学术对齐 | 复杂的 Agent 应用开发、企业级监控 | 语义搜索评估、RAG 系统调优、开源观测 | 大规模大模型产品团队的持续集成评测 | 快速 Prompt 迭代、CI 管道安全检查 |
5.3 现代评测生态的核心演进趋势
从 OpenAI Evals 到现代评测平台的演进,标志着 AI 软件工程正在经历三大范式转变:
- 趋势一:从「静态基准测试」转向「动态数据飞轮(Data Flywheel)」
现代评测不再仅仅依赖固定的标准数据集(如 MMLU 或手写 JSONL),而是将生产环境中的真实失败案例(Production Failures)作为最高优先级的测试资产:
Production User Interaction
    --Tracing-->     Capture Failure Case
    --Annotation-->  New Evaluation Dataset
当用户在使用 Agent 时遇到幻觉或死循环,系统自动将该条轨迹捕获并打上标签,一键转化为回归测试用例,从根本上防止同类错误再次发生。
- 趋势二:深度集成 OpenTelemetry 与分布式追踪
现代评测工具(如 Phoenix)全面拥抱 OpenTelemetry 标准。不再需要开发者手动去拼装 Recorder 日志,而是通过无侵入式的 SDK 自动拦截所有大模型调用、向量检索(RAG Retrieval)和 Tool Call,形成完美的有向无环图(DAG)轨迹。
趋势三:安全与红蓝对抗(LLM Red Teaming)的自动化
- 随着 Agent 拥有越来越多的操作系统或业务写权限(Tool Use),评测的边界从「答得对不对」扩展到了「安不安全」。
- 现代工具(如 Promptfoo 等)将自动化安全性扫描、提示词注入(Prompt Injection)防御测试直接集成进 CI/CD 流水线。
5.4 总结:站在巨人的肩膀上
OpenAI Evals 的伟大之处,在于它向整个软件工程界证明了:大模型的行为虽然具有概率性,但其评测流程依然可以被代码化、声明化和自动化。
大模型的行为虽然具有概率性,但其评测流程依然可以被代码化、声明化和自动化。
无论您未来选择自己基于 Evals 思想手写定制评测框架,还是引入 LangSmith、Phoenix 或 Braintrust 等现代化平台,前四个模块所沉淀的核心心智——Registry 资产解耦、严苛的 Model-graded Rubric 设计、以及细粒度的 Agent 轨迹断言——永远是构建高可靠 AI Agent 系统的基石。
JOTO 企业落地观察
- 企业部署智能体系统时,需将评测嵌入持续交付流程。OpenAI Evals 的 Registry 驱动架构允许团队将测试数据、配置与评分逻辑分离管理,使 QA 工程师可独立维护 JSONL 测试集、产品人员更新 YAML 评测定义,无需修改代码即可新增场景,降低跨职能协作门槛。
- 在智能体工程中,Agent 的执行轨迹(如工具调用序列、思考链、重试行为)比最终输出更关键。Evals 的 Solver 抽象支持封装多轮交互与 Function Calling,配合 Model-graded Scorer 可对中间步骤合理性建模,使团队能针对‘是否选错工具’或‘是否陷入无效循环’设计可审计的断言规则。
- RAG 知识工程依赖对检索-生成链路的细粒度归因评估。Evals 的 Model-graded Evals 能通过定制 Rubric 判断答案是否真正依据检索片段生成、是否存在幻觉引用,而非仅匹配关键词;其事件日志完整记录输入 Prompt、检索上下文、模型输出及裁判打分过程,支撑知识源有效性回溯。
- AI 安全治理要求评测具备不可篡改的审计证据链。Evals 的严格日志规范强制记录每次请求的原始输入、模型响应、Token 消耗及每条样本的 Matcher/Scorer 执行路径,所有字段带唯一标识并持久化为 JSONL,使企业可在合规审查中完整还原某次安全策略测试的全部决策依据与执行痕迹。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们