第 18 篇 · 给 Agent 加上异常检测
本文介绍如何为 AI Agent 构建运行时异常检测机制,涵盖异常定义、日志记录规范、七类检测规则(如连续工具失败、未知工具调用、上下文突增、接近轮次上限等),以及基于 Conversation Event 的状态化检查实现。强调异常检测需覆盖模型行为与工具执行双重维度,并保留完整上下文证据链。
上一篇我们给 Agent 加上了运行指标,可以看到最近的调用量、错误率和耗时。比如工具错误率升高了,我们就知道最近失败的调用变多了,接下来还得打开会话记录,查查哪些调用失败了、当时发生了什么。会话一多,靠我们逐条去查看就比较费时间。有些情况,比如同一个工具反复报错、上下文突然变大,可以先让程序检查出来,再把相关记录标出来,方便我们去查。这一篇我们就来给 Agent 加上这样的异常检测。
一、什么是异常,为什么要记录它
我们说的异常,包括哪些情况
我们先从平时开发的 ERP、CRM、订单等系统说起。比如我们写了一个提交订单的接口,用户填好信息,点击提交,程序校验完数据,把订单存进数据库,再返回提交成功。如果这时候数据库连接断了,订单没有存进去,程序就会报错。
这类异常我们比较熟悉。数据库连接失败、读取文件失败、调用外部接口超时,平时写代码时都会遇到。我们一般会用 try/except 或 try/catch 捕获异常,再决定是重试、结束这次操作,还是把错误继续交给上层处理。
不过,我们这一篇说的异常,范围还要更大一些。比如订单提交平时一秒就完成,这次却等了一分钟,程序虽然没有报错,但是系统还是给出异常警告,我们也得查查为什么这么慢。再比如接口返回成功了,订单金额却算错了,这类问题也需要异常排查。
只要实际运行情况和我们预期的不一样,就需要留意。 至于是不是异常,还得看具体业务。用户下单时库存不足,我们提示他无法购买,这是正常处理,库存明明足够,却因为数据库故障下不了单,就需要排查。查询一张订单和生成一份年度报表,我们能接受的等待时间也不一样。
以前我们是怎么记录异常的
还是提交订单这个例子。保存失败以后,我们可以在页面上告诉用户“提交失败,请稍后重试”。但后台如果也只记录了这一句话,等我们查问题时,还是不知道到底哪里出了错。
所以我们通常会把错误原因和异常堆栈一起写进日志。堆栈里有函数名、文件名和代码行号,我们可以根据这些信息找到报错的位置。除此之外,还要知道错误发生在什么时候,是哪一次请求、处理哪张订单时发生的。
比如我们从一条错误日志里,至少应该能看到这些信息:
时间:2026-09-10 10:23:15
级别:ERROR
请求编号:req-123
操作:保存订单
订单编号:order-456
错误:数据库连接超时
有了请求编号,我们就能继续找这次请求前后的日志。如果一次操作经过了几个服务,也可以用统一的追踪编号把它们关联起来。否则订单服务里一条错误、库存服务里一条错误,我们很难知道它们是不是同一次操作引起的。
系统简单的时候,这些日志可以先记录到文件里,系统服务多了,变复杂以后,我们也可以把它们收集到日志平台,方便统一查询。系统错误突然增多时,再通过监控告警通知我们,不用等用户反馈以后才知道系统出了问题。
前面我们说的慢请求、金额算错这类问题,就不能只靠捕获异常了。我们得另外记录接口耗时,对照业务规则检查金额,发现不符合要求时再留下记录。
为什么要记录异常
假设用户告诉我们“刚才订单提交失败了”,我们拿同样的数据再试一遍,却成功了。数据库可能只是短暂连接不稳定,外部接口也可能偶尔超时,等我们去查的时候已经恢复。如果当时没留下日志,很多问题就只能靠猜。
有记录就不一样了,我们先找到用户那次请求,看看错误发生在哪一步。如果是数据库连接超时,再查同一时间其他请求有没有报同样的错,就能知道是偶发问题,还是那段时间大家都下不了单。
把这些记录积累下来,我们还能发现一些平时不容易注意的问题。比如某个接口总在高峰期超时,或者更新了一版代码以后,同一种错误开始频繁出现
换成 Agent,我们还要记录什么
我们开发 Agent 时,前面这些错误一样会遇到。模型接口可能超时,工具可能没有权限读取文件,外部服务也可能暂时不可用。这些都要把错误原因记下来,并且能找到对应的会话和调用记录。
但 Agent 还有一些不同。以前我们写业务代码,调用哪个接口、参数从哪里来、失败后怎么处理,大多是提前写好的。Agent的很多步骤都是交给模型来决定,排查时我们就得多看一看,是工具本身执行失败了,还是模型调用的方式有问题?
比如模型调用了一个没有注册的工具,我们需要知道它调用的名字是什么、当时有哪些工具可用。如果工具提示参数错误,我们还得看模型当时传了什么参数。如果只保留一句“工具调用失败”,我们就不知道该改工具代码,还是该调整工具说明,让模型知道怎么用。
工具报错以后,Agent 接下来做了什么,也需要查看。读取文件时提示路径不存在,它找到正确路径再读,任务就能继续。如果一直用原路径读取,同样的错误出现了好几次,我们就得查它为什么没有调整做法。只记录最后一次失败,就看不出前面已经重复了多少次。 所以我们还要把相关调用连起来,记录这样的失败出现了几次。
有时候Agent也不报错,一直在运行,就是迟迟做不完。比如模型连续几次既没返回正文,也没有调用工具,或者一个任务跑了很多轮,马上就要达到我们设置的轮次上限。这些情况也要留下记录,方便我们排查它停在了哪一步、前面的轮次都做了什么。否则我们只知道一直没有结果,我们也不知道时间花在了哪里。
除了查看任务是否成功做完,我们还要看它花了多少时间、用了多少 Token。第 15 篇的旅行计划里,路线工具返回了大量内容,上下文从 2,208 Token 增长到了 26,200。那次工具调用是成功的,但后面模型每次请求都可能带着这些内容,输入一下子就多了很多。
如果我们只看成功或失败,这个中间的变化就被我们漏掉了。把增长前后的上下文长度记下来,再找到中间那次工具返回,我们才能看出是不是返回了太多不需要的内容,工具返回的内容是不是完全需要,是否可以压缩后在提供给模型。
这一篇我们先检查运行记录。当前代码实现有重复工具失败、未知工具、接近轮次上限、上下文突增、多次压缩、连续空响应和模型响应过慢七条规则。满足条件就保存一条 anomaly 事件,标出相关记录,方便我们回到会话里排查。规则命中只能说明需要留意,不能直接据此认定任务失败,也不代表已经找到了原因。
这些条件目前都是人工设定的,比如相同工具错误连续出现两次、模型响应超过 60 秒。它们是本项目的初始设置,还需要结合实际任务调整。记录里的 high、medium、low 用来区分关注优先级,不表示程序已经自动算出了故障影响。
下面我们来看看程序怎样保存这些信息,再用它们检查新记录。
二、从运行事件中检查异常
我们来看看当前系统是如何实现异常记录
异常检测仍然使用前面保存的 Conversation Event。主 Agent 的模型请求里有轮次、历史 Token 估算值和压缩信息,模型响应里有正文、工具调用和耗时,工具结果里有工具名称、返回内容和错误标记。
先确定检查哪些事件
这里先区分三个范围。一条会话由 session_id 标识,可以包含多次用户问答。用户每发来一次请求,stream_chat() 就开始一次执行。一次执行可能多次调用模型,iteration 从 1 开始记录这些模型迭代,一轮模型响应又可能包含多个工具调用。子 Agent 还有自己的执行循环和轮次。
当前检测器有两种入口,它们的状态范围不同。
| 入口 | 状态从哪里开始 | 哪些事件参与累计 |
|---|---|---|
运行时检查 detect_in_stream() | 每次 stream_chat() 新建状态 | 本次用户请求中送入检测器的主 Agent 模型请求、模型响应和工具结果 |
历史扫描 detect_in_session() | 每次扫描新建状态,从会话文件开头重算 | 整个会话中的相关事件,包括多次问答和子 Agent 记录,遇到用户消息不会重置状态 |
实时检查从本次用户请求开始计数。用户再发来一条消息,计数就重新开始。历史扫描则从会话文件开头往下读,即使读到下一条用户消息,也会接着前面的计数继续检查。
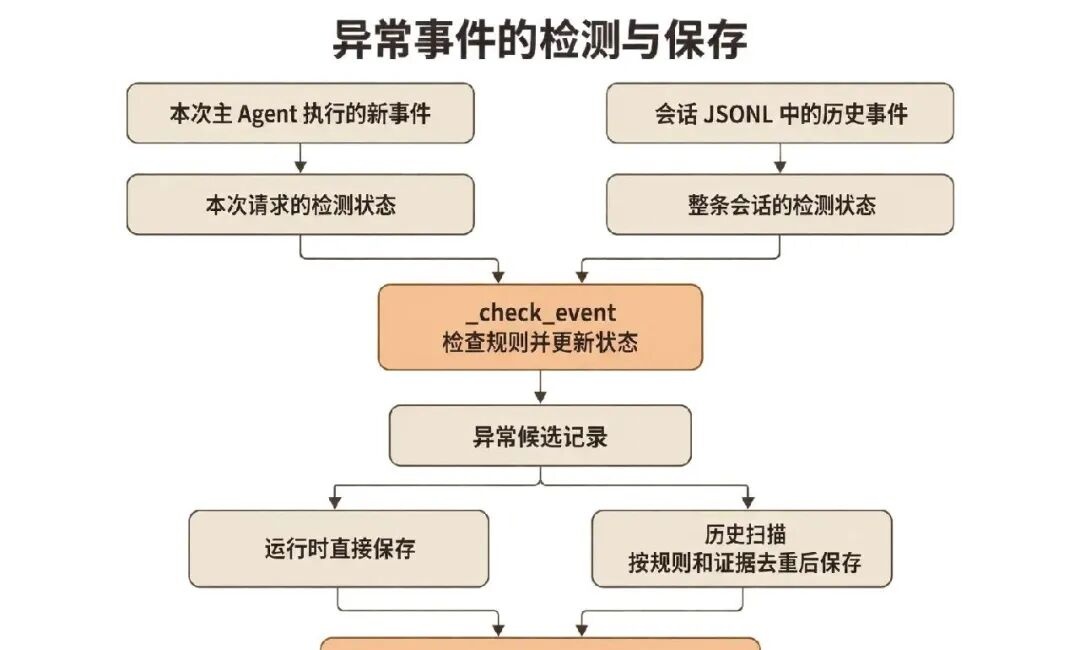
下面用同一次主 Agent 执行中的一组简化事件看一下这个过程,只列出本例关注的请求和工具结果,编号也是为了方便说明。
事件 m1  model_request  history_token_count=1000
事件 t1  tool_result    function_name=read_file  is_error=true  output="文件不存在"
事件 m2  model_request  history_token_count=1800
事件 t2  tool_result    function_name=read_file  is_error=true  output="文件不存在"
读到 m1 时,检测器记住上下文长度是 1000。读到 t1 时,记住 read_file 失败了一次,错误内容是“文件不存在”。
继续读到 m2,上下文从 1000 增长到 1800,增长了 80%,超过当前设置的 50% 阈值,于是产生一条 token_spike。读到 t2 时,相同工具又返回相同错误,连续次数达到 2,再产生一条 repeated_failure。
m1 → 保存上下文长度 1000
 t1 → 保存失败签名,连续失败次数为 1
m2 → 比较前后长度,产生 token_spike,保存新长度 1800
 t2 → 相同失败再次出现,产生 repeated_failure
这里的“连续相同失败”指相邻的工具结果都失败,而且工具名和错误摘要相同。中间出现模型请求不会清空计数;如果插入一次成功的工具结果,计数就会重置;如果换成另一种工具错误,则失败重新计数。
保存前面的状态
StreamDetectorState 里放的是计数、上一次的数值和相关事件编号。下面省略了部分成员。
class StreamDetectorState:
    def __init__(self) -> None:
        self.last_failed_signature = None
        self.failed_streak = 0
        self.failed_streak_event_ids = []

        self.empty_response_streak = 0
        self.compression_count = 0
        self.last_history_tokens = None
        self.last_model_request_event_id = None

        self.near_cap_fired = False
        self.compression_fired = False
事件编号用来保留依据。上下文增长需要前后两条模型请求,连续失败需要对应的工具结果。只有一个“发生异常”的提示,后面就很难找到当时的调用。
两个以 fired 结尾的字段表示是否已经提醒过。比如 Agent 到了第 40 轮时提醒一次接近上限,第 41 轮还满足条件,但不需要再写一条相同提醒。
这份状态属于内存对象,进程重启后不会保留。已经写入 JSONL 的异常记录仍然存在,历史扫描时可以读取原始事件重新计算状态。
三、连续工具失败与未知工具
_check_event() 先根据事件的 type 决定检查哪些字段。遇到 tool_result 时,读取 data.is_error。只有这个值为true,才会进入工具失败的处理分支。
连续相同失败
一次工具失败可能有很多原因。我们先实现一个简单判断,同一个工具连续返回相同的错误摘要,达到两次就记一条高等级异常。
代码用下面两个值组成失败签名,也就是用来比较两次失败是否相同的一组数据。
signature = (function_name, output[:120])
第一个值是工具名称,第二个值是错误输出的前 120 个字符。当前签名和上一次相同,就增加连续次数,不同,就从这次失败重新计数。
if state.last_failed_signature == signature:
    state.failed_streak += 1
    state.failed_streak_event_ids.append(event_id)
else:
    state.last_failed_signature = signature
    state.failed_streak = 1
    state.failed_streak_event_ids = [event_id]
    state.repeated_failure_emitted_at_streak = 0
假设 read_file 先返回“文件不存在”,下一次返回“没有读取权限”,虽然两次都失败,但签名不同,第二次会重新从 1 开始。两个不同工具返回相同错误,也不会被算成同一组连续失败。
这个只是我们当前的实现,你也可以修改实现不同的处理规则,假如只要是相同的工具名称连续失败就记录。
达到阈值以后,代码生成 repeated_failure,严重度为 high。判断条件如下。
if (
    state.failed_streak >= REPEATED_FAILURE_THRESHOLD
    and state.failed_streak != state.repeated_failure_emitted_at_streak
):
    state.repeated_failure_emitted_at_streak = state.failed_streak
    # 生成异常候选记录
REPEATED_FAILURE_THRESHOLD 当前是 2。这里并不是一组连续失败只提醒一次。第二次失败时写一条,第三次连续失败时,次数从 2 变成 3,又会写一条。
相同失败第 1 次  不提醒
相同失败第 2 次  repeated_failure,证据为第 1、2 次结果
相同失败第 3 次  repeated_failure,证据为第 1、2、3 次结果
如果希望一组连续失败只产生一条提醒,可以改成首次达到阈值时触发。当前实现会随着连续次数增加继续留下记录,查看异常数量时需要考虑这一点。
工具执行成功后,代码清空失败签名、连续次数和证据列表。因此下面的序列不会触发连续失败。
read_file 失败 → 任意工具成功 → read_file 再次失败
当前异常说明写着“以相似参数失败”,但实际判断没有比较工具参数。文件里虽然有 _args_signature() 辅助函数,规则并没有调用它。两次读取不同路径,只要工具名和错误输出前 120 个字符相同,也会被归为相同失败。
此外,同一轮模型响应可以一次返回多个工具调用。如果其中两个调用连续返回相同错误,也会命中规则。
所以当前规则只能帮助我们找到重复出现的工具错误,具体实施的规则大家可以按照项目的实际情况处理。
调用了不存在的工具
同一个 tool_result 还会检查错误输出里有没有“未知函数”或“未知工具”。
if "未知函数" in output or "未知工具" in output:
    # 生成 unknown_tool,严重度为 high
例如模型返回了一个没有注册的函数名,工具分发代码找不到它,就可能产生这种错误。也可能是工具配置已经修改,但会话历史里仍然保留着旧工具名称。
这条规则每遇到一条匹配的错误结果都会触发。连续两次调用同一个未知工具,第二条结果可能同时产生 unknown_tool 和 repeated_failure,分别标记未知工具错误和重复错误。因此这里两条异常记录不一定代表两个独立故障,它们可能是同一个错误引起的。
当前判断依赖中文错误文本。如果工具分发器换了错误文案,规则可能漏检,其他错误文本只要包含这些词,也可能被误归类。例如分发器的“未知函数类型”也会匹配“未知函数”,但它表示的并不是函数名没有注册,排查时要看完整错误。后面可以让工具结果带上固定错误码,检测器直接检查错误码,就不用依赖字符串内容。
四、模型轮次、上下文增长与压缩
遇到 model_request 时,检测器会检查三件事情,模型迭代是否接近上限、历史 Token 估算值是否突然增长,以及压缩累计次数是否达到阈值。检测所需的数据来自这条请求事件。
接近循环上限
前面的 Agent 主循环设置了最大模型迭代次数,避免任务一直运行下去。这里的轮次按模型请求计数,一轮可以调用多个工具,因此不等于工具调用次数。异常服务里也保存了一份上限和提醒比例。
MAX_TOOL_ITERATIONS = 50
NEAR_CAP_RATIO = 0.8
当前阈值为 int(50 * 0.8),也就是 40。模型请求中的 iteration 字段用于判断是否达到阈值。
JOTO 企业落地观察
- 对企业部署意味着:Agent 异常检测不能仅复用传统服务的错误日志模式,必须将模型决策链(如工具调用序列、上下文膨胀、空响应轮次)纳入可观测性体系。否则运维团队面对‘任务卡住’只能回溯原始会话,无法快速定位是模型幻觉、工具配置漂移还是上下文失控。
- 对智能体工程而言,异常检测模块的设计直接影响调试效率。文中强调保留事件ID链、失败签名及原始上下文快照,这要求企业构建Agent时必须将可观测性作为核心架构约束,而非事后补丁;否则当异常涉及多跳子Agent协作时,缺乏跨服务追踪能力将导致根因分析成本指数级上升。
- 对RAG知识工程提出新要求:上下文突增(如从2k到26k Token)被列为关键异常,说明检索结果质量直接影响Agent稳定性。企业需在RAG pipeline中嵌入内容密度评估与冗余过滤环节,并将‘检索结果体积’作为可监控指标,避免知识召回成为隐性性能瓶颈。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们