拿下 45.2k Star,记忆准确率 94.6%!Vectorize 开源 Agent 记忆引擎
Vectorize 开源的 Hindsight 是一款面向自主 Agent 的长期记忆引擎,采用分层认知架构与四路混合检索,LongMemEval 测评中达 94.6% 准确率,显著高于 GPT-4o(60.2%)和 Zep(71.2%)。它支持独立记忆库、增量演化信念、跨工具共享,并提供 Python 和终端插件快速集成。
最近登上了 GitHub 热榜的一个新开源项目 Hindsight,目前已经拿下了 45.2K 的 Star。
这个项目的定位是:一款面向自主 Agent 的长期记忆引擎。
它能把记忆拆成事实、经历、信念和心理模型四层,遇到新状态会自动做增量演化,避免无脑覆盖,还能跨终端工具无缝共享。
开源项目简介
Hindsight 是一个由 Vectorize 开源的 Agent 记忆引擎。
它主要想解决 Agent 在长周期任务中容易失忆和前后矛盾的问题。
普通的代码问答或单轮对话通常很快就能结束。复杂的长流程任务会经历很长的执行链路,中间要经过多次工具调用、文件修改、接口联调和故障排查。
任务一长,就会出现麻烦。上下文越来越大,前面的关键指令容易丢。改了配置或者技术选型,前后的记录很容易打架。
即使这次终于排查完了线上故障,下次遇到同类问题,Agent 依然是一张白纸,不会主动沉淀经验。
Hindsight 围绕两个核心设计展开:分层认知架构和四路混合检索。
前者把记忆细分为世界事实、执行经历、观察信念和心理模型;后者负责在检索时把向量、关键词、实体图谱与时序融合在一起。
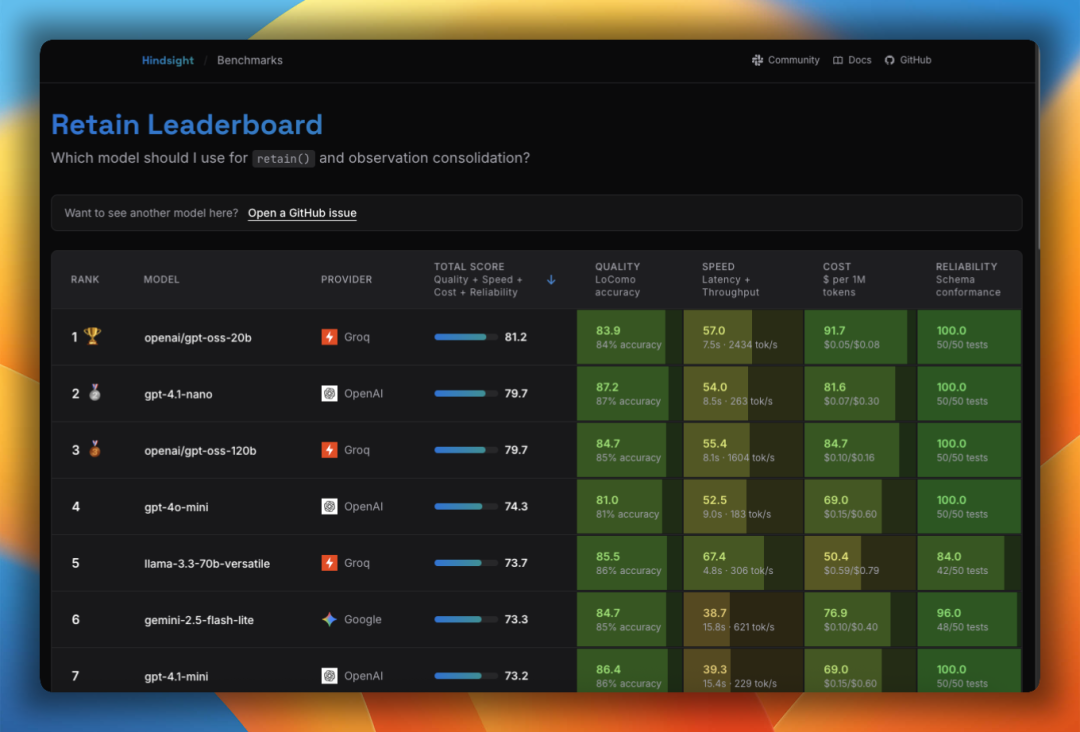
它的官方成绩也挺抢眼。在 LongMemEval 长期记忆评测中,不做记忆处理的原生 GPT-4o 只有 60.2% 的准确率,常见的记忆方案 Zep 是 71.2%,而 Hindsight 拿下了 94.6%。
它是怎么搞定长期记忆的
Hindsight 的功能不少,真正值得关注的是下面这 4 部分。
① 每个 Agent 拥有独立的记忆库
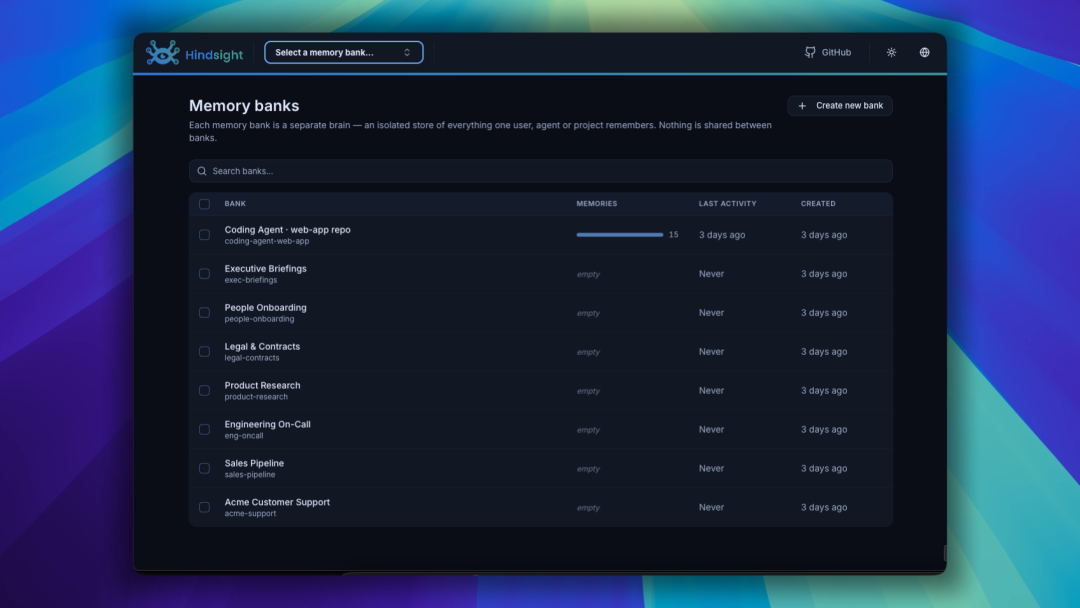
Hindsight 给每个 Agent 或每个项目分配独立的 Memory Bank(记忆库)。
每个记忆库相当于一个隔离的脑区。它不会把所有数据混在一起,而是拆成了四种明确的形态:
- 世界事实(World Facts)存储不可变的客观规则,比如生产数据库端口严禁对外暴露。
- 执行经历(Experiences)记录 Agent 跑过的真实轨迹,比如某次执行脚本因超时被熔断。
- 心理模型(Mental Models)存放特定的常驻规则。比如用户的编码偏好或团队规范,Agent 启动时直接读库加载,零额外推理耗时。
② 像版本控制一样增量演化信念
这是 Hindsight 最具特色的设计:观察信念(Observations)。
后台 worker 会异步提炼事实与经历,形成带证据链的高阶认知。
当新的事实到来时,系统不会粗暴覆盖,而是像代码版本管理一样做增量演化。
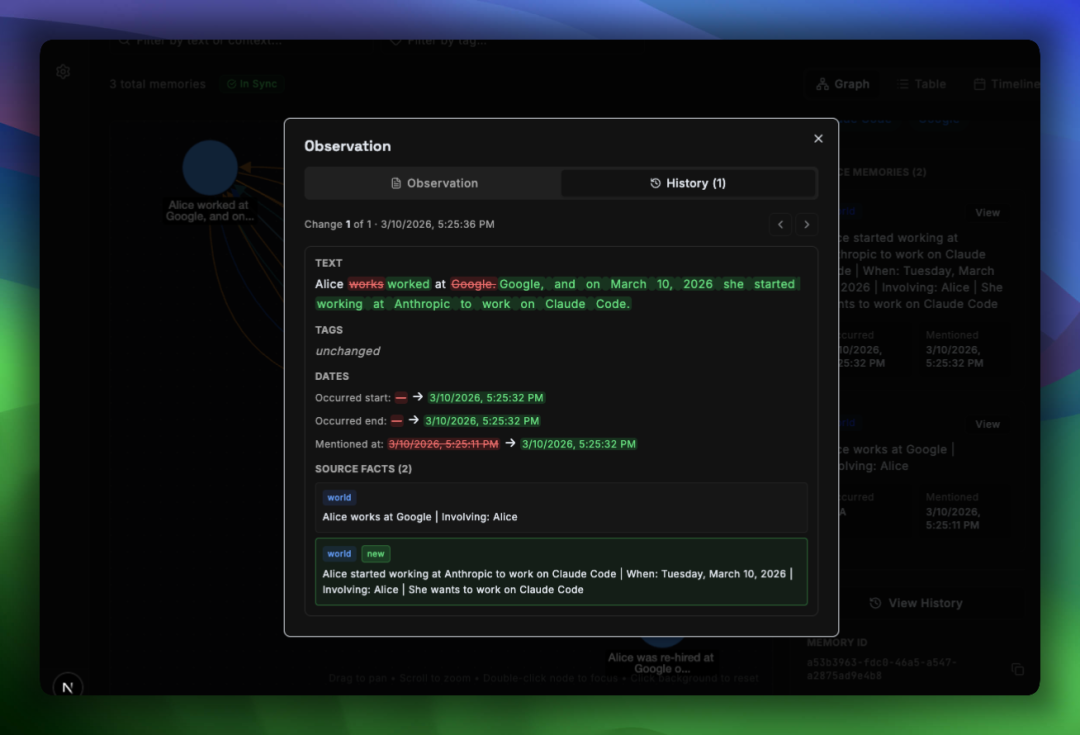
比如控制台里的典型案例:旧事实是 Alice 在 Google 工作,新事实是 Alice 跳槽到 Anthropic 参与 Claude Code 开发。
Hindsight 会自动把原认知标记为已解决的历史状态,把当前认知更新为 Anthropic,同时保留演化过程与时间戳。
这样不仅解决了时序冲突,还能避免单次误判直接推翻长期结论。
③ 四路混合检索与三维星图
传统向量数据库只认语义相似度,遇到精确错误码或时序筛选时经常抓瞎。
Hindsight 的 recall 操作同时发起四路查询:
- 向量语义检索
- BM25 关键词精确匹配(定位错误码和函数名)
- 实体图谱关联
- 时间范围过滤
四路结果通过倒数排名融合(RRF)算法汇总,再经由重排模型筛选出最相关的少数片段注入上下文。
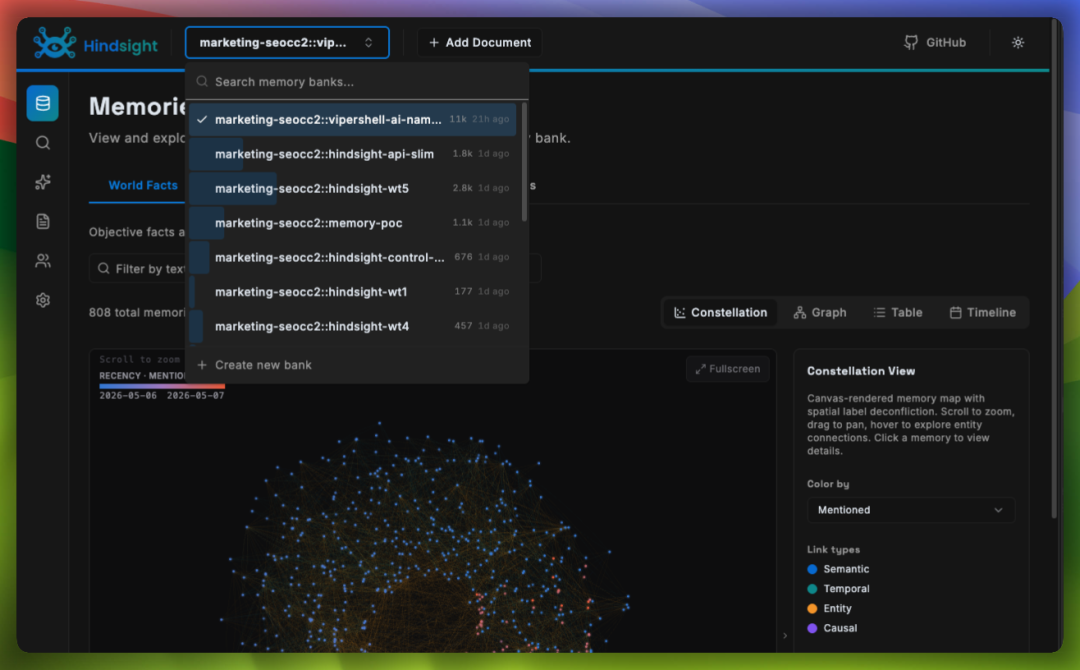
在控制台里,它还提供了三维交互式记忆星图,直观展现语义、时序、实体和因果四类关联链路。
面对复杂决策时,Agent 还能调用 reflect 遍历记忆网络进行逻辑推导,排查潜在矛盾。
④ 跨开发工具无缝共享记忆
Hindsight 不仅能嵌入 Python 代码,还针对开发场景做了终端集成。
通过官方命令,可以一键给本机安装的 Claude Code、Cursor CLI、Codex 等开发工具装上记忆插件。
多个工具可以连接同一个 Memory Bank,共享同一个项目的上下文与经验。
你在 Claude Code 里排查过的模块细节,切换到 Cursor CLI 继续编码时依然生效。
五分钟快速上手
Python 环境中可以通过包装器快速接入:
pip install hindsight-litellm只需包装原有客户端,即可在不改动原有业务逻辑的前提下挂载长期记忆:
from openai import OpenAI
from hindsight_litellm import wrap_openai

# 包装原有客户端,自动绑定独立记忆库
client = wrap_openai(OpenAI(), bank_id="dev-assistant")

# 提问前自动检索注入记忆,调用完成后后台自动沉淀
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "帮我梳理项目上周遗留的技术债务"}],
)
在终端使用多个编程工具时,可以通过官方脚本一键安装插件:
npx @vectorize-io/hindsight-coding-agents install all这里也要留意一下现实限制。
后台在提炼事实和演化信念时需要轻量模型辅助分析,会产生少量的额外 token 消耗。
另外,对于完全没有跨会话需求的单步命令,引入整套系统会增加额外的配置成本。
以前聊 Agent,大家最关心的是 Prompt 怎么写、模型上下文有多长。
现在,同一个模型有没有一套靠谱的记忆系统,表现往往差出一大截。
新旧信息冲突了能不能自动演化,排障失败的经验能不能留下来,常驻规范能不能零推理直接读库,这些都会影响最终的交付质量。
Hindsight 把这些能力放进了一个开箱即用的开源引擎里。
如果你也经常遇到 Agent 多轮交互后失忆、换个配置就前后打架的问题,很建议拉下来试试看。
项目地址:https://github.com/vectorize-io/hindsightJOTO 企业落地观察
- 企业部署长期记忆系统时,需权衡「分层记忆」带来的结构化收益与「增量演化」所需的轻量模型推理开销。Hindsight 将信念演化交由后台异步完成,意味着企业可在不阻塞主任务流的前提下获得认知演进能力,但需预留额外 token 预算。
- 这类系统的取舍在于是否接受「记忆即服务」的架构范式。Hindsight 通过独立 Memory Bank 实现项目级隔离,降低了多 Agent 协同时的记忆污染风险,但要求企业在工程初期即定义清晰的项目边界与记忆归属策略。
- RAG 知识工程中,四路混合检索(向量+关键词+图谱+时序)显著提升了对错误码、函数名等结构化信号的召回鲁棒性。企业若已有成熟日志与代码知识库,可将 Hindsight 作为统一记忆接入层,替代多套独立检索组件。
- AI 安全治理需关注记忆演化过程的可追溯性。Hindsight 对观察信念保留完整演化链与时间戳,为企业审计 Agent 决策依据提供了基础支撑,但其后台 worker 的分析逻辑透明度仍依赖 Vectorize 的文档披露程度。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们