英伟达发布Nemotron 3.5 Lightning与Switchyard:双开源方案降低AI智能体运行成本
英伟达推出300亿参数开源混合专家模型Nemotron 3.5 Lightning及开源路由库Switchyard,通过动态任务路由与低成本专用模型协同,在保持前沿任务能力前提下将基准成本降至Opus 4.8的约三分之一。
运行全天候 AI 代理的企业始终面临相同的权衡困境:将每项任务都发送至前沿模型,费用便会迅速攀升;而构建定制化路由逻辑,将简单任务分发至成本更低的模型,则又会演变成一项独立的工程任务——每次工作流变更时,该任务都需持续维护。
英伟达(Nvidia)提出了一种可同时触及该问题两端的解决方案。该公司将于周二发布 Nemotron 3.5 Lightning,这是一款专为高吞吐量、专业化代理任务打造的 300 亿参数开源混合专家(mixture-of-experts)模型;同时发布的还有 NeMo Switchyard,一个开源库,可将代理工作流的每一步路由至最适合该步骤的模型。
关键性能数据如下:据英伟达称,Lightning 的输出速度最高可达同类模型的 4 倍,在同等准确率下完成代理任务的速度比 Qwen3.6-35B 快约 30%。通过 Switchyard 配合使用时,英伟达表示该组合在保持前沿级任务完成能力的同时,基准测试成本降至单独运行 Opus 4.8 的约三分之一。
此次发布时间恰逢行业数月来最密集的开源权重模型发布期。自今年春季以来,阿里巴巴(Alibaba)、月之暗面(Moonshot)、智谱(Zhipu)和深度求索(DeepSeek)均已从中国推出具备竞争力的开源模型,其中多个模型在性能上达到或接近前沿水平,同时在模型规模或价格方面压低了美国实验室的水平。Meta 亦通过发布其自有 300 亿参数开源代理模型加剧了这一竞争压力。 Muse Glimmer。开源权重模型已在数月内从差异化优势转变为入场基本门槛,而英伟达此次发布正精准落于这一转变之中,而非领先于该趋势。
模型与路由器的配对本身即是核心要点。单靠一个模型无法解决成本问题,仅靠一个路由器则缺乏高效可路由的目标模型。英伟达押注的是:开源策略若同时应用于模型层与路由层,方能真正推动代理式 AI 的成本下降;单靠一款更廉价的模型,或仅在他人技术栈上叠加一个更智能的路由器,均无法达成此目标。
Switchyard 真正的竞争对手并非其他开源模型——而是 Not Diamond(目前已驱动 OpenRouter 的 Auto 模式)以及加州大学伯克利分校(UC Berkeley)与 LMSYS 联合开发的开源框架 RouteLLM。二者均未发布自有模型。英伟达的判断是:在单一开源许可证下同时掌控决策的两端(即模型与路由),正是仅提供路由器或仅提供模型的竞争者所无法匹敌的优势。
英伟达生成式 AI 副总裁卡莉·布里斯基(Kari Briski)在一次简报中表示:“这就是模型系统的威力——为工作流的每一步匹配最合适的模型。”
路由器如何实际改变工作流
模型路由并非新兴类别。OpenRouter、LiteLLM 及少数几家独立路由初创公司已允许开发者将流量导向多个供应商。Switchyard 并非直接取代这些工具,而是可接入其中多个系统。
Switchyard 解决的核心问题是:随着代理在任务中推进,最合适的模型也会随之变化。当工具返回结果、错误出现,或某一步骤被证实为常规操作而非复杂操作时,代理的状态即发生转变;而固定选择某一模型则无法适应上述任何一种状态变化。
布里斯基描述了响应这种动态状态变化的路由策略,而非基于静态任务类别的策略。
布里斯基表示:“它包含多种类型的路由策略。你可以采用随机路由器——效果并不理想;也可以采用代理状态路由或分类器路由。依据你的路由策略,系统会力求选择最佳模型。在某些情况下,你希望为真正高效的特定任务选用 Lightning 这类模型,而只要 Lightning 已被纳入你的模型池中,路由器便会实际选择它。”
成本直接嵌入路由决策过程,而非事后考量。在回应 VentureBeat的提问时,布里斯基表示,Switchyard 可评估模型的冗余度(verbosity),即某模型在执行特定任务时倾向于生成的 token 数量,并利用该预测在调用发起前便将任务导向成本更低的选项。
使该方案不至于演变为一项独立集成工程的关键,在于 Switchyard 的定位。英伟达将其合作伙伴划分为两类:一类是直接调用 Switchyard 的代理框架,包括 Cognition、LangChain 和 Nous Research;另一类是已将 Switchyard 支持功能集成至自身产品的大型语言模型(LLM)网关,包括 Kong、LiteLLM 和 OpenRouter。Kong 在其 Kong AI Gateway 中原生集成了 Switchyard。布里斯基在描述该库如何融入现有路由生态系统时,亦援引了同一份网关合作伙伴名单。
布里斯基表示:“我们是生态系统拥护者,致力于确保自身实现充分集成。我们已与 OpenRouter、LiteLLM 和 Kong 展开合作,它们均已集成我们的路由算法,因此你可在当前正在使用的最佳工具基础上直接启用该功能。”
英伟达分享了九家公司在测试 Switchyard 后的结果,其中多家附有具体数据。LangChain 报告称,在 145 个多轮次 Deep Agents 任务中,仅将 7% 的调用路由至前沿模型,即实现了 74% 的成本降幅,但准确率相应降低了 6%。Ramp 表示,其在 Ramp SWE-Bench 上复现了前沿模型的性能,同时将成本降低 58%,运行时间缩短 33%。Cognition 将 Switchyard 的分阶段路由器集成至 Devin Desktop 供内部使用,并报告称在 FrontierCode Main 上实现了接近前沿水平的性能,同时相较将全部请求路由至单一前沿模型的方案,平均成本降低了 28%。
Lightning 的架构与性能提升
Nemotron 3.5 Lightning 本身即是一款独立的开源模型,专为高吞吐量、专业化代理任务设计,而非通用用途。
它延续了英伟达于 2025 年 12 月随 Nemotron 3 系列推出的混合型 Mamba-Transformer 隐式混合专家(latent mixture-of-experts)架构 ,该架构同样支撑着Nemotron 3 Super ,后者在英伟达的后训练对比中被用作 Lightning 自身的基准线。在如 Switchyard 这类路由设置中,Lightning 定位为决策链中快速且低成本的一端,而非前沿端;但它可独立运行并独立发布,无需依赖任何路由器。根据
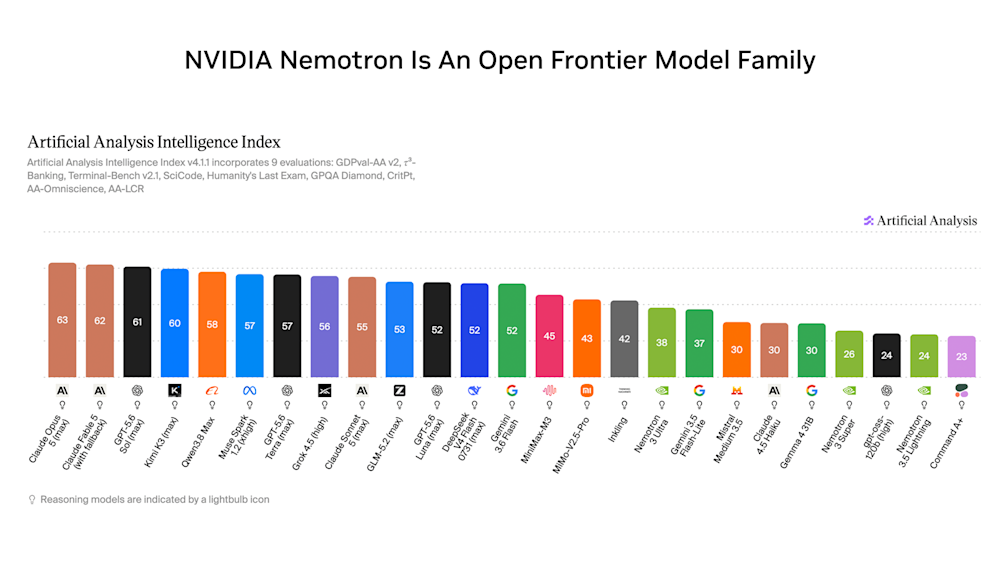
Artificial Analysis Intelligence Index (一项涵盖九项评测的通用能力基准)数据显示,Lightning 得分为 24,与 gpt-oss-120b 并列,但低于 Nemotron 3 Super、Gemma 4 31B、Claude 4.5 Haiku 和 Mistral Medium 3.5(均为 30 分)。Lightning 并非其尺寸级别中的通用智能领先者,英伟达亦未宣称其具备该地位。其实际主张更为聚焦:据英伟达提供的 PinchBench 数据,Lightning 在 PinchBench(一项覆盖编程、研究与文件管理等真实世界代理任务的基准)上,以约快 30% 的速度达到与 Qwen3.6-35B 相同的准确率,并在相近完成时间内超越 Gemma 4 26B 的准确率。这是一种速度与准确率之间的权衡,而非能力层面的胜利。
实际主张范围更窄:根据英伟达(Nvidia)提供的PinchBench数据,Lightning在PinchBench(一项涵盖编程、研究和文件管理的真实世界智能体任务基准测试)上,以约快30%的速度达到Qwen3.6-35B的准确率,并在相近的完成时间内超越Gemma 4 26B的准确率。这是一种速度与准确率之间的权衡,而非能力上的优势。
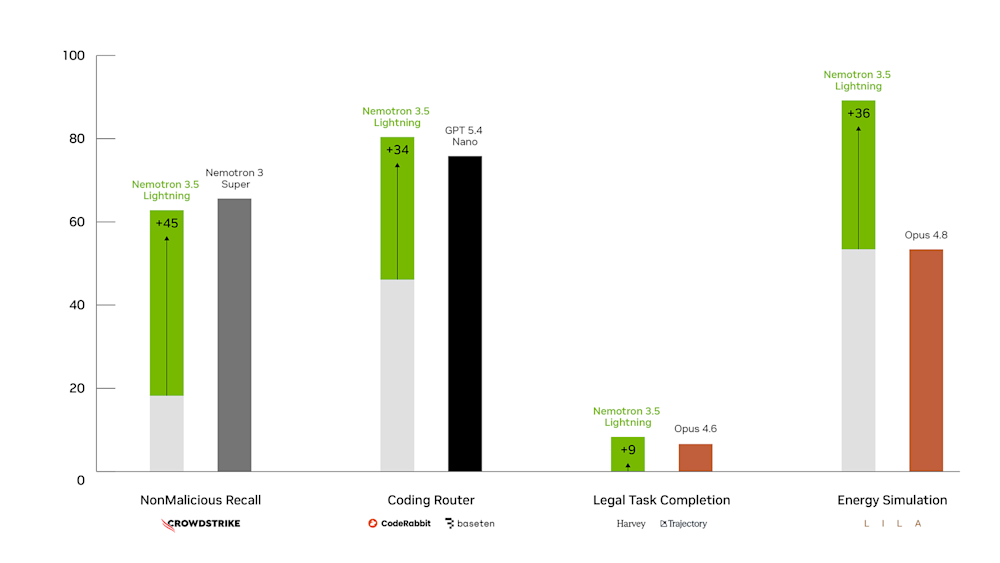
后训练阶段是英伟达声称能带来更大收益的环节。该公司分享了四家早期访问合作伙伴的前后对比数据:CrowdStrike 将恶意内容召回率与 Nemotron 3 Super 基线模型进行对比;CodeRabbit 将代码路由能力与 GPT 5.4 Nano 基线模型进行对比;Harvey 和 Trajectory 将法律任务完成率与 Opus 4.6 基线模型进行对比;Lila Sciences 将能源模拟工作与 Opus 4.8 基线模型进行对比。CodeRabbit 的案例最为具体:英伟达表示,采用标准 NeMo Auto 模型配方、仅训练一个 epoch,即可在约两小时内构建出一个可运行的路由智能体(router agent),成本约为 85 美元。
图片来源:Nvidia
这对企业意味着什么
在日益扩大的开源模型市场中,竞争性产品供应充足。此次新发布的 Nemotron Lightning 将成为组织机构需考虑的又一选项。
在模型层面,Lightning 自身的基准测试图表将 Qwen3.6-35B 选为其直接对比对象。VentureBeat 直接向 Briski 提问,询问 Lightning 与更广泛的中国模型相比表现如何;Briski 并未提供一对一的基准测试结果,而是指出开放性与可定制性才是关键差异化因素。
“我们的价值主张不仅在于开放,更在于高度可定制。”Briski 表示。
对于正在构建智能体(agentic)基础设施的企业而言,有三大趋势尤为突出:
路由决策正从静态转向动态。 那些围绕单一默认模型构建智能体流水线(agent pipelines)的企业,正被推向基于实时信号(例如智能体状态和 token 成本)的逐步骤路由机制,而非在设计阶段即固定分配的静态路由方案。
开源如今已成为覆盖两个层级的成本杠杆,而不再仅限于单一层级。 将开源模型与厂商端到端控制的开源路由器配对,这一论点比单纯依赖更廉价的模型权重(cheaper weights)更新颖;值得观察其他实验室是否会效仿这一模式。
竞争焦点已从‘最佳模型’转向‘最佳系统’。 随着路由库日趋成熟,差异化优势正从企业默认采用的模型,转向其路由层在生产环境中将模型与任务精准匹配的能力——这既更难进行基准测试,也更难进行市场宣传。
JOTO 企业落地观察
- 对企业部署而言,Switchyard与Lightning的组合表明:单纯替换低价模型已不足以控制AI运营成本,企业需将路由逻辑深度嵌入工作流——成本预测(如token冗余度)在调用前即参与决策,这对算力预算精细化管理提出新要求。
- 对智能体工程而言,静态路由正被基于代理状态、错误信号与任务复杂度的动态路由取代;LangChain等框架集成Switchyard后,仅7%调用需前沿模型即可降本74%,说明工程重心正从‘选好一个模型’转向‘每步都选对模型’。
- 对FDE落地而言,英伟达强调‘开源+端到端可控’的双层开源策略(模型+路由器),使企业可在不依赖闭源API的前提下构建可审计、可定制的智能体系统,这为金融、政务等强合规场景提供了符合国产化替代路径的技术选项。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们