无云无GPU亦可运行:Liquid AI发布可在树莓派部署的26亿参数代理型语言模型LFM2.5-2.6B
Liquid AI发布开源模型LFM2.5-2.6B,仅26亿参数、支持128K上下文,专为工具调用与本地代理任务优化,可在树莓派等极简硬件上纯CPU运行,无需云端或GPU,兼顾低延迟、高隐私与低成本。
本周早些时候,由前麻省理工学院(MIT)计算机科学家于2023年创立的人工智能初创公司Liquid 发布了LFM2.5-2.6B,一款专为代理型(agentic)工作负载设计的新型开源权重语言模型。
在发布材料及近期接受VentureBeat采访时,Liquid的研究人员表示,LFM2.5-2.6B可完全在本地硬件上运行——从智能手机和笔记本电脑,直至树莓派(Raspberry Pi)——无需依赖云端推理或GPU,从而解锁边缘AI应用,并为在受监管行业工作或处理敏感信息(不愿上传至云端)的企业提供更多选择。
该模型最适合高吞吐量、定义明确且在本地运行的代理型任务——例如工具调用、文档管理、日历与工作流自动化,以及始终在线的后台例行任务;也适用于车辆与机器人等连接受限环境;不过,编码密集型任务仍更适合交由更大规模的模型处理。
即便对于没有上述顾虑的企业而言,以近乎仅需电费的成本运行高性能、任务专用的代理,其吸引力本身或许已足以令这款新模型极具吸引力。
但 定制开源权重许可证,与 月前发布的Moonshot更大规模前沿模型Kimi K3 一样,值得企业法务团队仔细审视。
基础参数
LFM2.5-2.6B包含26亿参数,支持128,000词元(token)上下文窗口,并原生支持工具调用。其略显复杂的名称源于模型代际(2.5)与参数数量(2.6B)的组合。
当前,经后训练的模型及供希望微调的开发者使用的基线检查点(LFM2.5-2.6B-Base)均已上线 Hugging Face,并自发布首日起即支持主流推理栈,包括llama.cpp、MLX、vLLM、SGLang与ONNX——为其在消费级硬件、企业基础设施及嵌入式系统上的部署做好准备。
Liquid还提供一个开源微调框架, LEAP。
该公司并未将LFM2.5-2.6B定位为最大规模前沿模型的竞争对手,而是提出了另一种主张:一款能力足够强的小型模型,可解锁一类企业应用场景——在这些场景中,延迟、隐私性、部署灵活性或推理成本的重要性,远超绝对基准测试表现。
Liquid AI后训练负责人马克西姆·拉博纳(Maxime Labonne)在发布后接受VentureBeat采访时表示:“我也确实相信,最佳模型将位于云端,这并无问题。我们想为另一类用户打造模型,对其最恰当的描述是:当你无法使用云端模型时,就应采用[边缘AI]。”
小到可在树莓派上运行
当被问及最低可行硬件配置时,拉博纳表示该模型在CPU上“运行得非常、非常好”,且LFM2架构底层设计明确围绕真实世界CPU性能展开,而非GPU基准测试。
他说:“我认为最佳示例就是树莓派。我们有许多演示表明,它实际上在树莓派上运行得相当快。”
据该公司报告的测量数据,在Apple M5 Max上解码吞吐量约为每秒220个词元,在AMD Ryzen AI Max+ 395上为每秒113个词元,内存占用低于2.5 GB;在智能手机上则约为每秒30个词元。用户可通过Liquid AI的移动应用Apollo在手机上试用这些模型。
在部署光谱的另一端,Liquid AI报告称,该模型在单块Nvidia H100 GPU上持续并发负载下,输出词元速率接近每秒15,000个——相当于单卡每日约13亿词元。这些数据为厂商基准测试结果,尚未经过独立验证。
对拉博纳而言,内存占用与速度并非便利性选项,而是决定模型能否实际部署的硬性约束。
他说:“我们希望展示的是,这是一种真正出色的权衡方案,因为你能在极小极小的形态因子中获得与更大模型同等的质量水平。你可将其部署于根本无法部署其他模型的目标设备上。”
为代理而非聊天机器人而训练
Liquid AI表示,LFM2.5-2.6B的开发基于一项假设:语言模型正越来越多地通过代理框架而非传统对话界面被使用。
拉博纳表示:“模型已不再通过聊天机器人被使用。它们实际是通过代理型封装(agentic harnesses)被使用,例如OpenClaw、Hermes Agent。我们希望确保该模型不仅擅长数学或代码,更擅长使用工具。”
该模型预训练数据量约为34万亿词元,词汇表规模扩大一倍至128K,以更好支持非拉丁文字脚本;并专门设置中期训练阶段,将上下文窗口扩展至128K词元,以适配长时间运行的代理工作流。
后训练遵循四阶段流程:监督式微调、教师专业化(为指令遵循、数学、代码及工具使用等领域分别训练专家模型)、多领域在线策略蒸馏(MOPD),将这些专家能力融合回单一学生模型,最后进行代理强化学习。
在最后阶段,该模型直接在生产级代理封装(包括Hermes Agent与OpenClaw)内部、针对涉及研究、编码、文档管理、工具调用及工作流自动化的现实生产力任务进行训练,使其接触这些封装的实际工具、系统提示词及交互模式。
拉博纳将此次流程重构描述为产生了一次“幸运意外”:所获提升远超代理目标本身。
他说:“借助这些新训练技术,我们在所有方面都大幅提升。我们在数学、指令遵循方面表现更好。事实上,我们此前从未擅长代码——而通过此方法,我们甚至在代码方面也变得极为出色。”
构建模型——及封装
值得注意的是,Liquid AI还自行构建了代理封装,而非仅依赖现有框架,并演示了该模型在其封装内于手机上运行,全程在设备端规划并调用工具。
拉博纳表示:“这是一个在手机上运行的封装,我不知道是否还有其他任何封装能在手机上运行。”
他解释称,公司有两个原因:第一是必要性——当时尚无原生适配手机的封装;第二是一种不同的交互范式:当前封装等待用户输入提示,而Liquid AI希望助手能自主行动。
他说:“我们想要主动型代理。我们希望代理在后台运行,监测你的行为、查看你的日历,并基于此上下文执行任务。这在今天实际上并不存在。”
协同设计封装与模型,亦使软件能够弥补模型的薄弱环节。“模型不擅长的一切,封装都应予以辅助——尽可能提供协助,以提升其可靠性,”拉博纳表示,“终端用户并不关心是模型还是封装完成任务。他们只希望最终任务得以达成。”
该模型无需额外配置即可直接运行,支持包括Hermes Agent、OpenClaw和Pi在内的成熟代理框架,并可通过任何兼容OpenAI的端点提供服务。
更换代理框架,而非模型本身
针对企业级部署,Labonne认为此次发布标志着小型模型适用场景的根本性转变。他指出,此前本地模型主要作为经过窄域微调的专家模型具备经济合理性——即在云模型质量水平上专精于单一任务,且速度更快、成本更低。而代理能力(agentic capability)改变了这一权衡逻辑,因为同一模型可通过更换其周边工具而非修改模型本身来重新用于不同用途。
“你可以拥有一个日历助手,然后复用同一个模型构建会议助手,用于记录所有人的发言并生成摘要——有点像Granola,例如,”他说,“你不需要更改模型;只需更换代理框架,只需更换其周边工具。这带来了更强的通用性,而且实施起来更容易、成本也低得多。”
他仍建议在可行情况下对生产部署进行微调:“如果你不进行微调,就会损失部分性能;如果你微调得当,其性能将可媲美GPT和Claude——事实上,只要你的任务并非世界上最复杂的任务,”他补充道,称入门门槛已大幅降低:“如今开展微调的门槛极低,对所有人而言都极为易用。”
与DeepSeek-V4-Flash、谷歌Gemma及阿里巴巴Qwen的对比表现
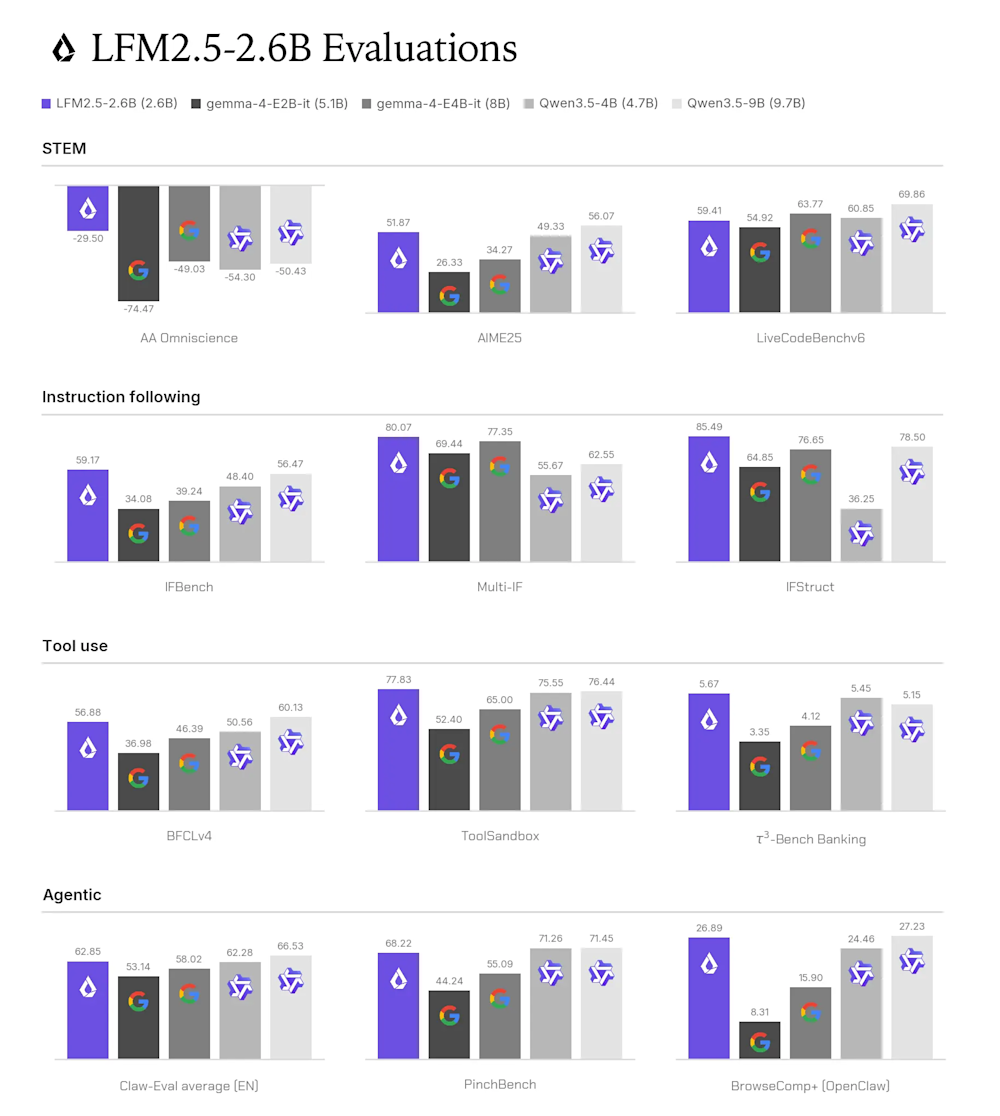
Liquid AI发布了自有基准测试对比图表,将LFM2.5-2.6B与企业最可能列入边缘部署候选名单的其他模型进行比对:谷歌Gemma 4 E2B(51亿参数)和E4B(80亿参数),以及阿里巴巴Qwen3.5-4B(47亿参数)和Qwen3.5-9B(97亿参数)。
本地AI客户端平台的一项独立测试 Atomic Chat 发现LFM2.5-2.6B完成三项任务(查询六个城市的天气与当地时间、将一项预算换算为六种货币、查询四家酒店并预订指定日期)共发出35次工具调用,其速度比DeepSeek-V4-Flash(参数量高达2840亿)快3.7倍;该模型自上周发布以来, 飙升 至 OpenRouter 榜首。
Gemma 4的小型模型是多模态通才模型,可同时接受图像、音频与文本输入,并采用逐层嵌入(Per-Layer Embeddings)设计,每个token仅激活其权重的一小部分——因此谷歌以其“有效”尺寸(23亿和45亿)进行宣传,尽管其总参数量分别为51亿和80亿。阿里巴巴Qwen3.5小系列模型, 于今年3月发布,从40亿参数起即原生支持多模态,并依托规模化强化学习追求前沿风格的推理能力——阿里巴巴宣称其90亿参数模型在推理基准测试中表现持平或超越OpenAI规模大得多的gpt-oss-120B模型。
LFM2.5-2.6B则选择了一条更窄的路径:它仅为纯文本模型、稠密架构,且专为代理任务(agentic work)优化;Liquid AI另行为LFM系列发布独立的视觉与音频变体,而非将全部模态整合进单个检查点。
Qwen的后训练强化学习聚焦于推理能力,而Liquid AI的强化学习则专注于真实代理框架内的工具使用。
据该公司公布的测试数据,该对比中参数量最小的模型在所有指令遵循基准测试(IFBench、Multi-IF、IFStruct)中均领先,并在几乎所有工具使用基准测试中亦居首位——在ToolSandbox上得分为77.83,高于Qwen3.5-9B的76.44(后者参数量接近前者的四倍),仅在BFCLv4上略逊于该90亿参数模型。
图片来源:Liquid AI
在代理能力评估中,该模型全面超越两款Gemma模型,与Qwen系列基本持平:在BrowseComp+上得分为26.89,略低于Qwen3.5-9B的27.23;同时在知识基准测试AA Omniscience(该测试对幻觉现象施以惩罚)中取得最高分。
Qwen系列模型在其训练重点领域保持优势:数学(Qwen3.5-9B在AIME25中领先)和编程,在LiveCodeBench上更大模型仍具优势——尽管Labonne指出,这一差距小于参数量差异所暗示的程度。
“在LiveCodeBench v6中,我们或许并非这些模型中表现最佳者,但我们的参数量无疑是最小的。能证明我们与它们具有竞争力,对我而言已是相当大的胜利,”他表示。
一项差异化因素则朝相反方向倾斜:许可协议。Gemma 4与Qwen3.5均采用宽松的Apache 2.0许可证发布—— 谷歌为此专门调整了许可政策以吸引企业用户。DeepSeek-V4-Flash则采用同样宽松的MIT许可证发布 。。
与此同时,Liquid AI采用营收门槛制许可(下文详述),要求大型企业另行签署商业协议。超过门槛的企业实质上是以许可复杂度为代价,换取更小的模型体积与更强的工具使用性能。
许可模式体现了一种商业中间路线
LFM2.5-2.6B依据 LFM Open License v1.0发布 ,该许可证允许年收入低于1000万美元的组织免费使用、修改及再分发该模型(包括商业用途)。年收入更高的企业进行商业用途不受本许可证覆盖,须与Liquid AI另行协商安排;符合条件的非营利组织在非商业及研究用途下豁免该收入门槛限制。
Labonne将该许可结构描述为支撑模型持续开发的一种方式:“模型本身才是真正护城河,因此我们必须审慎制定许可策略;否则无法盈利,也就无法持续开发更多模型”——同时将该收入门槛在实践中界定为一种轻量级机制。
当被问及公司如何得知大型企业是否悄然部署了开源权重时,他坦率回应:“我认为这是法律团队的问题,但就我个人而言,我并不知晓。即便你的年收入超过1000万美元,我们唯一的要求也只是联系我方。”
他补充道,该公司将其授权模型发布与免费公开的研究成果相结合,包括新型结构化输出评估方法,以及一种可缓解小型模型常见重复循环问题的训练技术——他指出Qwen系列模型“某种程度上正存在此类问题”。
小型模型,重大企业影响
此次发布恰逢乌克兰软件公司 MacPaw(CleanMyMac与Setapp背后的开发商)宣布与Liquid AI建立长期战略合作关系,共同为Mac设备构建端侧AI技术栈。
Liquid AI将为MacPaw的macOS助手Eney设计并微调基础模型,该助手将通过MacPaw的Elix推理引擎与Mnemos记忆层,在Apple芯片上本地运行,预计成果将于今年晚些时候推出。
Labonne将此项合作视为模型尺寸论点的具体验证:“他们选择我们的原因之一,也正是因为该模型体积相当小,而他们并无足够内存预算来运行其他模型。”
此次发布正值硬件厂商、操作系统开发商及企业软件公司日益加大对本地AI执行能力的投资之际,同时行业内的代理框架亦日趋普及。Liquid AI的判断是:部署经济性(deployment economics),而非原始规模,将定义该市场中一个关键细分领域:即无边际token成本、持续运行于各处的代理系统。
小型、高度优化的智能体模型能否成为企业人工智能领域的重要细分市场,最终将更多取决于运行可靠性,而非基准测试分数。但Liquid AI最新发布的模型表明,下一竞争前沿已不再仅仅是构建更大的模型——而是构建足够小、且能力足够强的模型,使其能够直接部署于企业现有工作流所处的任何位置。
JOTO 企业落地观察
- 对企业部署而言,该模型将推理成本压缩至仅需电费级别,并明确以CPU性能为设计基准(如树莓派实测可行),使受监管行业或带宽受限场景(如车载、工业现场)可绕过云依赖,实现合规、低延迟、持续运行的AI代理落地。
- 对智能体工程而言,其四阶段后训练流程(含代理强化学习)及与自研封装LEAP的协同设计,确立了‘模型+封装’联合优化范式:封装主动补足模型短板(如循环问题),并支持更换工具链而非重训模型,显著提升任务复用效率与工程敏捷性。
- 对AI安全治理而言,其营收门槛制许可证(年收入超1000万美元需商业协议)构成新型开源治理实践——既保障中小开发者自由使用,又迫使大型企业建立正式授权关系,为模型使用审计、责任追溯与合规集成提供了制度接口,区别于Apache/MIT的完全开放模式。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们