你的 Agent 记不住用户,多半是把"记忆"当成了"上下文"
本文指出当前多数 Agent 将记忆简单等同于上下文拼接或向量检索,导致信息过载、冲突难解、时效混乱。阿里云百炼提出区分知识库与记忆库,定义记忆为可写、可改、可检索、可演化的四维能力,并通过事实/画像/技能三类记忆结构、自动抽取与动态更新、多模态支持、白盒化配置及全链路可观测等设计实现工程级落地。
记忆不是上下文:三段对话揭示的根本问题
先来看三段对话:
用户:我上班去了
Agent:好的呢,记得你昨天说感冒了,别太累着自己呀。
用户:刚才出门我锁门了吗?
Agent:大门已经锁好啦,不用担心哦。
用户:周五下班要带家人吃个好的,有没有推荐的餐厅?
Agent:上次你提到那家陈记粤菜馆不错,你和孩子都爱吃,离学校也不远。
这三句里没有一句是"当场告诉它"的信息。它们来自昨天的对话、上周的偏好、上个月的一次家庭聚餐。
这就是当下大多数 Agent 缺的那块。而大多数团队的做法,其实是把"记忆"当成了"上下文"。
两种常见做法为何失效
第一种做法,是把历史对话一路拼进 prompt。
窗口有限,拼到第 20 轮就得截断;成本随对话长度线性上涨;更麻烦的是"记脏"——用户三个月前说过住在北京,上个月搬去了上海,两条信息同时躺在上下文里,模型不知道信哪一条。
第二种做法,是上一个向量库,把 QA 对存进去做检索。
它能查到"用户说过什么",但查不到"用户是谁"和"这事该怎么干"。语义检索擅长找相似文本,可记忆不是相似文本问题:时间性、冲突消解、生命周期、该忘什么,一个都没有。
一个直接的感受是:这两种方式都在解决"信息在哪儿",而记忆要解决的是"该记住谁"。
知识库与记忆库是两件事
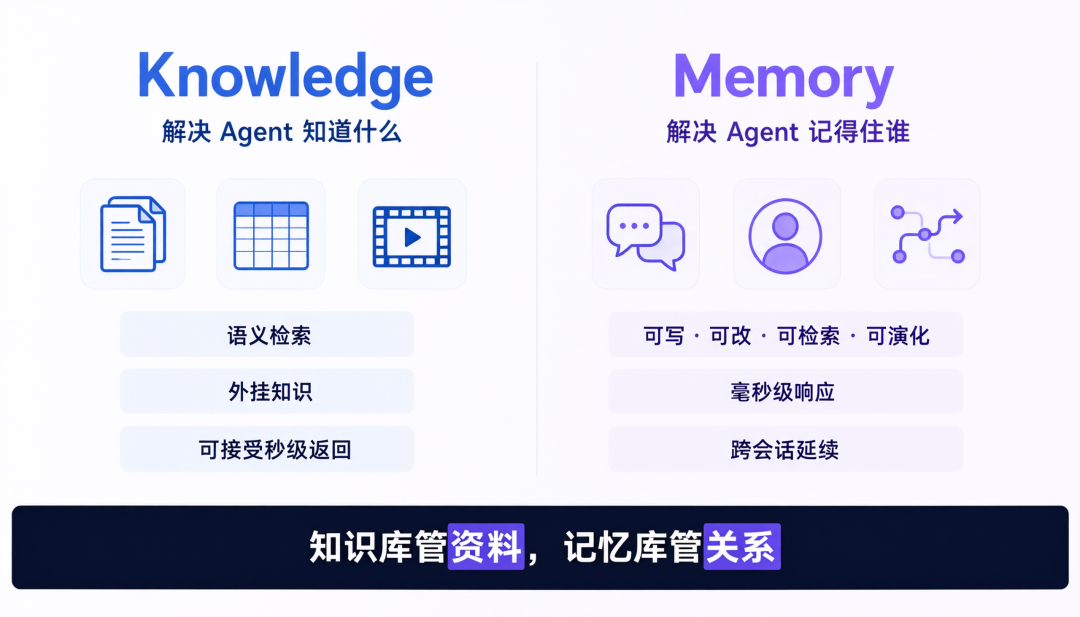
阿里云百炼在上下文层做了两个产品,分工很明确:
| 维度 | 解决什么 | 核心能力 |
|---|---|---|
| 知识库(Knowledge) | Agent 知道什么 | 语义检索企业私有资料,外挂知识 |
| 记忆库(Memory) | Agent 记得住谁 | 从对话与执行中沉淀状态,跨会话延续 |
差别不止是数据源不同。知识检索可以接受秒级返回,但记忆处在实时对话链路上,必须毫秒级响应、支持高并发、Schema 能动态扩展——这是工程形态上的差异,不是功能列表的差异。
所以"把企业文档和用户偏好塞进同一个向量库"这种做法,一开始就把两类完全不同的东西混成了一张表。
记忆是可写、可改、可检索、可演化的系统
百炼记忆库给长期记忆的定义是四件事:可写入、可更新、可检索、可演化。缺一件,就只是存储,不是记忆。
(1)三类记忆,覆盖"记住"的完整链路
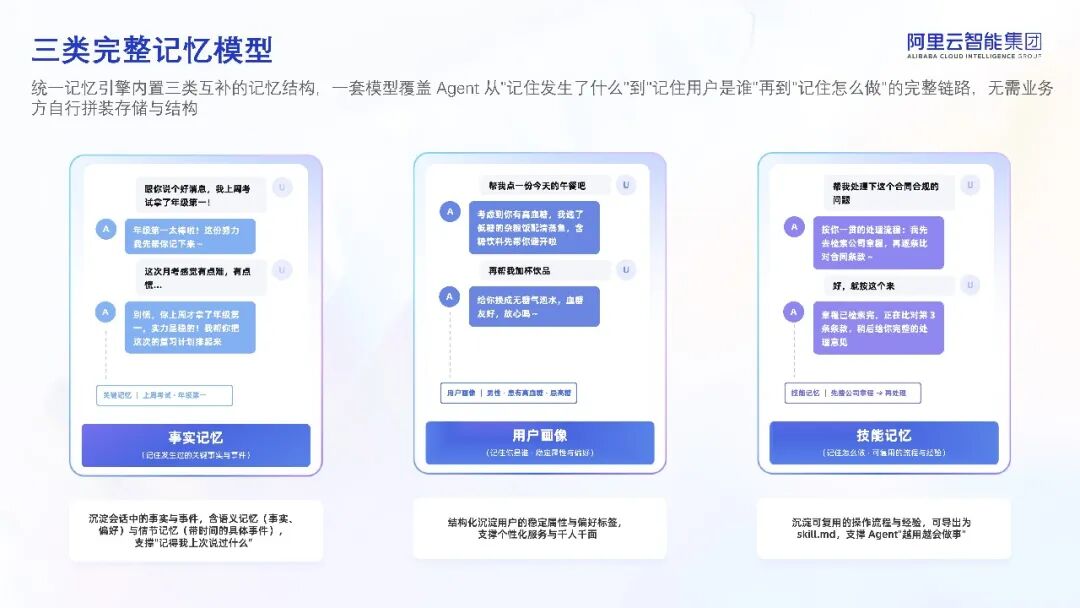
统一记忆引擎内置三类互补结构,不用业务方自己拼装:
- 事实记忆
记住发生过的关键事实与事件。例:用户说"我上周考试拿了年级第一",后续再问复习计划时会被主动唤醒。
- 画像记忆
记住用户是谁。稳定属性与偏好标签,如饮食忌高糖、常用城市、内容偏好,支撑千人千面。
- 技能记忆
记住怎么做。从执行历史里总结"如何成功完成某项任务"的流程与工具用法,可导出为 skill.md 供 Agent 复用。原来要调 4 处 bug 才定位的问题,下次一步到位。
第三类是很多记忆方案没做的。它对应的场景是"Agent 越用越会做事",而不只是"越用越了解你"。
(2)自动抽取 + 动态更新 + 遗忘
对话结束自动触发抽取,识别事实、偏好、事件与可复用经验,按三类结构入库,无需人工标注或额外埋点。
新信息不是简单堆叠:写入时自动比对已有记忆,识别重复、补充与矛盾,增量合并或按策略保留最新、可信的事实。同时支持 TTL 过期、软失效可恢复——时效性信息到期自动淡出,重要信息长期沉淀,且失效记忆不物理删除,可回溯。
(3)检索链路按实时对话场景优化
向量 + KV + 图 + 全文多路召回,配合 Query 改写与 Rerank。产品口径的性能数据:检索链路优化后响应从 900ms 降至约 450ms(下降约 50%),日期相关性提升约 66%。
"记不记得"之外,更关键的是"这一轮对话里能不能及时召回"。
(4)多模态记忆:不止记文字,图像也能记住
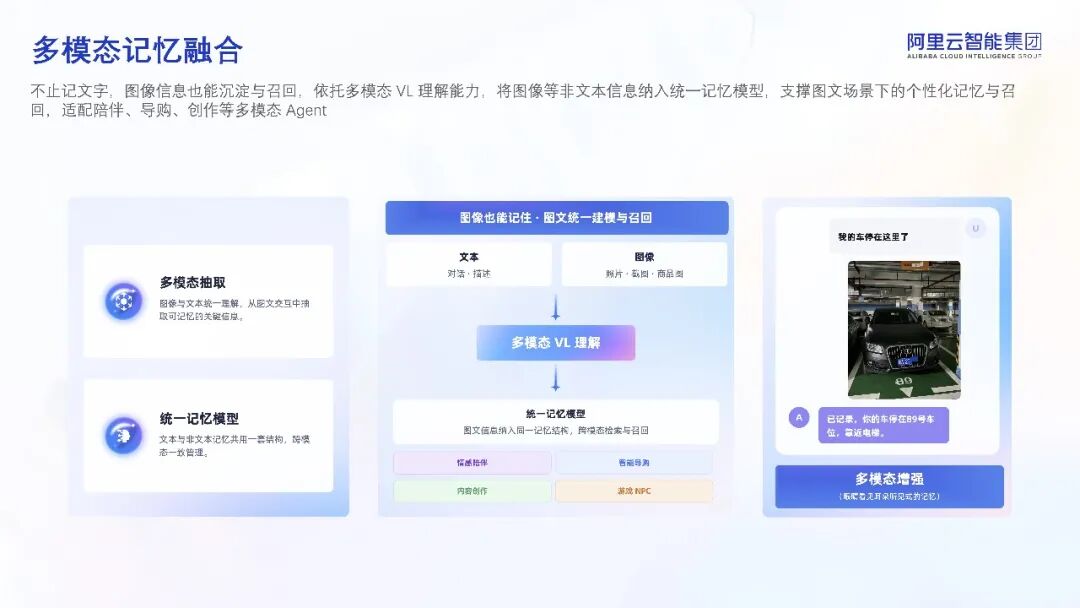
依托多模态 VL 理解,把照片、截图、商品图等非文本信息纳入统一记忆模型,图文混合召回。文本与非文本共用一套结构,跨模态一致管理。
一个直观的演示:用户发一张停车场照片说"我的车停在这里了",之后再问,Agent 能答"已记录,你的车停在 89 号车位,靠近电梯"。
适用场景集中在情感陪伴、智能导购、内容创作、游戏 NPC 这几类多模态 Agent。
(5)白盒化配置,而不是黑盒 SDK
抽取规则、留存策略、检索参数全部开放为可视化配置:可自定义记忆类型,可调召回相似度阈值与 TopK,并提供多场景冷启动模板,降低配置成本约 50%。
记忆效果不好时,业务方要能自己调参,而不是等框架迭代。
(6)全链路可观测与审计
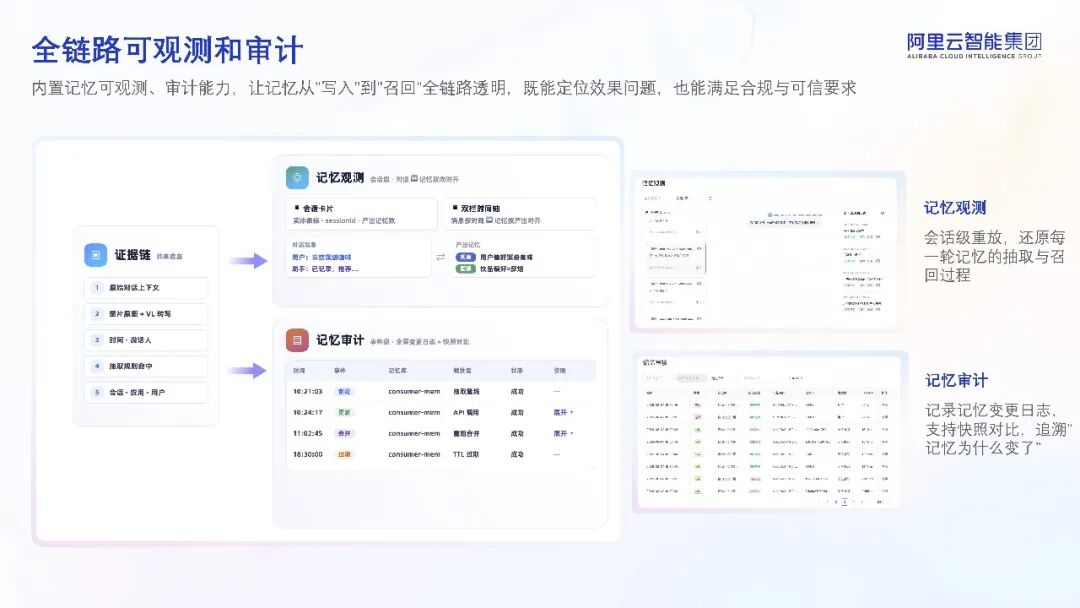
会话级重放,还原每一轮记忆的抽取与召回过程;记忆变更日志支持快照对比,能追溯"这条记忆为什么变了"。
对客服、金融、医疗这类场景,这既是效果定位能力,也是合规要求。
公开评测集上的效果表现
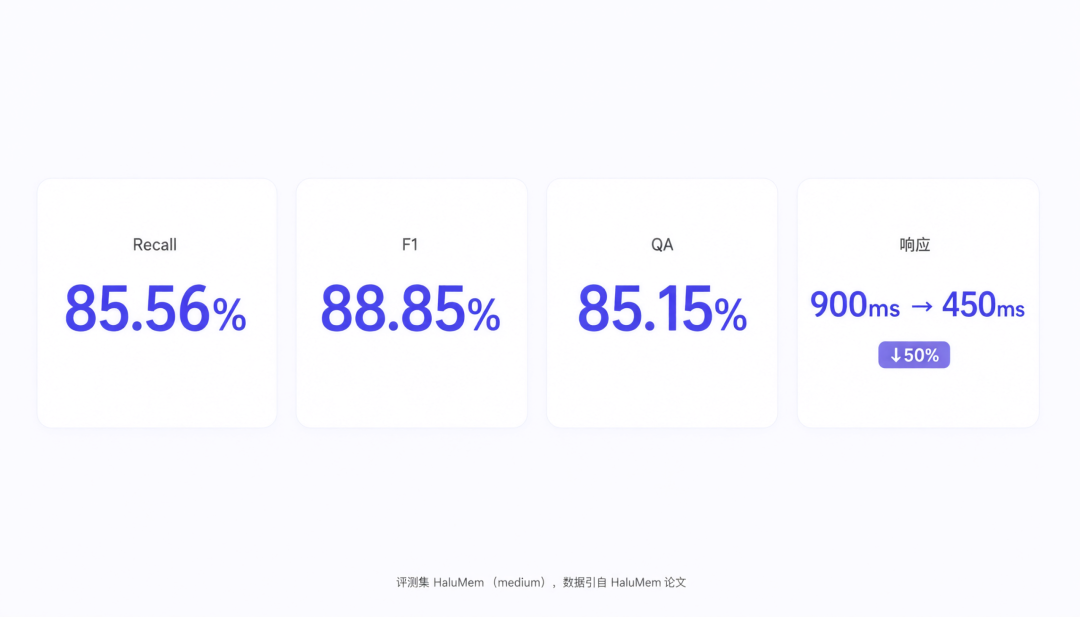
在开源评测集 HaluMem(medium)的记忆抽取任务上,百炼记忆库取得 Recall 85.56%、准确率 90.49、F1 88.85%;在记忆问答(QA)任务上为 85.15%,相较 Mem0、Zep、Supermemory、Memobase 等开源记忆产品领先。(数据引自 HaluMem 论文口径)
接入方式与部署选择
按次计费,Free 层不收费:每月 1,000 次 Add、5,000 次 Search、1 万条记忆永久免费存储。检索单价低到近乎可忽略(Pro ¥0.001/次,Lite ¥0.00002/次),存储约 1.44 元/万条/月。
双版本按需求选:Pro 用高精度 LLM 做抽取与检索重排,适合客服、医疗、金融这类对记忆质量敏感的场景;Lite 用轻量模型,适合日志摘要、批量画像、IoT 设备记忆这类大规模低成本场景。
接入渠道覆盖 API / SDK / MCP / CLI / Skill / Agent Harness,以及 Claude Code、Qoder、Cursor 等插件,并兼容 Dify、Coze 等编排框架。框架中立——不管你在用什么 Agent 技术栈,都能接。
结尾:记忆是 Agent 走向生产的基石
回到开头那三段对话。用户不会为"它记得我感冒了"单独付一次钱,但会因此多用一年。
Agent 走向生产,靠的不是某一次任务完成得漂亮,而是能不能持续理解用户、持续交付结果。记忆就是这条链路上最基础的一环。
阿里云百炼记忆库,让你的 Agent 真正更懂你。
JOTO 企业落地观察
- 企业部署智能体时,若将记忆简单复用 RAG 向量库架构,将面临时间衰减、冲突消解、身份绑定缺失等结构性瓶颈,需重新规划独立记忆服务的基础设施层级。
- 技能记忆的沉淀与复用能力,对企业构建可积累、可传承的智能体工作流至关重要——它使单次任务经验转化为组织级资产,而非一次性消耗资源。
- 全链路可观测性不仅是调试工具,更是企业 AI 安全治理的必要前置条件:记忆变更日志与快照对比,支撑 GDPR/《生成式AI服务管理暂行办法》中的可解释性与可问责性要求。
- 白盒化配置能力直接决定企业能否自主掌控记忆策略演进节奏,避免因 SDK 黑盒升级导致业务逻辑漂移,这对金融、政务等强合规场景尤为关键。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们