标榜“开源版Palantir”的Semantica深度解析
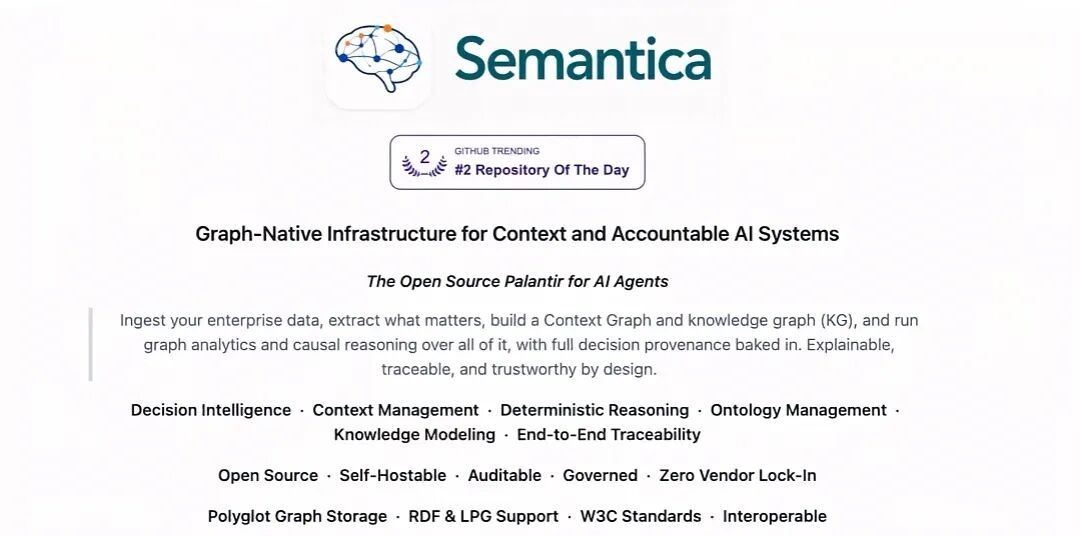
Semantica是2026年初爆火的开源项目,定位为「面向AI Agent的开源版Palantir」,以确定性知识图谱与决策溯源能力为核心,支持私有化部署。它不替代LLM或Agent框架,而是作为底层基础设施,存储语义而非embedding,兼容RDF与LPG标准,提供本体治理、因果推理与全链路审计能力。
直面AI决策不可解释性痛点
你是否在公司搭建过基于LLM(大语言模型)的聊天机器人或Agent(智能代理)?演示阶段往往运行顺畅,可一旦要上线正式服务,总会被问到同一个问题:“你能解释AI为什么会做出这个判断吗?”
绝大多数人都会在这里卡住。LLM是基于概率生成答案的模型,即便输入完全相同的问题,每次输出都可能不同,想要追溯结论的生成依据,难度非常高。
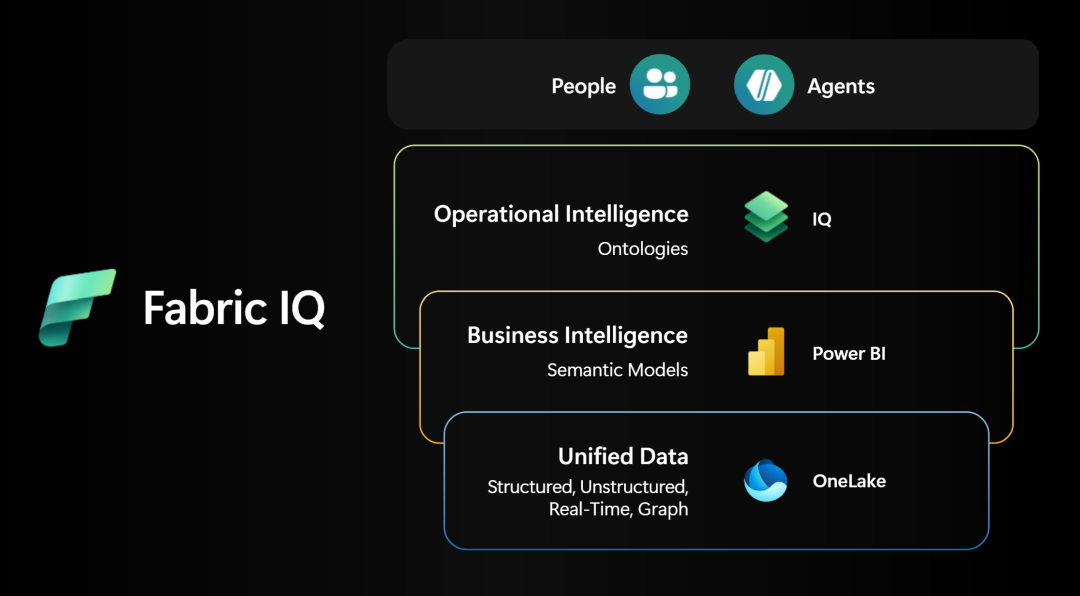
今天要介绍的Semantica,正是直面这一痛点的开源项目。它将自身定位为「面向AI Agent的开源版Palantir」。Palantir是服务于美国政府机构、大型金融机构的数据分析平台公司,核心能力是将组织内分散各处的数据整合为统一语义体系,支撑业务决策;但它价格高昂且完全闭源。Semantica的目标,就是将这套核心思路以开源形式实现,并适配AI Agent时代的需求。
存储语义而非embedding
Semantica的核心问题意识可以用一句话概括:大多数AI Agent的行为不留痕迹,因为系统存储的是embedding而非语义,最终只能留下无法解释的上下文、无法审计的决策。
目前主流的RAG(检索增强生成)方案,是将文档切分为片段,转换为向量(数字数组),再检索与提问“相似度高”的片段输入LLM。打个比方,就像图书馆管理员凭“感觉相近”给你推荐书籍。这种方式高效便捷,但无法还原精准的关联关系——比如“这位作者引用了那本书,那本书是该系列的第二册”。向量相似度只能判断“距离近”,却无法解释“为什么相关”。
Semantica在此基础上引入了Knowledge Graph(知识图谱)与Context Graph(上下文图谱)。知识图谱是将信息以“节点(实体)+连线(关系)”的形式存储,比如「金代理 —[所属]→ 信贷审核组」「该笔贷款 —[抵押物为]→ 这套公寓」。
这样存储之后,当被问及“AI批准这笔贷款的依据是什么”时,就可以沿着图谱的连接路径,逐条梳理出完整依据。不是靠模糊感觉,而是靠结构化逻辑给出答案。
运行于LLM之下的确定性基础设施
Semantica对自身的定位很有意思:它不替代LLM、向量数据库或Agent框架,而是作为一层基础设施,运行在这些组件的下方。整体处理流程如下:
- 数据接入(Ingest):接收企业内部文档、数据库等各类业务数据
- 信息抽取(Extract):从数据中提取有价值的实体与关系
- 图谱构建:生成Context Graph与Knowledge Graph
- 推理分析:基于图谱执行图分析与因果推理
- Decision Provenance(决策溯源):全流程操作均被完整记录,支持全链路追溯
其中有两点核心设计理念值得关注:
第一,图谱构建与推理不强制依赖LLM。
当下主流的GraphRAG类工具,大多依靠LLM抽取文档中的实体与关系,这会导致图谱本身具备概率性——今天生成的图谱和明天生成的可能不一样。Semantica默认采用deterministic(确定性)方案:相同输入永远产出相同结果。在有审计要求的场景中,这一点至关重要,同时也能减少LLM调用量、降低成本。
第二,系统原生内置决策溯源能力。
用开发者熟悉的概念类比,就是给AI的决策加上了 git blame 能力。README中举了贷款审核的例子:审核Agent做出的放款决策,在数月后接受监管核查时必须可追溯、可举证。对金融行业而言,这不是体验优化,而是合规风险、法律层面的硬性要求。
技术层面,它主打“多范式图谱存储”,同时支持RDF与LPG两种标准:
- RDF是W3C制定的标准,以「主语-谓语-宾语」三元组描述知识;
- LPG(属性图)是Neo4j等图数据库采用的主流模式,节点与边可附带自定义属性。
同时兼容学界标准与工业界主流方案,在互操作性上是非常务实的选择。
安装仅需一行 pip install semantica ,仓库内还内置了MCP服务器、可视化知识探索器Knowledge Explorer、多框架适配方案与完整示例集cookbook。
Context Graph为何成为新风口
和同类技术做对比,就能清晰看出Semantica的定位:
与微软GraphRAG对比:GraphRAG更偏向提升检索质量的“技术方法”,图谱生成完全依赖LLM;Semantica以确定性生成为基础,覆盖检索、治理、审计全链路,定位是底层“基础设施”。
与LangChain、LlamaIndex对比:二者是Agent编排框架,负责调度多步骤任务;Semantica运行在这些框架的下层,负责上下文与数据的统一管理,二者是互补而非竞争关系。
与Neo4j对比:Neo4j是纯粹的图数据库;Semantica是搭建在数据库之上的平台,额外包含Ontology(本体)管理、推理引擎、决策溯源能力。
补充说明:Ontology(本体)可以理解为企业的“概念词典”,明确定义组织内“客户”“合同”“抵押物”等概念的准确含义与相互关系。
- 与Palantir对比:底层方向一致,但采用了完全相反的交付策略——开源、支持私有化部署、无厂商锁定。
这个项目出现的时机也十分精准:欧盟AI法案等法规已明确要求高风险AI具备可解释性,行业关注点也正从“如何写好提示词”,转向“如何为模型提供高质量、可管控的上下文”,也就是所谓的上下文工程。Semantica正是这一趋势下,基础设施层面的解决方案。
对企业落地的务实参考价值
在金融、医疗、政务等强监管行业,IT系统的合规要求极高。尤其是在网络隔离的环境下,外部SaaS服务无法使用,可私有化部署的开源方案具备非常实际的优势。
举一个具体的落地场景:企业已基于内部规章制度搭建了RAG问答机器人,现在被要求所有回答必须附带依据。无需推翻现有整套架构,可以并行引入Semantica:将制度文档中的实体与关系抽取构建为图谱,回答时同步输出图谱路径作为佐证。仓库内置MCP服务器,也可以直接作为工具接入Claude等Agent。
官方给出的学习与落地路径建议:
- 先补图数据库基础:掌握Neo4j的Cypher或RDF的SPARQL查询语法,建立图查询的基本认知;
- 初步了解Ontology(本体)的核心概念;
- 执行 pip install semantica ,跟随cookbook中的示例跑通完整流程;
- 选取现有RAG系统中的部分文档并行试点,对比效果差异。
同时也要客观看待局限:
Ontology设计最终必须由懂业务的人员完成,前期建模成本较高,上手门槛远高于纯向量检索方案。项目目前还很新,成熟度与社区可持续性仍需观察。不建议将所有RAG场景全部替换为图谱方案,优先在解释责任重、合规要求高的领域选择性落地,才是更务实的选择。
JOTO 企业落地观察
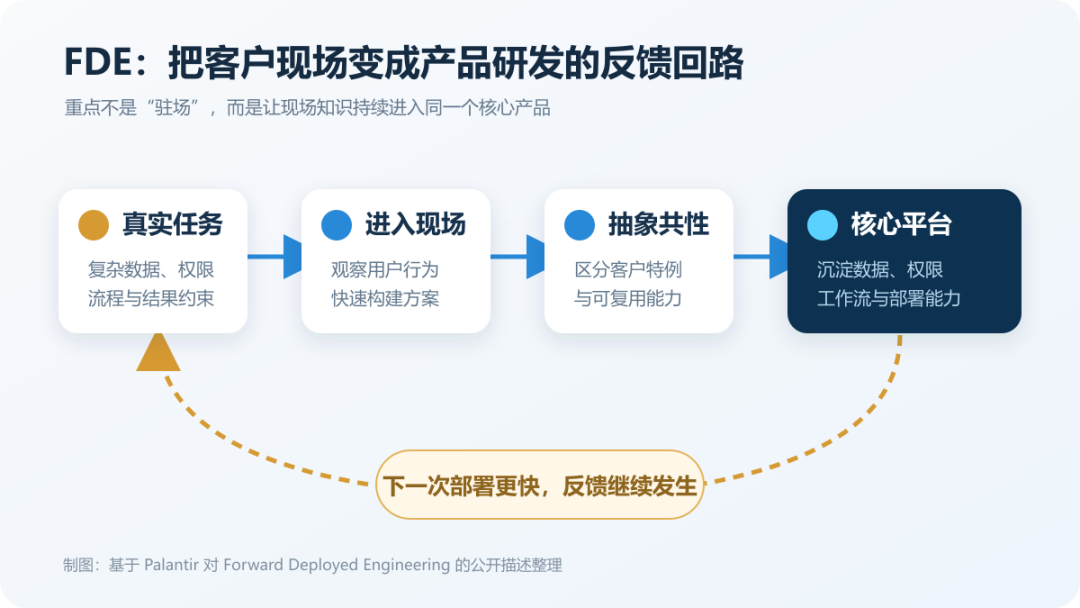
- 企业若计划引入Semantica,需重新评估FDE驻场共创的重心:从模型微调转向本体建模协同,业务专家需深度参与Ontology定义与图谱验证环节。
- 这类系统对RAG知识工程提出新要求——不再仅关注文本切分与向量化,而需建立“语义-关系-规则”三层知识治理流程,传统知识库团队需补充图谱建模能力。
- 在AI安全治理层面,决策溯源能力使企业首次具备对AI输出进行法律级举证的技术基础,但同时也要求日志体系与图谱存储满足同等等级的完整性与防篡改要求。
- 其确定性图谱构建机制降低了LLM调用频次,这对控制推理成本敏感型场景(如高频审批Agent)具有直接工程价值,但需权衡建模投入与长期可维护性。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们