DataFlow-Harness:弥合自然语言到生产级数据流水线的鸿沟
北大等机构推出开源框架DataFlow-Harness,引导LLM智能体构建结构化、可视化、可审计的数据处理DAG流水线,端到端通过率达93.3%,API成本降低72.5%,解决NL2Pipeline鸿沟问题。
如果你让一个AI编程智能体编写一个独立的Python脚本以解析单个JSON文件,它很可能在几秒钟内就给出完美答案。但当你要求同一智能体构建一个系统性的数据处理流水线时——例如摄取成千上万份杂乱文档、对文本进行分块、评估质量,并为适配你特定企业技术栈的检索增强生成(Retrieval-Augmented Generation, RAG)系统过滤噪声——该智能体却常常失效。
尽管大语言模型(LLM)在一次性代码生成方面表现出色,但其针对复杂数据处理任务所生成的输出通常为自由格式、一次性的脚本。这些脚本脱离了MLOps团队在生产环境中所依赖的、可管控的工作流抽象,因而难以进行审计或通过可视化方式编辑。
为解决这一问题,北京大学的研究人员, 中关村学院(Zhongguancun Academy), 以及上海高级算法研究院(Shanghai’s Institute for Advanced Algorithms Research)推出了 DataFlow-Harness,这是一个开源框架,引导LLM智能体逐步构建结构化、可视化的数据处理工作流,而非从零开始编写原始代码。
该框架使AI生成的流水线更易于管理并集成到现有架构中,因为所生成的产物具有持久性且易于编辑。
研究人员报告称,该平台在一项包含12项任务的数据工程基准测试中实现了93.3%的端到端观测通过率。相较于标准Claude Code,它将API成本最多降低72.5%,响应延迟降低49.9%,同时取得与AI在拥有完整代码库前提下编写标准脚本几乎相同的成功率。对企业团队而言,这意味着在获得AI自动化速度的同时,不会累积难以管理的技术债务,从而确保流水线保持安全、可审计且随时可用于生产环境。
“NL2Pipeline鸿沟”(NL2Pipeline gap)
以数据为中心的AI需要支持合成数据生成、检索增强和模型训练等任务的工作流。虽然LLM能够将自然语言翻译为可执行实现以完成这些任务,但高任务准确率对于生产部署而言仍不足够。
DataFlow-Harness论文的第一作者何润明(Runming He)向VentureBeat表示:“第一道障碍通常并非编写Python代码。现代编程智能体往往能快速生成看似合理的脚本。更难的问题在于将该脚本扎根于实际生产平台:使用真正已安装的算子(operators)、匹配真实数据集模式(schema)、引用已注册的数据集与模型服务、保留各阶段之间的依赖关系,并留下另一名工程师能够理解并修订的产物。”
通用型AI智能体经常虚构依赖关系,依赖不可用的算子或过时的平台假设。它们并未留下另一名工程师能够理解并修订的产物,而是生成了一次性代码,这类代码难以通过工作流管理工具进行审计。
研究人员将这一挑战定义为“NL2Pipeline鸿沟”:即用户以自然语言表达工作流需求,与生产环境要求结构化、持久化流水线资产之间存在的脱节。
研究人员在其实验中证实了这一鸿沟。例如,当允许Claude Code利用代码库上下文编写标准的自由格式脚本时,其成功率可达94.2%;然而,当限制其仅能使用平台特定的构建模块来创建原生工作流图时,其成功率则下降至83.3%。这一差距正是该论文的核心发现:原生的、可管控的流水线对智能体而言,其构建难度显著高于一次性代码。
研究人员写道:“弥合这一鸿沟不仅需要提升代码生成准确性:构建过程必须始终立足于平台语义,并产出可与宿主平台集成的产物。”
四个组件如何协同工作
何润明表示:“DataFlow-Harness改变了智能体的动作空间。它不再要求智能体输出任意代码,而是通过MCP检索实时算子注册表与当前流水线状态,并对一个持久化的有向无环图(DAG)施加类型化、增量式变更。”
为实现此目标,该平台围绕四个组件组织工作流合成:数据流水线后端(Data Pipeline Backend)、交互层(DataFlow-WebUI)、MCP工具层(MCP Tools Layer)以及AI引导层(DataFlow-Skills)。
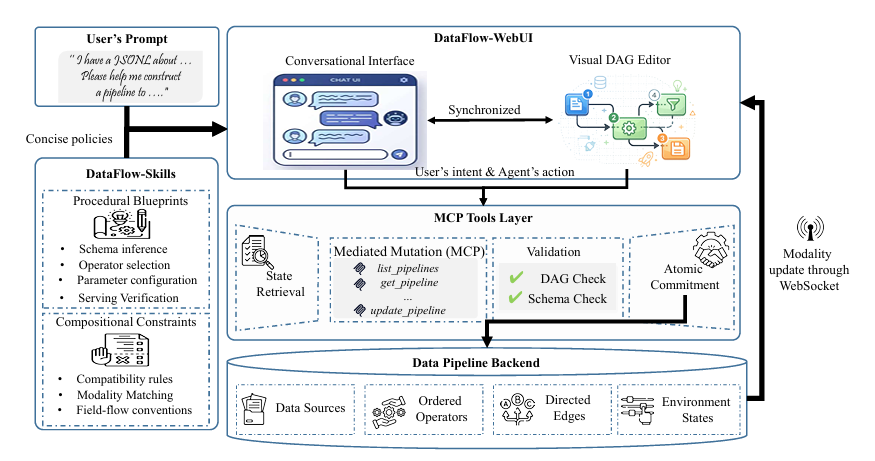
DataFlow-Harness架构(来源:arXiv)
数据流水线后端作为对话式、可视化及程序化接口的权威事实源(source of truth)。它将流水线表示为一个有向无环图(DAG),即一张结构化工作流地图,其中包含数据源、经配置的预建处理模块(研究人员称之为“算子”)以及执行依赖关系。智能体并非生成自由格式代码,而是通过“类型化变更”(如添加算子或连接边)与该后端交互。
DataFlow-Skills是Markdown文件,将领域特定知识注入模型的上下文窗口,指导模型进行算子选择模式、模式推断(schema inference)及组装流程。技能并非放任AI猜测如何组装组件,而是向AI提供兼容性规则,教导其如何正确匹配不同数据格式、处理复杂数据结构,同时不破坏流水线。
MCP工具层赋予AI访问算子注册表及当前数据工作流状态的能力。AI通过工具层提出结构化变更。系统验证这些变更,以确保工作流按有效顺序运行,且每个相连模块均采用相同的数据语言。
DataFlow-WebUI提供两种界面,支持人类与AI协同构建工作流。开发者可通过对话式界面以自然语言描述工作流需求;也可通过可视化DAG编辑器以图形化地图形式访问工作流。在此界面中,开发者可直接检查AI提出的变更并进行修改。
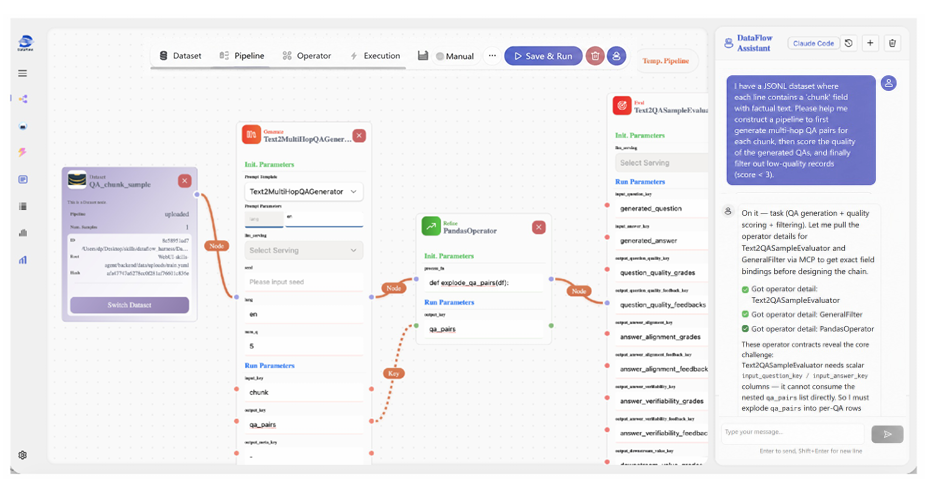
DataFlow-WebUI(来源:arXiv)
何润明表示:“当前实现会在接受流水线变更前,基于平台元数据执行静态检查。这些检查包括:已注册数据集、算子及模型服务引用的校验,字段流向(field flow)校验,部分无效参数用法校验,以及结构有效性校验。结果可在图形化编辑器中直观呈现,并可通过人工或后续轮次由智能体进行修订。”
实验结果:93.3%通过率,成本降低72.5%
研究人员在涵盖六个工业数据处理场景(如问答生成、评论治理及模式规范化)的12项任务基准测试中对DataFlow-Harness进行了测试。他们在实验中以Claude Opus 4.7作为基础模型。
他们将DataFlow-Harness与三个基线方案进行了对比:
Vanilla CC:使用标准Claude Code的无约束编码基线。
Context-Aware CC:一个在其上下文窗口中可访问DataFlow代码库的智能体。
仅限MCP:一种可访问DataFlow MCP工具并被指示生成平台原生DAG(但无权访问DataFlow-Skills)的智能体。
DataFlow-Harness实现了93.3%的端到端通过率,较仅限MCP方案提升10.0个百分点,并优于Vanilla CC(91.7%),同时与Context-Aware CC(94.2%)相差仅0.9个百分点。
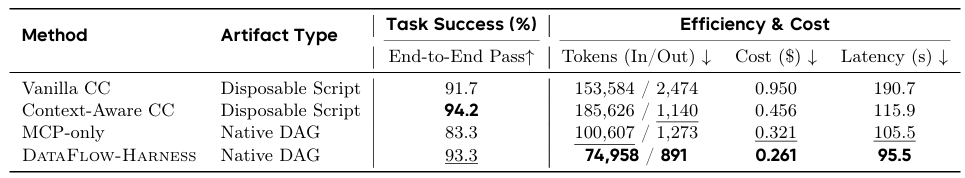
DataFlow-Harness在数据处理基准测试中的性能(来源:arXiv)
重要的是,其每项任务的API成本降至0.261美元,较Vanilla CC下降72.5%,较Context-Aware CC下降42.8%。在工作流生成方面,其速度比Vanilla CC快49.9%,比Context-Aware CC快17.6%。
DataFlow-Harness在依赖隐式领域知识的复杂任务(例如问答生成)中表现尤为出色。基线仅限MCP方法虽常能生成结构上有效的DAG,却难以仅凭算子描述推断出任务特定的流程。
为展示该方法在现实世界中的运作方式,研究人员详细阐述了一项教科书到视觉问答(VQA)提取任务。该任务要求AI整合PDF解析、版面恢复、OCR、图表提取、多模态理解以及长距离问答匹配等能力。DataFlow-Harness实现了97.2%的精确率和87.3%的覆盖率,轻松超越各项基线方案。通过让AI拼接现有平台资产而非从零编写复杂任务代码,该方法从文档中恢复了更多有效的问答对。
他们的实验还表明,DataFlow-Harness在构建数据生成流水线方面极为高效。例如,在一项合成指令数据生成任务中,该智能体构建了一个多阶段流水线:生成候选指令–响应对、对其进行批判性评估与重写、使用基于大语言模型(LLM)的裁判进行评分,并在训练前过滤低质量输出。
“此类工作流若以一系列临时脚本形式构建,不仅开发成本高昂,且维护脆弱,”他指出,“该Harness并不会自动使其具备安全性,但它将这些工作流转化为显式、可编辑的阶段,工程师可借助常规生产管控手段对其进行检查、测试与治理。”
同样,在构建数学数据清洗与合成流水线的任务中,由DataFlow-Harness流水线生成的数据所训练出的模型,在AIME24和AIME25基准测试上的平均准确率高于由Vanilla Claude Code流水线生成的数据所训练出的模型。
技术栈适配与实现权衡
对于正在评估DataFlow-Harness的工程团队而言,理解其如何融入现有基础设施至关重要。该框架以Apache 2.0许可证发布,当前实现需投入一定工程工作方可适配主流技术栈。
“当前实现原生适配DataFlow平台;它并非即插即用的Airflow、Prefect或Spark插件,”他指出,“若要将这些系统用作执行主干,团队必须构建一个适配器,将其组织的注册表、元数据及执行接口连接至该智能体的控制层。”
此外,组织必须投入资源界定AI应遵守的边界。这需要维护算子注册表、定义模式,并将反复出现的领域流程编码为Skills。鉴于此类开销,他建议避免在简单一次性转换(此时一段简易脚本已足够)或无法暴露可靠元数据的遗留环境中使用该框架。
最后,尽管该平台通过验证结构性属性来防止逻辑错误连接,但它仅是一个工程控制层,而非合规性替代方案。“Harness仍应被视为工程控制层,而非合规政策、经验证的检测模型、访问控制、审计日志或人工审批的替代品,”他指出。
该平台为开源项目,开发者可通过该项目的 GitHub仓库直接访问源代码及代码库文档。
随着MCP等协议逐步标准化,人类工程师与AI智能体之间的边界将发生转变。“目标并非在无人监督下实现自主数据工程,”他指出,“而是实现更优的劳动分工:智能体在明确界定的边界内执行重复性构建工作,而工程师则持续负责语义、策略及需领域问责的关键决策。”
JOTO 企业落地观察
- 对企业部署而言,DataFlow-Harness将AI生成的数据流水线从一次性脚本升级为可版本控制、可审计的DAG资产,显著降低MLOps团队在RAG等场景中因技术债务导致的运维风险,但需投入资源维护算子注册表与Skills知识库。
- 对智能体工程而言,该框架通过MCP工具层+类型化变更+Skill注入,强制智能体动作空间受限于平台语义,不再自由生成代码,而是增量编辑持久化DAG——这标志着智能体从‘代码生成器’转向‘工作流协作者’。
- 对AI安全治理而言,框架内置的静态检查(如字段流向、注册资产校验)提供了基础工程控制,但明确声明不替代合规策略、访问控制或人工审批;其价值在于将隐性逻辑显性化,使安全审查对象从不可读脚本变为可视化、可干预的阶段节点。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们