腾讯把企业知识库开源了,我第一时间拆了它的架构
腾讯开源企业知识库 WeKnora,支持 PDF、Word、扫描件等十余种格式解析,内置 PaddleOCR-VL 实现扫描件 OCR;采用父子分块策略兼顾检索精度与上下文完整性;提供关键词+向量混合检索、rerank、Graph RAG 等多层检索能力;全栈插拔式设计,支持 29 家大模型、8 种向量库及主流云存储;v0.8.2 起内置 MCP Server,可作为标准化 AI 工具后端服务。
它凭什么敢这么说
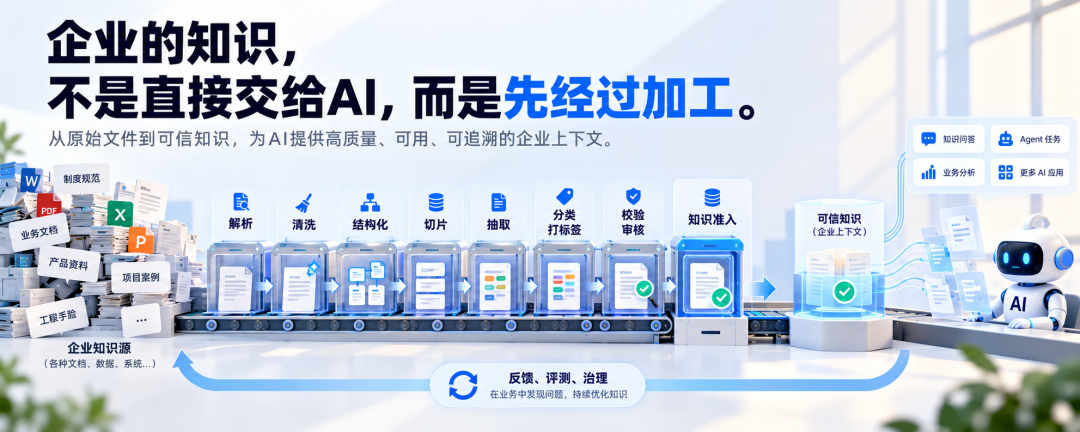
一个能处理文档的系统,核心就三件事:把文件读进来、把它切碎、让它能被搜到。
绝大多数开源项目只做好其中一件。WeKnora 的做法是——把三件都做成可以换的零件。
先看最外层的结构。它由四个东西组成:前端、应用服务、文档解析器、以及一排存储后端。文档解析器是单独拆出来的一个服务,叫 docreader,它自己不存任何东西,只负责把各种格式的文件变成结构化的文本。
这个拆法很关键。因为文件格式是这世界上最脏的东西。
第一层:格式的脏活
它支持 PDF、Word、PPT、Excel、CSV、TXT、Markdown、HTML、EPUB、MHTML、JSON、XMind、图片——十几种。
Office 那几种它用了一个内置的解析器叫 anydoc,在自己进程里就完成了。扫描件走的是 PaddleOCR-VL,一个视觉大模型做 OCR。
这是它跟大多数开源知识库的第一个区别:扫描件不是外挂,是内置能力。
我自己的方案里,OCR 是单独一个项目、单独一套流程。它的方案里,OCR 是解析器的一个选项。
第二层:把文档切碎
文档切分是知识库最容易被低估的一环。
切得太粗,检索出来的东西不精确;切得太细,上下文全丢了。WeKnora 的做法是父子分块——一个大的语义块作为父块,里面套若干个小的子块。检索的时候用子块去匹配,返回的时候把父块带出来。这样既有精度,又有上下文。
更关键的是:每个 chunk 可以单独编辑、看差异、回滚。
这句话听起来平淡,但做过知识库的人会知道这意味着什么。传统做法是——你发现某一段切得不对,改完必须重建整个索引。一份几百兆的资料重建一次要几分钟到几十分钟。它的做法是,改那一个块,带版本历史。
第三层:怎么让它被搜到
检索有三层:
关键词和向量混合搜;搜完做 rerank 重排;再往上还可以接 Graph RAG——用知识图谱的方式把实体和关系织起来。
它官方给的能力表里还写了端到端评测,带召回率和 BLEU、ROUGE 指标。意思是它有一套标准的方法告诉你:我这次检索到底准不准。
这些都是可以换的
这是我认为它最工程化的一点。
大模型支持 29 家。向量库支持 PostgreSQL、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Apache Doris、腾讯向量库。对象存储支持本地、S3、MinIO、腾讯云、火山、阿里云、华为云、金山云。
每一层都能换。这意味着你可以只拿它做解析和切分,把数据吐进你自己的数据库;也可以全都用它的。
一个我没想到的细节
它 v0.8.2 版本里内置了一个 MCP Server。
每个知识库可以发布成一个独立的 MCP 端点,带自己的 token、自己的知识库范围、自己的限流。也就是说,装一套 WeKnora,它不仅能自己用,还能变成一个所有 AI 工具都能调的后端服务。
Cursor 能调、Claude 能调、任何支持 MCP 的 Agent 都能调。
我准备怎么用它
我不会拿它替掉我现在的东西。我打算把它当成数据清洗的前端入口。
客户把各种乱七八糟的文件、管道文件塞进来。它负责把文件洗干净、切碎、结构化。然后数据流进我们自己的 PostgreSQL。
我要的是最后那个结果,不是它那一整套界面。
最后一句
其实这件事的意义不在 WeKnora 本身。
而在于:当一个有工程能力的团队决定开源一套企业级基础设施时,小团队最花时间的那部分脏活,第一次有了免费的成熟答案。
我现在花在写解析代码、维护 OCR 流水线上的时间,可以拿去做别的了。
JOTO 企业落地观察
- 企业部署知识库时,文档解析环节长期依赖定制开发或拼凑多个开源组件,WeKnora 将 OCR、多格式解析、结构化输出封装为统一服务,显著降低 RAG 知识工程的初始集成成本。
- 父子分块 + chunk 级别版本管理的设计,使知识库内容迭代不再绑定全量索引重建,这对需高频更新制度文档、合同条款等场景的企业知识工程尤为关键。
- MCP Server 的内置,意味着该系统天然适配智能体(Agent)调用范式,企业无需额外开发适配层,即可将知识库能力注入各类 AI 工具链,加速 FDE 驻场共创中“工具即服务”的落地节奏。
- 全栈插拔架构虽提升灵活性,但也对企业技术选型能力提出更高要求——向量库、大模型、OCR 模型的组合效果需实测验证,不能仅依赖默认配置,这对 AI 安全治理中的模型可控性与结果可溯性构成新挑战。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们