OpenAI 推出 GPT-6.1 Sol 与 Ultrafast 层级:以 1/5 成本逼近 Astra 性能,推理速度达 300 token/s
OpenAI 发布 GPT-6.1 Sol,编程与专业任务性能接近 GPT-6 Astra,但输入/输出 token 成本仅为后者的五分之一;同步推出 Ultrafast 推理层级,API 下最高 300 token/s,价格为标准档 6 倍。企业可依延迟敏感度与成本约束,在智能、速度、经济性三者间精细权衡。
OpenAI 推出 GPT-6.1 Sol,这是 GPT-6 Sol 的升级版本,OpenAI 表示其在编程、计算机使用及专业工作流方面已接近其旗舰模型 GPT-6 Astra,同时标准输入与输出 token 价格仅为 Astra 的五分之一。
与此同时,OpenAI 正式推出 Ultrafast,这是一项高级推理层级服务,可在 Codex 中实现最高达 8 倍、在 API 中实现最高达 6 倍的 token 生成速度,峰值可达 每秒 300 个 token。
以该速度计,OpenAI 的 Ultrafast 层级将稳居当前模型市场高速端,但尚非绝对吞吐量领导者。
独立第三方基准测试机构 Artificial Analysis 目前测得 Google 的 Gemini 3.5 Flash 约为 201 tokens/sec,而专为超高吞吐量推理优化的模型则远超此值: Mercury 2 约为 769 tokens/sec 以及 Celeris-1 约为 1,491 tokens/sec。
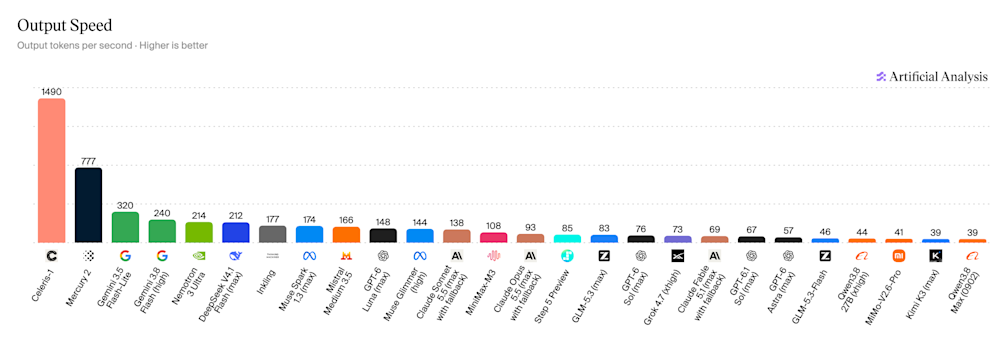
模型输出速度(每秒 token 数)的 Artificial Analysis 基准测试结果。图片来源:Artificial Analysis
关键区别在于,OpenAI 是在其前沿 GPT-6 级模型上提供该每秒 300 token 的上限,而绝对速度领先者通常为专门针对超高吞吐量推理优化的模型。
该速度附带显著溢价:API 使用费用为对应模型标准费率的 6 倍。Ultrafast 即日起已对 GPT-6 Astra 开放,而公司表示面向 GPT-6.1 Sol 的版本即将推出。
上述发布共同为企业开发者构建了更宽广的价格-性能光谱。组织可基于相对廉价的 Sol 模型运行日益复杂的自主任务,或在响应延迟而非 token 成本成为限制因素时支付更高费用。
GPT-6.1 Sol 在维持 Sol 定价的同时向 Astra 性能靠拢
最重要的定价细节或许正是 OpenAI 未上调的部分。
GPT-6.1 Sol 的定价为:每百万输入 token 2 美元、每百万缓存输入 token 0.10 美元、每百万输出 token 10 美元。
其未缓存输入与输出费率与 GPT-6 Sol 相同,而缓存输入费率则从每百万 token 0.20 美元降至 0.10 美元,降幅达 50%。 OpenAI 当前的开发者文档 将 GPT-6 Sol 列为:输入 2 美元、缓存输入 0.20 美元、输出 10 美元。
因此,从预算规划角度看,此次代际升级异常直接:开发者可从 GPT-6 Sol 迁移至 GPT-6.1 Sol,而无需接受更高的基础 token 费率。
与 Astra 的对比则更为显著。OpenAI 当前对 GPT-6 Astra 的收费为:每百万输入 token 10 美元、每百万缓存输入 token 1 美元、每百万输出 token 50 美元。因此,GPT-6.1 Sol 的标准未缓存输入与输出成本恰好为 Astra 的五分之一,而其 0.10 美元/百万 token 的缓存输入费率则仅为 Astra 的十分之一。
作为参照,OpenAI 当前折扣价的 GPT-5.6 Sol 为每百万输入 token 4 美元、每百万输出 token 20 美元,这意味着 GPT-6.1 Sol 的当前 token 价格亦为该较早一代 Sol 模型的一半。OpenAI 的定价文档指出,GPT-5.6 Sol 的促销定价至少持续至 2026 年 11 月 21 日。
模型 / 层级 | 输入 / 百万 | 缓存输入 / 百万 | 输出 / 百万 |
GPT-5.6 Sol,当前促销价 | 4 美元 | 0.40 美元 | 20 美元 |
GPT-6 Sol | 2 美元 | 0.20 美元 | 10 美元 |
GPT-6.1 Sol | 2 美元 | 0.10 美元 | 10 美元 |
GPT-6 Astra | 10美元 | 1美元 | 50美元 |
该缓存输入成本降低对于企业级智能体(enterprise agents)尤为相关。长时间运行的编程智能体、研究系统及业务流程自动化系统,经常在多次调用之间重复使用系统指令、代码仓库上下文、策略、参考文档及其他提示材料。对于执行数百次或数千次模型推理轮次(model turns)的工作负载而言,降低此类可复用上下文的读取成本,其重要性可能超过输入价格的 headline 数值。
OpenAI 表示,Sol 模型的性能已大幅接近 Astra 的水平。
OpenAI 以一系列自身评测结果支撑其定价主张,显示 GPT-6.1 Sol 正在缩小与 Astra 的性能差距。在 DeepSWE v1.1——一项针对真实代码库中长时间软件工程工作的评测基准——上,OpenAI 表示,GPT-6.1 Sol 以约五分之一的成本达到与 Astra 相当的性能,并较 GPT-6 Sol 的最佳结果高出 6.4 个百分点。
在 GDP.pdf——一项涉及含图表、表格、示意图及细小字体信息等复杂专业文档的评测基准——上,OpenAI 报告称,GPT-6.1 Sol 在启用回退机制(fallbacks)时得分高于 Anthropic 的 Claude Opus 5.5,而每项任务成本却不到后者的二分之一;同时,其性能亦以约五分之一的成本逼近 Astra。
这些结果可能对基于 AutomationBench的企业级智能体部署更具直接相关性。AutomationBench 测试覆盖销售、营销、运营、支持、财务和人力资源六大领域共 47 种工具的端到端任务。OpenAI 表示,在中等推理强度下,GPT-6.1 Sol 较 Opus 5.5 高出 2.2 个百分点,同时每项任务成本约为后者的三分之一;在同一设置下,其表现亦较 GPT-6 Sol 提升 4.8 个百分点。
计算机操作任务亦呈现相同模式。在 OSWorld 2.0 离线数据集上,据 OpenAI 称,GPT-6.1 Sol 在最高推理强度下与 Astra 的差距仅为 2.1 个百分点,而每项任务成本约为后者的七分之一。
上述均为 OpenAI 自行开展的评测,而非独立的生产环境测试。该公司指出,其评测均在研究环境或 API 中进行,结果可能与生产版 ChatGPT 存在一定差异。但其定位十分明确:Astra 仍是能力上限最高的选项,而 Sol 正日益成为 OpenAI 希望开发者选用的模型——当智能体需反复运行、经济性与绝对基准性能同等重要时。
Ultrafast 将推理速度打造为一项高端产品。
OpenAI 此次公告的后半部分则聚焦于另一瓶颈:标准前沿模型虽足以完成工作流,但在人类用户需等待每次响应的应用场景中仍显过慢。OpenAI 的应对方案是 Ultrafast,本质上是一条高端推理通道。
OpenAI 表示 该档位推理速度最高可达每秒生成 300 个 token,在 Codex 中生成速度快达标准模式的 8 倍,通过 API 的生成速度则快达标准模式的 6 倍;API 使用费用为标准定价的 6 倍。
这一定价策略远比 OpenAI 现有的 Fast mode(此前称为 Priority processing,即优先处理模式)更为激进。OpenAI 当前 API 定价表对 GPT-6 系列模型收取标准费率两倍的价格:例如,GPT-6 Sol 在标准处理模式下的输入/输出价格为 2 美元/10 美元,而在 Fast mode 下升至 4 美元/20 美元;Astra 则从标准处理模式下的 10 美元/50 美元升至 Fast mode 下的 20 美元/100 美元。
模型 / 服务档位 | 速度 | 输入 / 每百万 token | 缓存输入 / 每百万 token | 输出 / 每百万 token | 相较标准档位价格 |
GPT-6 Sol — 标准档位 | 标准 | 2 美元 | 0.20 美元 | 10 美元 | 1 倍 |
GPT-6 Sol — Fast mode | 快于标准 | 4 美元 | 0.40 美元 | 20 美元 | 2 倍 |
GPT-6 Astra — 标准档位 | 标准 | 10 美元 | 1 美元 | 50 美元 | 1X |
GPT-6 Astra — 快速模式 | 比标准模式更快 | 20美元 | 2美元 | 100美元 | 2X |
GPT-6 Astra — 超快速 | API 中最高快 6 倍;Codex 中最高快 8 倍;最高达每秒 300 个 token | 60 美元* | 6 美元* | 300 美元* | 6X |
GPT-6.1 Sol — 标准模式 | 标准模式 | 2美元 | 0.10 美元 | 10美元 | 1X |
GPT-6.1 Sol — 超快速 | API 中最高快 6 倍;Codex 中最高快 8 倍;最高达每秒 300 个 token | 12 美元* | 0.60 美元* | 60 美元* | 6X |
* 推导出的定价: OpenAI 表示超快速 API 使用费用为标准定价的 6 倍,但其 DevDay 资料并未单独公布每一项超快速细目费率。因此,上述 Astra 和 GPT-6.1 Sol 超快速的数值系根据 OpenAI 公布的标准价格及宣布的 6 倍乘数计算得出。OpenAI 表示,对于同一基础模型,超快速的费用是快速模式的三倍、标准模式的六倍。
因此,在假设使用相同基础模型的前提下,超快速的费用是快速模式的三倍、标准处理的六倍。
对于 GPT-6 Astra,所宣布的 6 倍乘数折算为每百万输入 token 60 美元、每百万输出 token 300 美元,而标准模式为每百万输入/输出 token 分别 10/50 美元,快速模式为每百万输入/输出 token 分别 20/100 美元。
对于 GPT-6.1 Sol,一旦超快速上线,相同的已宣布乘数将意味着每百万 token 输入费用为 12 美元、输出费用为 60 美元;若该乘数统一适用于其已公布的每百万缓存输入 token 0.10 美元费率,则缓存输入费用为每百万 token 0.60 美元。
OpenAI 的 DevDay 资料仅说明了 6 倍乘数,而未单独列出这些 GPT-6.1 Sol 超快速 token 费率,因此这些数值系根据已宣布的定价推导而来,而非独立发布的细目价格。
从经济性角度看,超快速不太可能取代标准推理用于后台智能体、文档处理或其他以吞吐量为导向的任务。其明显适用场景是等待本身即产生成本的应用:交互式编程、客户支持、金融分析、事件响应以及其他需人工参与的系统。
OpenAI 已就此理念展开过实验。今年 8 月,它 预览了基于 Cerebras 硬件的 GPT-5.6 Sol 超快速版本 ,面向有限客户群体实现了最高达每秒 750 个输出 token 及最高达标准速度 14 倍的性能。OpenAI 强调金融研究、商业、支持与事件响应为其早期用例。
DevDay 的发布将该实验转化为更广泛的产品层级,尽管更新的 GPT-6 模型以获取更新智能为代价,部分牺牲了预览版的最大标称速度。
可用性——以及规模大得多的 DevDay 推广
GPT-6.1 Sol 已通过 API(模型标识符为 gpt-6.1-sol)提供,并面向 ChatGPT Work 和 Codex 的 Plus、Pro、Business、Enterprise 及 Edu 用户开放。OpenAI 明确表示其目前尚未在常规 Chat 中提供。
GPT-6 Astra 超快速现已通过 API 提供,并面向 Pro 500 和 Enterprise 客户在 ChatGPT Work 和 Codex 中开放。GPT-6.1 Sol 超快速将于未来数日内上线。
API 参考文档还公开了一个 access-controlled service_tier=ultrafast 针对受支持模型的选项。
此次模型发布仅构成规模大得多的 DevDay 推广中的一部分。 OpenAI 还宣布了 其 Dots 常驻智能体;Private Intelligence 隐私基础设施;Agents API 中的计算机使用能力;由 OpenAI 提供支持的 AWS Bedrock 托管智能体;全新的 Codex 云服务、CLI、代码审查与安全功能;Decisions API;扩展的插件及 MCP 事件触发自动化;协作式 ChatGPT Spaces、Pages 和幻灯片;团队任务;ChatGPT 与 Slack 和 Microsoft Teams 的集成;会议插件;使用 ChatGPT 登录;新的 Pro 500 订阅计划;以及面向企业客户的 OpenAI 商店。
然而,对于企业技术领导者而言,GPT-6.1 Sol 与超快速模式所揭示的,或许是比这些单个产品更为根本的转变:OpenAI 日益要求开发者不再仅优化“哪个模型最聪明”,而是需在三个独立变量之间进行权衡:智能水平、成本与延迟。
GPT-6.1 Sol 将具备能力的智能体执行大幅推向成本曲线的更低端。超快速则朝相反方向推进,要求客户在每一秒都至关重要的场景下支付高昂溢价。
这使企业架构师面临一项更精细的决策——并可能是一项更具经济效益的决策:仅在延迟能创造商业价值之处使用昂贵的推理,同时将更大规模的自主工作迁移至能力日益逼近前沿、却无需承担前沿价格的模型之上。
JOTO 企业落地观察
- 对企业部署而言,GPT-6.1 Sol 将高性价比智能体落地门槛显著下移:其在 DeepSWE、AutomationBench 等工作流基准上以 20% 成本达成近 Astra 水平,且缓存输入成本降半,利于长期运行的编程/业务自动化系统控制总拥有成本。
- 对智能体工程而言,Ultrafast 的 6 倍溢价定价与 300 token/s 速度形成明确信号——它并非通用加速方案,而是专为交互式场景(如实时编程辅助、客户支持会话)设计的‘延迟即服务’产品;开发者需重构调用逻辑,仅在人类等待产生真实商业损耗时启用该层级。
- 对 FDE 落地而言,OpenAI 此次将模型能力、推理延迟、token 成本拆解为三个正交决策变量,倒逼企业架构师放弃‘单点最优模型’思维;实际部署中需按任务类型分层选型(如后台批处理用 Sol,前台交互用 Ultrafast),这要求组织建立细粒度的 AI 成本归因与 SLA 分级机制。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们