相关文章
2060 篇高质量内容
打造你的企业级智能文档问答系统——Everything plus RAG 实战指南
用开源技术打造能理解文档的智能问答系统,解决海量文档检索与语义理解的痛点。 核心内容: 1. 传统全文搜索与AI问答的优缺点对比 2. RAG技术原理与开卷考试比喻解析 3. 基于Python+Flask的三层架构实战方案
LEANN:200GB 压到 6GB,笔记本跑 RAG 不是梦
LEANN 革命性压缩技术,让 RAG 应用在笔记本上也能轻松运行,6000 万文档仅占 6GB! 核心内容: 1. 传统 RAG 系统的痛点与 LEANN 的创新解决方案 2. LEANN 的技术原理:图索引与两步搜索机制 3. 实际应用场景与性能测试结果

如何用NotebookLM,把枯燥的财报解读成精美的PPT?
NotebookLM:你的AI学霸助手,一键将复杂财报变身高大上PPT! 核心内容: 1. NotebookLM的9大输出形式解析 2. 财报自动生成PPT的实战演示 3. AI重构商业叙事的底层逻辑
这次,RAG记忆被微信AI团队的超图盘活了
微信AI团队用超图技术突破RAG记忆瓶颈,让AI真正理解复杂关系! 核心内容: 1. 传统RAG在长文本推理中的痛点分析 2. HGMEM超图记忆系统的创新架构与三大核心模块 3. 在四大基准测试中实现性能与成本的双突破
企业级 RAG + 知识图谱的4 种主流实现路径
企业级RAG+知识图谱的五大实现路径解析,总有一款适合你的业务需求。 核心内容: 1. 开源组合派:自主可控但需强工程能力 2. 云原生托管派:省心省力但成本较高 3. 商业平台派:快速交付但定制困难 4. 混合增强派:推理精准但构建成本高 5. Agent编排派:动态进化但架构复杂
EdgeVec:浏览器原生向量数据库,让AI应用彻底摆脱服务器
EdgeVec让AI应用在浏览器中实现本地向量检索,无需服务器支持,数据安全且性能卓越。 核心内容: 1. EdgeVec的核心特性:零配置部署、极致内存优化、硬件加速 2. 完整数据库功能:元数据过滤、软删除、持久化存储、内存监控 3. 性能表现与快速上手指南
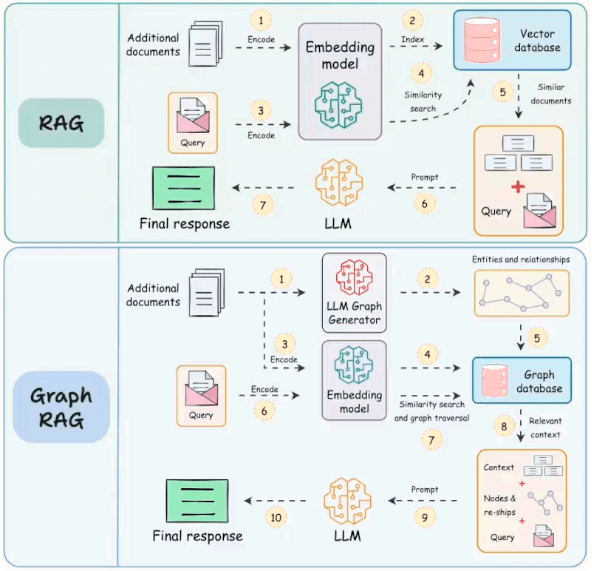
先RAG后KG,还是先KG后RAG?我们试了三种策略
RAG与知识图谱如何协同?三种策略帮你构建更可靠的智能问答系统。 核心内容: 1. RAG与知识图谱各自的优势与短板分析 2. 先RAG后KG的"大胆假设,小心求证"策略 3. 先KG后RAG的"证据确凿,娓娓道来"策略
不到 100 行代码用 LlamaIndex 搞一个“带脑子”的 RAG 系统(RAG + 知识图谱)
用不到100行代码打造智能问答系统,结合知识图谱让回答更精准! 核心内容: 1. 实战教程:基于LlamaIndex+Neo4j+Chroma搭建企业级智能问答系统 2. 知识图谱应用:实现"用户→部门→流程"的精准推理链路 3. 零门槛部署:普通笔记本即可运行,附完整代码和Docker配置指南
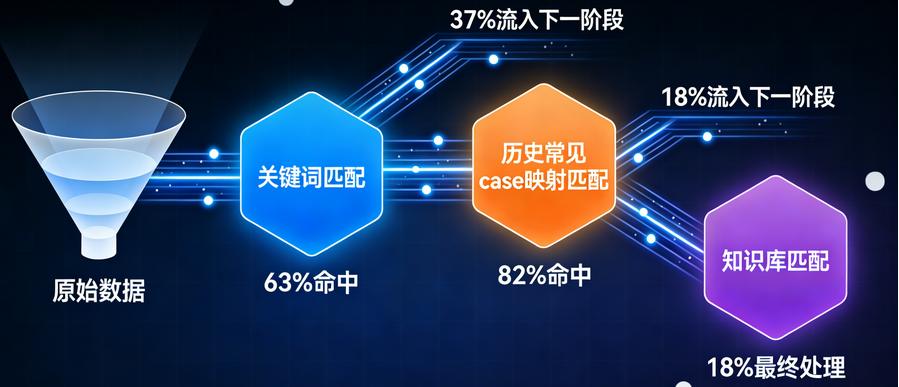
ASR+LLM+RAG视频内容识别全方案
ASR+LLM+RAG技术方案,精准解决视频内容识别难题,提升广告植入与竞品分析效率。 核心内容: 1. 传统方案痛点与新技术架构设计 2. 分层处理流程:ASR转写、文本预处理、精准匹配与模糊检索 3. 知识库构建与LLM在语义修复中的应用
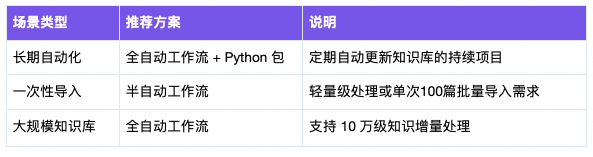
从工单、文档到结构化知识库:一套可复用的 Agent 知识采集方案
阿里妹分享了一套全自动化的Agent知识库建设方案,将分散的工单、文档智能转化为结构化知识,大幅提升效率与质量。 核心内容: 1. 传统知识库建设的痛点与人工方案局限 2. 自动化pipeline的五大核心能力与设计理念 3. Python工具包实现开箱即用,降低技术门槛
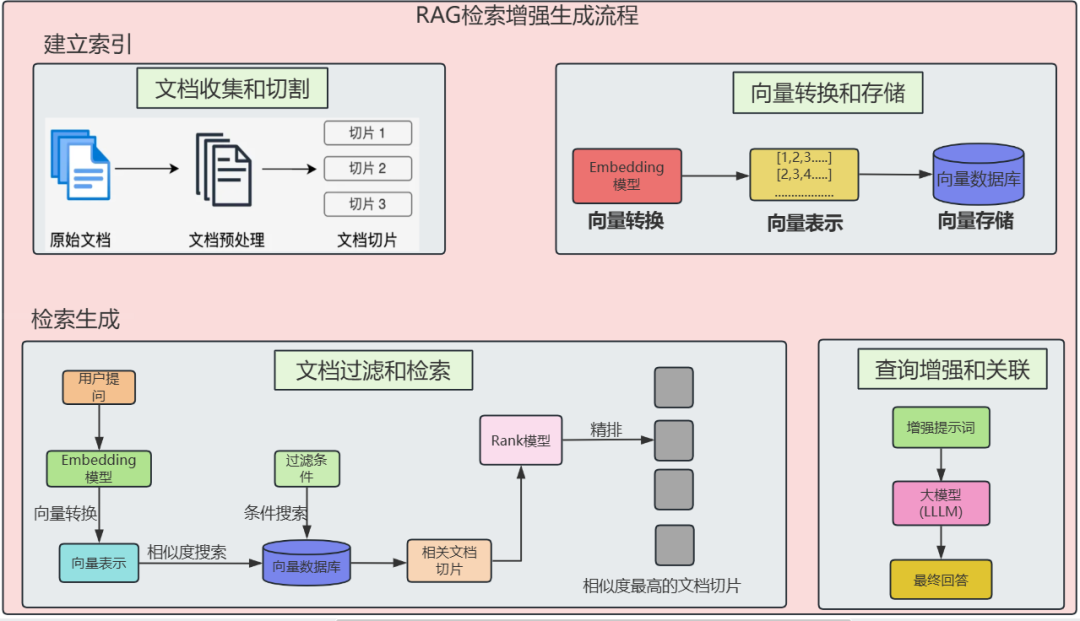
RAG知识库-文档过滤和检索
深入解析RAG知识库中的文档过滤与检索技术,掌握Spring AI提供的强大查询处理组件。 核心内容: 1. 检索前阶段的查询优化方法(重写、翻译、压缩、扩展) 2. Spring AI提供的四种查询转换组件详解 3. 代码示例展示各组件实际应用场景
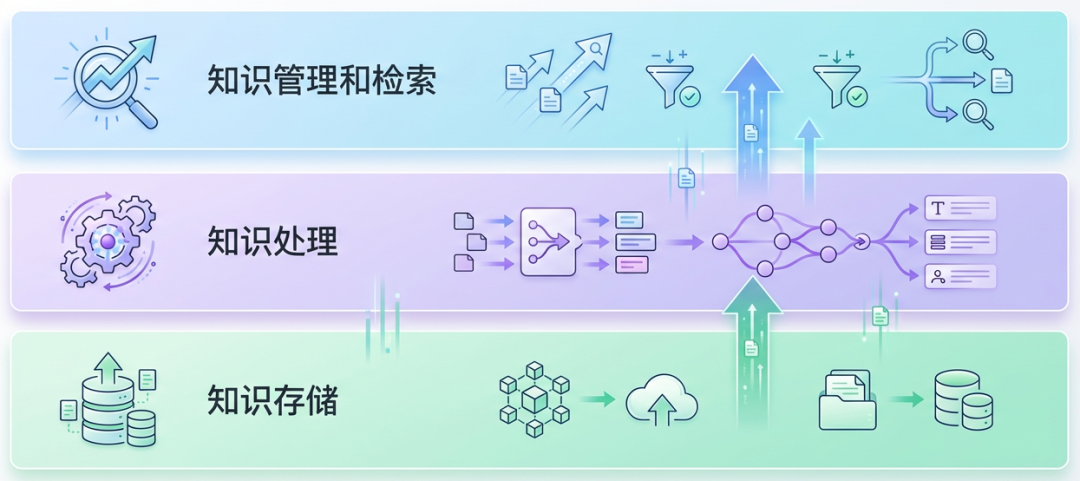
RAG落地实践:知识库三层架构和关键组件
RAG知识库系统的三层架构解析,助你打造高效稳定的智能咨询系统。 核心内容: 1. 知识存储层的三种核心数据类型与存储模式 2. 知识处理层如何提升检索召回率和精准度 3. 工程实践中确保数据一致性和高可用性的挑战
Dify x 阿里云 Tablestore:向量检索与结构化数据统一存储方案
Dify与阿里云Tablestore强强联手,为企业提供百亿级向量检索的轻量级解决方案,5分钟即可部署生产级RAG应用。 核心内容: 1. 当前生产级RAG面临的三大痛点:高成本、规模受限、召回不稳定 2. Dify集成阿里云Tablestore的创新方案:Serverless架构统一存储向量与标量数据 3. 通过计算巢实现一键部署,5分钟快速体验百亿级数据处理能力
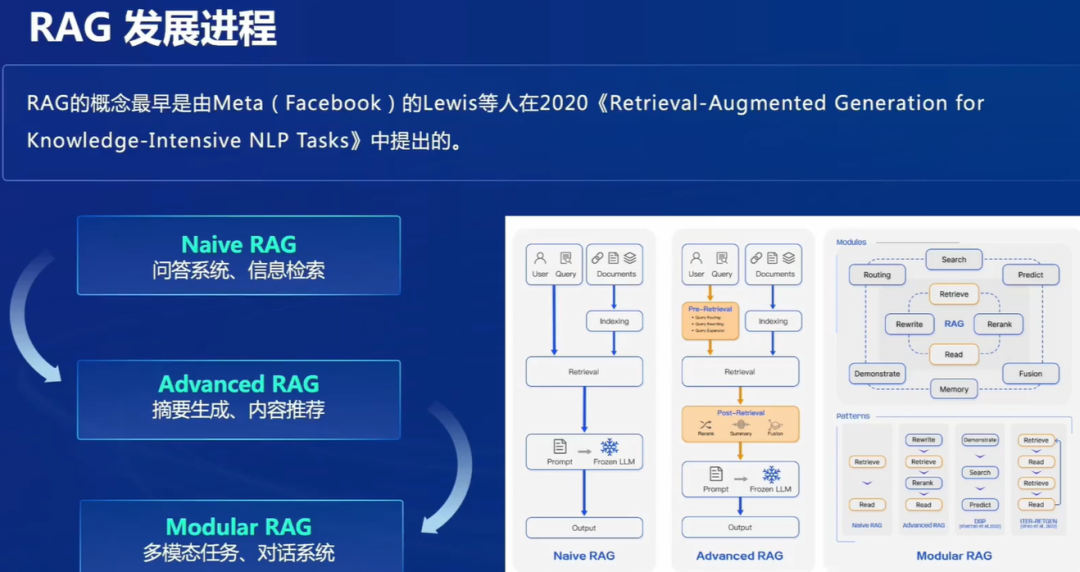
RAG检索增强是在给大模型“喂”数据?不,你是在为它构建一整套物流体系
RAG不是简单的数据检索,而是一套复杂的数据物流体系,知识库管理才是其核心挑战。 核心内容: 1. RAG系统的物流体系比喻:知识库是仓库,大模型是客户 2. 知识库管理的难点与重要性:入库、出库、更新等流程 3. 大数据量场景下的系统压力与解决方案
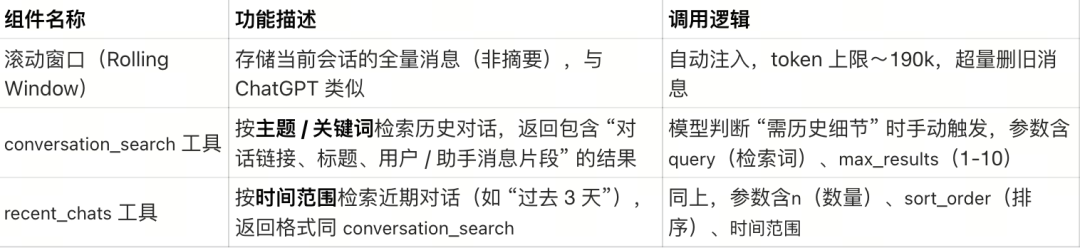
ChatGPT VS Claude ,Agent记忆用对话压缩还是RAG按需检索
ChatGPT与Claude在记忆模块设计上各显神通,一文揭秘两大AI如何实现个性化记忆。 核心内容: 1. ChatGPT采用四层静态注入架构,轻量化实现连续记忆 2. Claude运用RAG式按需检索,动态平衡记忆深度与效率 3. 两种记忆系统对日常Agent搭建的实践启示
上下文不等于记忆:从单Agent到多Agent协作,记忆系统是关键
Agent技术正面临记忆系统的关键突破,从上下文工程迈向记忆工程才能实现真正的多Agent协作。 核心内容: 1. LLM在记忆层面的三大结构性缺陷 2. 人类认知架构对AI记忆系统的启发 3. 构建持久化记忆系统的关键方法与价值
为什么Claude Code不用RAG?
Claude Code为何放弃RAG转向更原始的Agentic Search?揭秘代码助手背后的技术路线之争。 核心内容: 1. RAG被弃用的三大关键原因:性能体感差、索引更新滞后、安全隐患 2. Agentic Search的核心原理:基于Glob/Grep的实时动态搜索机制 3. 当前代码助手领域三大技术路线对比及优劣势分析
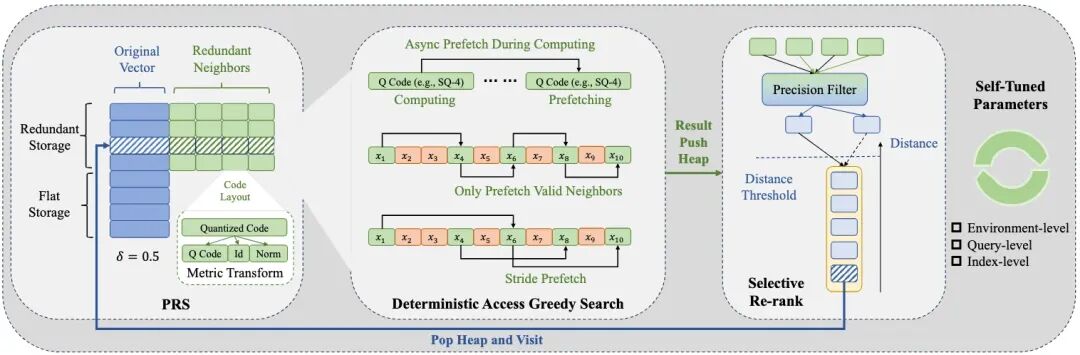
图索引性能提升 400%:详解 VSAG 向量检索框架
蚂蚁集团开源VSAG框架,通过三大优化实现图索引性能飞跃,最高提升400%检索速度! 核心内容: 1. 图索引技术面临的三大核心挑战:缓存不命中、参数敏感性和距离计算瓶颈 2. VSAG框架的三大创新优化:缓存优化、自动调参和距离计算加速 3. 实际应用效果:在保证高召回率前提下实现400%性能提升
告别关键词高亮,语义高亮才是解决搜索 / Agent噪音的标准答案
告别机械高亮,语义高亮让信息检索更精准高效,解决RAG和Agent场景中的核心痛点。 核心内容: 1. 传统关键词高亮的局限性与应用场景中的不足 2. 语义高亮技术的市场现状与挑战 3. 自研双语语义高亮模型的创新解决方案
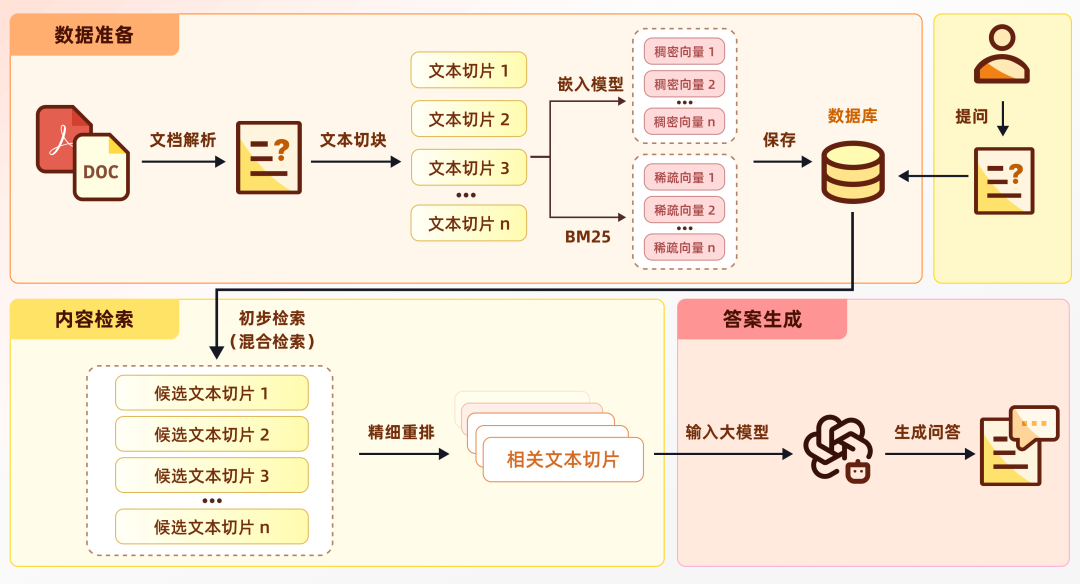
让RAG像人类一样“扫视全文”:上下文检索技术详解
RAG技术如何突破检索瓶颈?揭秘让AI像人类一样"扫视全文"的上下文检索技术。 核心内容: 1. 传统RAG系统因文本切块导致的语义割裂问题 2. 文档格式多样性带来的切块规则设计难题 3. 上下文检索技术如何实现更精准的语义理解