相关文章
2060 篇高质量内容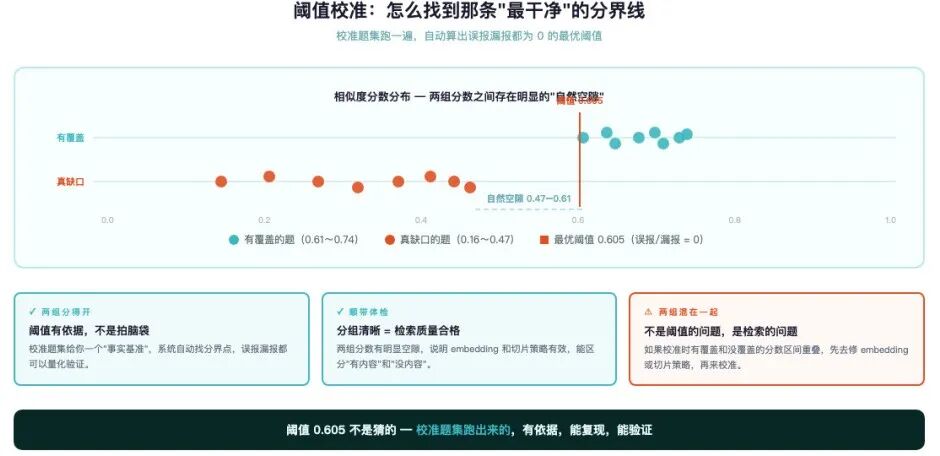
一个"知识库质检工具"
如何快速发现知识库的隐藏缺口?这个工具用问答当探针,一键生成精准的“缺漏报告”,核心在于其科学的判定逻辑与阈值校准。 核心内容: 1. 如何科学判定知识库“答不出来”的核心设计 2. 利用阈值校准模式确保检测结果可靠 3. 从知识图谱探索到朴素向量检索的最终选择
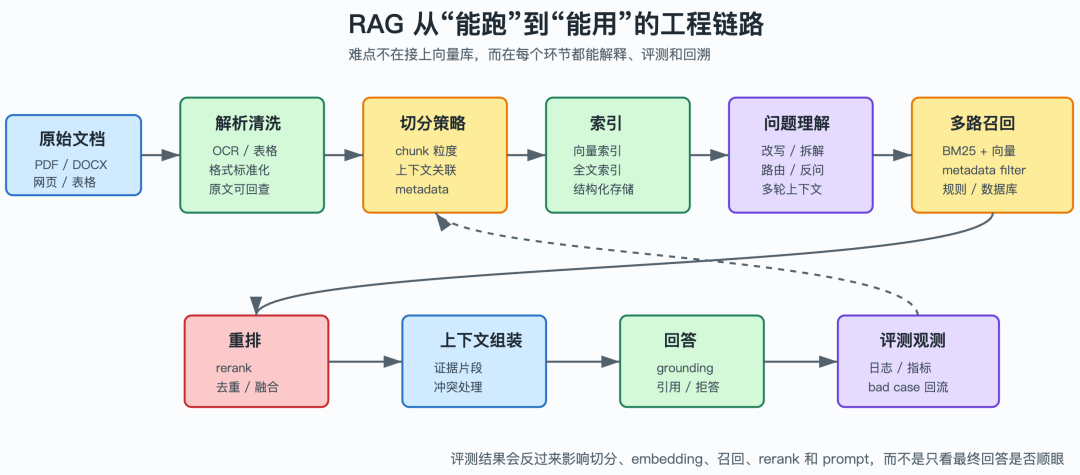
不要只是搭建:RAG 不是上传文档然后问答那么简单
探索RAG系统背后的工程挑战,从简单搭建到真正可用的知识库,需要克服哪些关键难题。 核心内容: 1. RAG系统从搭建到实用的工程链路详解 2. 当前教程与真实应用场景的差距分析 3. 提升RAG效果的关键技术与优化方向
3.1万Star!PageIndex:不用向量数据库,RAG准确率做到98.7%
PageIndex 开源系统通过树形索引与推理检索,彻底告别向量数据库,将 RAG 准确率提升至98.7%。 核心内容: 1. 传统向量RAG“相似不等于相关”的固有缺陷 2. PageIndex基于树形索引与推理检索的核心架构 3. 与传统RAG相比在准确率上的突破性提升
AI落地实战:企业RAG全链路实施方案
AI如何让沉睡的知识库“活”起来?企业RAG全链路实施指南,助你打通信息孤岛,激活核心资产。 核心内容: 1. 企业知识管理面临的五大核心痛点剖析 2. RAG技术的完整实施链路与关键环节 3. 跨行业应用场景与未来发展趋势
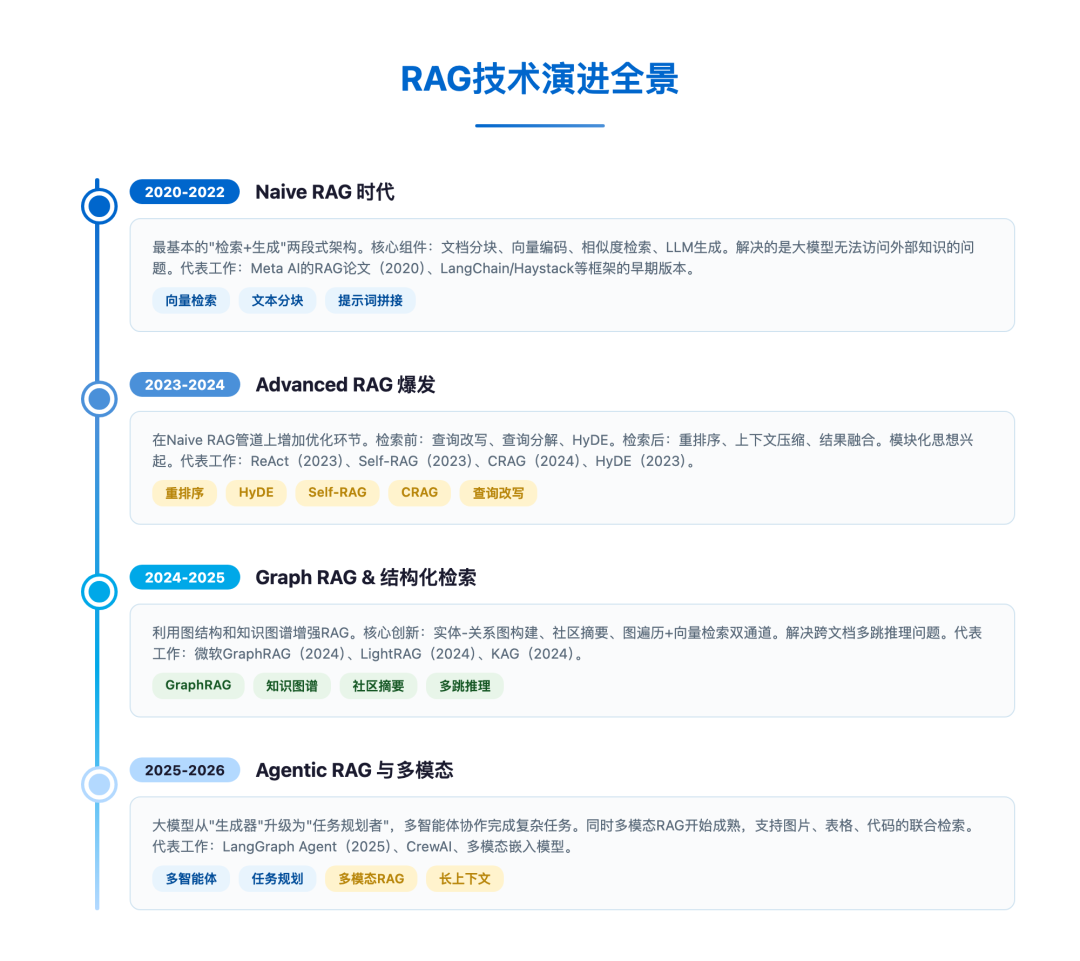
主流RAG技术全景 -- 从Naive到Agentic
梳理主流RAG技术演进,从Naive到Agentic,帮你理清技术选型思路,为投标书编写等场景找到最合适方案。 核心内容: 1. 从Naive RAG到Agentic RAG的技术演进脉络 2. Graph RAG、Self-RAG等各类技术的核心思想与适用场景 3. 针对投标书编写等实际场景的技术选型建议
如何构建一个更“好”的知识库?
本文深入探讨构建高质量RAG知识库的技术原理与工程实践,系统解决幻觉、召回不准等问题,实现端到端性能优化。 核心内容: 1. RAG知识库的评估标准与技术架构 2. 文档切分、检索增强与重排序等关键技术详解 3. 前沿优化方案与自动化工具的应用实践
7.9K星:Google黑科技TurboQuant开源实现,Rust重写向量检索提速30倍
TurboQuant 开源实现用 Rust 重写,为向量检索带来 30 倍提速,兼顾精度与效率。 核心内容: 1. 向量检索在速度与精度上的传统矛盾 2. TurboQuant 通过残差量化与多 probe 机制实现突破 3. turbovec 的 Rust 技术架构与性能优势
企业级智能体系统 RAG的分片优化逻辑
探索企业级RAG系统分片优化的实战方案,分享三种高效策略的实现逻辑与代码结构。 核心内容: 1. RAG系统中分片优化的必要性与价值 2. 固定窗口、语义、命题三种分片策略的详细实现 3. 完整的项目代码结构与服务设计解析
Vector Graph RAG 开源!一套向量数据库同时搞定语义检索+RAG多跳
Vector Graph RAG开源了,它巧妙地将图结构能力融入单一向量数据库,无需部署复杂的图数据库,就能高效解决RAG多跳问答难题。 核心内容: 1. 传统RAG在多跳推理中的困境与图数据库方案的局限 2. Vector Graph RAG的核心思路:用向量数据库构建逻辑图结构 3. 新方案在基准测试中的优异表现与实际应用价值
企业 RAG 知识库落地,应如何设计实现?
本文为你详解企业级RAG知识库的系统架构设计,并指明Java开发者的核心参与路径。 核心内容: 1. 企业级RAG系统的七层架构全景图 2. 从文档接入到评估运营的各层功能详解 3. Java开发者如何利用工程优势参与RAG项目
知识库分层编排:从 RAG 到 Agent-native Knowledge Context Layer
探索知识库编排的进阶之路,从RAG的局限到结构化Agent-native方案的突破。 核心内容: 1. 剖析当前RAG方案在工程知识库中的三大结构性缺陷 2. 梳理从平铺向量检索到结构化知识图谱的方法论演进 3. 提出面向Agent的原生知识上下文层解决方案
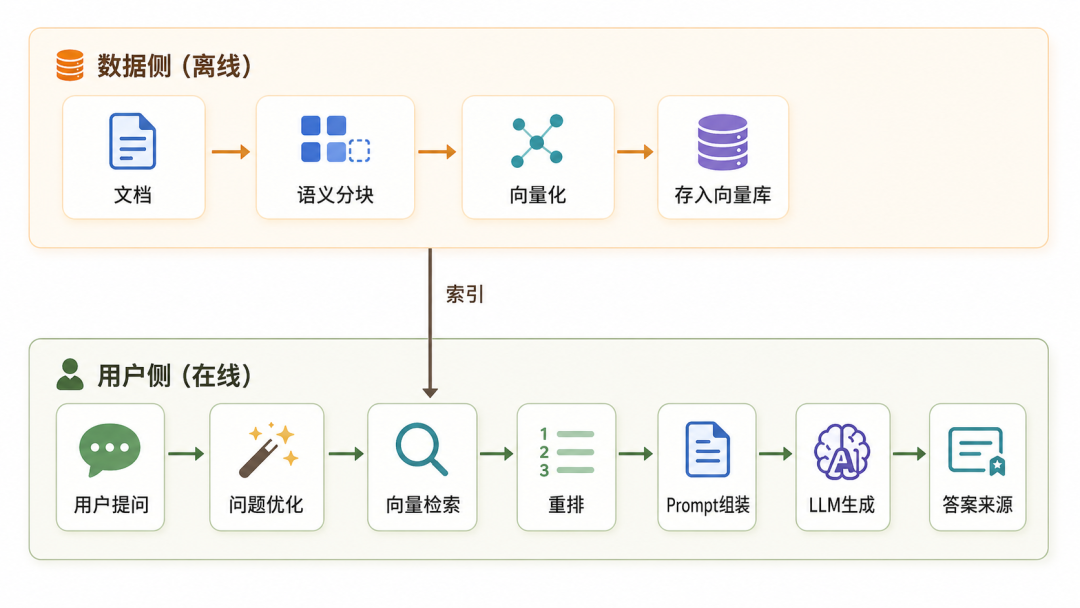
RAG 优化 20 法:从"搜得到"到"答得好"
优化RAG系统从"能跑"到"好用"的完整路径,20个实用技巧帮你解决检索不准、回答啰嗦和胡编乱造的问题。 核心内容: 1. 数据入库阶段的关键优化:语义分块、元数据过滤与摘要索引 2. 检索与生成环节的协同策略:多路召回、重排序与提示工程 3. 全链路优化的系统思维与评估反馈机制
企业 RAG 知识库落地,真正难的不是调用大模型
企业RAG落地最难的并非技术实现,而是数据治理与工程化。本文带你走出Demo误区,直面真实生产环境的复杂挑战。 核心内容: 1. RAG基础流程解析与Demo理想条件的局限性 2. 企业真实环境中的数据多样性、权限与成本等综合挑战 3. 文档解析、检索质量等核心难点的深度剖析
RAG 2.0 落地实战:从「检索增强」到「知识推理」的工程跃迁
从“检索增强”到“知识推理”,RAG 2.0如何实现工程架构的跃迁? 核心内容: 1. 传统RAG架构在2026年面临的三大致命缺陷 2. GraphRAG、Agentic RAG等下一代技术支柱的深度解析 3. 从“模块”到“循环”的认知结构升级路径
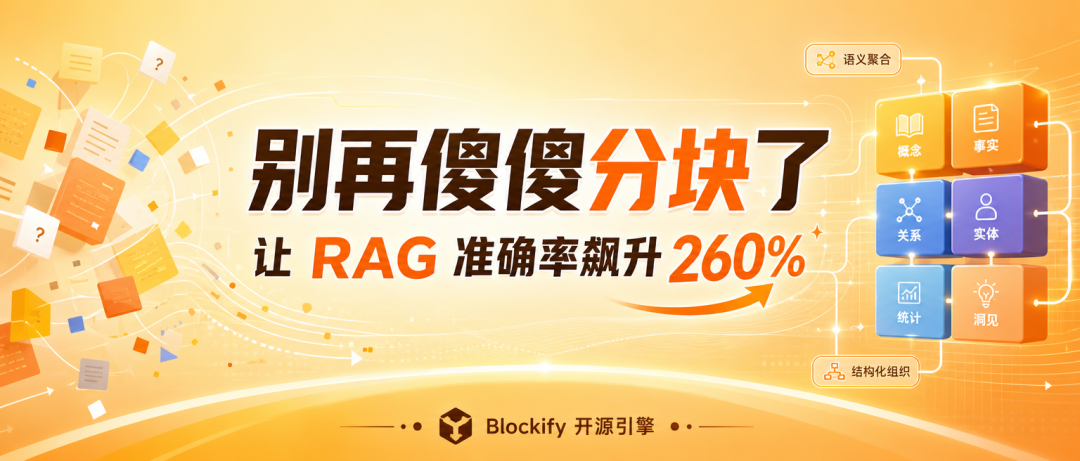
别再傻傻分块了:这个开源引擎让RAG准确率飙升260%
别再在RAG分块上浪费时间了,这个开源引擎从数据源头重构知识单元,让准确率实现质的飞跃。 核心内容: 1. 传统RAG分块策略的根本缺陷与问题根源 2. Blockify引擎如何用IdeaBlock重构知识表示 3. 从数据预处理层解决检索准确性的核心思路
万字长文!千万级文档 RAG 知识库系统落地实践
如何从“玩具级Demo”跨越到真正的企业级RAG知识库?本文结合千万级文档实战经验,为你拆解核心架构与解决方案。 核心内容: 1. 千万级文档RAG系统面临的五大核心挑战 2. 生产可用RAG系统的七层架构设计参考 3. 系统设计的三大原则:模块化、自动化与可观测性
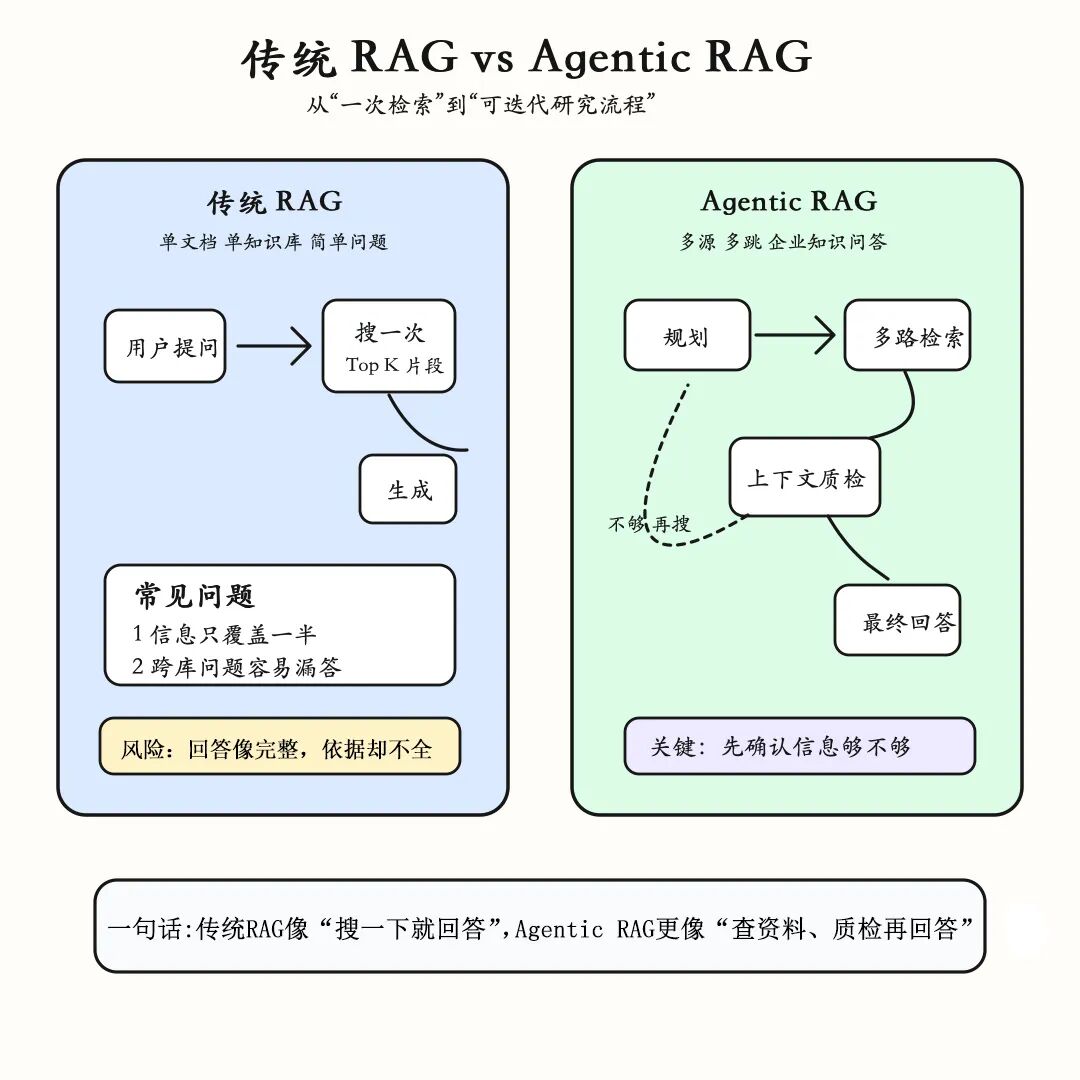
RAG不够用了?谷歌推出全新Agentic RAG框架
Agentic RAG让AI学会“打破砂锅问到底”,通过多智能体协作,彻底解决复杂检索难题。 核心内容: 1. 传统RAG的单次检索瓶颈与业务痛点 2. Agentic RAG的多智能体分工与协同工作流 3. 核心组件“充分上下文智能体”的创新机制
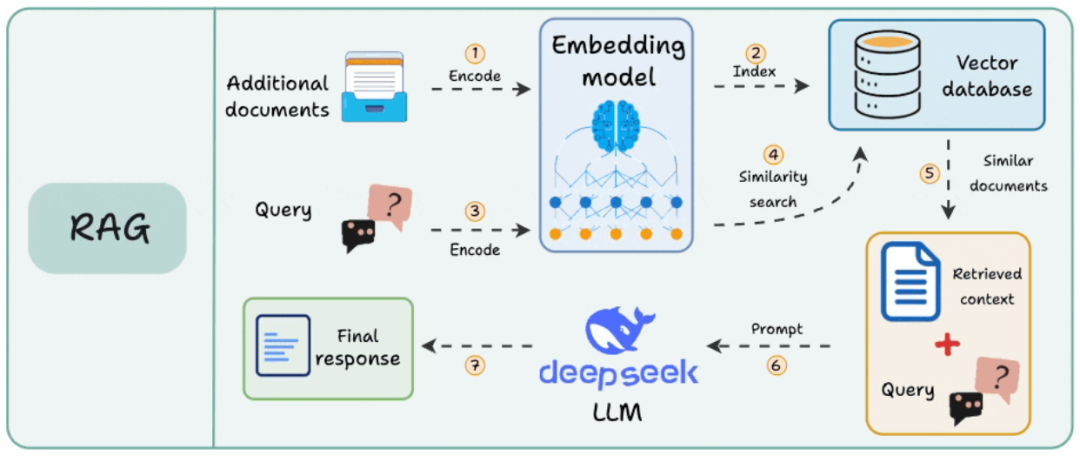
RAG检索:注定下沉为检索基础设施
RAG正从应用内部流程演变为可复用的基础设施,为AI系统提供持续、动态的检索能力。 核心内容: 1. Native RAG的局限性及独立检索层的优势 2. Agentic RAG中检索作为动态工具的工作机制 3. RAG演变为共享基础设施的核心趋势与价值
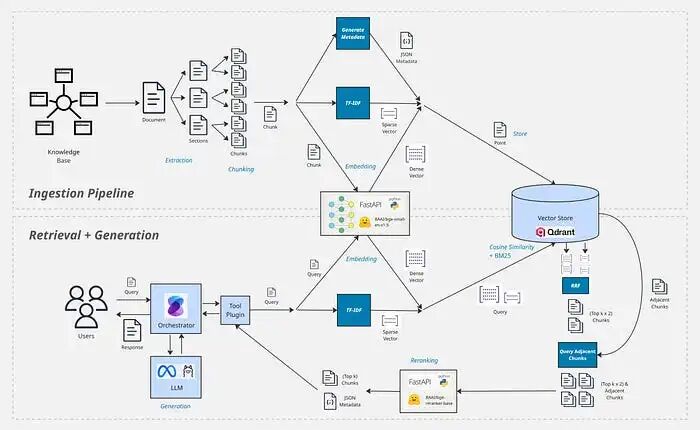
设计生产级 RAG 架构
RAG技术如何让LLM摆脱“幻觉”?本文带你用开源工具搭建生产级架构,从数据摄取到检索生成,一步步实现可靠的知识支撑。 核心内容: 1. 数据摄取管道的核心作用与设计挑战 2. 检索与生成流程的关键技术决策 3. 基于自身数据特性设计架构的最佳实践
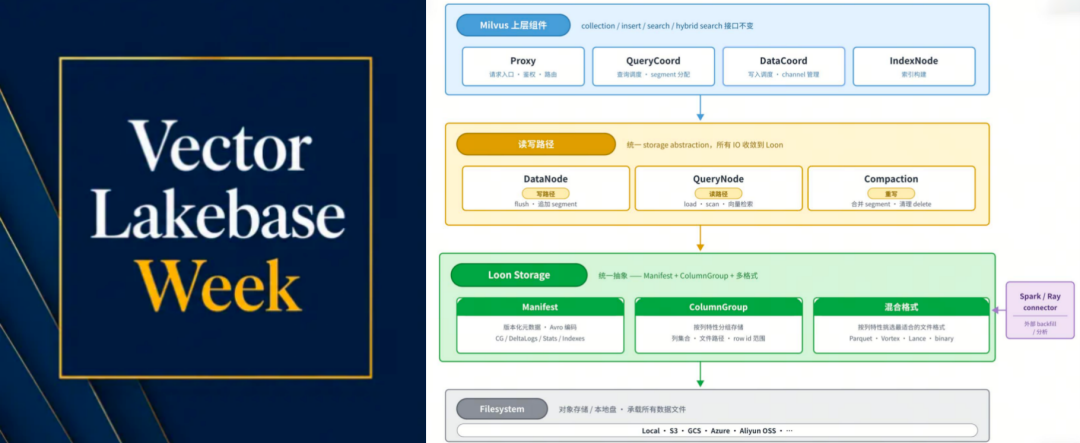
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎
我们为什么决定重构Milvus的存储引擎?因为AI时代的数据形态,已远超传统数据库的承载能力。 核心内容: 1. 传统存储模型在AI时代面临的三大典型问题 2. 全新Loon引擎如何通过混合格式等方案解决这些问题 3. 以多模态训练为例的AI数据生产场景剖析