相关文章
590 篇高质量内容
一篇讲清楚,如何构建AI知识库的目录结构和配套的Skills工作流
作者结合权威思路,详解AI知识库目录结构与Skills工作流,解决资料管理混乱难题,构建长期稳定的知识体系。 核心内容: 1. AI知识库目录结构分类(原始来源、笔记、原子等) 2. 参考的权威架构思路(LLM Wiki、GBrain等) 3. Skills工作流与目录的串联方法
别再迷信 LLM WIKI:大模型根本撑不起知识库的持续进化
别再迷信LLM WIKI!大模型无记忆特性难支撑知识库持续进化,传统算法通过多维度识别解决文件重复混乱问题。核心内容:1. 知识库当前混乱现状(重复版本、真假难辨)2. LLM WIKI理论与现实技术差距(大模型无记忆/无状态,无法持续进化)3. 传统算法解决方案(Hash/内容特征/文本指纹识别,本地快速扫描存储)
AI 时代的“HTML 时刻”:一个被严重低估的知识标准 OKF
AI时代知识标准被低估?Google OKF或如HTML般成底层核心,定义知识如何被人及Agent读取验证。核心内容:1. OKF定义与迭代:V0.2新增来源、验证等机制2. Agent基础设施定位:解决知识形式问题,连接模型与应用3. 底层价值与行业影响:类似HTML重塑知识接口,国内关注度不足

AI Coding的下一站,不是更会写代码,而是更懂团队
AI Coding团队效率瓶颈不在写代码,而在经验断层!本文分享0到1建设团队经验系统的完整路径,含三层治理链路与可复用方法论。核心内容:1. AI Coding团队经验断层的四类痛点(经验归零、重复踩坑等)2. 团队经验系统的核心目标:持续捕获、沉淀团队经验,让AI带项目语境进场3. 从0到1系统构建:初版问题、三层治理链路迭代及实验数据驱动的方法论
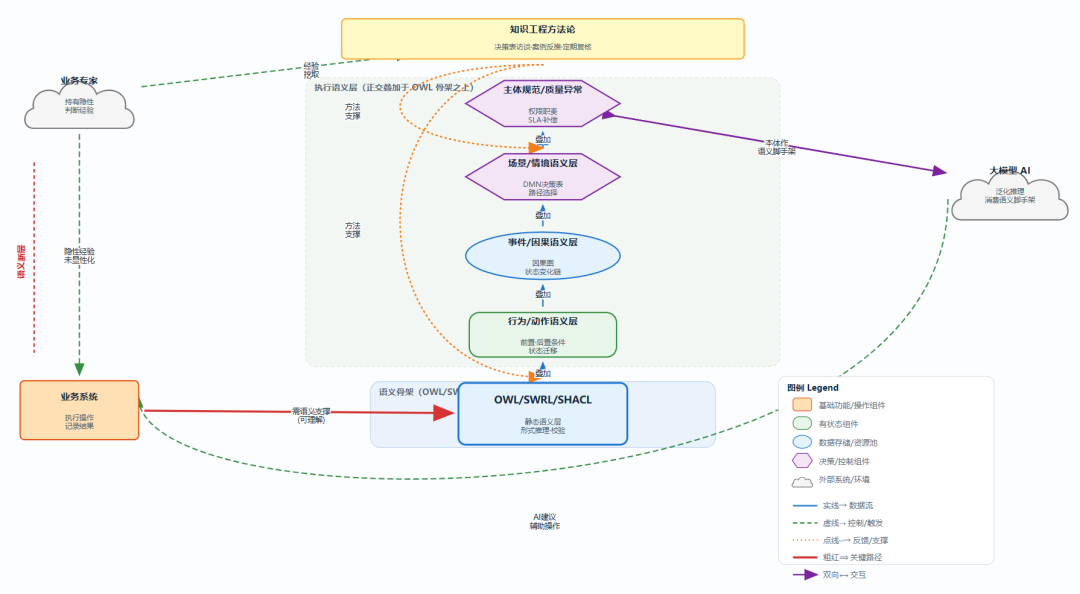
企业级知识工程和本体建模——系统的边界不是语义的边界
IT系统功能强却难成“参谋”?本文揭示系统边界非语义边界,本体建模助其升级为智能分析工具。 核心内容: 1. IT系统语义断层现象(如采购订单场景判断规则、退货处理链条等依赖人工经验) 2. 本体建模的关键:系统需包含更丰富语义以支持预测推理 3. 语义断层成因及本体建模补断层的解决方向
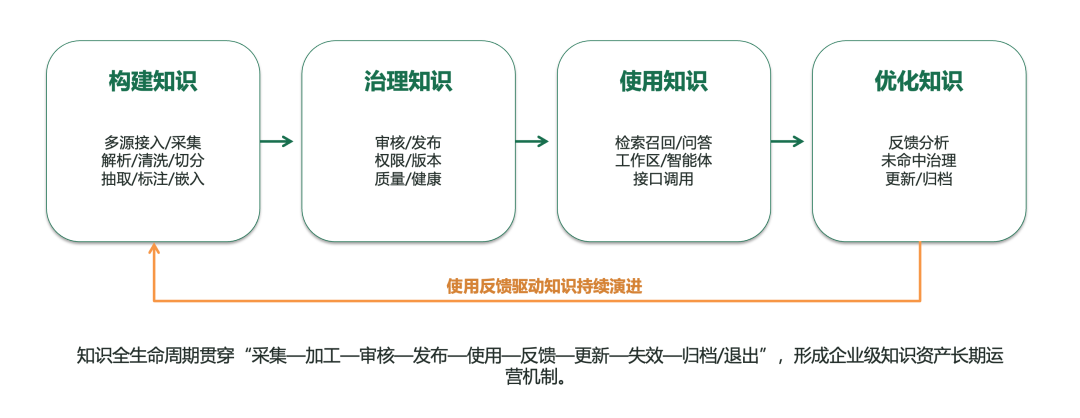
做完一次总体设计后,我重新理解了企业级知识库
作者通过企业级知识库项目实践,揭示其核心门槛:知识持续运行机制,而非简单文档上传系统。 核心内容: 1. 企业级知识库本质:非文档上传系统,而是知识供应链 2. 知识工程闭环:持续进入、使用、优化的运行机制 3. 核心价值:沉淀企业上下文,助力企业在Agent时代拉开差距
Agent Wiki 现状:AI 智能体的知识编译革命
Agent Wiki:AI智能体的知识编译革命,LLM一次性编译源文档成持久化页面,颠覆传统RAG的检索式维护难题。 核心内容: 1. Agent Wiki的核心理念:摄入时编译而非查询时检索 2. 系统三层架构:源文档、Wiki页面、Schema文件 3. 关键操作:Ingest(摄入)、Query(查询)、Lint(检查)
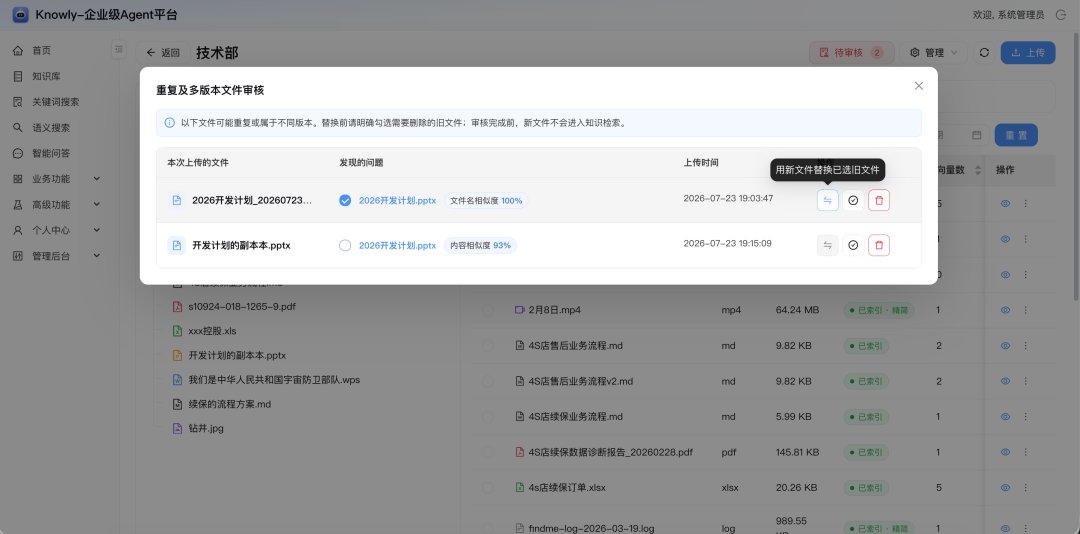
企业知识库最可怕的,不是“创建”,而是“持续治理”
企业知识库“创建易治理难”,重复文档、版本混乱致信任危机,Knowly功能帮你实时治理。 核心内容: 1. 重复上传相似文档的典型场景(如销售流程版本混乱) 2. 治理缺位导致的恶性循环与信任危机爆发 3. Knowly V3.11.0版本识别与内容查重功能及治理方案
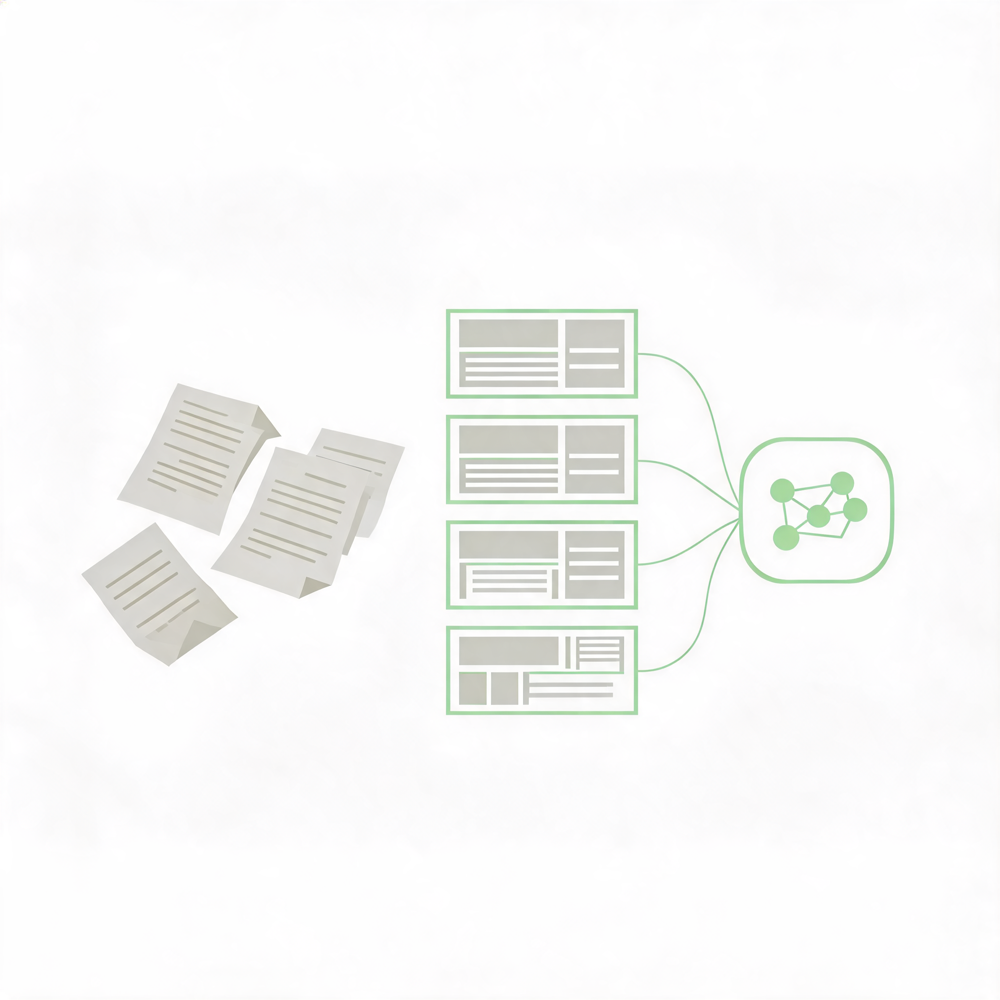
知识库不是文档仓库,而是 Agent 的上下文底座
AI应用上限取决于知识质量,知识库从文档仓库升级为Agent可消费的上下文底座,设计需遵循可读、可更新、可消费原则。 核心内容: 1. AI应用中知识散旧导致的上下文瓶颈 2. 知识库作为Agent上下文底座的核心目标 3. 知识库设计原则:可读\可更新\可消费
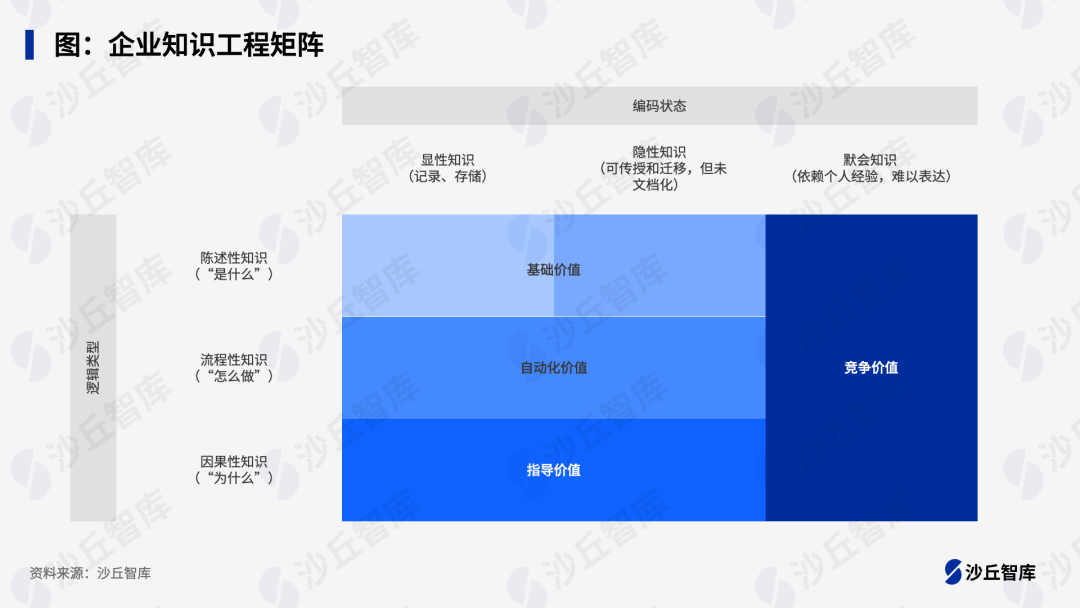
AI Agent知识工程:从企业隐性知识到可靠上下文
AI Agent时代,企业知识工程突破RAG局限,将隐性知识转化为可用上下文,支撑复杂任务执行。 核心内容: 1. 企业AI应用从RAG到Agent的能力升级需求 2. 知识工程的定义及企业知识的分类维度 3. 知识工程在构建语义等方面的核心价值
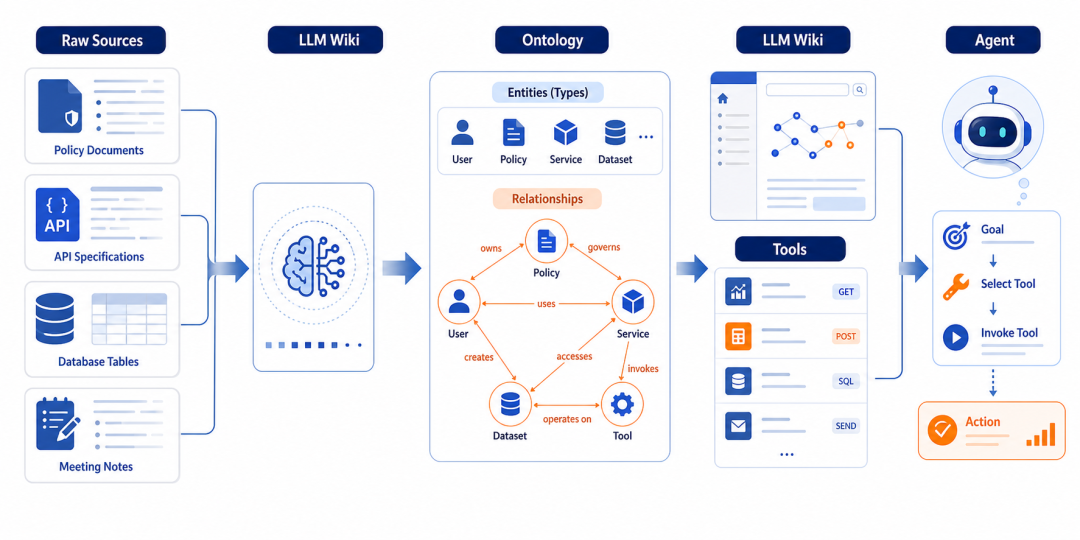
LLM Wiki + Ontology:让企业知识从“可检索”走向“可行动”
企业知识库接入大模型后,复杂业务问题仍难解决?LLM Wiki+Ontology让知识从“可检索”走向“可行动”,突破业务理解瓶颈。 核心内容: 1. 企业知识管理痛点:复杂业务问题暴露现有知识未结构化,Agent仅会搜索资料 2. LLM Wiki:提前编译知识,构建机器可理解的结构化知识体系 3. Ontology:定义业务实体、关系与约束,助力知识转化为可行动指令
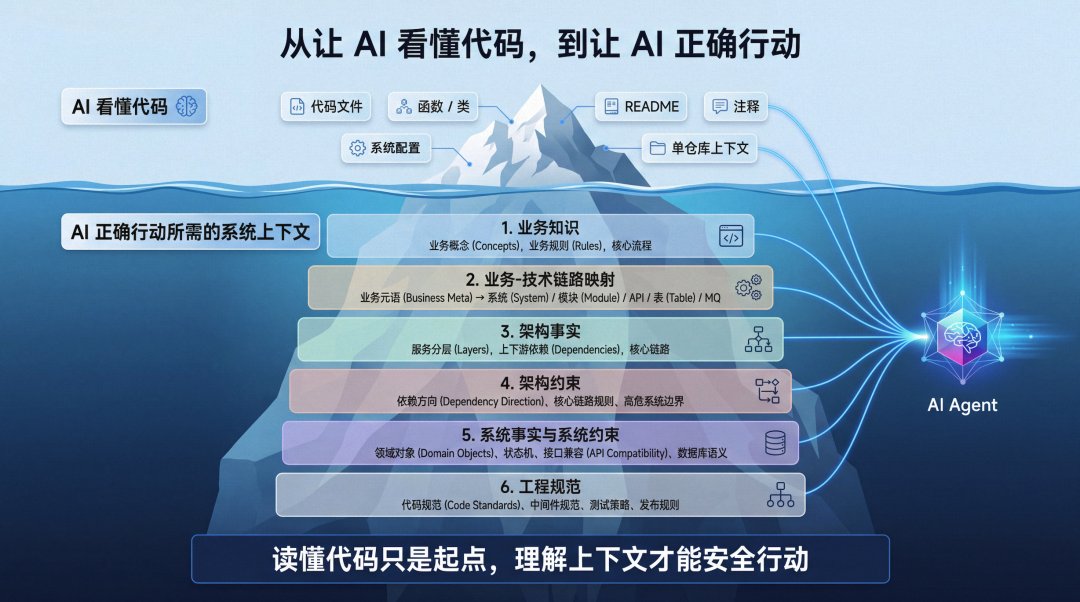
分解一座冰山:后端系统「AI 知识库体系」建设实践(长文干货)
后端系统AI Friendly化的核心在于知识库体系!本文拆解从“AI看懂代码”到“正确行动”的实践,干货解析不同场景下的知识形态设计。 核心内容: 1. AI在后端系统中面临的知识分散问题(代码外关键知识的缺失) 2. 知识库设计的场景化方案(新人onboarding/跨服务分析/安全修改代码的不同知识形态) 3. 技术方案设计的决胜作用(方案质量对后续研发流程的决定性影响)
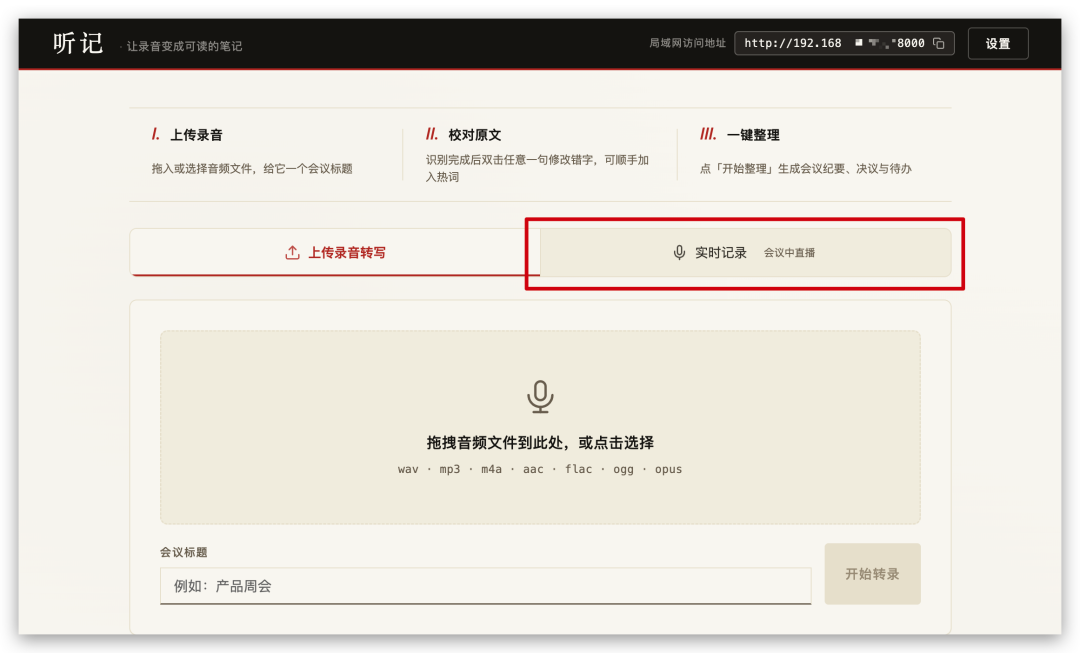
「听记」v0.4:我用 Kimi K3 给听记加了实时转录
「听记」v0.4新增实时转录,用Kimi K3实现边说边出字,标准/增强模式适配不同场景。 核心内容: 1. 实时转录功能及两种模式(标准/增强) 2. 实时转录的实现流程(采集、识别、存储) 3. 开发中遇到的关键问题与解决(权限、字幕排版等)
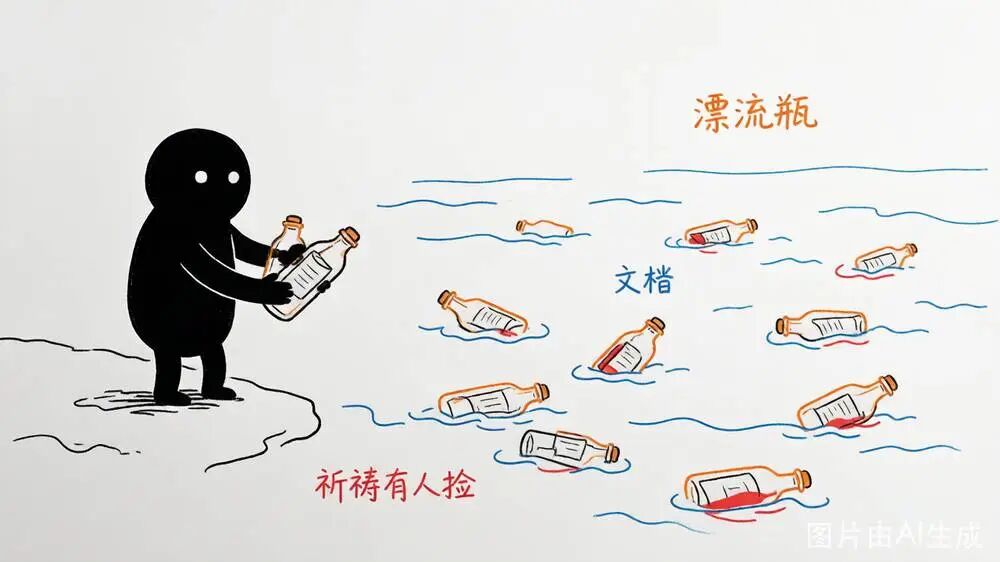
忘掉"漂流瓶"时代的企业知识库,用事件驱动激活,知识有消费才有增长
新一代企业知识库告别“漂流瓶”模式,通过事件驱动实现知识的主动激活与智能涌现,让知识真正流动起来。 核心内容: 1. 从被动检索到事件激活:知识围绕业务事件自动汇聚 2. 知识生命周期重构:激活、消耗与涌现的三步循环 3. 系统自我进化:历史与当下碰撞生成全新解决方案
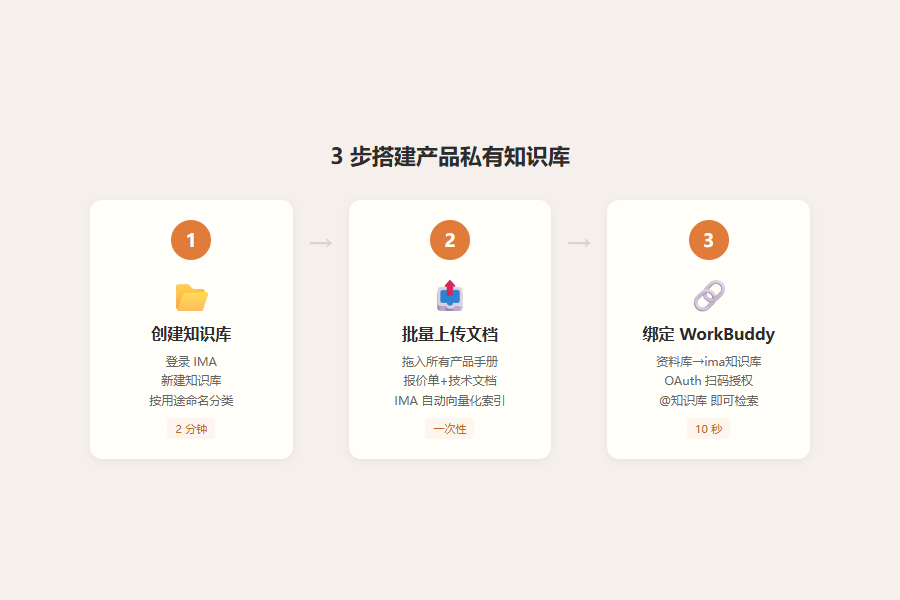
装一个"私有知识库"Skill,把公司所有产品手册喂给AI,以后问报价直接出答案
销售还在为翻产品手册发愁?用AI搭建私有知识库,10秒内精准报价。 核心内容: 1. 传统产品信息查询的三大痛点与效率瓶颈 2. 三步搭建私有知识库的核心工具与操作流程 3. 知识库应用实战:快速获取精准报价与信息
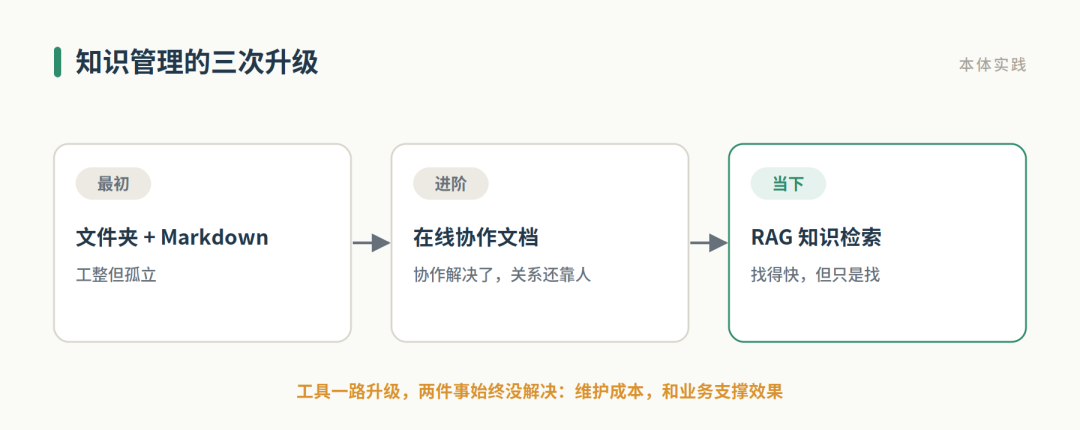
我为什么要用本体做文档知识库管理
用本体管理文档,打破传统知识库的僵局,让知识真正流动起来。 核心内容: 1. 传统文档管理(文件夹、在线协作、RAG)的演进与核心困境 2. 引入本体模型,如何解决知识维护跟不上变化、业务推理浅表化两大难题 3. 本体知识库的实践价值与未来展望
知识库是普通人在 AI 时代唯一的护城河
在信息过载的AI时代,如何让收藏的知识真正为己所用?程序员崔孟超用AI工具Unote给出了答案。 核心内容: 1. 个人知识管理的普遍困境与“收藏吃灰”现象 2. 用AI重构知识库的核心思路:从收藏到消化 3. Unote如何通过AI整理实现信息的找回、理解与应用
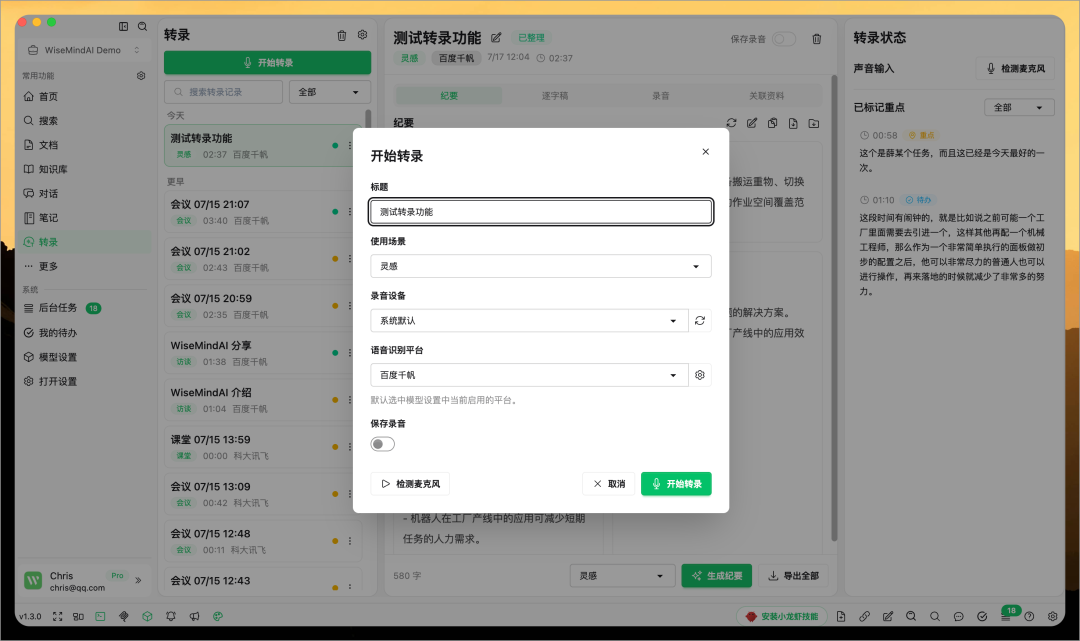
WiseMindAI v1.3.0 更新,实时转录来了!会议、课程和访谈边说边整理
用实时转录和AI知识大纲,让会议纪要、学习笔记一步到位,效率翻倍。 核心内容: 1. 实时转录功能:边听边生成逐字稿,并智能提炼重点与待办事项 2. AI知识大纲:将文档自动整理为结构清晰的知识树,突出核心与难点 3. 多项体验优化:信息图内容预确认、笔记模式切换与平台适配复制

从WorkBuddy企业版,到AI Native组织的关键问题
从WorkBuddy企业版出发,探讨AI如何重构企业协作的深层逻辑,揭示从个人效率到组织变革的必经之路。 核心内容: 1. AI时代下,个人效率提升与组织流程瓶颈的矛盾 2. AI进入组织后需要解决的三个层次问题(L1-L3协作协议) 3. 迈向AI Native组织的关键挑战与思考框架
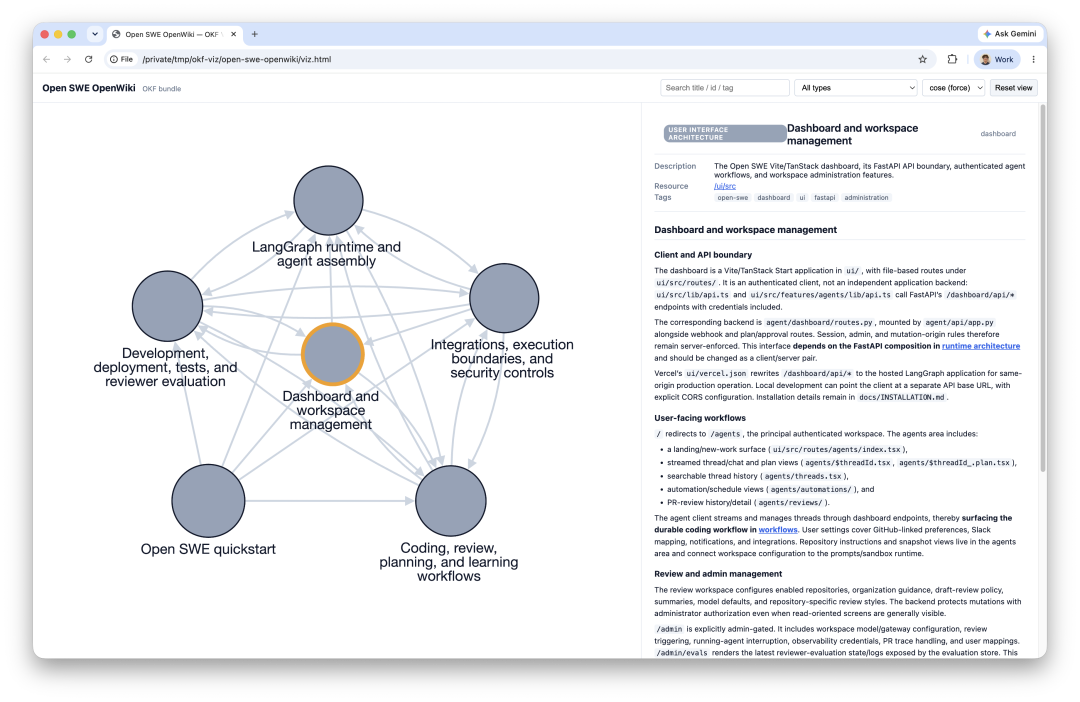
OpenWiki 0.2 接入 OKF,检索省时又省 token
让 Agent 检索代码库文档更高效,告别反复翻查与无效 token 消耗。 核心内容: 1. OpenWiki 0.2 接入 OKF 标准的意义与背景 2. LLM Wiki 模式如何革新传统 RAG 的文档管理方式 3. 这一整合如何为编程 Agent 带来效率提升