相关文章
590 篇高质量内容
Spec文档太大?要分层分场景
团队用 AI 写代码,卡点在对齐而非生成。这套 Spec 分级框架,通过三级规范和交叉校验,让 PM、研发、测试在 AI 动手前达成共识。 核心内容: 1. AI Coding 团队协作的核心瓶颈与对齐难题 2. 三级分级的 Spec 文档体系与 14 份覆盖全链路的文档模板 3. 依据风险定制的分级策略与关键设计原则
一种新的 LLM Wiki 方法论:让 AI 帮你建一个能活下去的知识库
告别一次性对话,用LLM Wiki打造可持续进化的知识库,让AI成为你的专属编辑。 核心内容: 1. RAG模式的局限与LLM Wiki的核心理念 2. 使用Obsidian高效采集与固化素材的实操步骤 3. 利用图谱视图维护与优化知识库结构
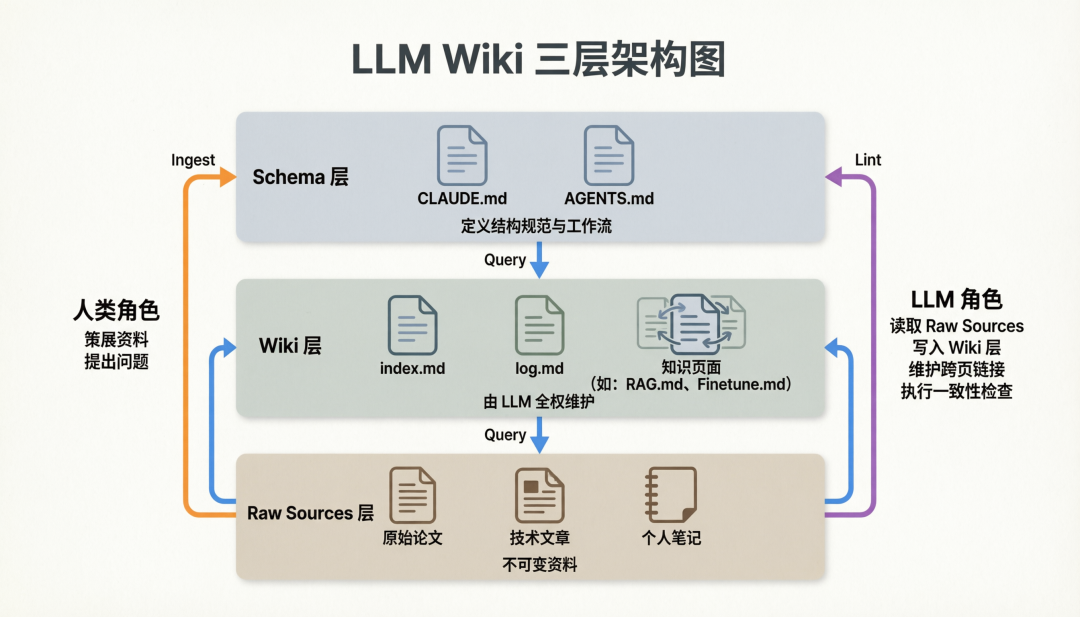
从RAG到LLM Wiki:用AI构建持续进化的个人知识库
告别信息收藏夹吃灰!LLM Wiki让你像维基百科一样,让AI主动消化知识,构建持续进化的个人知识库。 核心内容: 1. LLM Wiki与传统RAG知识库的本质区别 2. LLM Wiki三层架构与三种核心操作详解 3. 知识如何实现复合增长与主动维护
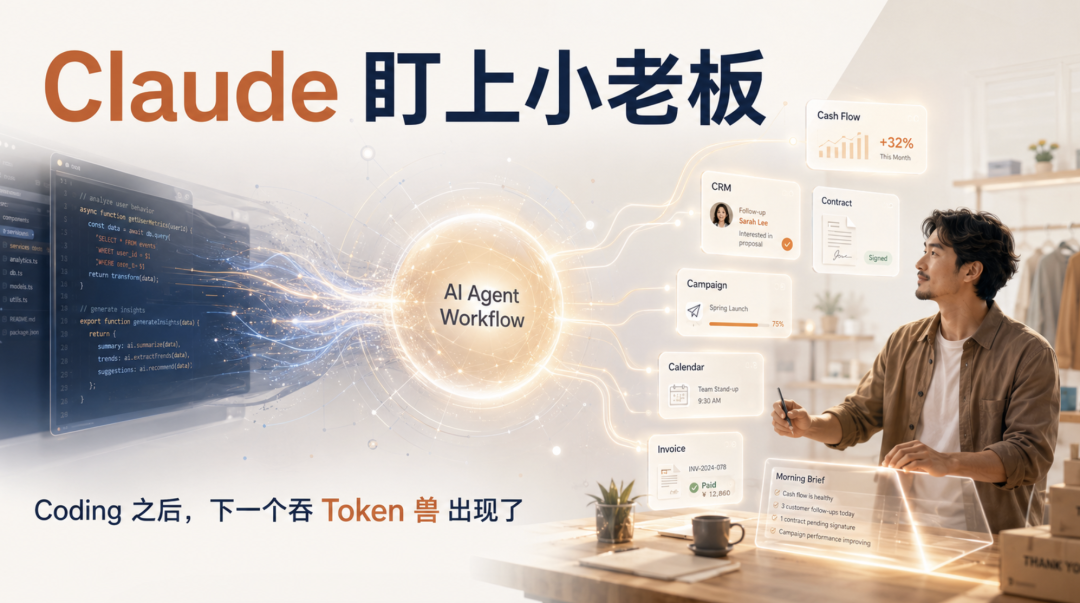
Claude 盯上小老板:Coding 之后,下一个吞 Token 兽?
大模型公司正从代码开发转向小企业经营,AI商业化的下一站可能就在小老板的待办清单里。 核心内容: 1. 大模型在代码开发场景率先实现商业化的原因 2. 小企业AI需求未被满足的症结与Claude的新方案 3. 从“回答问题”到“推进工作”的产品逻辑转变
HHM企业AI落地六步走:把AI写进经营决策链
企业AI落地不是工具升级,而是经营决策的重构。本文深度剖析如何将AI从工具层推进到决策链,实现真正的业务价值。 核心内容: 1. 企业AI落地的常见误区与核心痛点 2. AI如何重构企业决策链条与组织能力 3. 实战落地的六步走路径与核心场景选择
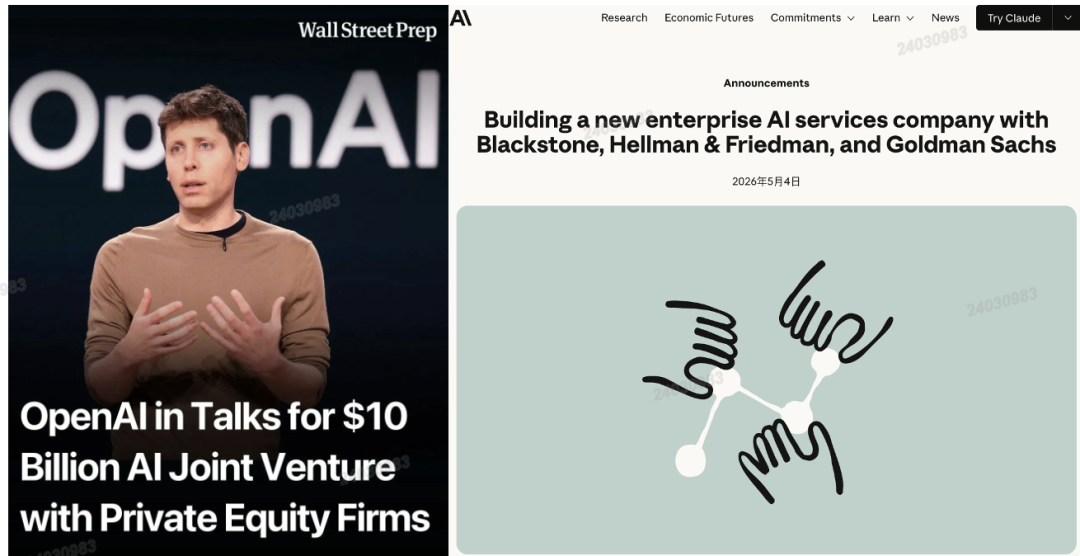
AI行业正从“卖Token”转向“卖组织认知能力”,咨询业浴火重生?
AI行业正从“卖Token”转向“卖组织认知能力”,这不仅是技术的演进,更是咨询业浴火重生的信号。 核心内容: 1. 当前AI部署的瓶颈与Palantir式本体论的局限 2. 大模型作为动态本体与自主智能体的现实挑战 3. 未来趋势:从SaaS到“认知即服务”与新型咨询公司的崛起
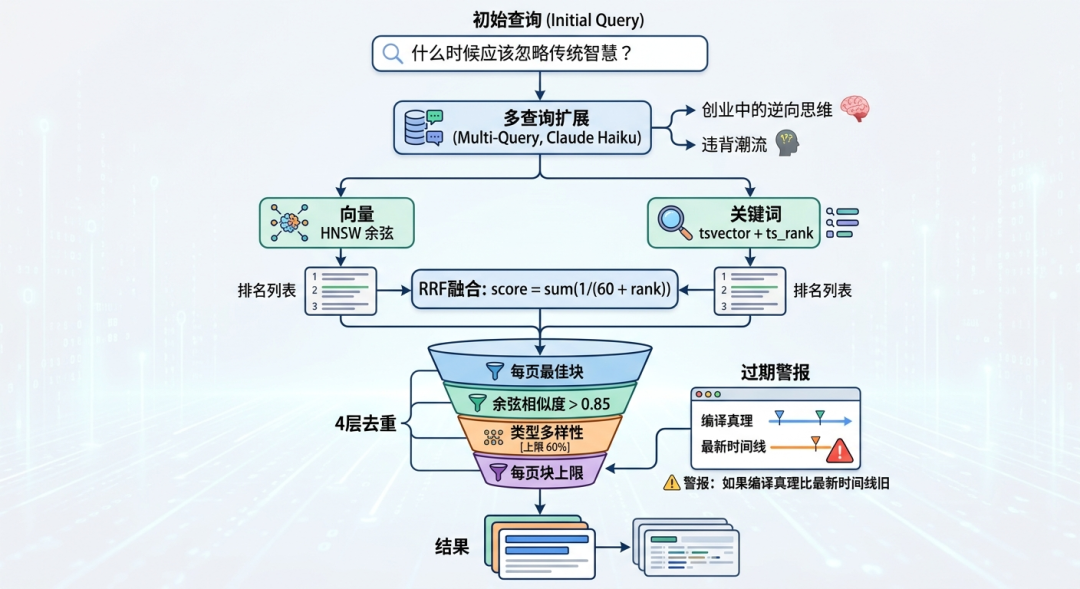
GBrain:让AI Agent拥有完美记忆的知识系统
GBrain:让AI助手拥有完美记忆的革命性系统,Y Combinator总裁Garry Tan的开源项目正在改变AI智能的边界。 核心内容: 1. GBrain如何解决AI助手的记忆瓶颈问题 2. Garry Tan构建数字大脑的具体实践与惊人成果 3. 混合搜索技术如何支撑大规模知识的即时检索
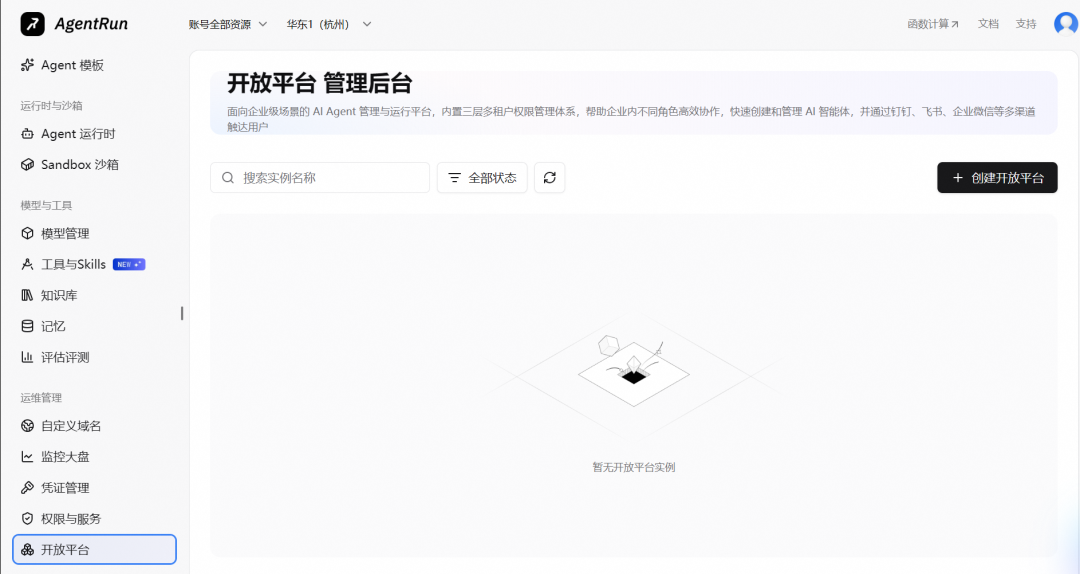
Agent 从“能用”到“管好”,中间差了什么?
从“玩具”到“工具”,Agent规模化落地面临哪些挑战?本文揭示企业AI治理的四大痛点与解决方案。 核心内容: 1. 企业Agent规模化落地的四大核心挑战 2. AgentRun开放平台的三层多租户体系设计 3. 安全、可控、高效的Agent生产与管理环境构建
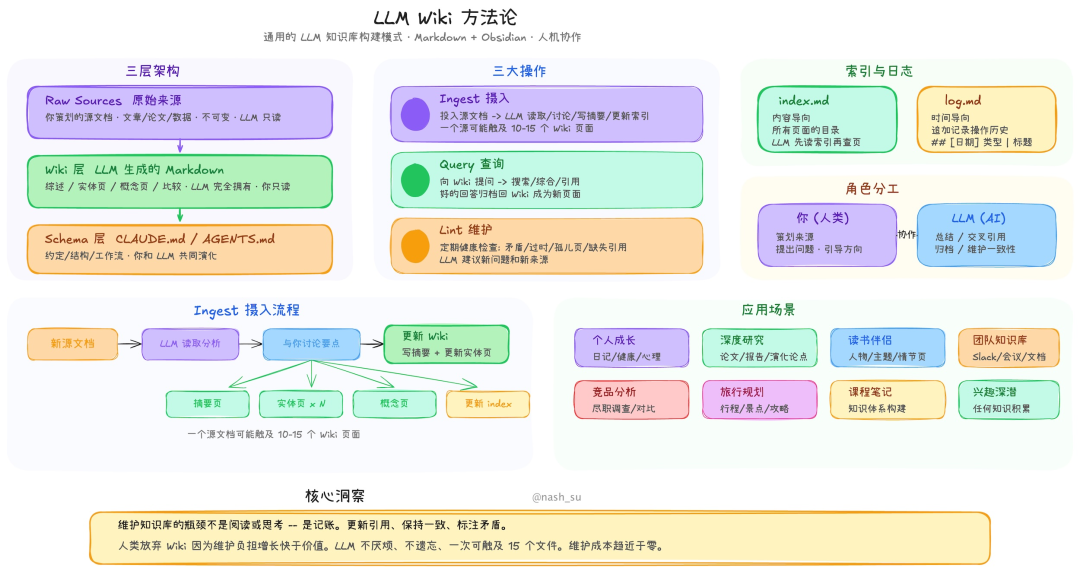
Karpathy 的知识库构想被人做成桌面应用了,而且做得相当扎实,已在 Github 上斩获 5.8k+ Star!
Karpathy的LLM Wiki设计终于有了桌面实现,这个开源项目让AI知识库真正实现积累和进化,告别"更贵的搜索引擎"体验。 核心内容: 1. 传统RAG与LLM Wiki的本质区别:临时生成vs持续编译 2. 关键创新:两步思维链摄取(分析+生成)的工程实现 3. 项目效果:构建结构化Wiki网络,使用越久知识越稠密
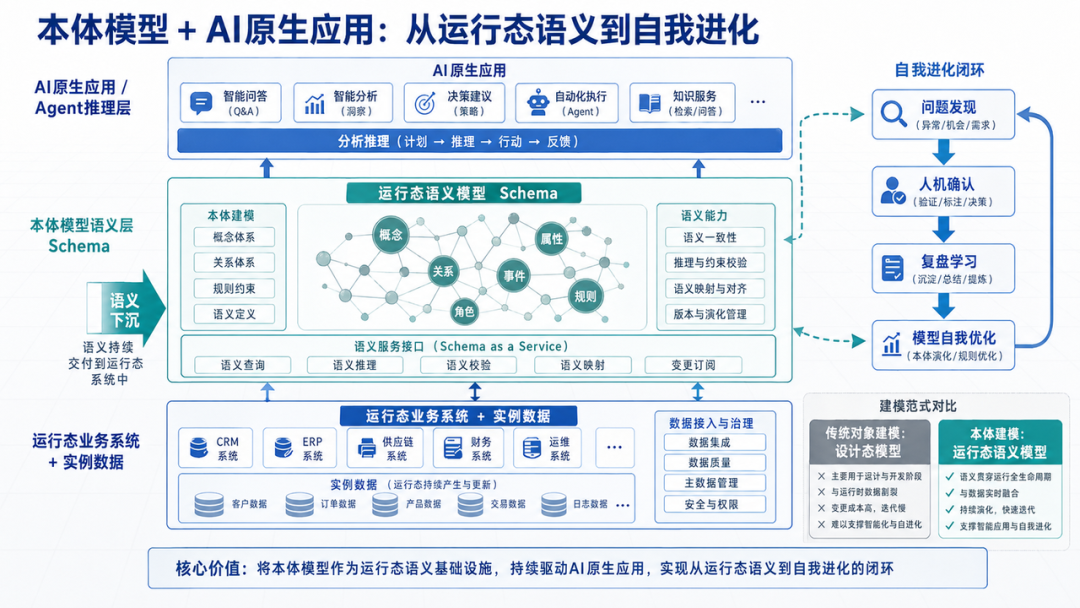
从本体到AI原生,从知识库到Skills技能库
从本体论到AI原生应用,探索知识库与技能库的融合进化之路。 核心内容: 1. 本体论在AI原生应用中的关键作用与适用场景 2. 动态本体的误区与本体模型自我进化的实现路径 3. 知识库与技能库的本质区别及未来发展方向

Harness不是目的,知识才是护城河 —— 一个AI工程交付团队的知识沉淀实践
在AI工程热潮中,我们发现了真正的护城河——不是工作流本身,而是沉淀其中的团队知识。 核心内容: 1. Harness Engineering热潮背后的本质思考 2. 团队知识分层架构的设计与实践 3. 工作流作为知识沉淀载体的创新方法
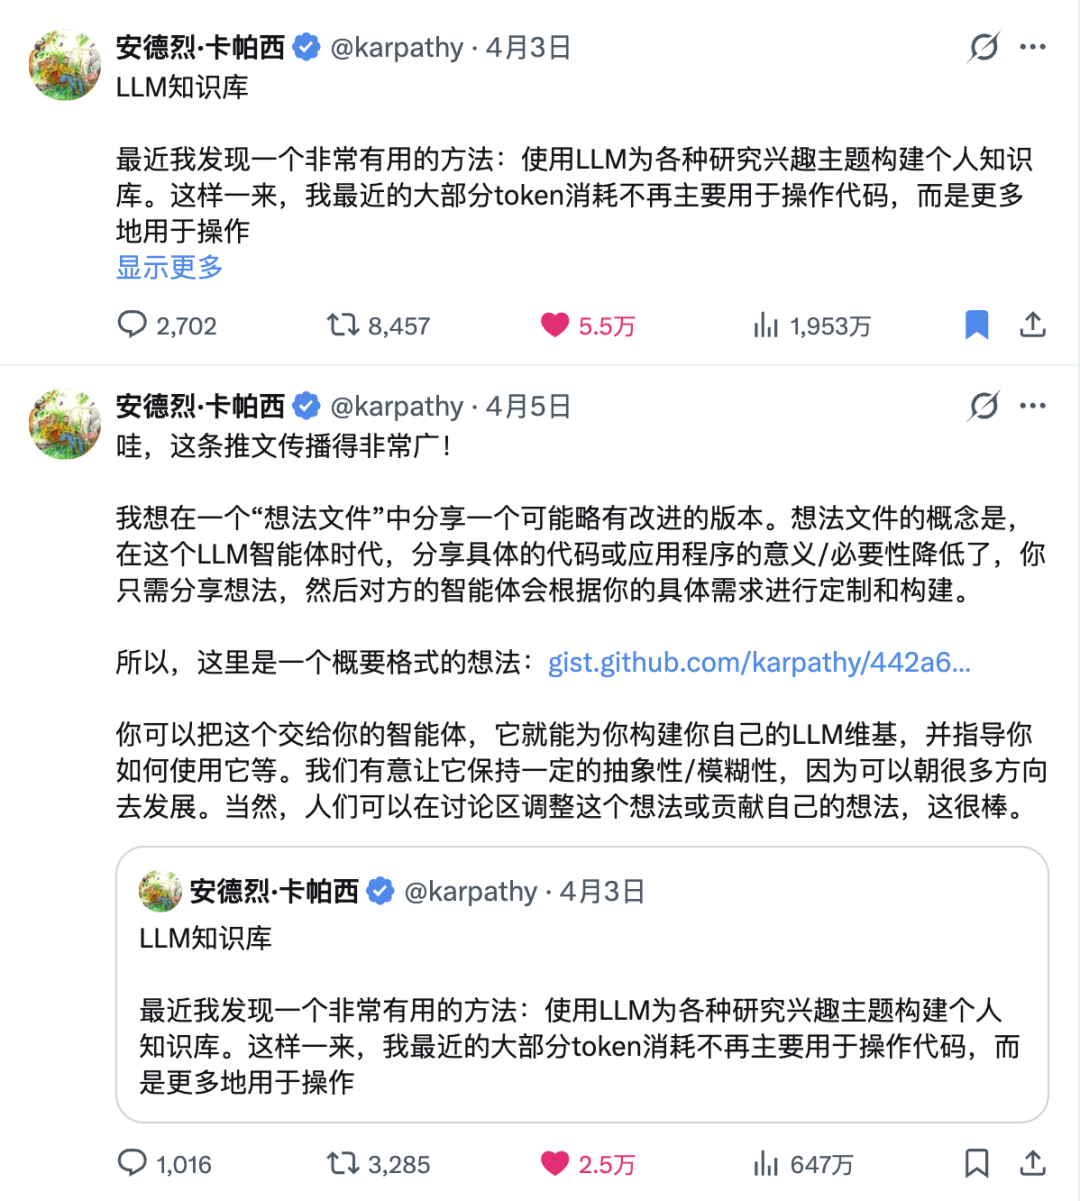
Karpathy的AI知识库方法很好用,但不一定适合你
Karpathy的AI知识库方法在学习研究中堪称神器,但在内容创作和企业场景可能水土不服。 核心内容: 1. Karpathy知识库方法的三层结构解析 2. 学习研究场景下的完美适配性 3. 内容创作和企业场景的局限性分析
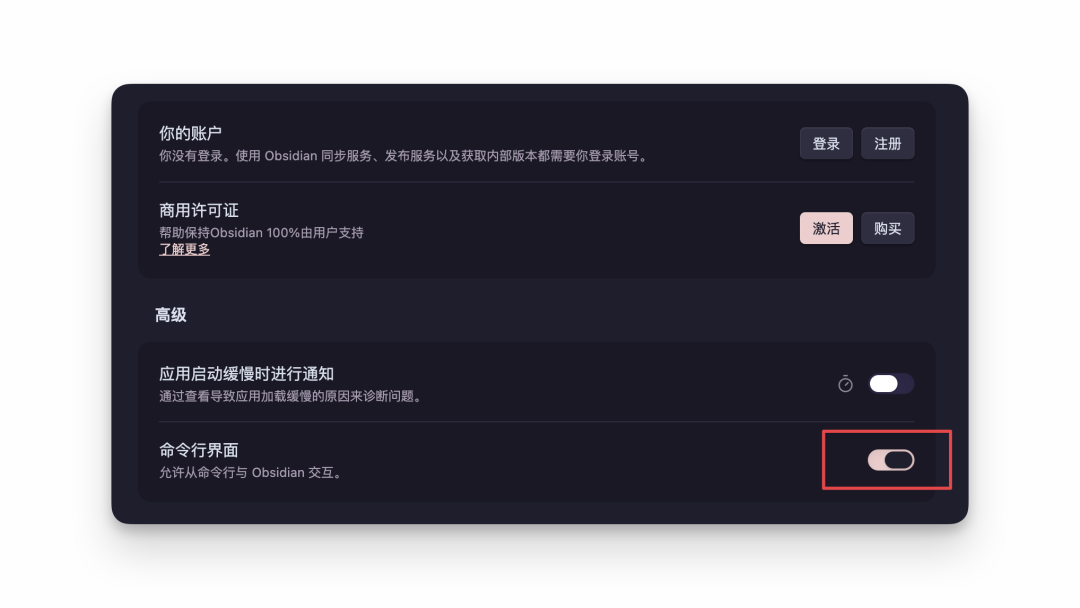
Obsidian Cli 基础使用教程 AI化知识管理全过程
用AI彻底改变你的知识管理方式,Obsidian CLI让AI直接进入你的笔记仓库动手干活! 核心内容: 1. Obsidian CLI如何解决传统AI辅助笔记的局限性 2. AI通过命令行实现的三类核心操作:建结构、整笔记、存指令 3. 从零开始配置Obsidian CLI的完整流程
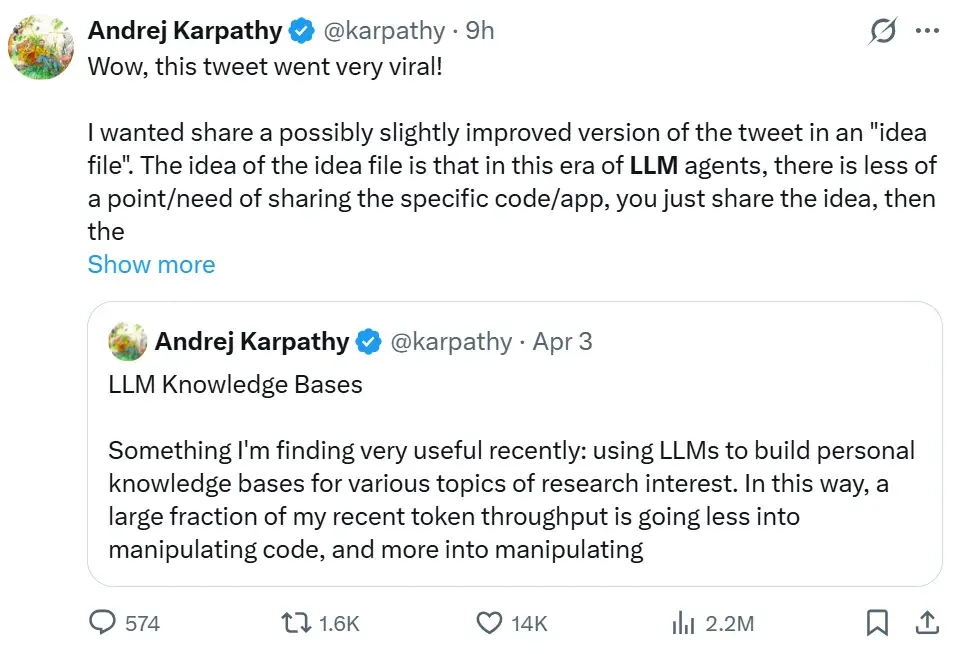
Karpathy用「harness」彻底终结了RAG。
Karpathy提出「llm.wiki」框架,彻底革新知识管理方式,让AI持续编译而非临时检索信息。 核心内容: 1. 传统RAG与llm.wiki知识管理模式的本质差异 2. 知识编译技术在个人wiki、记忆系统等场景的应用潜力 3. 实战演示用复杂真实数据构建三层架构wiki系统
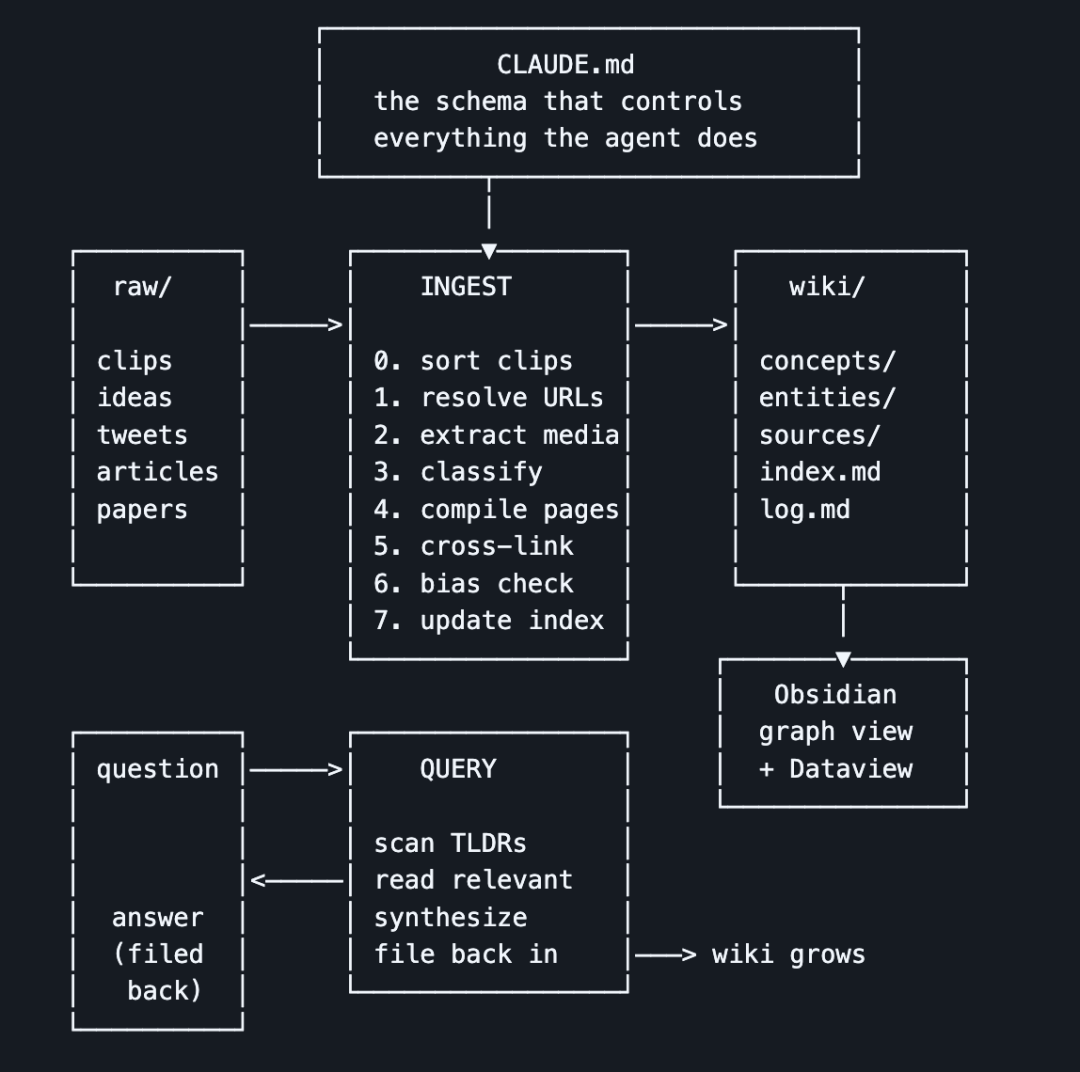
AI 知识层:让每个 Agent 都变聪明的双层系统
让AI真正"懂"你:20分钟搭建专属知识层系统,解决智能体记忆缺失痛点。 核心内容: 1. 知识层系统的双架构设计原理(动态知识库+静态品牌层) 2. 从零搭建的20分钟实操指南 3. 在内容创作、企业运营等场景的应用效果展示
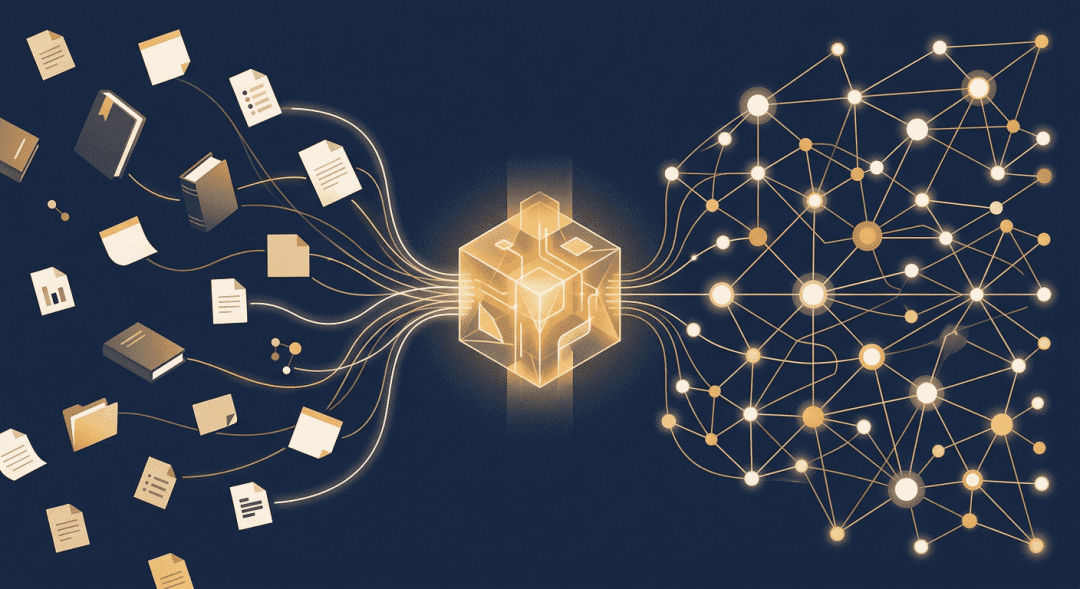
Karpathy的LLM Wiki很美,但普通人真正需要的是一个知识工作台
Karpathy的LLM Wiki理念惊艳,但普通人更需要一个能落地的知识工作台,让AI真正成为认知升级的伙伴。 核心内容: 1. LLM Wiki如何重构知识管理:从静态归档到动态编译 2. 知识系统的三层架构解析(原始资料-Wiki层-Schema层) 3. 普通用户面临的实践困境与解决方案方向
自学习机制下的 API 资产分类实践
货拉拉如何通过自学习机制高效分类海量API资产,实现安全防护前置? 核心内容: 1. 海量API资产面临的分类挑战与安全风险 2. 自学习系统构建中的特征工程优化实践 3. 95%高置信度标签的自动化分类成果展示
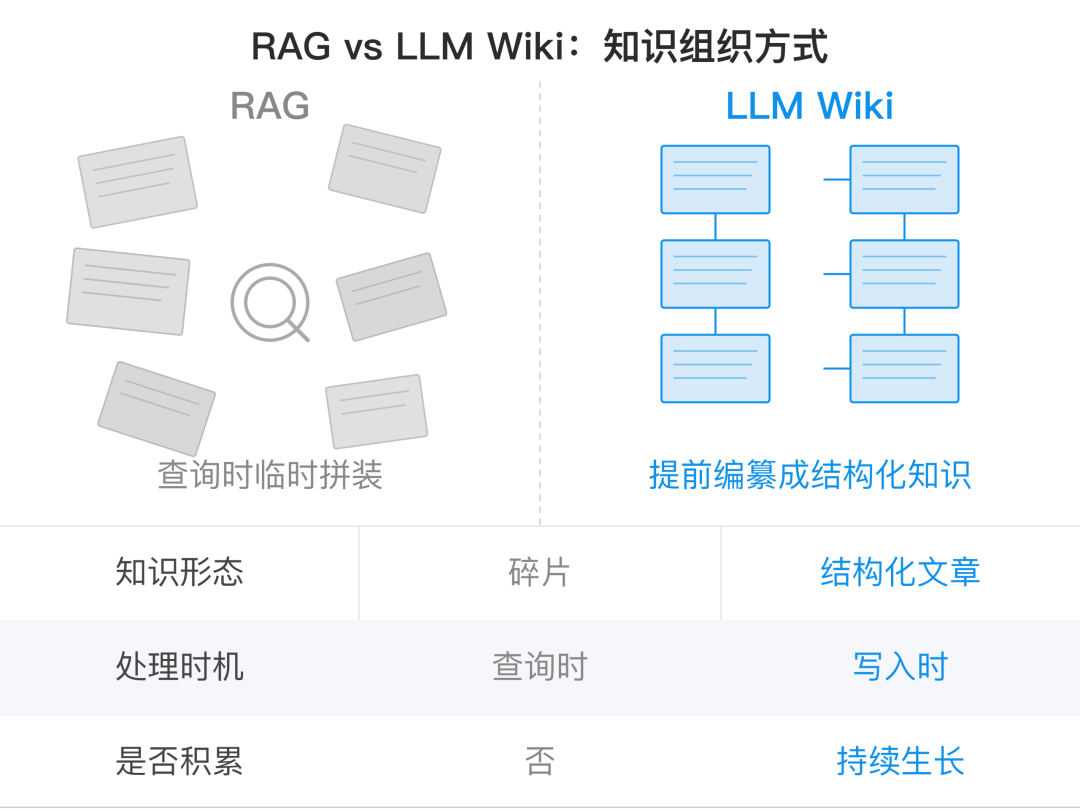
从检索到理解:Karpathy的LLM Wiki为什么比RAG高一个维度
Karpathy的LLM Wiki突破RAG局限,让AI从检索信息升级为构建知识体系。 核心内容: 1. RAG技术的局限性:每次查询都需重新组织信息,缺乏持续积累 2. LLM Wiki的创新:自动生成结构化、可交叉引用的知识库 3. 知识管理新范式:从碎片化检索到系统性理解
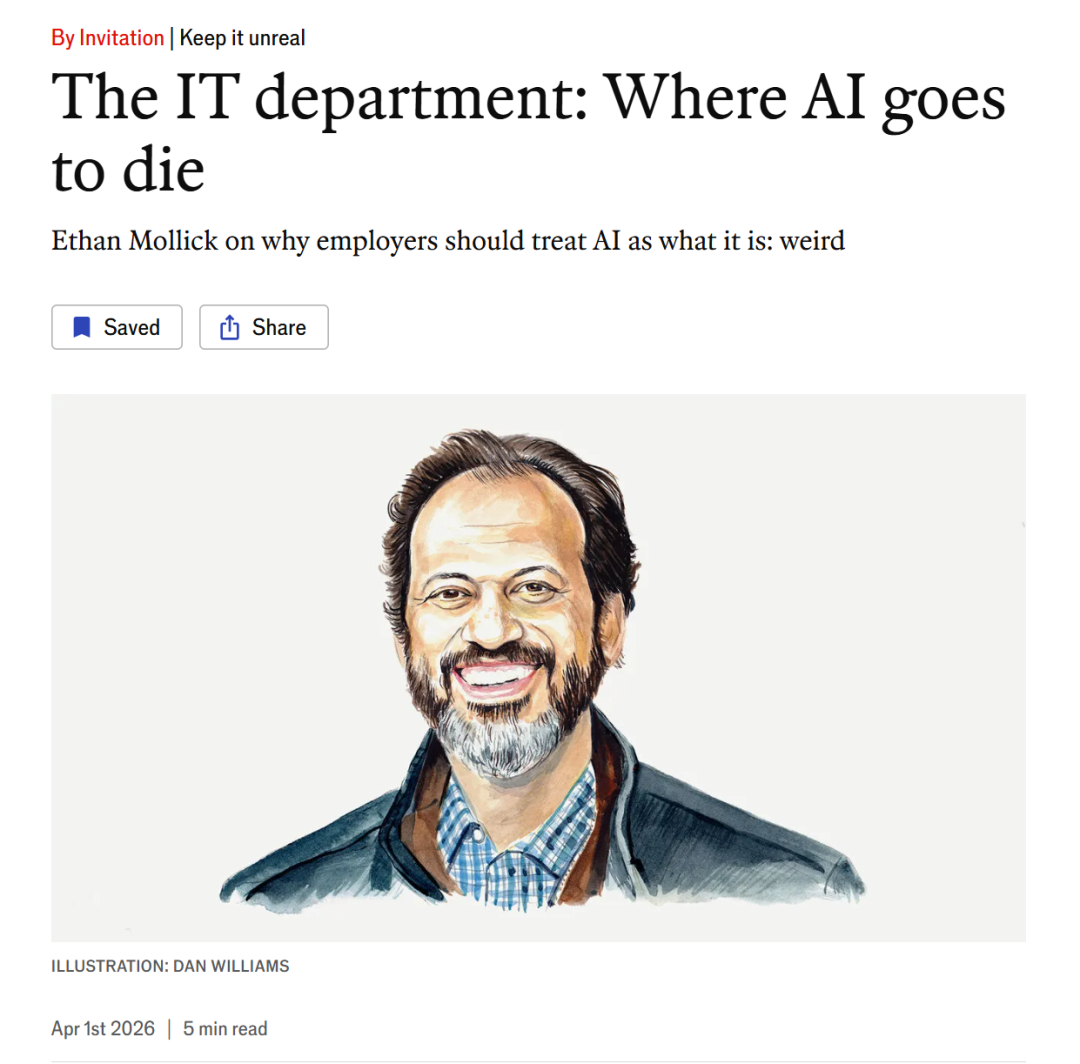
别把AI交给IT部门
沃顿商学院教授警告:将AI交给IT部门管理,可能扼杀其真正的变革潜力。 核心内容: 1. 企业将AI视为普通软件的严重战略失误 2. 驯化AI导致的两大失败:自动化优先与想象力缺失 3. 构建"领导层-员工群体-实验室"的新型AI组织模型
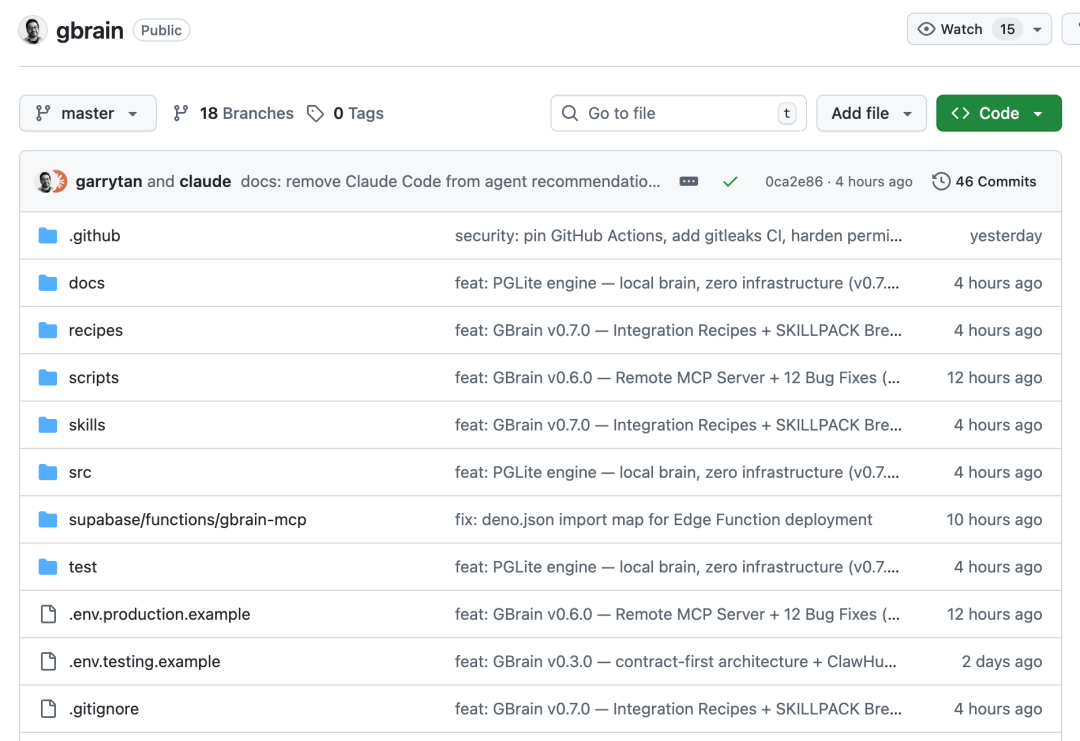
YC总裁开源了他在用的AI记忆系统:10000个文件里找东西,再也不用grep了
Garry Tan开源GBrain:AI记忆系统让万级文件检索告别grep时代,实现精准与语义搜索的完美结合。 核心内容: 1. GBrain解决AI Agent记忆调取难题,支持万级文件高效检索 2. 双引擎架构(关键词+向量搜索)与"编译事实+时间线"设计 3. 智能工作流包含实体检测、三层查询和写入强化三大步骤