相关文章
2384 篇高质量内容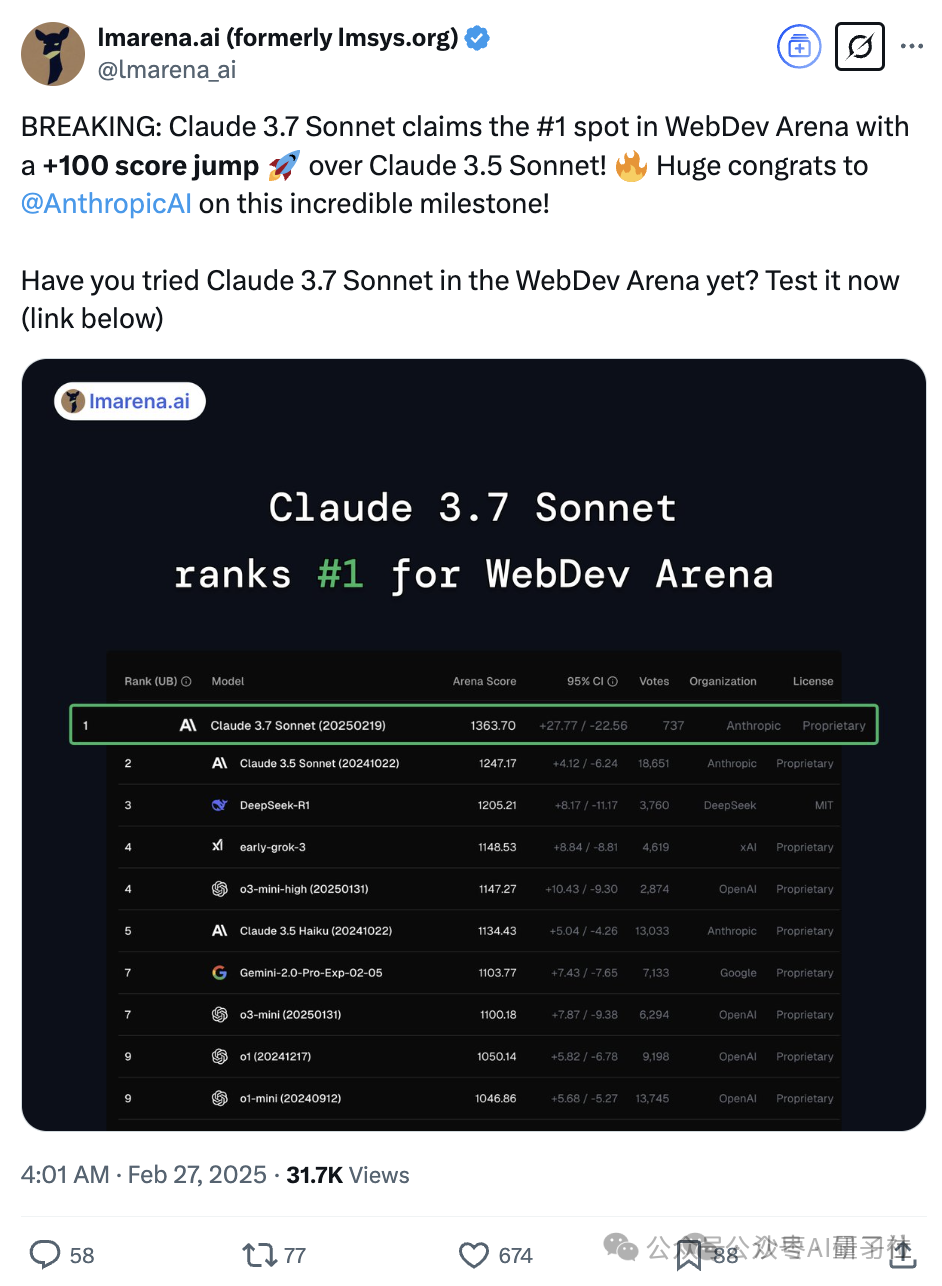
用Claude3.7一句话实现了个知乎...
Claude 3.7 AI编程能力再次刷新你的认知,轻松复刻网站和App。 核心内容: 1. Claude 3.7在AI编程领域超越前代,实力登顶 2. 实战体验:一句话复刻知乎首页,几轮调整复刻flomo App 3. Claude 3.7对提升生产力的巨大潜力,未来创意和需求挖掘是关键
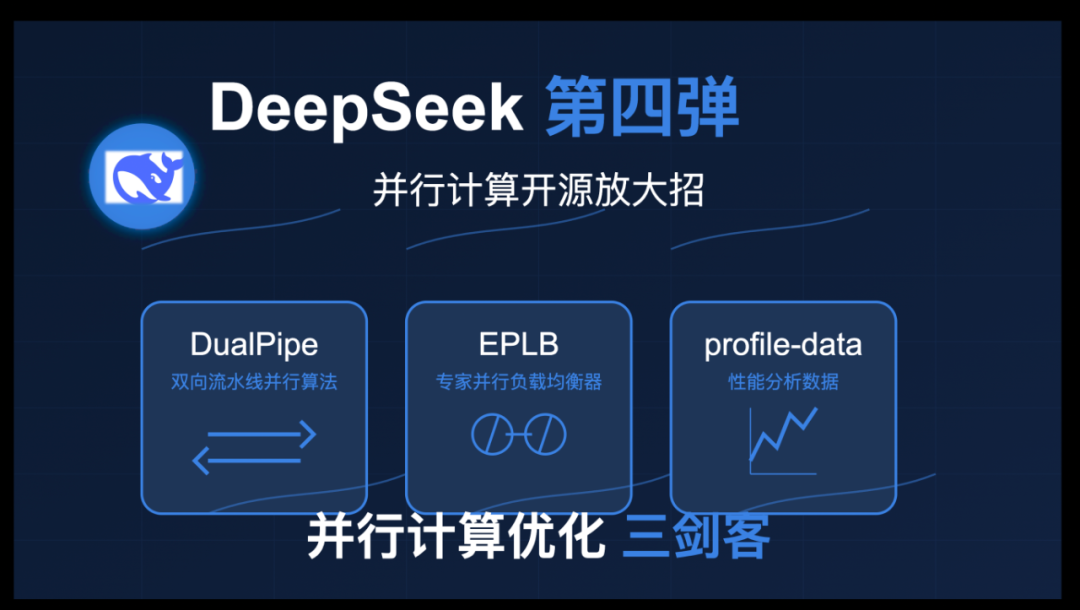
DeepSeek开源第四弹放大招:一口气放出并行计算优化三剑客「训练速度,GPU利用,优化经验」
DeepSeek开源项目第四弹,带来大模型训练效率革命!探索并行计算优化的三大利器。 核心内容: 1. DualPipe:创新双向流水线并行算法,实现计算与通信全重叠,减少流水线气泡 2. EPLB:专家级并行负载均衡器,优化GPU资源分配,实现高效负载均衡 3. profile-data:性能分析数据,深入剖析V3/R1模型的并行计算奥秘
DeepSeek开源打碎了谁的饭碗
DeepSeek开源如何重塑AI行业格局,引发中腰部企业及芯片公司新机遇。 核心内容: 1. DeepSeek开源对中腰部AI公司和本土芯片公司的积极影响 2. 大模型“六小虎”在开源浪潮中面临的挑战与困境 3. DeepSeek“开源周”计划及其对全球AI企业的影响
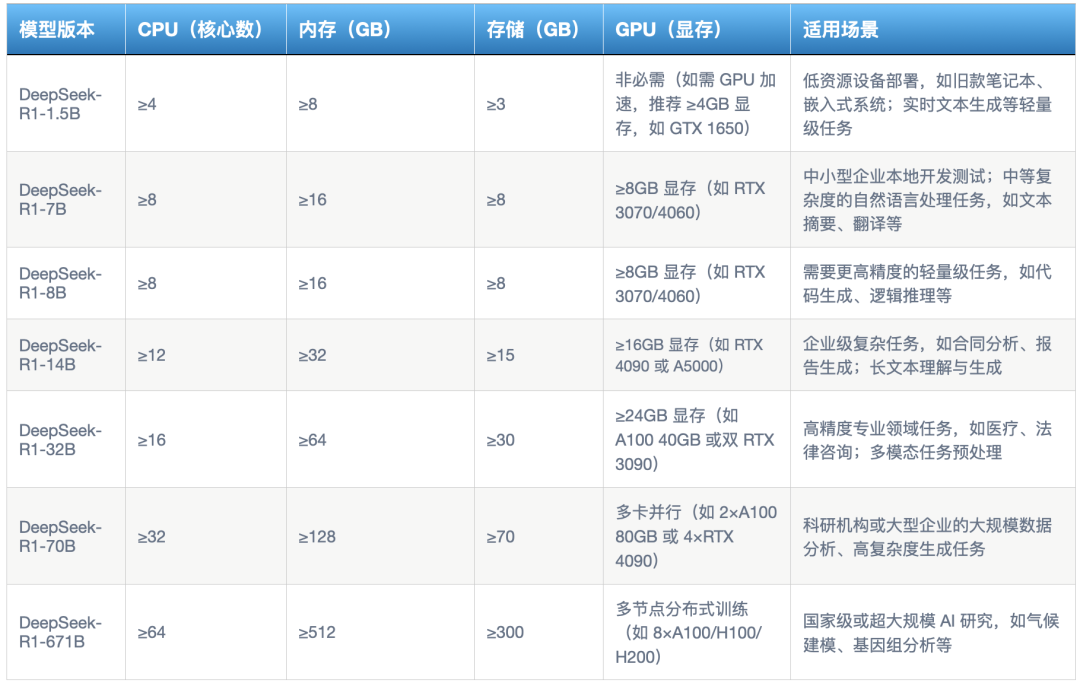
DeepSeek不同版本私有化部署成本对比:企业如何选择最优方案?
深度解析DeepSeek版本迭代及其私有化部署成本,助力企业精准决策。 核心内容: 1. DeepSeek版本迭代与性能成本对比 2. 私有化部署硬件需求与成本差异 3. 高端硬件购置策略与维护考量
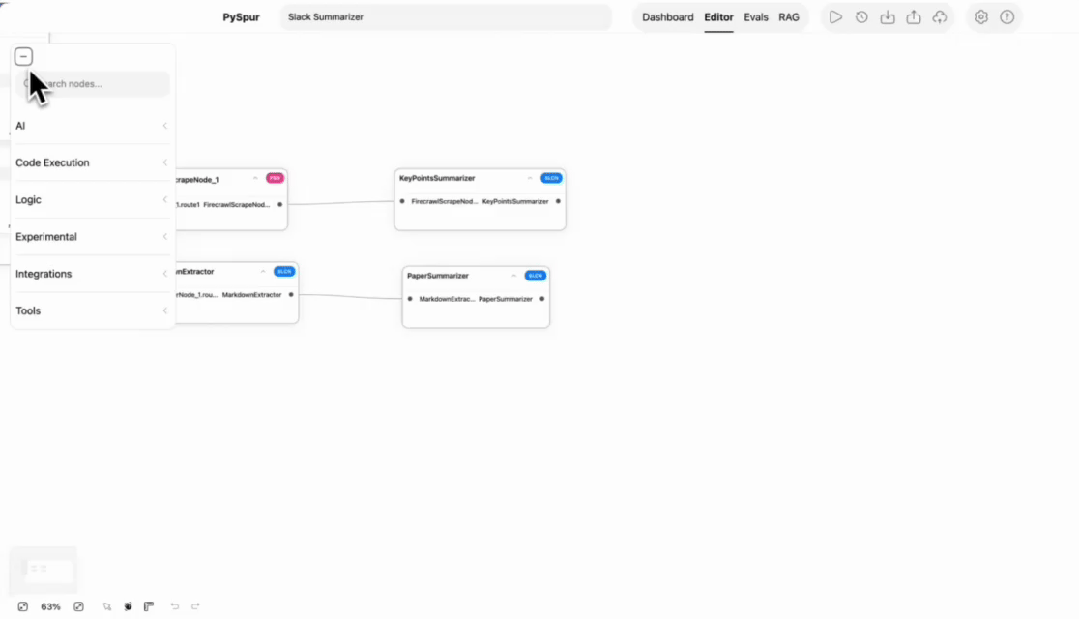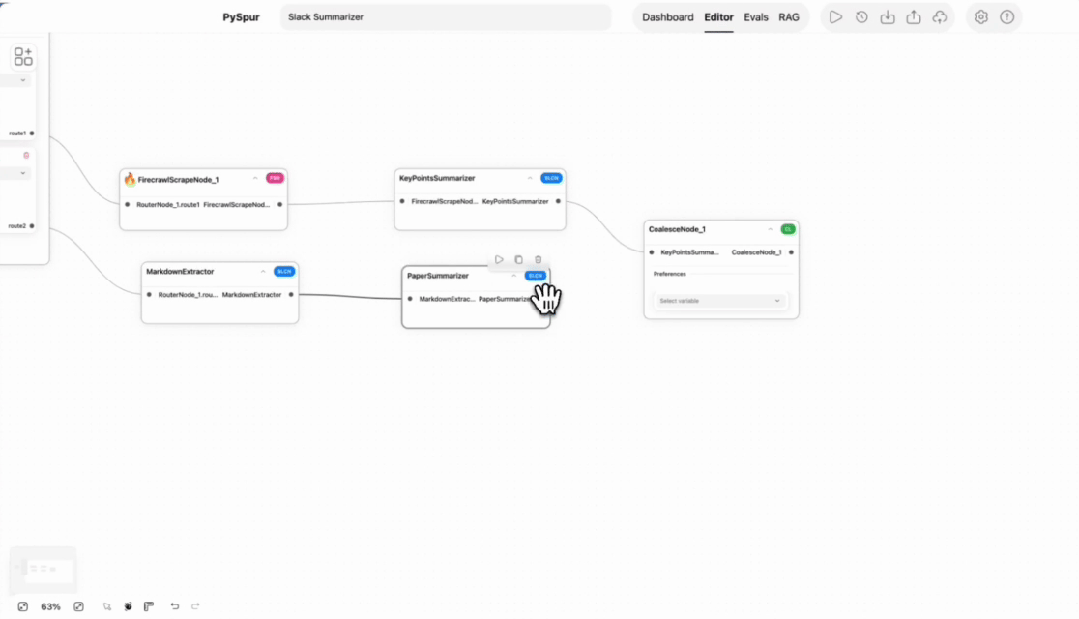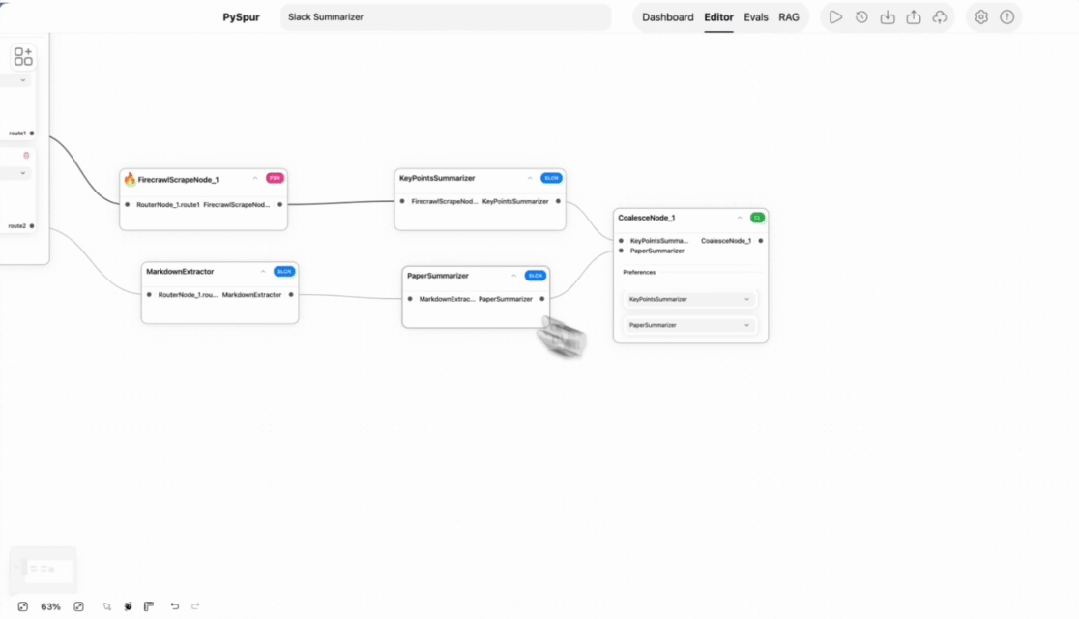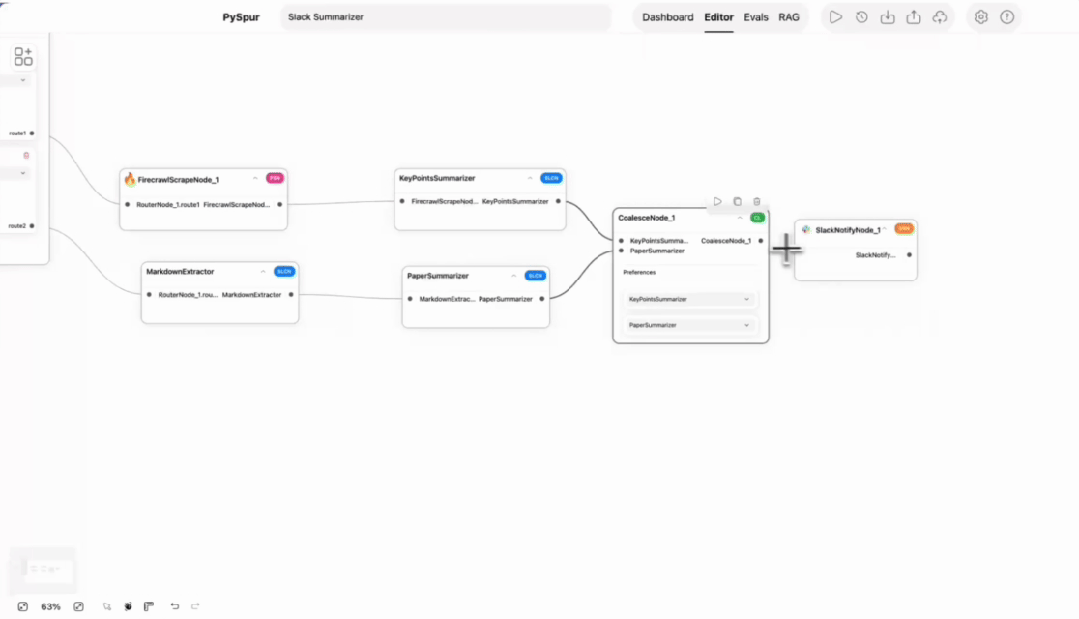
拖拽就能开发 AI 工作流?这个神器让编程小白也能玩转大模型!
无需编程基础,也能轻松搭建AI工作流!PySpur让AI开发变得触手可及。 核心内容: 1. PySpur解决传统AI开发的高门槛问题 2. PySpur的八大核心功能及其应用案例 3. 手把手教你如何安装并快速上手PySpur
刚刚,阿里开源最强视频大模型!性能干翻Sora,8G显卡就能跑
阿里云开源视频大模型万相2.1,性能超越Sora,8G显卡即可运行。 核心内容: 1. 万相2.1双版本模型参数规模及适用场景 2. 万相2.1在基准测试中的性能优势 3. 万相2.1的多项功能支持和应用演示
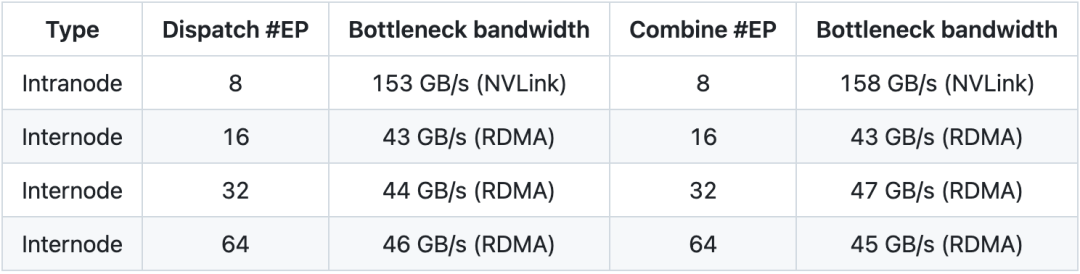
DeepSeek开源DeepEP: 高效的专家并行通信库
专为混合专家模型设计的通信库DeepEP,优化数据传输,提升分布式训练效率。 核心内容: 1. 支持全交换GPU核心,实现高吞吐低延迟通信 2. 动态资源调控,根据任务需求调整SM数量 3. 支持低精度运算,加速大规模分布式训练
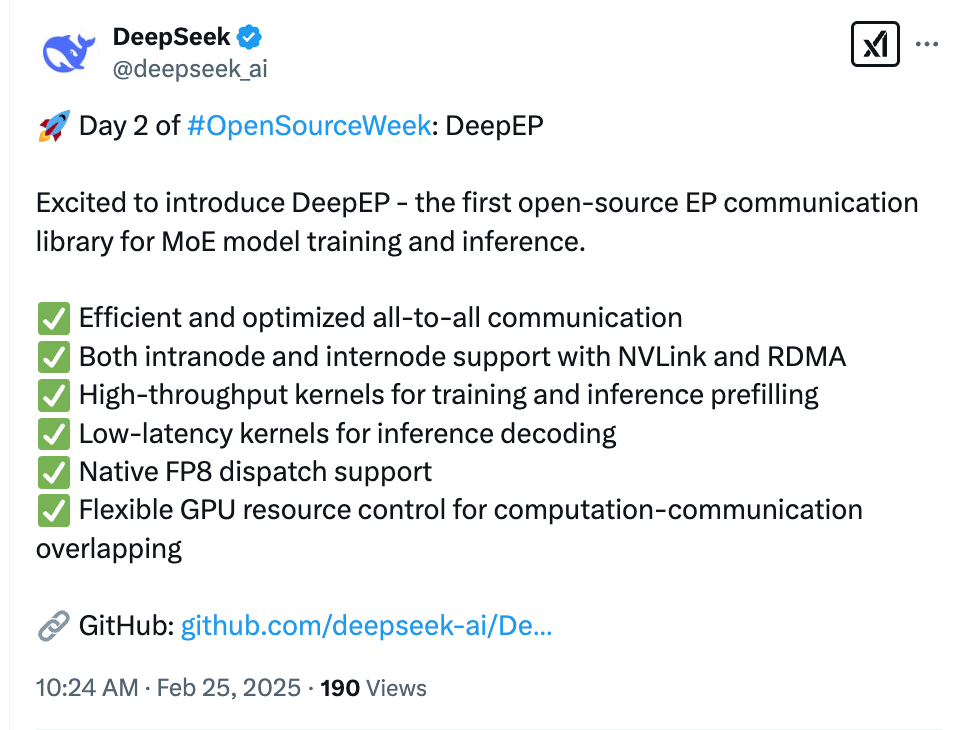
刚刚,DeepSeek开源MoE训练、推理EP通信库DeepEP,真太Open了!
DeepSeek开源MoE通信库DeepEP,高效并行处理的革命性突破! 核心内容: 1. DeepEP:首个MoE模型训练和推理的EP通信库 2. 高效All-to-All通信、支持NVLink/RDMA、原生FP8数据分发 3. 优化计算核心、灵活资源调度,实现计算通信高效重叠
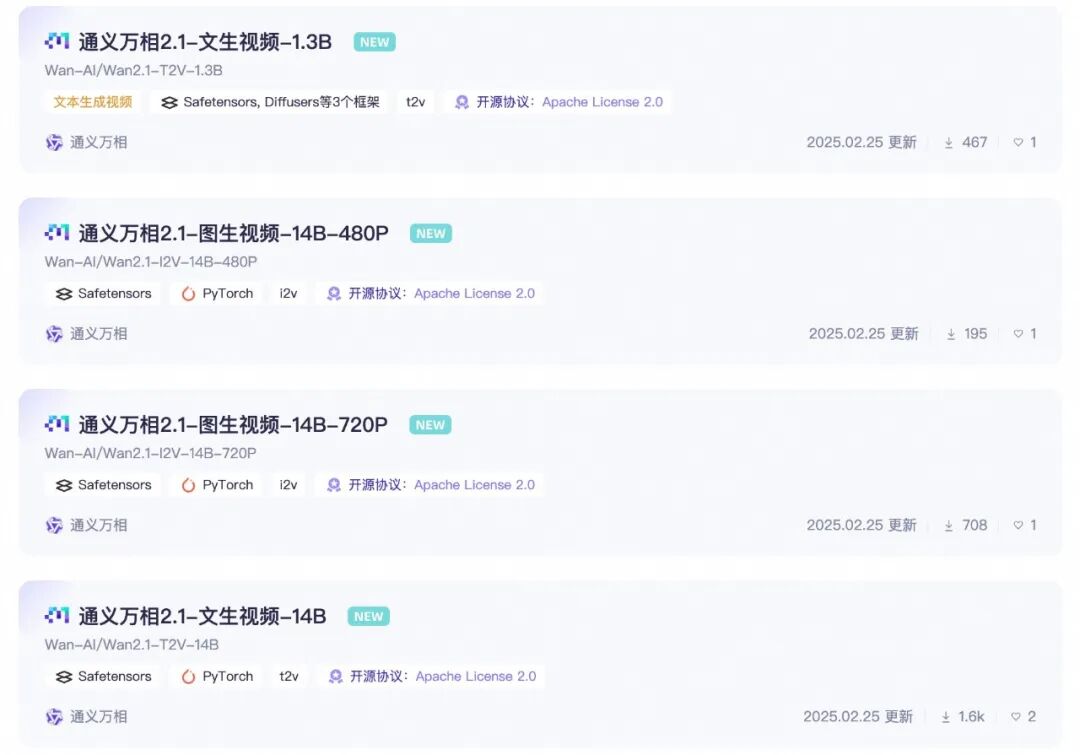
万相,开源!
阿里云视频生成大模型万相2.1(Wan)全面开源,性能领先全球,开启AI视频新纪元。 核心内容: 1. 阿里云万相2.1模型全面开源,包含14B和1.3B参数版本 2. 万相2.1模型在多个基准测试中大幅领先现有模型 3. 万相大模型的关键技术创新解读,包括自研3D VAE架构等
字节跳动整活了!正式发布 BFS-Prover,并全程开源!
字节跳动豆包团队震撼发布BFS-Prover,开启AI数学证明新纪元。开源精神助力全球开发者共同进步。 核心内容: 1. BFS-Prover:数学证明领域的革命性突破 2. 三大核心技术,优化证明路径,提升推理效率 3. 权威测试成绩亮眼,AI数学推理能力达到新高度
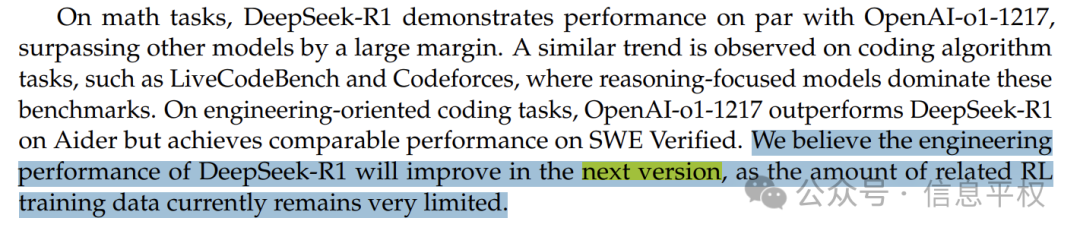
如何预期DeepSeek R2
深入解读DeepSeek R2的预期发布及其技术前景。 核心内容: 1. DeepSeek R2的预期发布时间与研究员Daya的预测 2. R2相对于R1在RL训练数据和模型表现上的提升 3. DeepSeek的开源策略与未来技术路线图的比较分析
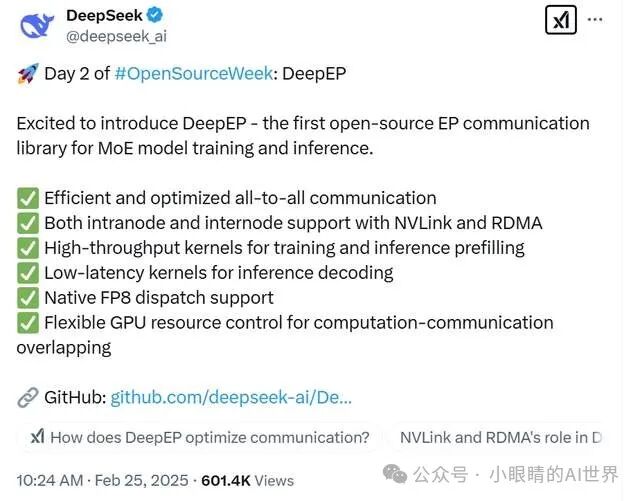
DeepSeek首次开源五大核心代码,第二篇:DeepEP解析
DeepSeek开源五大核心代码,第二篇DeepEP解析,AI大模型的新突破。 核心内容: 1. DeepEP的基本概念和在MoE模型中的应用 2. DeepEP的技术亮点:高吞吐量与低延迟的GPU内核 3. DeepEP如何优化通信路径,提升AI系统性能
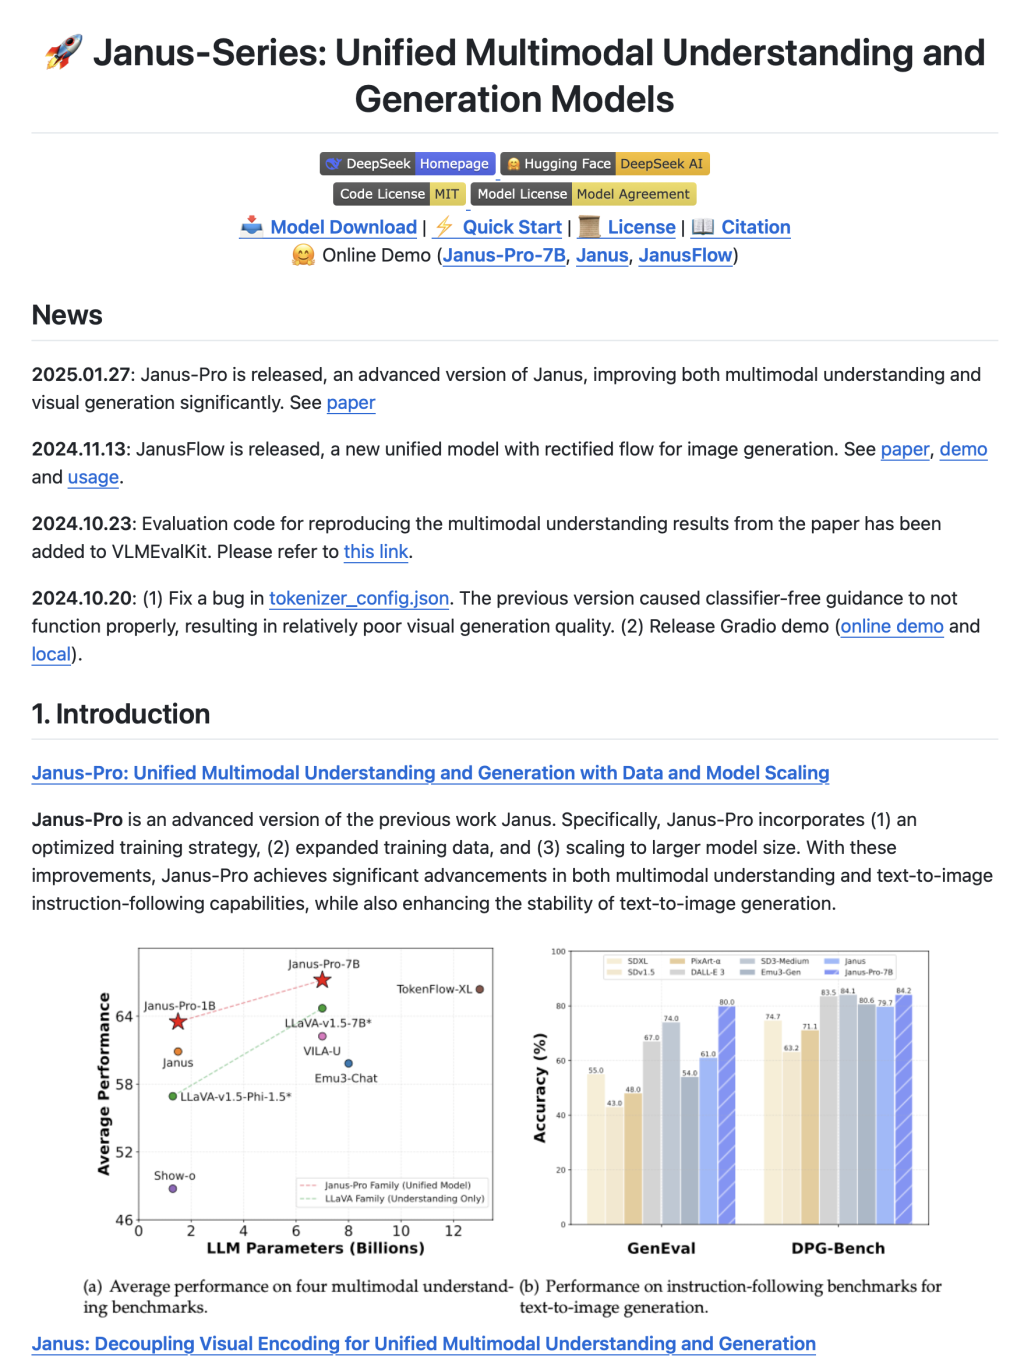
DeepSeek 第二弹:Janus-Pro 文生图模型
探索DeepSeek的最新突破,Janus-Pro如何引领AI文生图的未来。 核心内容: 1. DeepSeek Janus-Pro的升级亮点与性能提升 2. 7B和1.5B参数规模的开源模型,低门槛本地运行的潜力 3. 双路径视觉编码架构与多模态理解能力的提升
SpeechGPT 2.0:复旦大学开源端到端 AI 实时语音交互模型,实现 200ms 以内延迟的实时交互
复旦大学最新研发的实时语音交互模型,具备情感控制和低延迟响应,引领AI语音交互新趋势。 核心内容: 1. SpeechGPT 2.0模型的拟人化表达和百毫秒级低延迟响应 2. 模型支持多情感控制、实时打断交互和文本能力集成 3. 超低比特率流式语音Codec和语义-声学联合建模的技术原理
手把手教你在本地部署DeepSeek R1,并集成到Dify中,建议收藏
掌握DeepSeek R1本地部署与集成技巧,提升工作效率。 核心内容: 1. 本地部署DeepSeek R1的详细步骤 2. 通过ollama集成DeepSeek R1到Dify中 3. 提升工作效率的实践指南
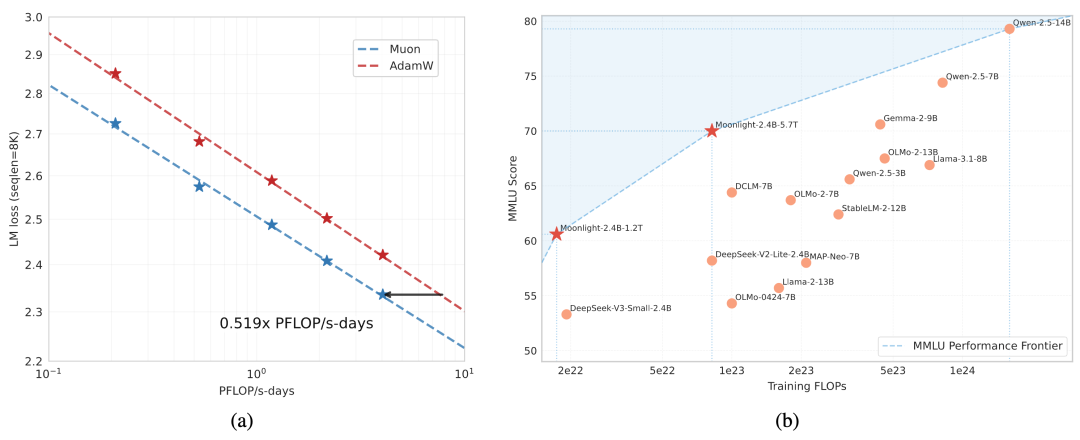
Kimi开源Moonlight-16B-A3B:基于Muon优化器的高效大模型,性能与训练效率双突破!
Kimi开源Moonlight-16B-A3B,基于Muon优化器的大模型性能与训练效率突破性进展。 核心内容: 1. Muon优化器在大规模模型上的应用与扩展关键技术 2. Moonlight-16B-A3B系列模型的参数规模与训练数据 3. Kimi开源资源与技术贡献,推动未来研究与应用
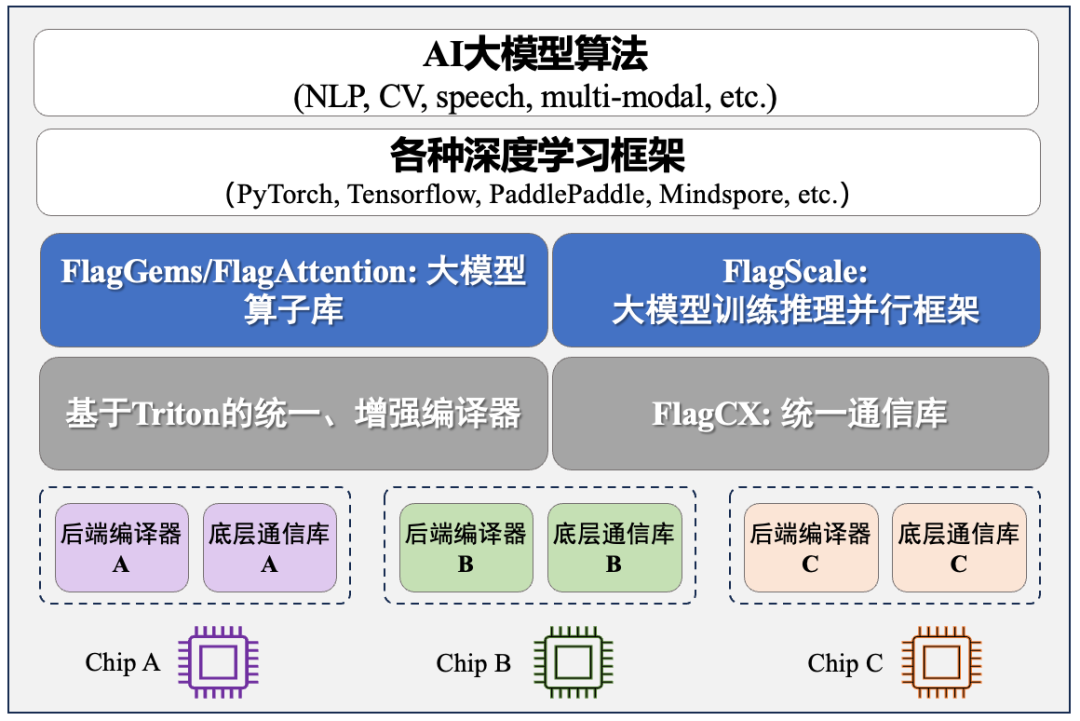
智源开源FlagOS升级:首次实现DeepSeek-R1满血版多种芯片高效快速部署
智源开源FlagOS升级,实现DeepSeek-R1多芯片高效部署,打破生态墙,推动AI大模型发展。 核心内容: 1. DeepSeek-R1多芯片版本基于FlagOS开源,实现不同AI芯片架构的推理 2. 严格评测保证不同芯片上的DeepSeek-R1版本与英伟达版本效果对齐 3. 源代码、模型文件、Docker镜像等全面开源,降低使用门槛,提升部署效率
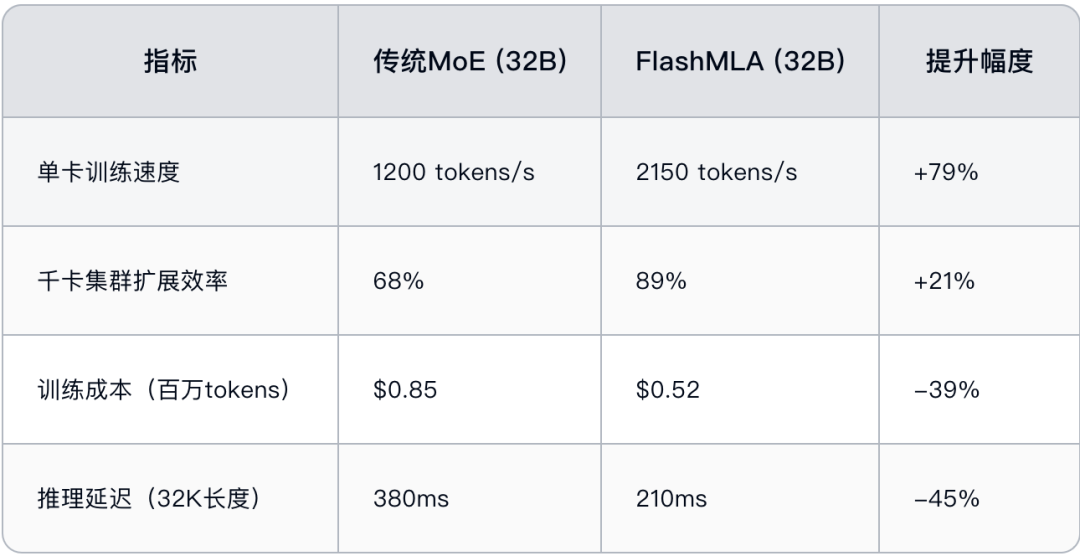
DeepSeek开源FlashMLA,突破GPU性能极限
DeepSeek开源FlashMLA,GPU性能革命性提升。 核心内容: 1. DeepSeek开源FlashMLA,专为英伟达Hopper GPU深度优化 2. 核心技术MLA架构,显著提升长上下文推理效率 3. 实测性能突破,内存带宽和计算性能均接近硬件极限
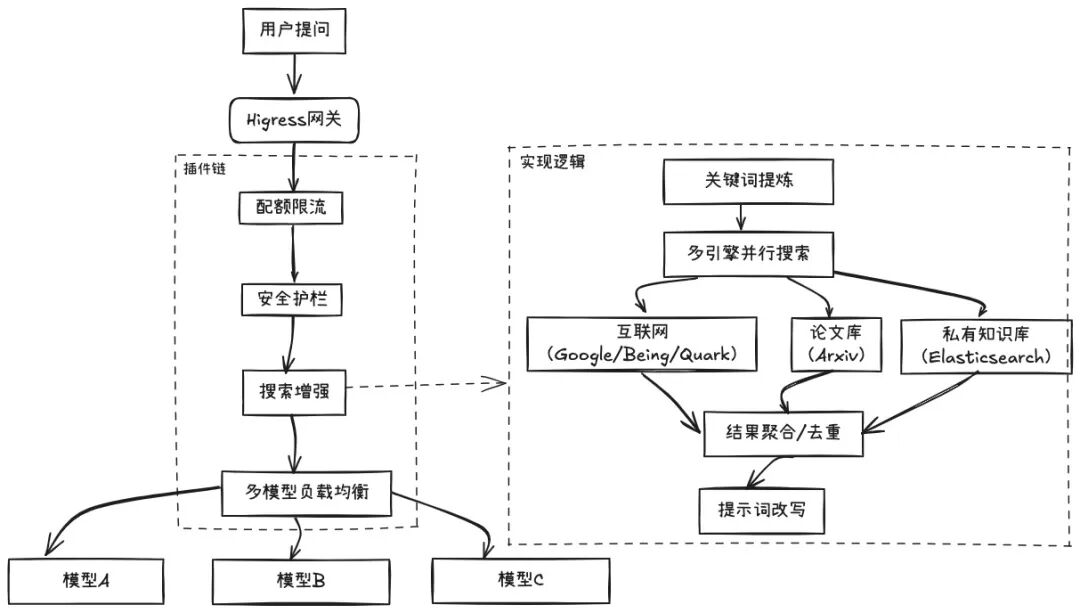
自建 DeepSeek 时代已来,联网搜索如何高效实现
自建DeepSeek时代,低成本实现企业级智能问答系统。 核心内容: 1. DeepSeek技术革新,企业自建智能问答系统成本大幅降低 2. Higress云原生API网关,零代码增强LLM的多功能瑞士军刀 3. 联网搜索技术实现与场景价值,多引擎智能分流与核心思路解析
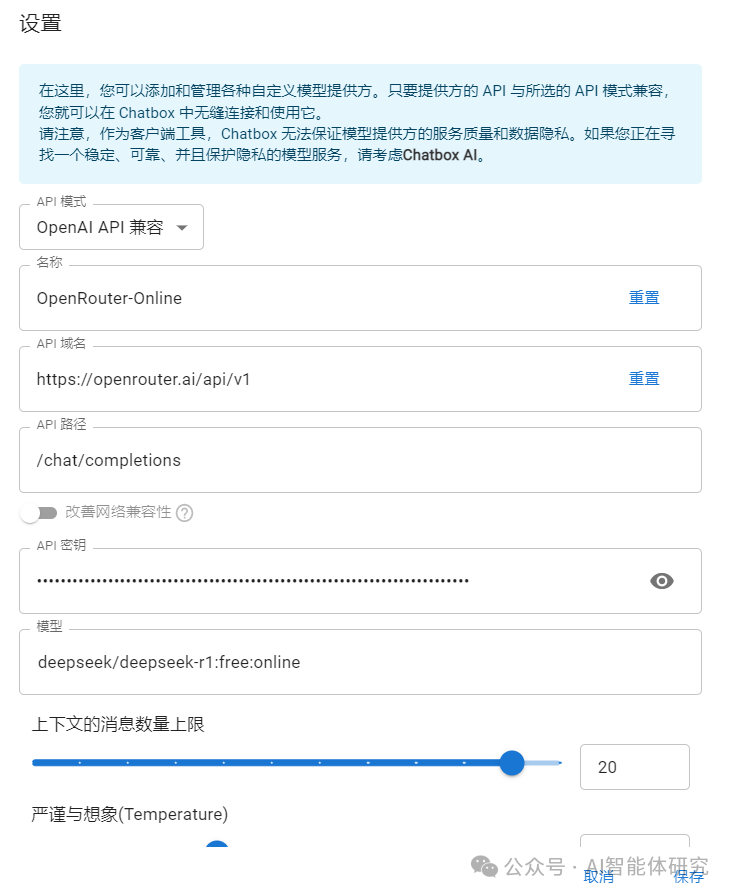
ChatBox社区版联网搜索教程:OpenRouter配置指南
探索ChatBox社区版如何突破联网搜索限制,实现实时信息获取! 核心内容: 1. ChatBox社区版联网搜索功能的重要性与局限性 2. 四种主流AI聊天助手联网方案的对比分析 3. 使用OpenRouter为ChatBox添加联网搜索功能的详细配置教程