别再迷信 LLM WIKI:大模型根本撑不起知识库的持续进化
文章指出当前主流LLM WIKI方案无法支撑知识库持续进化,因其无记忆、无状态特性难以处理上千份文件的跨版本查重与内容演化。实测显示,传统算法(Hash、文本指纹、特征识别)在本地完成全量扫描,10分钟识别1454个文件中的81组重复,准确区分完全相同、高度相似及疑似新旧版本,并将判断权交还用户。
LLM WIKI 的根本性局限
在这个时代,要是还没有构建自己的AI知识库,你就out了!市面上的知识库产品五花八门,能导入、能搜索、能问答、能总结。可到现在,从来没有一个能真正解决【知识查重】的问题!
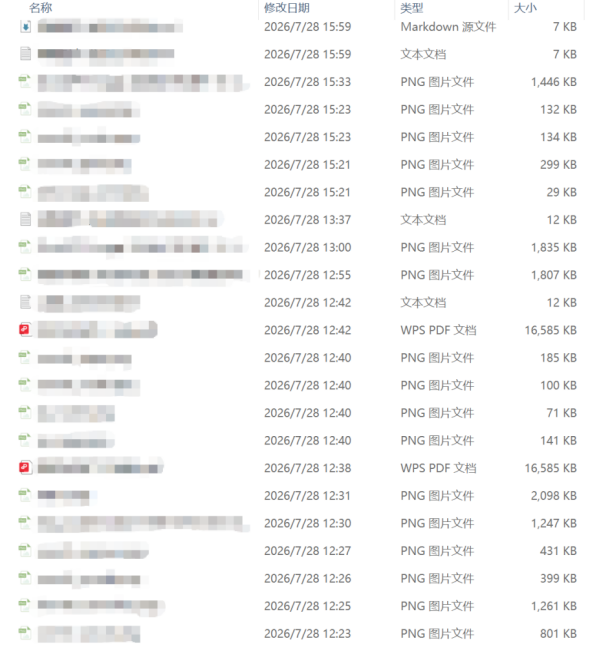
同一份资料被复制到不同目录,改个文件名又存一份;旧版本、新版本、最终版、最终版2混在一起;内容明明一样,只是 Word 转成了 PDF。文件少的时候还能手动整理,一旦积累到几百、几千份,知识库就不再是“知识”,而是一堆真假难辨、互相冲突的历史版本。
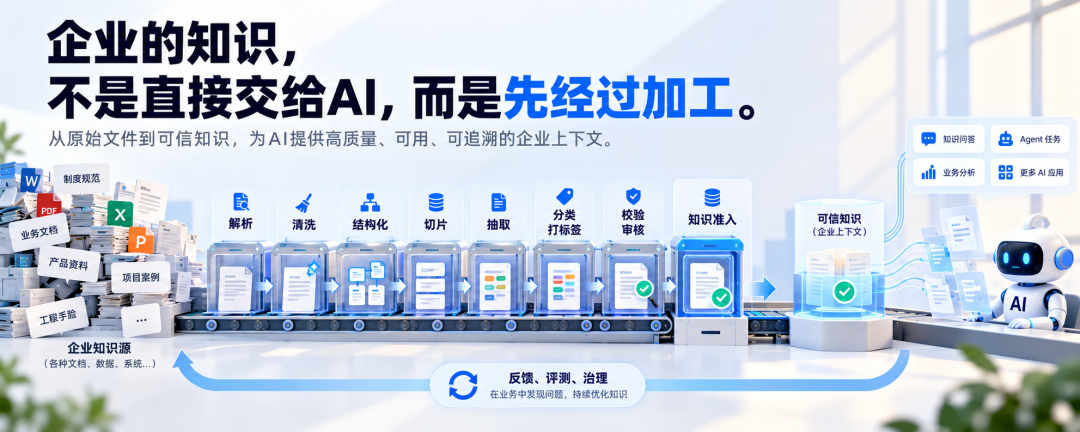
自媒体们天天吹捧的LLM WIKI,我也不知道究竟有几个人真正尝试过!理论上是美好的:让大模型自动阅读资料、提炼内容、识别冲突,再把旧知识升级成新知识。可是以当下的大模型实际技术水平,根本支持不了这个知识库内容的持续精选、提炼、升级进化(当然,你要是文件只有一点点、几十个文件另说!)
为什么大模型支持不了?因为现今的大模型是无记忆、无状态的,而知识提炼、知识进化,是需要记忆、需要持续的。不是说 LLM 完全不能比较两份文件,而是它每次只能对当前上下文负责,天然不知道上一次看过什么、哪个文件刚刚改过、哪些内容已经被确认保留,面向上千份文件大模型根本无能为力!
技术特性就注定大模型根本做不了知识库的持续进化。
一次失败的LLM查重尝试
Knowly 之前上架过一个官方的Skill,让 LLM 根据文件标题、路径、修改时间等信息,判断重复版本和过时文件。诊断结果交给用户决策以后,可以选择删除文件,或者操作文件加特殊标记,从而从知识库体系里移除。
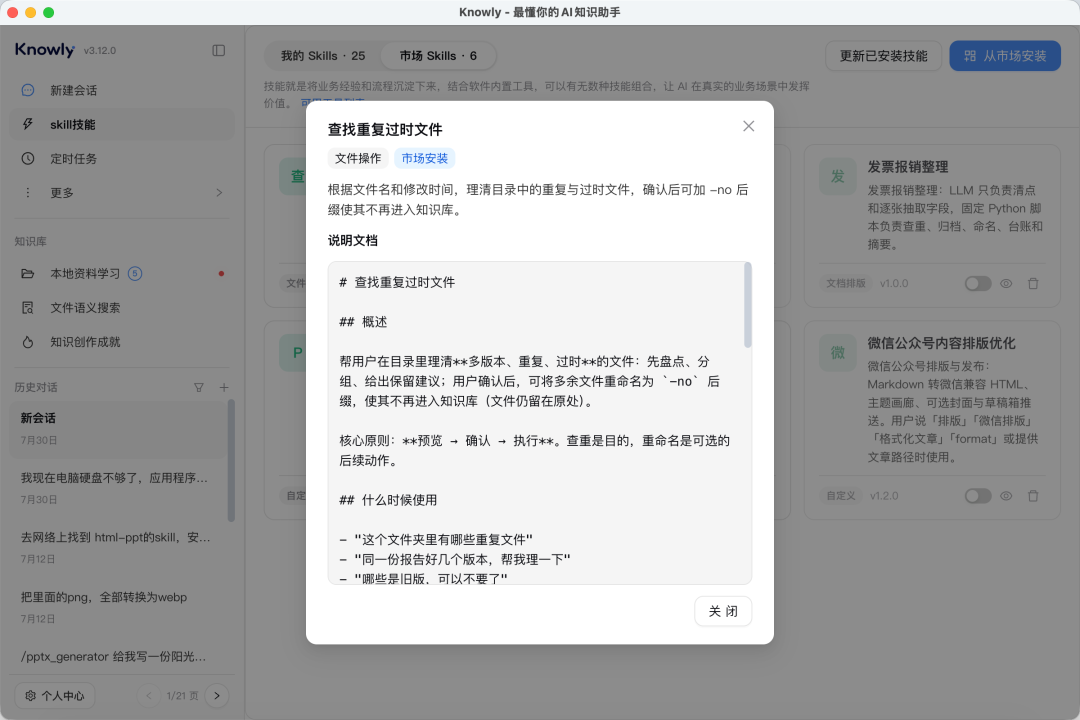
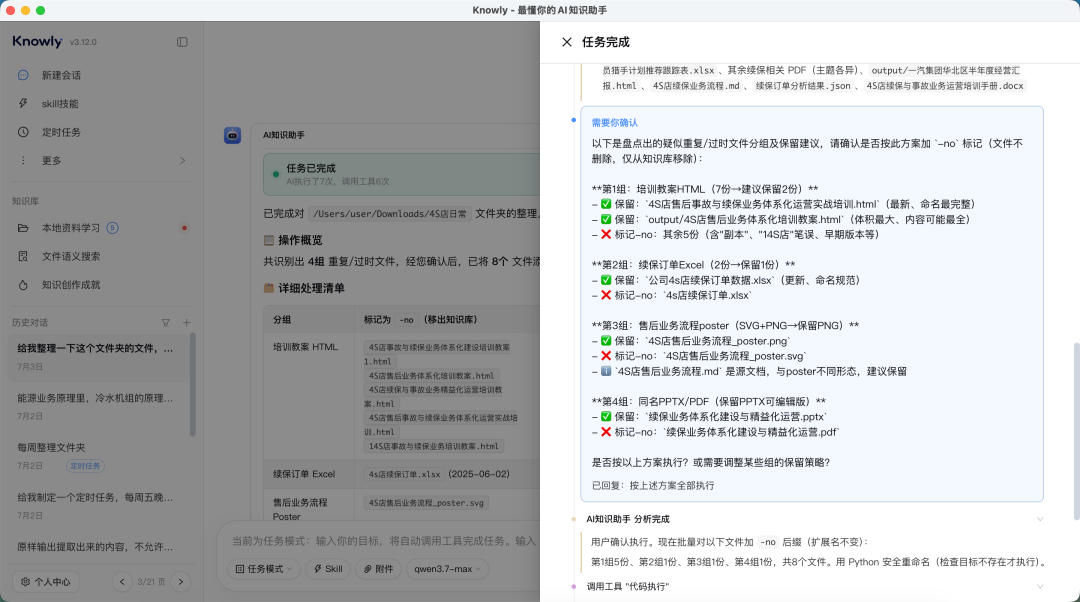
上线以后收到了不少用户的好评,但也有用户提出,这个并不是他心目中理想的查重功能,文件内容不能识别的话终究只是个半成品。这个skill毕竟只是一种折中和妥协的方案:没有对文件正文进行稳定、完整的比对,就很难判断两个名字完全不同的文件,内容是不是其实一样;也无法准确识别一份资料只是换了格式,还是确实增加了新内容。
回归传统算法的工程实践
从来都没有万能的技术方案,只有最适合的技术方案。真正实践过以后,我们放弃了完全基于LLM来做知识判断和持续进化,回归到了传统的算法来计算。
这不是技术倒退,而是终于为场景找到了适合的技术。
- 完全相同的文件,通过 Hash 精确识别
- 正文相同但文件名、格式不同的资料,通过内容特征识别
- 存在少量修改的文件,通过文本指纹计算相似度
- 再结合文件名的特征,判断它们是不是疑似新旧版本
整个过程在本地完成,不需要把几千份文件反复交给大模型阅读(当然交给大模型它也做不了),而且识别速度极快,一分钟就可以读上百份文件。并且识别结果通过数据库存起来,未来查重时可以再次快速使用。
1454个文件的实测效果
我找了一个本地的文件夹,里面有1454个各种类型的文件。
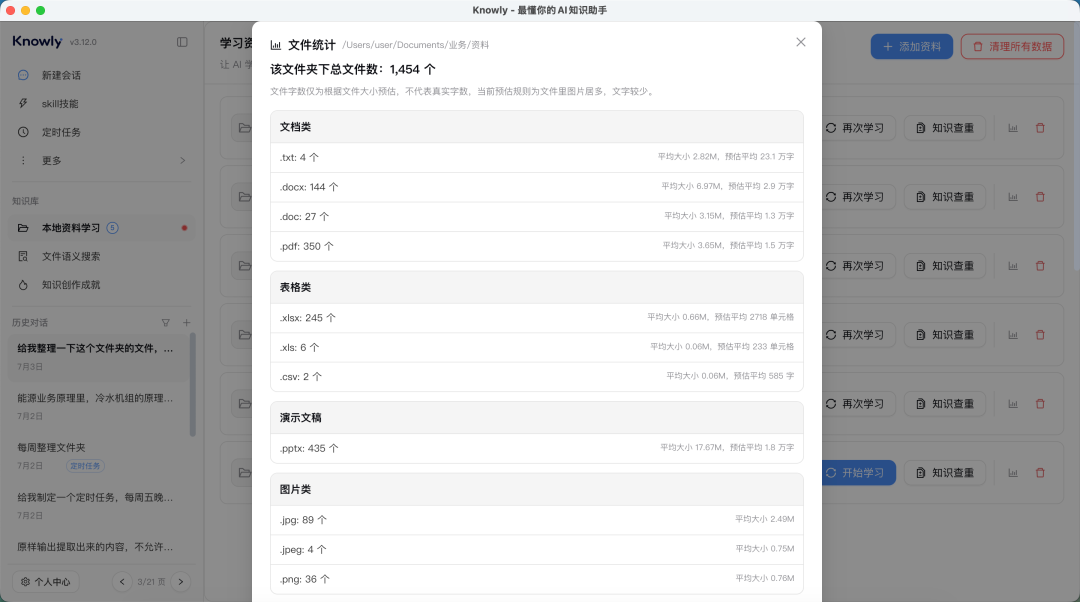
大概花了10分钟扫描完成后(有3个文件还在那,但已经被排除出知识库了),找出了 81 组重复内容。有些文件只是名称多了一个“(1)”,正文完全相同;有些表格是分散在不同项目目录里,内容相似度达到 88%;还有些资料标题相近、内容存在变化,基本上都是长期积累下来的新旧多个版本。
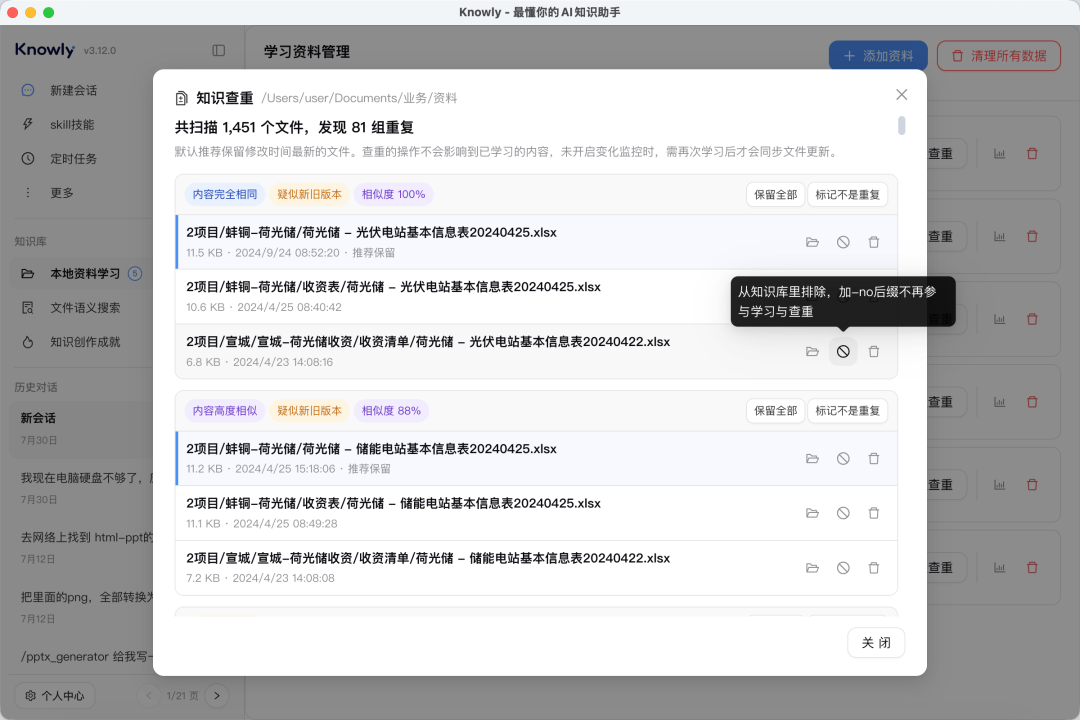
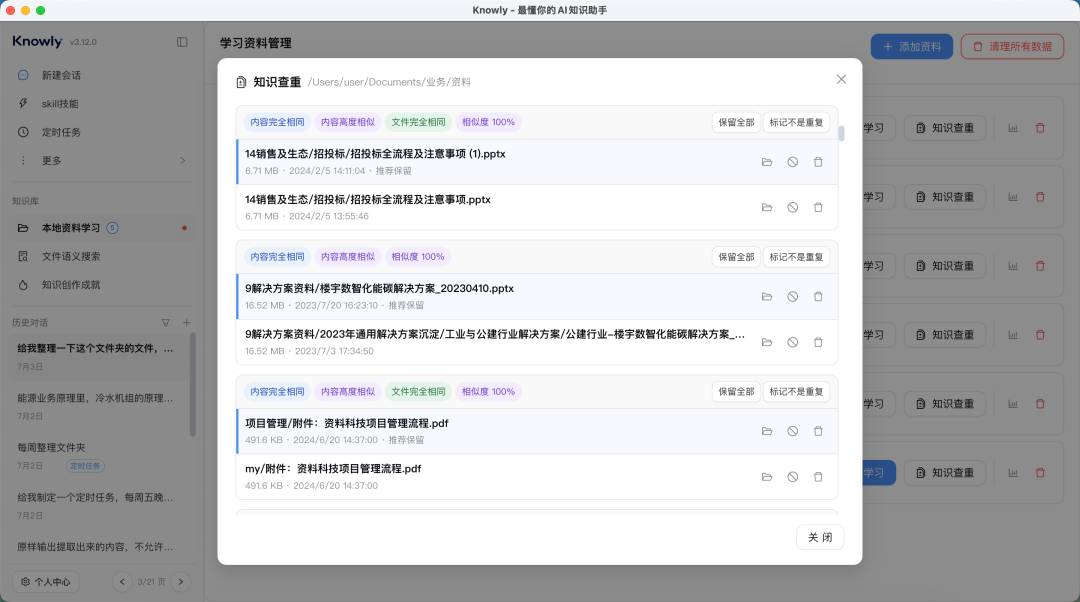
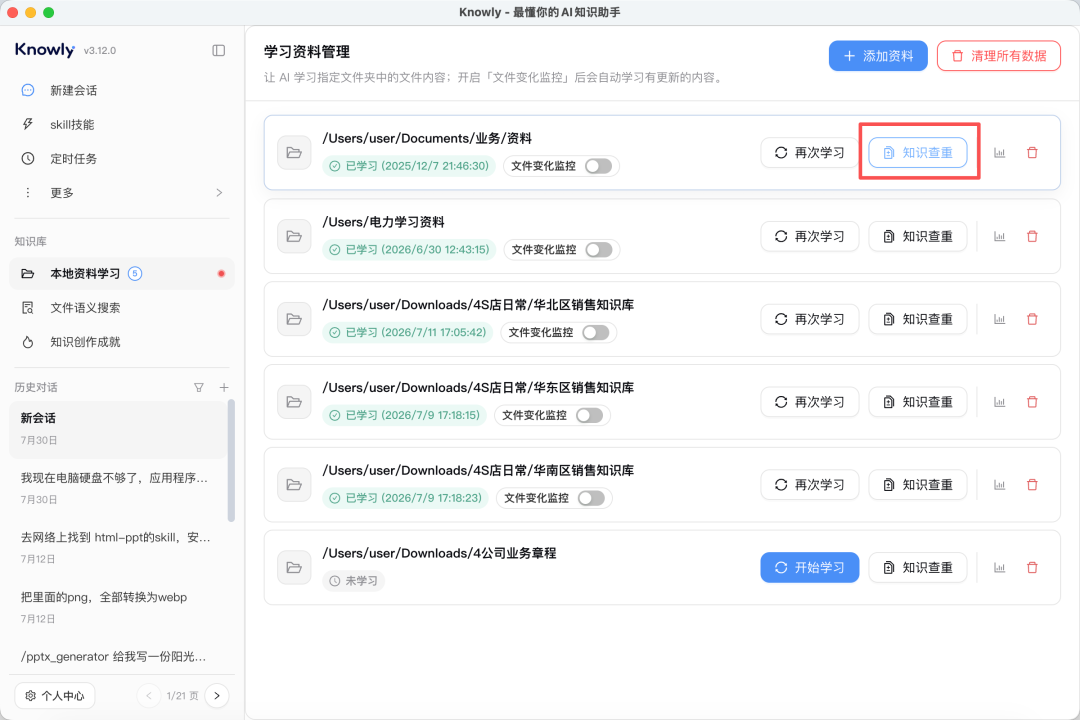
查重结果会把这些文件分组展示,并标明“文件完全相同”“内容完全相同”“内容高度相似”或“疑似新旧版本”,同时给出相似度、文件路径、大小和修改时间。系统会根据修改时间等特征推荐出一份应该保留的,但不会擅自替用户执行,因为时间最新不等于内容一定正确,最终判断权必须留给真正了解资料的人。
确认重复的文件,可以移到系统回收站;暂时不想删除的,可以保留在原目录,但将它排除出知识库体系;如果两份资料本来就应该共存,也可以标记为“不是重复”,下次不再提示;如果暂时不知道如何做的,也可以先选择“保留全部”,等到以后时机成熟了再做决策。
工具负责把问题找出来、把依据摆清楚,而不是代替用户做不可挽回的决定。知识库进化的第一责任人,还是我们自己。
知识查重是进化的前提
知识查重当然不等于知识进化,但它是知识进化之前必须做的一步。一个同时装着旧制度、新制度、三份最终版和五份副本的知识库,接入再强的大模型,也只会更快地生成相互矛盾的答案。
LLM 适合理解、问答和内容重组,传统算法更适合全量扫描、精确比较和持续记录状态。真正能长期使用的 AI 知识库,不应该把所有问题都推给大模型,而应该先用可靠的工程能力把重复、过时和冲突的资料治理好。
先让知识库里的内容可信,再谈让它持续进化。有兴趣的就来试试我们的文件查重功能吧!
JOTO 企业落地观察
- 企业部署AI知识库时,若盲目依赖LLM做全量内容治理,将面临状态缺失、上下文断裂、成本失控三重风险;必须前置构建可审计、可回溯、本地化的内容指纹索引层。
- RAG知识工程中,“查重”不是边缘功能,而是知识新鲜度(freshness)与一致性(consistency)的基础设施;其技术选型应优先保障确定性而非幻觉式推理。
- 这类系统的取舍关键在于:是否允许知识库在无人干预下自动合并/覆盖内容。传统算法提供明确边界与人工否决权,而LLM驱动方案天然削弱该控制力,对企业合规与责任归属构成挑战。
- AI安全治理需覆盖知识摄入环节——未经查重过滤的冗余、冲突、过时内容,会直接污染RAG响应,放大幻觉输出,且无法通过后置提示词或微调修复。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们