知识图谱装事实,本体论定规矩,搞反顺序就白干
搞反知识图谱与本体论的顺序就白干,一文厘清二者分工边界,避开语义项目常见死坑。 核心内容: 1. 企业语义项目中混淆二者概念导致失败的典型案例 2. 知识图谱的核心定义、技术实现路线与独有特征 3. 知识图谱与本体论的分工差异、衔接逻辑与落地要点
摘 要
两者不是二选一。知识图谱答"正在发生什么",本体答"这是什么意思",六个维度看清分工与接缝。
文末阅读原文可获取原文 PDF 和中文解读 PPT
1两个词被混用,代价落在项目上
某家制造企业的数据平台上,有个标着"知识图谱"的模块上线了半年。技术团队把 ERP、MES、售后工单三套系统的数据抽出来,建成三元组灌进图库。演示时点开界面,一张密密麻麻的网络,节点是设备编号,边是"属于""安装在""维修过"。
业务方问了一个很具体的问题:这台设备为什么在第三年故障率突然上升。
系统答不上来。它知道这台设备维修过四次,知道工单挂在哪个服务商名下,却不知道"维修"这个动作背后是部件更换,更不知道部件更换之后还有一个质保窗口。节点和边都在,规矩不在。
存了事实,丢了语义,这是语义项目最常见的死法。而它多半源于一个特别容易被忽略的混淆:把知识图谱和本体论当成同一件东西的两个叫法。
这两个词确实天天被并排提起,出现在同一份方案书的相邻两页,被同一批供应商打包出售。可它们解决的是不同层面的问题,抽象层级不同,服务的对象也不同。混着用,轻则架构跑偏,重则团队对"建成什么样才算成功"根本没有共识。
PuppyGraph 这篇《Knowledge Graph vs Ontology》把这件事讲得很清楚,也用了一个很好记的对照:图谱回答正在发生什么,本体回答这是什么意思。本文顺着这条线索往下拆,把分工、接缝、以及工程上真正卡人的地方一次说透。
2知识图谱:把散落的事实连成一张网
知识图谱是一种以图结构组织数据的表示方式。节点代表现实世界里的实体,人、产品、地点、事件都算;边代表实体之间的关系,归属、成员、依赖、交互都能表达。节点和边都可以挂属性,所以一张图既能装事实,也能装事实的上下文。
它跟关系型模型的差别不在存储介质,在思路顺序。关系型模型先定表结构再往里填行,知识图谱先问这些东西彼此怎么连,再按连接的实际形状组织数据。顺序一变,查询方式也跟着变。沿着边走比按字段筛更贴近人的提问习惯。
工程上有两条主流实现路线。一条是带标签的属性图(LPG),一条是 RDF 三元组。查询语言也随之分工,Cypher 与 Gremlin 面向属性图,SPARQL 面向 RDF。它们都能表达"从 A 出发,经过两跳关系,找到满足条件的 C"这类问题,而这恰恰是 SQL 里写起来又长又慢的那一类。
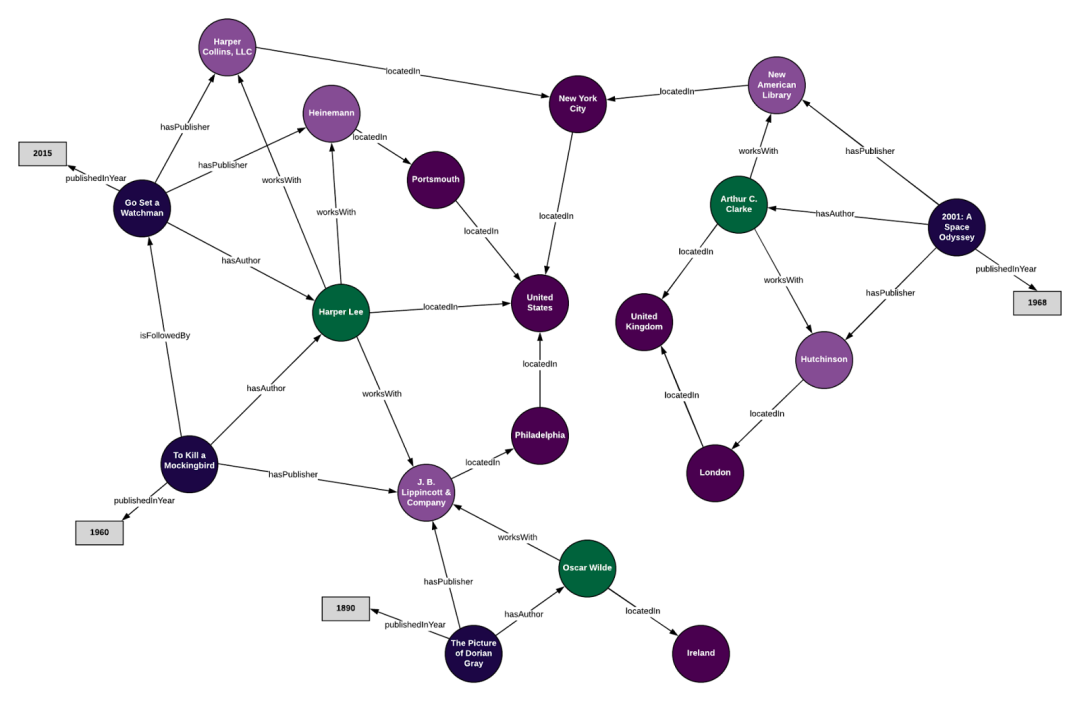
原文配图:知识图谱实例,节点是具体的书、作者、出版社与城市,边以 hasAuthor、worksWith、locatedIn、publishedInYear 标注
图里全是具体的人和具体的书。哈珀·李、阿瑟·克拉克、奥斯卡·王尔德,各自连着出版社、城市、年份。这是知识图谱的典型长相:实例密集,事实明确,问"王尔德属于哪个国家"能立刻答出来。
它的第一个特征是只认实例层。"爱丽丝在 X 公司工作""数据集 A 由任务 B 产出",这类具体断言是它的主场,也因此它的价值能立刻被应用消费掉。
第二个特征是模式可以松动。有些图会强制 schema,更多图允许部分定义甚至边用边加。团队要加一个新实体类型,不必走一遍代价高昂的表结构迁移,这对敏捷开发非常友好。
第三个特征是查询驱动。图是拿来问问题的,不是拿来看的。数据越多、关系越密,能挖出来的连接越值钱,这种网络效应让它的价值随时间递增。
常见落点也就集中在关系密集的场景:搜索引擎做实体理解和富结果摘要,电商把用户、商品、行为连起来做推荐,数据平台用图建模血缘、归属和影响分析。企业里更常见的是数据目录、客户 360 视图、反欺诈和供应链可视。它们的共性是把分散的数据源拧成一张可查询的网,而这件事在数据孤岛遍地的大型组织里格外值钱。
3本体:给这张网写一份语法书
本体是对某个领域共享概念化的形式化、显式规定。这句话拗口,拆开就顺了。它不描述单个事实,它定义这个领域里存在哪些类型、类型之间允许什么关系、有什么约束和规则。它更像一份语法书,规定了句子该怎么造,而不是替你写句子。
表达本体一般用形式化语言,OWL 和 RDF Schema 是两大主力。这些语言能定义类、属性、层级和逻辑公理。有意思的是,在基于图的模型里,LPG 的节点标签和边标签其实在扮演类似的角色:标签隐式定义了实体类型与关系类型,因此可以被看作一种轻量或隐式的本体,同样在约束和组织图的结构。
这个观点很实用。它说明本体不是非得从 OWL 起步不可,日常做图建模时给节点分类、给边命名,本身就是在做一个最小可用版本的本体。区别只在严谨程度和是否支持推理。
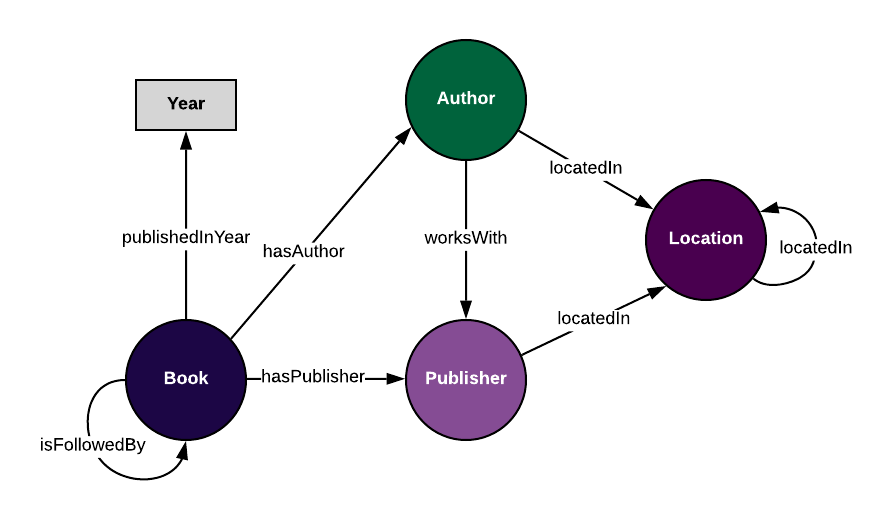
原文配图:本体示意图,Book、Author、Publisher、Location 是类而不是具体个体,Year 与 isFollowedBy 定义为约束与关系模板
和上一张图对照着看,差别一眼能看出来。这张图里没有一个具体的人名或书名,全是 Book、Author、Publisher、Location 这样的类,边上标的是 hasAuthor、hasPublisher、locatedIn 这类关系类型。它描述的是允许存在什么,而不是已经存在什么。
第一个特征是抽象。本体定义"人""组织""数据集"这些范畴,不定义爱丽丝或 A 公司。这种抽象让它可以跨系统、跨数据集复用,一套词表管十个项目。
第二个特征是形式语义。它为逻辑推理而生。如果本体规定员工都是人,而爱丽丝是员工,推理机就能推出爱丽丝是人,不需要谁手动标注这条边。这类推断在医疗、金融、合规这些要求严密性的场景里,价值远超一句方便。
第三个特征是共识属性。本体通常由领域专家协作产出,目的是让同一套术语在团队之间、工具之间、组织之间保持一致解释。它不是某个工程师的个人偏好,而是一份需要签字确认的约定。
常见落点也对应得很整齐:医疗健康里疾病、治疗、手术的标准化词表,生命科学里基因、蛋白质、生物过程的本体描述,企业侧的 MDM 与语义集成。语义网时代留下的那批成果更典型,本体给共享语义层,不同机构发布的数据才可能被机器自动合并而不产生歧义。
4一句话分清:一个记事实,一个定规矩
原文给的这个对照值得抄在便签上:知识图谱回答正在发生什么,本体回答这是什么意思。
前一句指向具体的实体和它们之间的关系,可以被应用直接查询消费。后一句指向这些事实的结构与含义,用来保证数据被正确解释。前者以数据为中心、由实例驱动,后者以模型为中心、由定义驱动。
推理能力的归属也是分水岭。本体天生为逻辑推断设计,能依据形式规则推出新知识。知识图谱可以有推理,但这项能力往往取决于它有没有挂上一个底层本体或语义模式。反过来说,图谱的推理是借来的,本体的推理是自带的。
结构上的差别同样明显。知识图谱通常更大、更动态,随数据摄入不断变化,实体增删是日常。本体相对稳定,因为改动核心概念和定义会引发连锁反应,一处定义变更可能让下游所有推理结果重算。
功能取舍由此而来。知识图谱优先性能与可扩展性,支撑实时查询与分析。本体优先正确性与表达力,有时要为此付出计算效率的代价。运营洞察与语义严谨是两条不同的优化目标,硬要一套东西兼顾,通常两头不讨好。
5六个维度的正面对照
原文那张并排表格值得完整保留,它把差异压缩到了最小颗粒度。
这张表最有信息量的一行是"模式灵活性"。它解释了大量真实项目的困境来源:图谱侧想快,于是模式一路松动;本体侧想稳,于是定义一路加严。两边节奏不同步,中间就出现一条谁都不负责的缝。
它也说明了选型不该按"哪个更强"来判,而该按"哪个更适配当下的问题"。要回答的是具体查询,图谱优先;要保证的是跨系统语义一致,本体优先。按用途选,不按优越性选。
6两段各自生长的历史,在 2012 年交汇
用结构化形式表达知识,这个想法在计算机科学里有很长的谱系,但知识图谱作为独立且有影响力的概念,出现得相当晚。早期数据库系统围着表和模式转,而图结构在捕捉复杂互联知识上显然更自然。
现代知识图谱的兴起,受人工智能、信息检索和大规模数据管理三条线的推动。真正的转折点在 2012 年,Google 公开推出自己的 Knowledge Graph,示范了基于图的知识表示如何显著改善搜索、问答与用户体验。这个里程碑让"知识图谱"这个词流行起来,也让它的实用价值走出了学术圈。此后它逐步成为企业数据架构的核心部件,支撑推荐、数据集成、智能助手和分析。
本体的年头要长得多,也更曲折。它的概念源头在哲学,原本指对存在本身的研究。进入计算机科学后,本体在 20 世纪末作为知识表示与专家系统研究的一部分登场,那一代工作强调形式逻辑、共享词表、分类体系和规则推理,目标是把领域描述得精确且机器可解释。
两者的连接在 2000 年代初语义网兴起时变得格外紧密。RDF、RDFS、OWL 这些标准陆续成型,为网上可互操作、语义丰富的数据提供基础。本体供给形式语义,定义类、属性和约束;图结构供给连接方式,让跨源信息有了天然的挂接点。两套东西一个管意义,一个管形状,正好互补。
到了当代系统里,关系变成了知识图谱当总体框架、本体做支撑角色。本体负责概念模式和语义一致,图谱负责可扩展的数据集成、现实实体建模和实际应用。这条路径其实是哲学、人工智能与万维网技术三股线索的汇流,也是今天语义数据系统的底座。
7为什么"选一个"是个伪命题
把两者当成竞争关系,是选型讨论里最常见的思维陷阱。它们更像是同一套生态里的两个部件:图谱擅长整合大规模异构数据、在规模上表达关系;本体提供精确的领域概念、共享词表和形式语义,把含义固定下来。
真正常见的形态是两者叠加。本体给语义地基,定义概念、关系与约束;图谱把这个地基实例化,用真实数据把它跑起来。原文那句话说得最到位:没有本体的图谱语义含混,没有图谱的本体停在理论。
这句判词对做企业项目的人有直接的诊断价值。如果一张图跑得很顺但没人敢用它做决策,多半是语义不清,缺本体;如果一份本体写得很漂亮但从来没被查询过,多半是没落地,缺图谱。两种失败模式长得很不一样,修法也不一样。
所以真正的问题不是二选一,是怎么把两者接起来,并且让这个接法能持续演进。而这恰恰是工程上最难的部分。
8真正难的不是概念,是把它建起来
现实中的知识图谱很少只由实例数据构成。多数系统都是实例图加本体或模式层定义的组合,前者装具体实体和关系,后者编码类型、语义与结构约束。一个能用的知识图谱从来不是其中之一,而是两者的合体。
概念上讲得通,建起来却是硬仗。传统做法要求团队先设计好本体或模式,再通过复杂的 ETL 管道把关系数据转成图,并把实例图加载进专用图数据库。这条路上,模式演进与实例摄入被死死绑在一起,每改一次模型就要重跑一遍管道,迭代慢、成本高、运维脆。
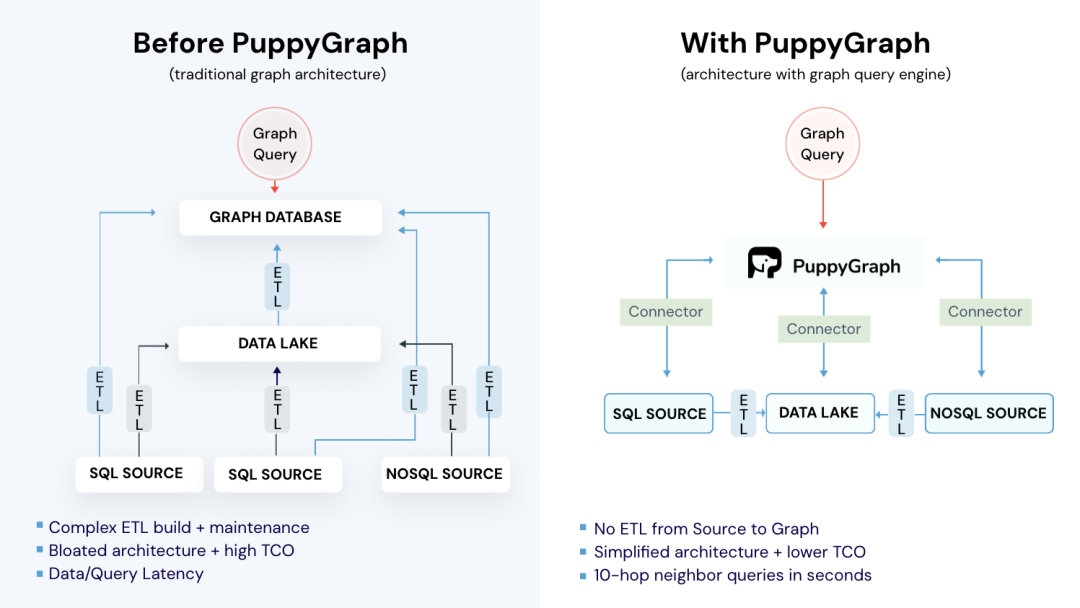
原文配图:左为传统图数据库架构,数据湖与多个源系统之间叠着层层 ETL;右为引入 PuppyGraph 后,连接器直连 SQL 源、数据湖与 NoSQL 源,源到图之间不再有 ETL
这张架构对比把代价画得很直白。左边每一层 E、T、L 都是一份要维护的作业,图上写着三行注脚:ETL 构建与维护复杂、架构臃肿且总持有成本高、数据与查询有延迟。右边的三个连接器取代了那一堆方块,注脚换成:源到图之间没有 ETL、架构简化且成本更低、十跳邻居查询秒级返回。
这不是把管道挪个位置的问题,是把模式定义与数据摄入彻底解耦。解耦之后,模型可以随便改,数据不用动;数据可以随时进,模型不用重跑。迭代速度的量级差别就在这里。
9零 ETL 的虚拟图:把模式与数据拆成两件事
PuppyGraph 走的是另一条路。它不在物理上物化图,而是在既有数据系统之上加一层虚拟图,把模式定义从数据摄入里抽出来。图模式用一个轻量 JSON 文件声明式描述,写清楚顶点类型、边类型,以及它们到下层表和键的映射关系。
这个设计的直接好处是图建模变成免费的。同一份数据源,写不同的 JSON 模式文件,就能得到多个图模型,同一批数据可以被不同语义视角解释。做客户 360 是一种切法,做反欺诈是另一种切法,底下的表一张都不用动。
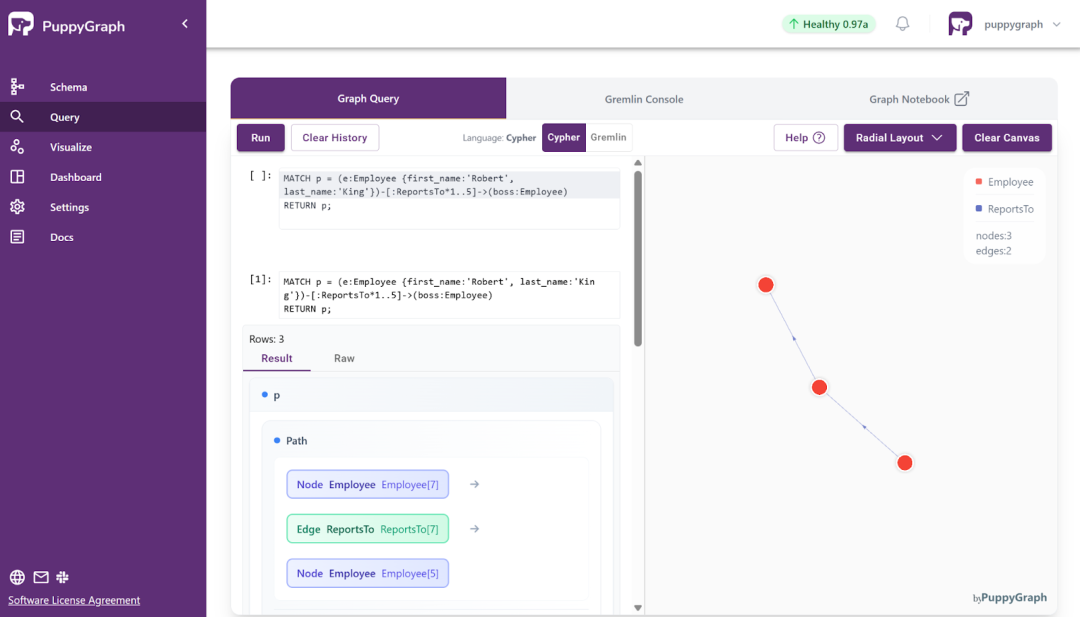
原文配图:PuppyGraph 的 schema 视图,左侧导航为 Schema、Query、Visualize、Dashboard,右侧是客户、订单、产品、区域等类型构成的可视化模式与边类型列表
界面里能直接看到这套模式长什么样。Category、Customer、Demographic、Employee、Order、Product、Region、Shipper、Supplier、Territory 是一组顶点类型,BelongsToDemographic、PurchaseOrder、AssignedTo、ShippedBy、CoversTerritory 是一组边类型。这就是一份可视化之后的本体草稿,虽然用的是 LPG 标签而非 OWL 类。
这套模式驱动的抽象天然能延伸到知识图谱建设。模式作为语义层,显式定义领域概念与关系;图查询直接跑在这些语义上,而不是跑在表和 join 上。于是带领域知识的问题可以写成直观的图遍历,底层数据仍然保持关系型原样。语义建模与物理存储一分开,知识图谱就能增量地建、增量地改,不必重构数据,也不必引入复杂管道。
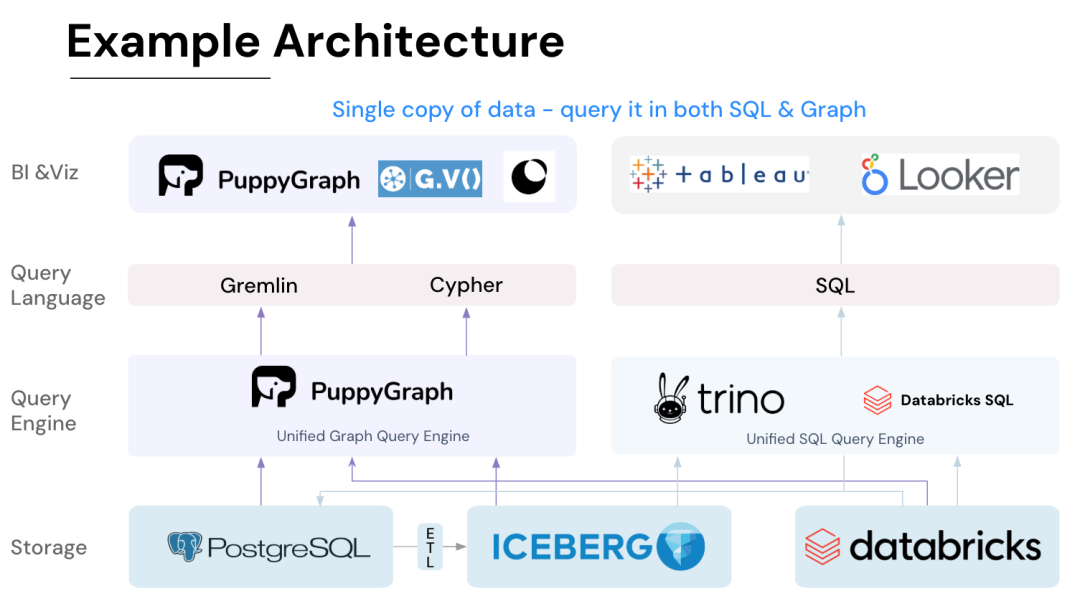
原文配图:PuppyGraph 架构示例,底层为 PostgreSQL、Iceberg、Databricks 存储,上层由 PuppyGraph 图查询引擎与 SQL 引擎共享同一份数据副本
这张图点出了一个常被忽略的设计取舍。标题写着"单份数据副本,同时用 SQL 和图查询"。底下是 PostgreSQL、Iceberg、Databricks 三种存储,往上分出两条路:左边 PuppyGraph 接 Gremlin 与 Cypher,服务 BI 与可视化;右边 Trino 和 Databricks SQL 接标准 SQL。一份数据,两种查询范式并存,不需要为了图分析再复制一份数据出去。
落到能力清单上,原文列了八条,几条硬指标值得单独摘出来。
零 ETL 是底色:它作为查询引擎跑在既有关系库和数据湖上,跳过管道建设,几分钟就能开始用图的方式查。不复制数据:原地查询,不把大数据集搬进独立图库,数据一致性和既有访问控制都能沿用。实时分析:查的是活的源数据,分析结果反映当下状态,而不是某个可能过期的图快照。据其用户反馈,跨数十亿条边的六跳查询在三秒内返回。
性能上,分布式计算引擎随集群规模扩展,可跑 PB 级负载和十跳邻居这类深遍历,靠的是并行处理与向量化求值。范式上,因为数据原地查,团队可以继续用现有 SQL 引擎做表格类负载,用 PuppyGraph 做关系密集型分析,不必把所有场景硬塞进图数据库,也不必让全员重学一门查询语言。
成本是另一条主线。原文的说法很尖锐:图数据库让你付两次钱,一次付给管道、重复存储和平行治理,一次付给让它跑得快所需的高内存硬件。零 ETL 加不搞第二套系统,两笔都能省掉,没有巨额内存账单,没有重复的 ACL,也没有多余的基础设施要加固。
模式侧还有灵活性。元数据驱动的模式让同一份底层数据能生出多个图视图,模型可以快速迭代而不必重建数据管道。查询侧支持 openCypher 与 Gremlin 两种标准图查询语言,配可视化工具,分析师能自己上手探关系。
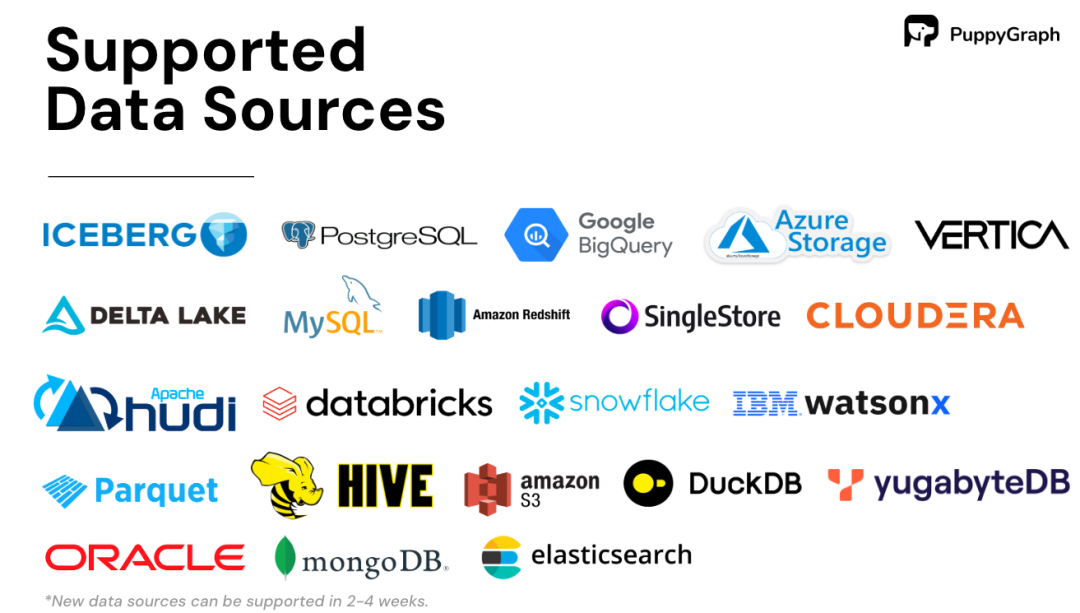
原文配图:PuppyGraph 支持的数据源,涵盖 Iceberg、Delta Lake、Hudi、Parquet、PostgreSQL、MySQL、BigQuery、Redshift、Snowflake、Databricks、SingleStore、Oracle、MongoDB、Elasticsearch、DuckDB、Hive、S3、Vertica、Cloudera、watsonx、yugabyteDB 等
数据源覆盖面是这类方案能不能进企业的一道硬门槛。这张图把支持清单摆得很满:湖侧有 Iceberg、Delta Lake、Hudi、Parquet 与 S3,仓侧有 BigQuery、Redshift、Snowflake、Databricks、SingleStore、Vertica、Cloudera、watsonx,库侧有 PostgreSQL、MySQL、Oracle、DuckDB、yugabyteDB,加上 MongoDB 与 Elasticsearch 两个非关系源。图脚注补了一句,新数据源可在两到四周内支持。对存量系统复杂的企业来说,这决定了是"能用"还是"又得先做一轮数据搬迁"。
部署侧的门槛压得更低。下载免费的 Docker 镜像,连上既有数据存储,定义图模式,就可以开始查询。部署形态支持 Docker、AWS AMI、GCP Marketplace,也可以放进自有 VPC 或数据中心,把数据完全握在自己手里。
10落地侧写:从云安全到社交网络
抽象讲完,看一个具体查询会更有感觉。云安全是图分析最典型的战场,因为权限问题天然是路径问题。
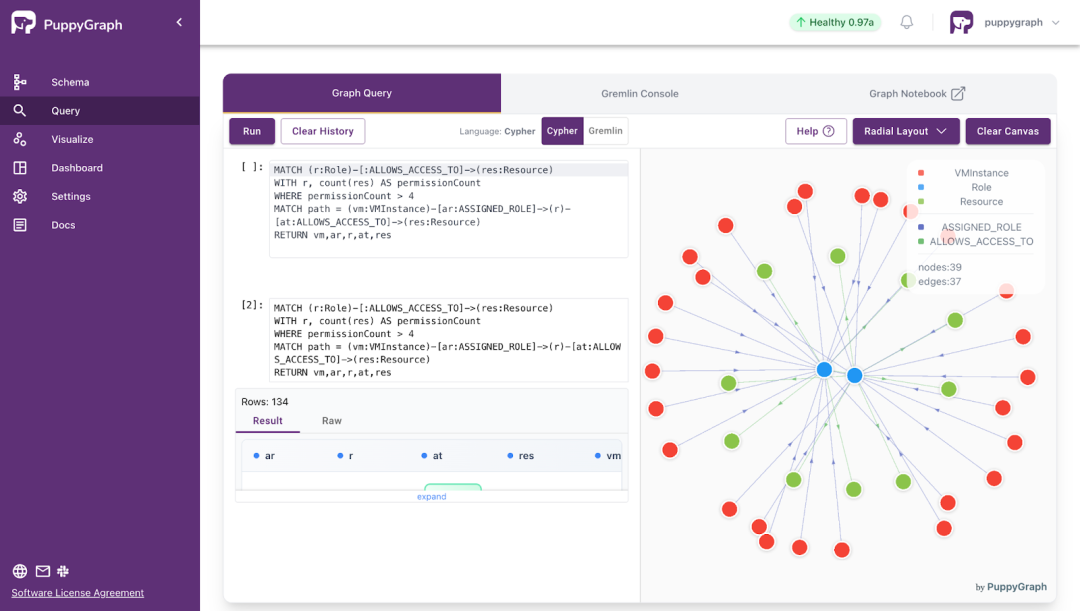
原文配图:PuppyGraph UI 上的云安全图谱用例,Cypher 查询 Role 到 Resource 的 ALLOWS_ACCESS_TO 路径并按权限数过滤,右侧为 39 节点 37 边的辐射状布局
界面里那段 Cypher 值得读一遍。它先匹配所有从 Role 到 Resource 的 ALLOWS_ACCESS_TO 边,按 Role 聚合出权限数量,再用 WHERE permissionCount 大于 4 把权限过多的角色筛出来,接着顺着 ASSIGNED_ROLE 找到挂在这些角色上的 VM 实例,末端返回整条路径。这次查询返回 134 行,右侧画布上是 39 个节点、37 条边。
这个查询在关系型世界里要写多层自连接加聚合,写在图里就是三段 MATCH 顺着边走。问题本身就是路径,用图表达才不别扭。安全团队真正想知道的不是"有多少个角色",而是"哪台机器通过哪条授权链拿到了不该有的访问权",这是典型的多跳可达性问题。
原文另外给了两个用例截图,社交网络和电商。前者把人与人的介绍关系展开,后者在商品、订单、客户之间做关联推荐。三个用例的共同点是一样的:价值不在节点属性,而在连接的形状。
企业侧的背书也有具体名字。原文称 PuppyGraph 已被前二十大网络安全公司中的一半采用,工程驱动型企业里包括 AMD 与 Coinbase。这些团队用它替掉的正是慢速 ETL 管道和复杂的图技术栈,换成更简单也更快的架构。
原文配图:PuppyGraph 生产环境客户,含 Coinbase、Clarivate、Prevalent AI、eBay、Protocol Labs、Netskope、Alchemy Pay、Palo Alto Networks、CipherOwl、Datadog、AMD
客户名单本身说明了图分析的落点分布。交易所、支付、云安全、数据可观测性、芯片设计,全是关系密度高、且对多跳推理有硬需求的行业。这类公司的共性是数据早就有了,卡住的是查询范式而不是存储容量。
11落到你手上的判断清单
回到最初那个答不上问题的制造企业。它缺的不是图数据库,也不是更多的边,而是一份说清楚"维修到底指什么"的约定。这份约定就是本体,哪怕它只是十几个节点类型加几条约束。
给正在做技术选型的人五条可执行的判断。
第一条,先问要回答的问题长什么样。如果是"这台设备关联了哪些工单""这个账号能到达哪些资源",问题本身是路径,图谱优先。如果是"不同系统里的物料是不是同一个东西""这批数据的口径能不能统一",问题本身是定义,本体优先。
第二条,把本体当活文档写。不需要一上手就上 OWL 全套,先用 LPG 的节点标签和边标签把类型定下来,写进那份 JSON 模式文件,让它在每次查询里被真实使用。用得上的最小本体,胜过躺在文档里的完整本体。
第三条,警惕模式与摄入的耦合。如果改一次模型要重跑一遍 ETL,那就该考虑虚拟图这条路。迭代速度是语义项目能不能活下来的第一变量,模型改不动的项目最终会停止演进。
第四条,别为了图而图。表格类负载继续走 SQL 引擎,关系密集的查询才交给图引擎,两者共享同一份源数据是最省成本的形态。
第五条,用真实查询验证性能。六跳、十跳这些数字要在自己的数据上跑一遍,PB 级和十亿边是能力上限,不是你的起点。
原文的结论其实很朴素:知识图谱抓具体实体和关系,本体定义概念框架来保证一致性、语义和共识,合起来才能支撑既数据丰富又理解语义的智能应用。PuppyGraph 的切入点是把这个组合从"要建重型管道才能实现"变成"原地查询就能实现",把知识图谱从静态模型变成生产可用的系统。
先定语义,再连数据,顺序反过来,图建得再漂亮也只是张关系网。这句话是全文最值得带走的部分。
语义层的争论还会继续,但方向已经清楚:没有一个团队会因为"图太大"而失败,却有很多团队因为"没人说得清这些边是什么意思"而放弃。把那份约定写下来,比换一套引擎更值钱。
标签:知识图谱 · 本体论 · 语义层 · 零 ETL · 图查询引擎
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们