让模型只提议、不许拍板:OntoSmith 把本体和知识图谱建成一条可审计的流水线
OntoSmith 是一个开源知识图谱构建工具,采用「提议与裁决分离」架构:低成本模型生成候选三元组,固定裁决模型 Jev 逐条对照证据判定是否写入;本体以扁平化、版本化、人工审批的「抽取契约」形式存在;构建分语料普查、本体审批、批量执行三段,全程留痕、可报价、可断点续跑;每条三元组附带证据句、出处与可信度打分,专为医疗、法律、金融等需审计追责的生产场景设计。
随缘抽取造出的图谱,你敢直接用吗
把一摞文档扔给一个能力不错的大语言模型,让它「抽成知识图谱」,是过去两年最常见的做法。听起来顺理成章:模型看得懂文本,抽出的实体和关系直接进图数据库,检索增强生成的效果立竿见影。问题出在你事后想核对的时候—你不知道哪条边是文本里真写了的,哪条是模型脑补的。
常见的补救是看问答效果:拿几个问题考一考建好的图谱,答得好就认为图质量高。这种评估有两个漏洞。第一,问答对路了不代表图对了,模型可能绕开图谱靠参数记忆答题;第二,问答错了你也不知道该修哪条边,因为图里几万条三元组没有一条带着「我为什么存在」的说明。这还不算团队协作的账:交接一个图谱项目时,接手的人面对一堆来路不明的边,重建不敢、沿用也不。
医疗、法律、金融这类场景把这个问题放得更大。一份合同的期限条款被抽错方向,一个药物相互作用被凭空补上,代价都不是「检索质量下降」四个字能盖住的。图谱要进生产环境,前提是每条事实都能回答「证据在哪」。这正是 OntoSmith 立项的出发点:它是一个开源的知识图谱构建工具,但它的核心主张不在「构建」二字,而在「先定规则、逐条裁决、留痕可查」十二个字上。
提议与裁决分离:写库权收归一道门
OntoSmith 的方法可以用一句话概括:提议的人没有拍板权,拍板的人不负责提议。具体跑起来分四步。
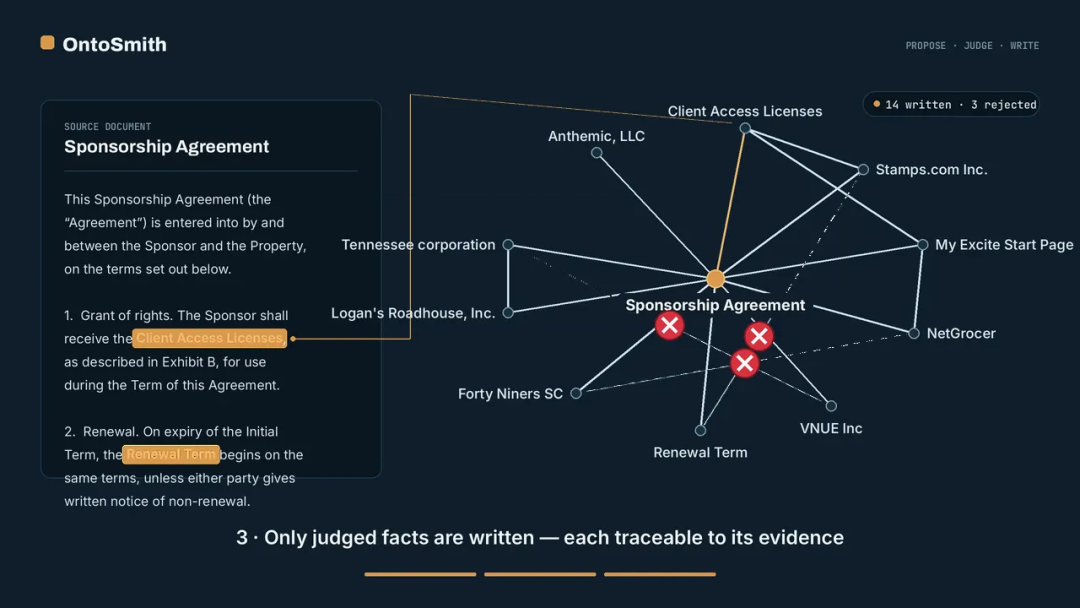
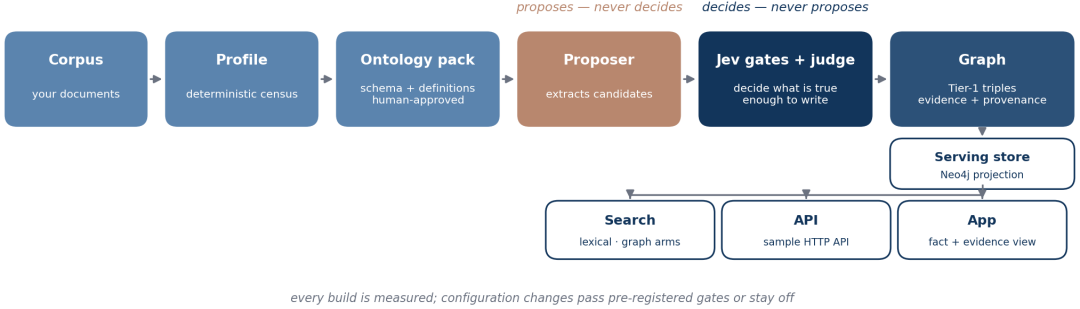
第一步,低成本模型作为提议者,从文本里枚举实体对、生成候选三元组。一个「配对调用」把枚举出的实体对转成候选关系,这一步只求覆盖面,不求准。第二步,一组确定性门禁先做形式检查:类型对不对得上本体、格式合不合规,不合格的候选在这里就被筛掉,根本不消耗裁决模型的调用。第三步,内置的 Jev 裁决模型逐条判定候选三元组是否够可信—它对照证据句逐条审,只有它点头的条目才有资格写入图数据库。第四步,写入的每条三元组都带上证据句、文档出处和一个可信度打分。
值得强调的是那个打分的定位。项目文档里管它叫 p_true,并明确说它是用来排序和设阈值的分数,不是校准过的概率。这句话看着谦虚,其实诚实:很多工具把模型输出的置信度当成概率讲给用户听,OntoSmith 直接把话说破—这是一个排序用的数,别拿它做风险计算。
这套分离的好处是经济上的。提议可以用便宜的高产出模型,裁决用一个固定的、经过调校的组件,两边各自调优互不牵连。整个系统里没有任何一条三元组是因为提议者自己说了算就进图的。
本体先行:一份扁平的抽取契约
OntoSmith 对「本体」的理解和语义网社区的传统不太一样。这里的本体是一份扁平的抽取契约:一个封闭的实体类型和关系类型清单,每个类型带定义和边界示例,由人起草或从语料导入、经人审批后生效,裁决模型按类型逐条执行。
「扁平」是刻意的。它没有类继承、没有逻辑公理,也不是 OWL 本体编辑器,不对图谱做推理。项目对这件事的解释很直白:逐类型的裁决才让质量可度量,而层级结构恰恰会把这些裁决糊在一起。一个类型到底算不算另一个类型的子类,在形式本体里是推理问题,在抽取契约里是责任问题—OntoSmith 选了后者,因为它要交付的是「一份可治理、带证据、能被检索和智能体调用的图谱」,不是一套逻辑体系。
这份契约的工程形态叫领域包:本体以数据的形式存在,带版本号,用 sha256 哈希钉死,加载时校验不过就拒绝启动。领域内容全部放在包里,代码里不留任何领域分支—换一个领域就是换一个包,不动一行代码。
三段流水线:先普查、再定约、后构建
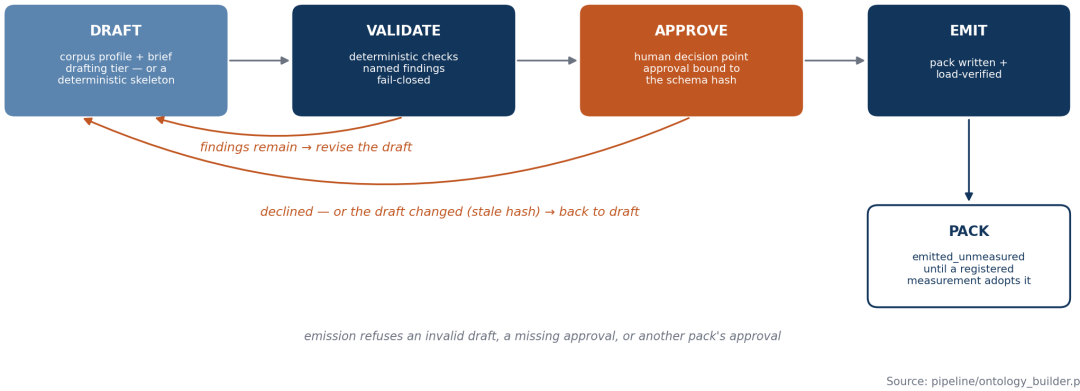
整个工具的使用流程分三段,第一段甚至不需要任何模型。
第一段叫语料普查。ontosmith profile 命令对你的文档做一次确定性普查:清点文档数量、格式约定、以及哪些「决策点」需要人先拍板—比如同一实体在不同文档里的写法差异。这一步完全不调用大模型,同样的语料跑一百遍,输出的档案哈希一模一样。它的价值在于让你在花一分钱之前先看清:我的语料长什么样,有哪些坑需要先定规则。
第二段是本体起草与审批。ontosmith ontology 命令从普查档案起草领域模式,用确定性的规则校验,然后停在人工审批这一步等你点头。你批准之后它才发出一个版本化、哈希钉死的领域包。没有审批,就没有包。
第三段才是构建。ontosmith batch 在领域包约束下跑完整流水线,成本有红线,随时可以断点续跑。三段之间靠两个工件衔接:一个叫档案,描述你的语料;一个叫包,承载领域的本体。每次构建都绑定一档案、一包,谁在什么规则下建的图,记录得清清楚楚。
构建段的内部结构是八个阶段:摄取、命名实体与名册、候选生成、门禁、路由、写入、索引、核验。
摄取负责把文档切分成带溯源信息的块。实体阶段建立文档内的名册。候选阶段用提议模型枚举关系候选。门禁阶段做确定性筛查。路由阶段决定每个候选走哪条裁决路径。写入阶段把过关的三元组连同证据写进图库。索引阶段建向量索引和全文索引。核验阶段回读图库,确认写进去的东西和裁决记录一致。八个阶段共享一本账,任何时刻中断都能从账本恢复,重跑不重花钱—这对要过夜的长构建是刚需。阶段边界同时是审计边界:每一阶段的进出都有账可查,出了问题能定位到具体环节,而不用把整条流水线从头怀疑一遍。
这个结构里藏着一个和常见做法不同的取舍:候选生成没有本地自然语言处理栈。项目曾经内置过一条 GLiNER 加 spaCy 的候选来源,2026 年 10 月底退役了,现在是纯大模型提议。理由不难猜:维护两套候选来源的一致性,比维护一套的成本更高,而提议这一环本来就该用最便宜的模型跑量。
Jev 与五个席位:裁决模型是固定组件
OntoSmith 把模型接入抽象成「席位」,参考配置是五席位三层:提议席位负责出候选;配对裁决席位和提议共享模型行;Jev 是钉死的裁决门,一个固定组件,不参与模型海选;升级席位处理裁决升级,在评估里兼作对照裁判,但从不决定写入;起草席位辅助起草本体和档案,在构建循环之外;嵌入席位负责索引和问题嵌入。
参考配置的四个模型绑定是:提议用 Claude Haiku 这一档的便宜快模型,裁决用 typesafe 出品的 jev 模型,升级用 Claude Sonnet 档,嵌入用 OpenAI 的 text-embedding-3-large。一张密钥通吃四个模型。项目特别说明:这张表应当读作「测量出处」,而不是「配置要求」—公开的数字是在这套绑定下测出来的,但工具只需要任意一个连接,不需要这一套。
这个设计里最值得琢磨的是裁决席位的处理方式。提议、升级、起草都可以换模型,唯独 Jev 是钉死的产品组件。把「什么可以写进图谱」的判断权固化在一个可审计的组件里,而不是每换一次模型就重新调一遍阈值,这是整套方法可信度的锚点。阈值、枚举窗口、裁决配置全部由预先注册的测量门选定,没过门的配置直接停用,落选记录留在质量档案里。
先报价、后花钱:写进账本的预算红线
大模型项目的成本失控通常长一个样:跑到一半发现候选对数量爆炸,账单已经回不了头。OntoSmith 把成本控制做成了两个硬机制。
第一个是先报价。每次构建前,ontosmith verify project 会先从你的数据里数出候选对数量,按你提供的单价算出预算—工具不内置任何价目表,价格由调用方给。文档里反复强调一句话:任何文档里引用的数字都不是你的成本,你的配置下的预测才是。
第二个是止损线。每个批次创建时冻结一条预算红线,运行中一旦要越过红线,就拒绝启动那个会越线的单元,然后从账本断点续跑,而不是重新花一遍钱。账本机制同时解决了成本和恢复两个问题:花了多少、花在哪、停在哪,全是账本上的记录。
对要在企业环境里立项的人来说,这两个机制比榜单数字重要得多。「构建一个图谱要多少钱」在创建批次之前就有答案,这在大多数同类工具里是做不到的。
四个领域包:生物医学与法律合同的实测
OntoSmith 自带四个领域包加一个基线:生物医学包带配套的实体关系模式和限定词规则,在 BioRED 语料上测过;法律合同包带 41 个标签类别和角色词、定义术语规则,在 CUAD 语料上完成了晋级实测;FIBO 合同包是从 EDM 协会的 FIBO 本体导入的,15 个实体类型加 13 个关系类型;开放域包在 Re-DocRED 上跑出了旗舰构建记录;核心包是跨领域的基线。
法律合同包的实测结果值得细看:在 Bellicum 制药与 Miltenyi 生物技术的一份供应协议上,构建出 42 个实体、77 条一级三元组,每一条都带证据句和出处。旗舰构建是一个 3902 条三元组的句子窗口配置。
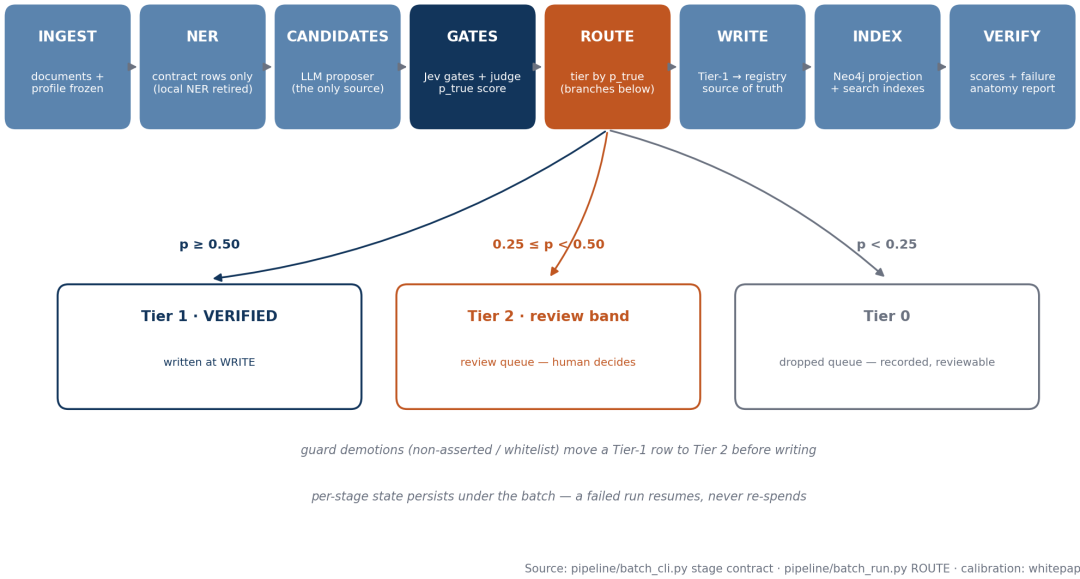
质量档案的诚实程度同样值得一提。项目白皮书明确列出每个数字的适用范围:校正后的分数描述的是那个 3902 条的句子窗口配置,不是出厂默认配置;出厂的一级集合额外包含 186 条晋级三元组,其校正精度没有重算;裁决是机器裁决,没有做过人工抽查环节;检索评测钉在一个 116 题的长合同题集上,在短摘要上恰好是零分。一个开源项目把「我的数字不适用于哪里」写成专门的一段,这比多刷三个点更有参考价值。
每条边带证据:三个真实的例子
证据随行这件事,用三个项目文档里的真实条目最容易讲透。
第一个来自新闻语料。一篇文章讲的是一位名叫萨贝特的官员,其中一句话提到他长期辅佐前阿富汗总理希克马蒂亚尔。按主体归属,这条事实的主语是阿富汗这个国家:阿富汗 → 政府首脑 → 希克马蒂亚尔,作为一条边写入,证据句就是那句话本身。片段落在别人的文章里,事实却回答它自己的主体,附录里这条被判为「有据」。
第二个来自小说。左拉的《巴黎的肚子》从不列人物表,人物凯南是靠一句情节叙述进场的—他回到继兄身边避难。于是「巴黎的肚子 → 角色 → 凯南」成为一条边,人物靠关系进场,而不是靠出场名单。
第三个来自合同,也最能体现工程功力。一份协议边写边定义术语:本协议期限为十年(下称「期限」)。构建器把这类约定术语收进每文档的登记表,把后续所有「在期限内」的指称都归并到同一个节点—定义和用例是同一个实体,不是一堆字符串匹配。做过合同抽取的人都知道,这个「定义术语归并」是合同图谱成败的分水岭。
与 GraphRAG 路线的对照
| 维度 | GraphRAG 类流水线 | OntoSmith |
|---|---|---|
| 构建中心 | 单个前沿大模型直接抽取 | 低成本提议者加固定裁决门 |
| 本体来源 | 从抽取结果中涌现 | 显式、版本化、人工审批的契约 |
| 写入依据 | 提议者说了算 | 裁决模型逐条判定 |
| 质量评估 | 靠问答效果间接评判 | 直接对图谱本身评分,附裁决记录 |
| 成本控制 | 跑完才知道 | 构建前报价,账本止损 |
| 适合场景 | 快速出演示图、要涌现结构 | 图谱要进审计、要追责的场景 |
这张表不是要说谁优谁劣。项目自己的表述很公允:想要涌现结构、先跑一个能用的演示,GraphRAG 一族更快到达;而图谱必须被审计时,才轮到这一套方法上场。两条路线的分野不在技术高下,在于你对图谱承担什么责任—给内部创新项目做原型,涌现式抽取的性价比无可匹敌;给监管报表、临床决策、法律意见供数,没有裁决记录的图谱等于给自己埋雷。选型前先问自己一句:这张图三个月后出问题时,你能不能把当时的判定过程重放出来。能,就选这一套;不能,至少要把答复范围圈在低风险场景里。
上手三步:前两步不用密钥
项目的上手设计对围观者相当友好,三步里前两步完全不需要任何模型密钥。
第一步,安装后跑语料普查,看示例语料的档案输出:四份文档、六条声明、零花费,档案哈希钉死。还可以对随附的演示构建做检索提问—这个演示用整本《傲慢与偏见》建图,检索直接跑在冻结的记录文件上,不用密钥、不用图库、不用装任何服务。也可以把普查指向自己的文件夹,先看看语料合不合适。
第二步,核对质量主张。旗舰构建的校正分数可以从随附的裁决附录完整重放,不调任何模型,任何数字对不上,脚本直接报错退出。每一个对外引用的数字都对应一条可重算的命令,这类「自己给自己配审计脚本」的做法在开源项目里不多见。
第三步才是真构建:一条命令配置模型绑定,装好 Neo4j 5.x 社区版,然后一行 ontosmith quickstart 从单个文本文件建图并对外服务。缺密钥或缺图库时,它会在创建任何东西之前拒绝,并告诉你缺哪个变量。此外项目还提供了一个面向机器阅读的 llms.txt,以及四条视频演示。
医疗场景的启示:从病历到循证护理
对做医疗知识工程的团队,这套方法有三处可以直接借鉴。
第一处是证据随行的范式。电子病历里的一条结论、一条护理评估,和 CUAD 合同里的一条条款没有本质区别:都是需要溯源的自然语言断言。把「每条三元组带证据句和出处」当成图谱的出厂标准,临床决策支持系统引用图谱时才能给出「依据哪份病历的哪句话」的说明,这在医疗场景里不是加分项,是准入项。
第二处是裁决与生成的分离对药企知识治理的映射。药物相互作用、适应证、禁忌证这些关系,如果由生成模型直接写库,审评人员面对的是几万条无差别的边;如果提议与裁决分离,审评人员面对的是一堆带裁决记录的事实,每一件都能回放判定路径。国自然护理学与人工智能交叉方向的评审里,可溯源性也正在从加分项变成硬要求。
第三处是本体的工程化定位。护理领域不缺本体,国际护理实践分类等标准已经存在,缺的是把标准本体落成「可执行的抽取契约」的那一步。OntoSmith 的本体导入能力(FIBO 包示范了从既有本体压平导入的路径)给了一个现成的迁移模板:拿标准本体、记下裁剪范围、压平成类型清单、人工审批、哈希钉死。这条路对 SNOMED 临床术语这样的巨型本体同样走得通,只是裁剪记录会厚得多。
再往护理科研的日常推一步:文献综述要做的证据提取,本质就是一次「带裁决的图谱构建」—从随机对照试验里抽人群、干预、结局,抽完还要逐条核对有没有抽错。这套提议与裁决分离的流水线,加上先报价的成本机制,恰好是循证医学证据提取工作流的形式化版本。护理信息学的团队不必照搬它的技术栈,但「契约先行、逐条裁决、账本留痕」这三件事,放在任何一支证据提取流程里都成立。
回到开头那个问题:随缘抽取造出的图谱,你敢直接用吗?OntoSmith 的答案是—不用不敢用的图谱,用每一条都敢给你看证据的图谱。它不承诺把图谱建得更大更全,它承诺的是另一件更稀缺的事:让图谱的每一条事实,都经得起第三方的回放。对一个要把知识图谱从演示稿推进到生产系统的团队来说,这十二个字的承诺,比任何榜单名次都值钱。
JOTO 企业落地观察
- 企业部署知识图谱时,若缺乏可审计的构建链路,将难以通过医疗、金融等强监管行业的合规审查;OntoSmith 的「提议-裁决分离」架构,为企业提供了可验证的图谱生成闭环,降低上线前的治理成本。
- 智能体工程中,知识图谱常作为外部记忆模块被调用;当图谱每条边自带证据溯源能力,智能体在生成响应时即可同步返回依据原文,显著提升临床决策支持、法律咨询等高风险场景的可解释性与可信度。
- RAG 知识工程面临「幻觉不可控」与「更新难追溯」双重瓶颈;OntoSmith 将本体固化为版本化领域包、构建过程绑定档案与包,使知识更新具备原子性与可回滚性,避免传统 RAG 中向量库与原始语料脱节的问题。
- AI 安全治理要求关键数据链路具备可复现性;OntoSmith 的语料普查哈希、裁决附录重放、账本断点续跑等设计,使图谱构建过程满足「输入确定→过程可查→输出可验」的安全基线,为企业 AI 治理提供可落地的技术抓手。
立即咨询 JOTO
JOTO 提供覆盖企业智能体规划与搭建、AI 平台私有化部署、RAG 知识工程、AI 安全治理、FDE 驻场共创及持续运营优化的全周期 AI 落地服务,帮助企业把验证中的 AI 能力转化为安全、可控、可持续迭代的生产力。 联系 JOTO 获取 AI 落地咨询
想把这些做法用到你的业务里?
留下你的场景和痛点,我们帮你判断从哪一步开始。
联系我们